
Bạn có thể chạy Nemotron 3.5 Transcribe mới của NVIDIA trên một GPU và phiên âm các bản ghi dài hàng giờ bằng 40 ngôn ngữ mà không phải trả tiền theo phút hay gửi âm thanh cho bất kỳ ai. Đây là mô hình trọng số mở hàng đầu trên Bảng xếp hạng ASR mở của Hugging Face, được phát hành theo giấy phép OpenMDW-1.1 thân thiện với thương mại, và NVIDIA đã công bố trọng số BF16, FP8 và NVFP4 vào ngày phát hành, 28 tháng 10 năm 2026.
Hướng dẫn này đề cập đến phần cứng bạn cần, ba cách chạy mô hình (vLLM, SGLang-Omni và Transformers), các lệnh chính xác từ thẻ mô hình chính thức, và những cài đặt khiến người ta gặp khó khăn. Tất cả các lệnh được sao chép từ thẻ vào ngày 29 tháng 10 năm 2026.
Mới làm quen với mô hình? Hướng dẫn miễn phí của chúng tôi giải thích nó làm gì và xếp hạng ra sao. Không có GPU? API được lưu trữ có giá $0,002 mỗi phút.
Tại sao nên chạy cục bộ
- Không hóa đơn theo phút. Với mức $0,002 mỗi phút của DeepInfra, 10.000 giờ tốn $1.200. Trên GPU của riêng bạn, chi phí chỉ là tiền điện.
- Quyền riêng tư. Cuộc gọi khách hàng, ghi âm y tế và bản ghi pháp lý không bao giờ rời khỏi mạng của bạn.
- Bộ tính năng đầy đủ. Đường dẫn vLLM hỗ trợ dấu thời gian từng từ, phân tách người nói, dịch và gợi ý ngữ cảnh. Một số điểm cuối được lưu trữ chỉ cung cấp một phần trong số đó.
- Tinh chỉnh. Bài đăng ra mắt của NVIDIA cho thấy một bản tinh chỉnh y tế giảm WER từ 30,8% xuống 11,8%. Bạn chỉ có thể làm điều đó với trọng số.
Phần cứng: những gì chạy được nó
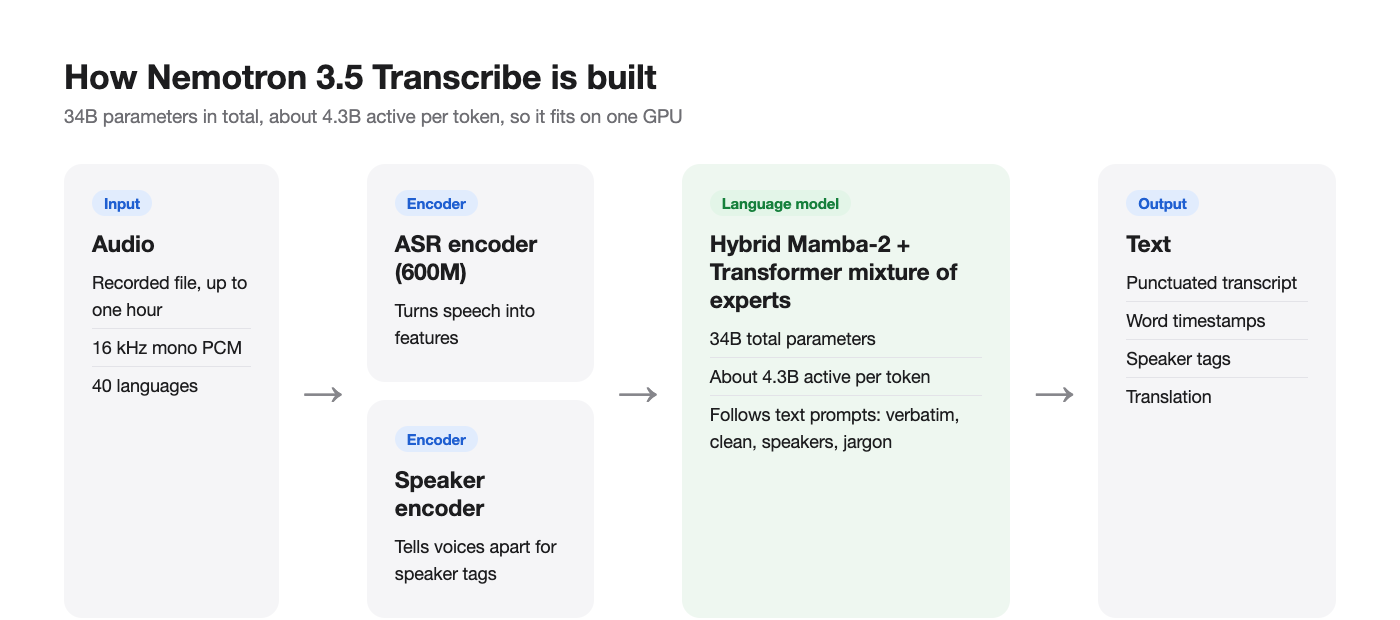
Mô hình có tổng cộng 34B tham số và khoảng 4,3B tham số hoạt động, vì vậy trọng số rất lớn mặc dù tính toán cho mỗi token nhỏ. Mục tiêu tham chiếu của NVIDIA là một H100 80 GB ở BF16. Bảng tương thích trên thẻ mô hình:
| GPU | Độ chính xác | Môi trường chạy |
|---|---|---|
| H100, H200 | BF16, FP8 | vLLM 0.32.0, Transformers, SGLang-Omni 0.2.0 (H100) |
| A100 80 GB | BF16 | vLLM 0.32.0, Transformers |
| L40S 48 GB | FP8 | vLLM 0.32.0, Transformers |
| B200, GB200, GB300 DGX Station | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| DGX Spark (GB10), Jetson Thor | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| RTX PRO 6000 Blackwell Server | BF16, FP8, NVFP4 | vLLM, Transformers, SGLang-Omni, GGML |
| RTX 5090 (32 GB) | chỉ NVFP4 | vLLM 0.32.0, Transformers, GGML |
Chọn checkpoint cho card của bạn:
nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(BF16)nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-FP8nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4
Card 24 GB như RTX 4090 không có trong danh sách, và Apple Silicon không được hỗ trợ. Hệ điều hành là Linux, hoặc Windows thông qua WSL2. GGML cũng chạy trên Windows gốc, nhưng bài đăng ra mắt của NVIDIA nói rằng bản dựng cục bộ NeMo-Speech.cpp vẫn "sắp ra mắt."
Tùy chọn 1: Máy chủ vLLM (được khuyến nghị)
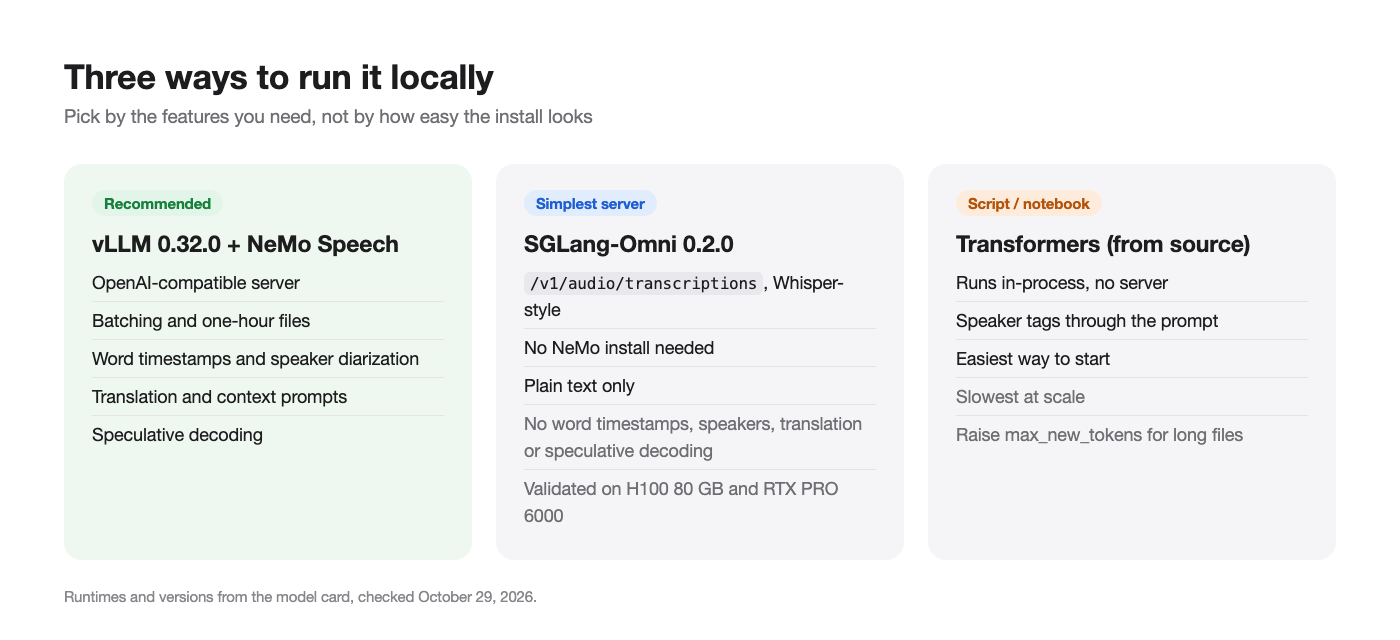
vLLM cung cấp cho bạn một điểm cuối tương thích OpenAI với xử lý theo lô, tệp dài một giờ, giải mã suy đoán và dấu thời gian từng từ. Nó cần vLLM 0.32.0 cùng nhánh chính NeMo Speech mới nhất, cung cấp plugin vLLM của mô hình.
Cài đặt
Thẻ sử dụng uv và Python 3.13:
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
PyAV (av) cho phép nó giải mã M4A và các định dạng nén khác mà không cần FFmpeg hệ thống. OpenCV có mặt vì vLLM cần nó và cài đặt phụ thuộc của NeMo bỏ sót nó.
Khởi động máy chủ
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
Những cờ đáng hiểu:
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600nâng giới hạn âm thanh của vLLM từ 600 giây lên một giờ. Quên nó và các tệp dài sẽ thất bại.VLLM_USE_V2_MODEL_RUNNER=0giữ trình chạy V1, thứ mà dấu thời gian từng từ cần.--speculative-configbật dự đoán nhiều token với tám token nháp (MTP8). Trên H100, NVIDIA đo được RTFx tiếng Anh theo lô là 270 với MTP8 và 410 với MTP2, vì vậy hãy thử"num_speculative_tokens":2nếu bạn quan tâm đến thông lượng hơn độ trễ.--middleware ... ctc_timestamp_middlewarevà--trust-request-mm-kwargscho phép các yêu cầu yêu cầu dấu thời gian từng từ.- Các cài đặt nhắm đến H100 80 GB. Trên các card khác, hãy giảm
--gpu-memory-utilization,--max-model-lenhoặc--max-num-seqs.
Máy chủ lắng nghe trên 127.0.0.1:8000. Thêm --host 0.0.0.0 để truy cập từ các máy khác trong mạng của bạn.
Gửi một tệp
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("standup.wav", "rb").read()).decode()

response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
Thay hướng dẫn văn bản bằng bất kỳ gợi ý tác vụ nào. Đối với cuộc họp có nhiều giọng nói:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
Yêu cầu dấu thời gian từng từ có các quy tắc: một bản ghi cho mỗi yêu cầu, stream=false và n=1. Phản hồi sau đó bao gồm một đối tượng ctc_timestamps với các từ, thời gian bắt đầu và kết thúc tính bằng giây, và thẻ người nói.
Tùy chọn 2: SGLang-Omni để phiên âm đơn giản
Nếu bạn chỉ cần văn bản từ toàn bộ tệp, SGLang-Omni 0.2.0 đơn giản hơn và không cần NeMo. Nó đã được kiểm chứng trên một H100 80 GB và một RTX PRO 6000 Blackwell với checkpoint BF16 hoặc FP8.
sgl-omni serve \
  --model-path nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --model-name nemotron-transcribe \
  --mem-fraction-static 0.85 \
  --port 8000

curl http://localhost:8000/v1/audio/transcriptions \
  -F model=nemotron-transcribe \
  -F file=@audio.wav
Route /v1/audio/transcriptions đó khớp với hình dạng mà Whisper API của OpenAI sử dụng, vì vậy mã máy khách Whisper hiện có thường chỉ cần một base URL mới. Đánh đổi: không có dấu thời gian từng từ, nhãn người nói, dịch hoặc giải mã suy đoán trong tích hợp này.
Tùy chọn 3: Transformers trong một script
Đối với notebook và các tác vụ một lần, hãy chạy nó trong tiến trình với Hugging Face Transformers được cài đặt từ nguồn:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

prompt = ("Transcribe this audio with punctuation and capitalization. Include all spoken words "
          "and verbal fillers. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription.")
inputs = processor.apply_transcription_request(["podcast.mp3"], prompt=[prompt]).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=4096)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=False))
Đây là cách dễ nhất để bắt đầu và là cách chạy chậm nhất ở quy mô lớn. Tăng max_new_tokens cho các tệp dài: một giờ dày đặc có thể tạo ra khoảng 20.000 token.
Nó nhanh đến mức nào trên GPU của riêng bạn?
Con số tiêu đề của NVIDIA là 2.238 giây âm thanh mỗi giây trên một RTX PRO 6000 Blackwell, với trọng số NVFP4 và giải mã suy đoán DFlash2, và 0,13 giây để trả về một clip 30 giây. Đọc chú thích: những con số đó đến từ NIM được tối ưu hóa, mà các thay đổi phục vụ của nó vẫn chưa mã nguồn mở. Thẻ nói rằng tích hợp vLLM mở dự kiến sẽ chậm hơn khoảng hai lần.
Đối với phiên âm tiếng Anh theo lô trên H100 ở BF16, thẻ liệt kê các số RTFx sau (giây âm thanh mỗi giây tính toán):
| Giải mã suy đoán | RTFx |
|---|---|
| MTP2 | 410 |
| DFlash2, K=7 | 340 |
| MTP8 | 270 |
| DFlash2, K=15 | 260 |
Ngay cả hàng chậm nhất cũng xử lý một giờ âm thanh trong dưới 15 giây thời gian GPU khi làm việc theo lô. Nếu bạn muốn mô hình nháp DFlash2, lưu ý rằng vLLM 0.32.0 cần một bản vá nhỏ từ thẻ, DFlash2 vô hiệu hóa dấu thời gian từng từ, và bạn không nên kết hợp nó với MTP.
Các vấn đề thường gặp và cách khắc phục
- Tệp dài bị cắt ở 10 phút. Bạn đã bỏ qua
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600. - Không có dấu thời gian trong phản hồi. Kiểm tra
VLLM_USE_V2_MODEL_RUNNER=0, cờ--middleware, và rằng yêu cầu cóstream=falsevà một bản ghi. - Hết bộ nhớ trên các card nhỏ hơn. Chuyển sang checkpoint FP8 hoặc NVFP4 và giảm
--max-num-seqs. - Các cụm từ lặp lại ở cuối bản phiên âm. Thẻ khuyến nghị một rào chắn vòng lặp sinh trên đầu ra cuối cùng. Giới hạn
max_tokensvà cắt bỏ phần lặp lại. - Sai chính tả tên. Thêm
Context terms: <names>vào gợi ý. - Giọng nói nền trong bản phiên âm. Hãy thử gợi ý trường gần thử nghiệm từ thẻ, giúp giảm WER trên âm thanh hỗn hợp từ 27,32% xuống 4,78% trong thử nghiệm của NVIDIA.
Nếu bạn mới làm quen với chính vLLM, bài giải thích về vLLM của chúng tôi đề cập đến cách nó xử lý theo lô các yêu cầu và quản lý bộ nhớ GPU.
Để tác nhân lập trình của bạn kiểm tra máy chủ cục bộ bằng Apidog CLI
Một mô hình cục bộ chỉ hữu ích nếu điểm cuối của nó vẫn chính xác qua các nâng cấp vLLM, tinh chỉnh gợi ý và hoán đổi checkpoint. Hãy để tác nhân lập trình của bạn đảm nhận việc đó với Apidog CLI, chạy kiểm tra đối với http://127.0.0.1:8000 từ cùng một máy.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho tác nhân của bạn một gợi ý:
In Apidog project <id>, add POST {{baseUrl}}/v1/chat/completions for my local
Nemotron 3.5 Transcribe server. Create test cases that send samples/en.wav and
samples/two-speakers.wav as base64 audio_url content with temperature 0, and assert
status 200, a non-empty choices[0].message.content, and at least two distinct <spk:N>
tags for the two-speaker file. Run them against the local environment and report failures.
Tác nhân đọc schema, xác thực payload của nó, viết các ca kiểm thử và chạy chúng:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Chạy nó sau mỗi lần nâng cấp máy chủ, hoặc kết nối apidog run ... -r junit vào CI như được hiển thị trong Apidog CLI trong pipeline CI/CD. Để thiết lập tác nhân, xem Apidog CLI trong Claude Code.
Câu hỏi thường gặp
Tôi có thể chạy Nemotron 3.5 Transcribe trên RTX 4090 không? Nó không có trong danh sách tương thích của NVIDIA. Card tiêu dùng nhỏ nhất được liệt kê là RTX 5090 với checkpoint NVFP4.
Nó có chạy trên Mac không? Không có môi trường chạy chính thức nào hỗ trợ Apple Silicon tính đến ngày 29 tháng 10 năm 2026.
Sử dụng cục bộ có miễn phí cho sản phẩm thương mại không? Giấy phép OpenMDW-1.1 cho phép sử dụng thương mại và phi thương mại. Đọc văn bản giấy phép để biết điều khoản ghi công trước khi phát hành.
Nó có thể phiên âm âm thanh trực tiếp không? Không. Đây là mô hình ngoại tuyến cho các tệp đã ghi. NVIDIA cung cấp một mô hình Nemotron 3.5 ASR Streaming riêng cho sử dụng trực tiếp.
Cái nào nhanh hơn, vLLM hay SGLang-Omni? NVIDIA không công bố so sánh trực tiếp. Sử dụng vLLM khi bạn cần dấu thời gian, người nói hoặc dịch, và SGLang-Omni cho máy chủ chỉ văn bản đơn giản nhất.
Nó xếp hạng như thế nào so với các mô hình cục bộ khác? Nó dẫn đầu mọi mô hình trọng số mở trên Bảng xếp hạng ASR mở ngày 28 tháng 10. Danh sách các mô hình chuyển giọng nói thành văn bản mã nguồn mở tốt nhất của chúng tôi so sánh nó với Qwen3-ASR, Granite Speech, Canary-Qwen, Voxtral và Whisper.
Chạy nó
Tải xuống checkpoint phù hợp với GPU của bạn, khởi động vLLM với giới hạn âm thanh một giờ và middleware dấu thời gian, và gửi tệp WAV qua máy khách OpenAI. Sau đó để tác nhân của bạn chạy kiểm tra Apidog đối với điểm cuối cục bộ để mỗi lần nâng cấp chứng minh nó vẫn phiên âm trước khi bạn tin tưởng nó với các bản ghi thực.