
Để chạy ERNIE 5.5 Flash trên máy cục bộ, hãy cài vLLM 0.32.0 cùng plugin vLLM-ERNIE của Baidu, rồi chạy vllm serve baidu/ERNIE-5.5-Flash-Base với data parallelism và expert parallelism trên một node đa GPU. Bạn sẽ có một server tương thích OpenAI trên cổng 8000. Điểm cần lưu ý: bản trọng số mở hiện tại là mô hình Base, một checkpoint tiền huấn luyện chỉ tiếp nối văn bản chứ không phải mô hình chat.
Bên dưới là: những gì bạn có thể tải xuống, cấu hình phần cứng Baidu công bố, các lệnh serve chính xác và cách kiểm tra endpoint. Mọi lệnh và số liệu dưới đây đều lấy từ thẻ mô hình Hugging Face của Baidu và kho lưu trữ vLLM-ERNIE, đã kiểm tra vào ngày 12 tháng 11 năm 2026.
Còn mới lạ với mô hình này? Hãy bắt đầu với ERNIE 5.5 Flash là gì. Nếu bạn muốn dùng mô hình chat mà không cần cụm GPU, hướng dẫn API ERNIE 5.5 Flash là con đường nhanh hơn.
Bạn có thể chạy gì trên máy cục bộ ngay hôm nay?
Bạn có thể chạy ERNIE 5.5 Flash Base, được phát hành trên Hugging Face ở định dạng FP8 và BF16. Đây là mô hình sparse mixture-of-experts 280 tỷ tham số với 14 tỷ tham số được kích hoạt mỗi token, huấn luyện trên 33,5 nghìn tỷ token. Bản ERNIE 5.5 Flash Preview đã tinh chỉnh cho chat hiện chỉ có qua API; Baidu cho biết trọng số sẽ sớm ra mắt "sớm" theo giấy phép Apache 2.0.
So sánh hai bản phát hành khi tự lưu trữ:
| ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview | |
|---|---|---|
| Bản chất | Checkpoint cuối giai đoạn tiền huấn luyện | Mô hình hậu huấn luyện đầu tiên (chat, suy luận, agent) |
| Trọng số | Hugging Face và ModelScope, FP8 và BF16 | Chưa phát hành tính đến 12/11/2026 |
| Endpoint bạn gọi | /v1/completions (tiếp nối văn bản) |
Chat completions với suy luận và công cụ |
| Giấy phép | ERNIE 5.5 Flash Base Model License v1.0 | Apache 2.0 được hứa khi phát hành |
| Nơi sử dụng hiện nay | GPU của riêng bạn | Qianfan API, OpenRouter |
Hiện tại, bộ sưu tập ERNIE-5.5-Flash của Baidu chỉ có hai checkpoint Base, và README của vLLM-ERNIE ghi mô hình chat là "Coming soon". bài viết phát hành Preview không nêu ngày cụ thể.
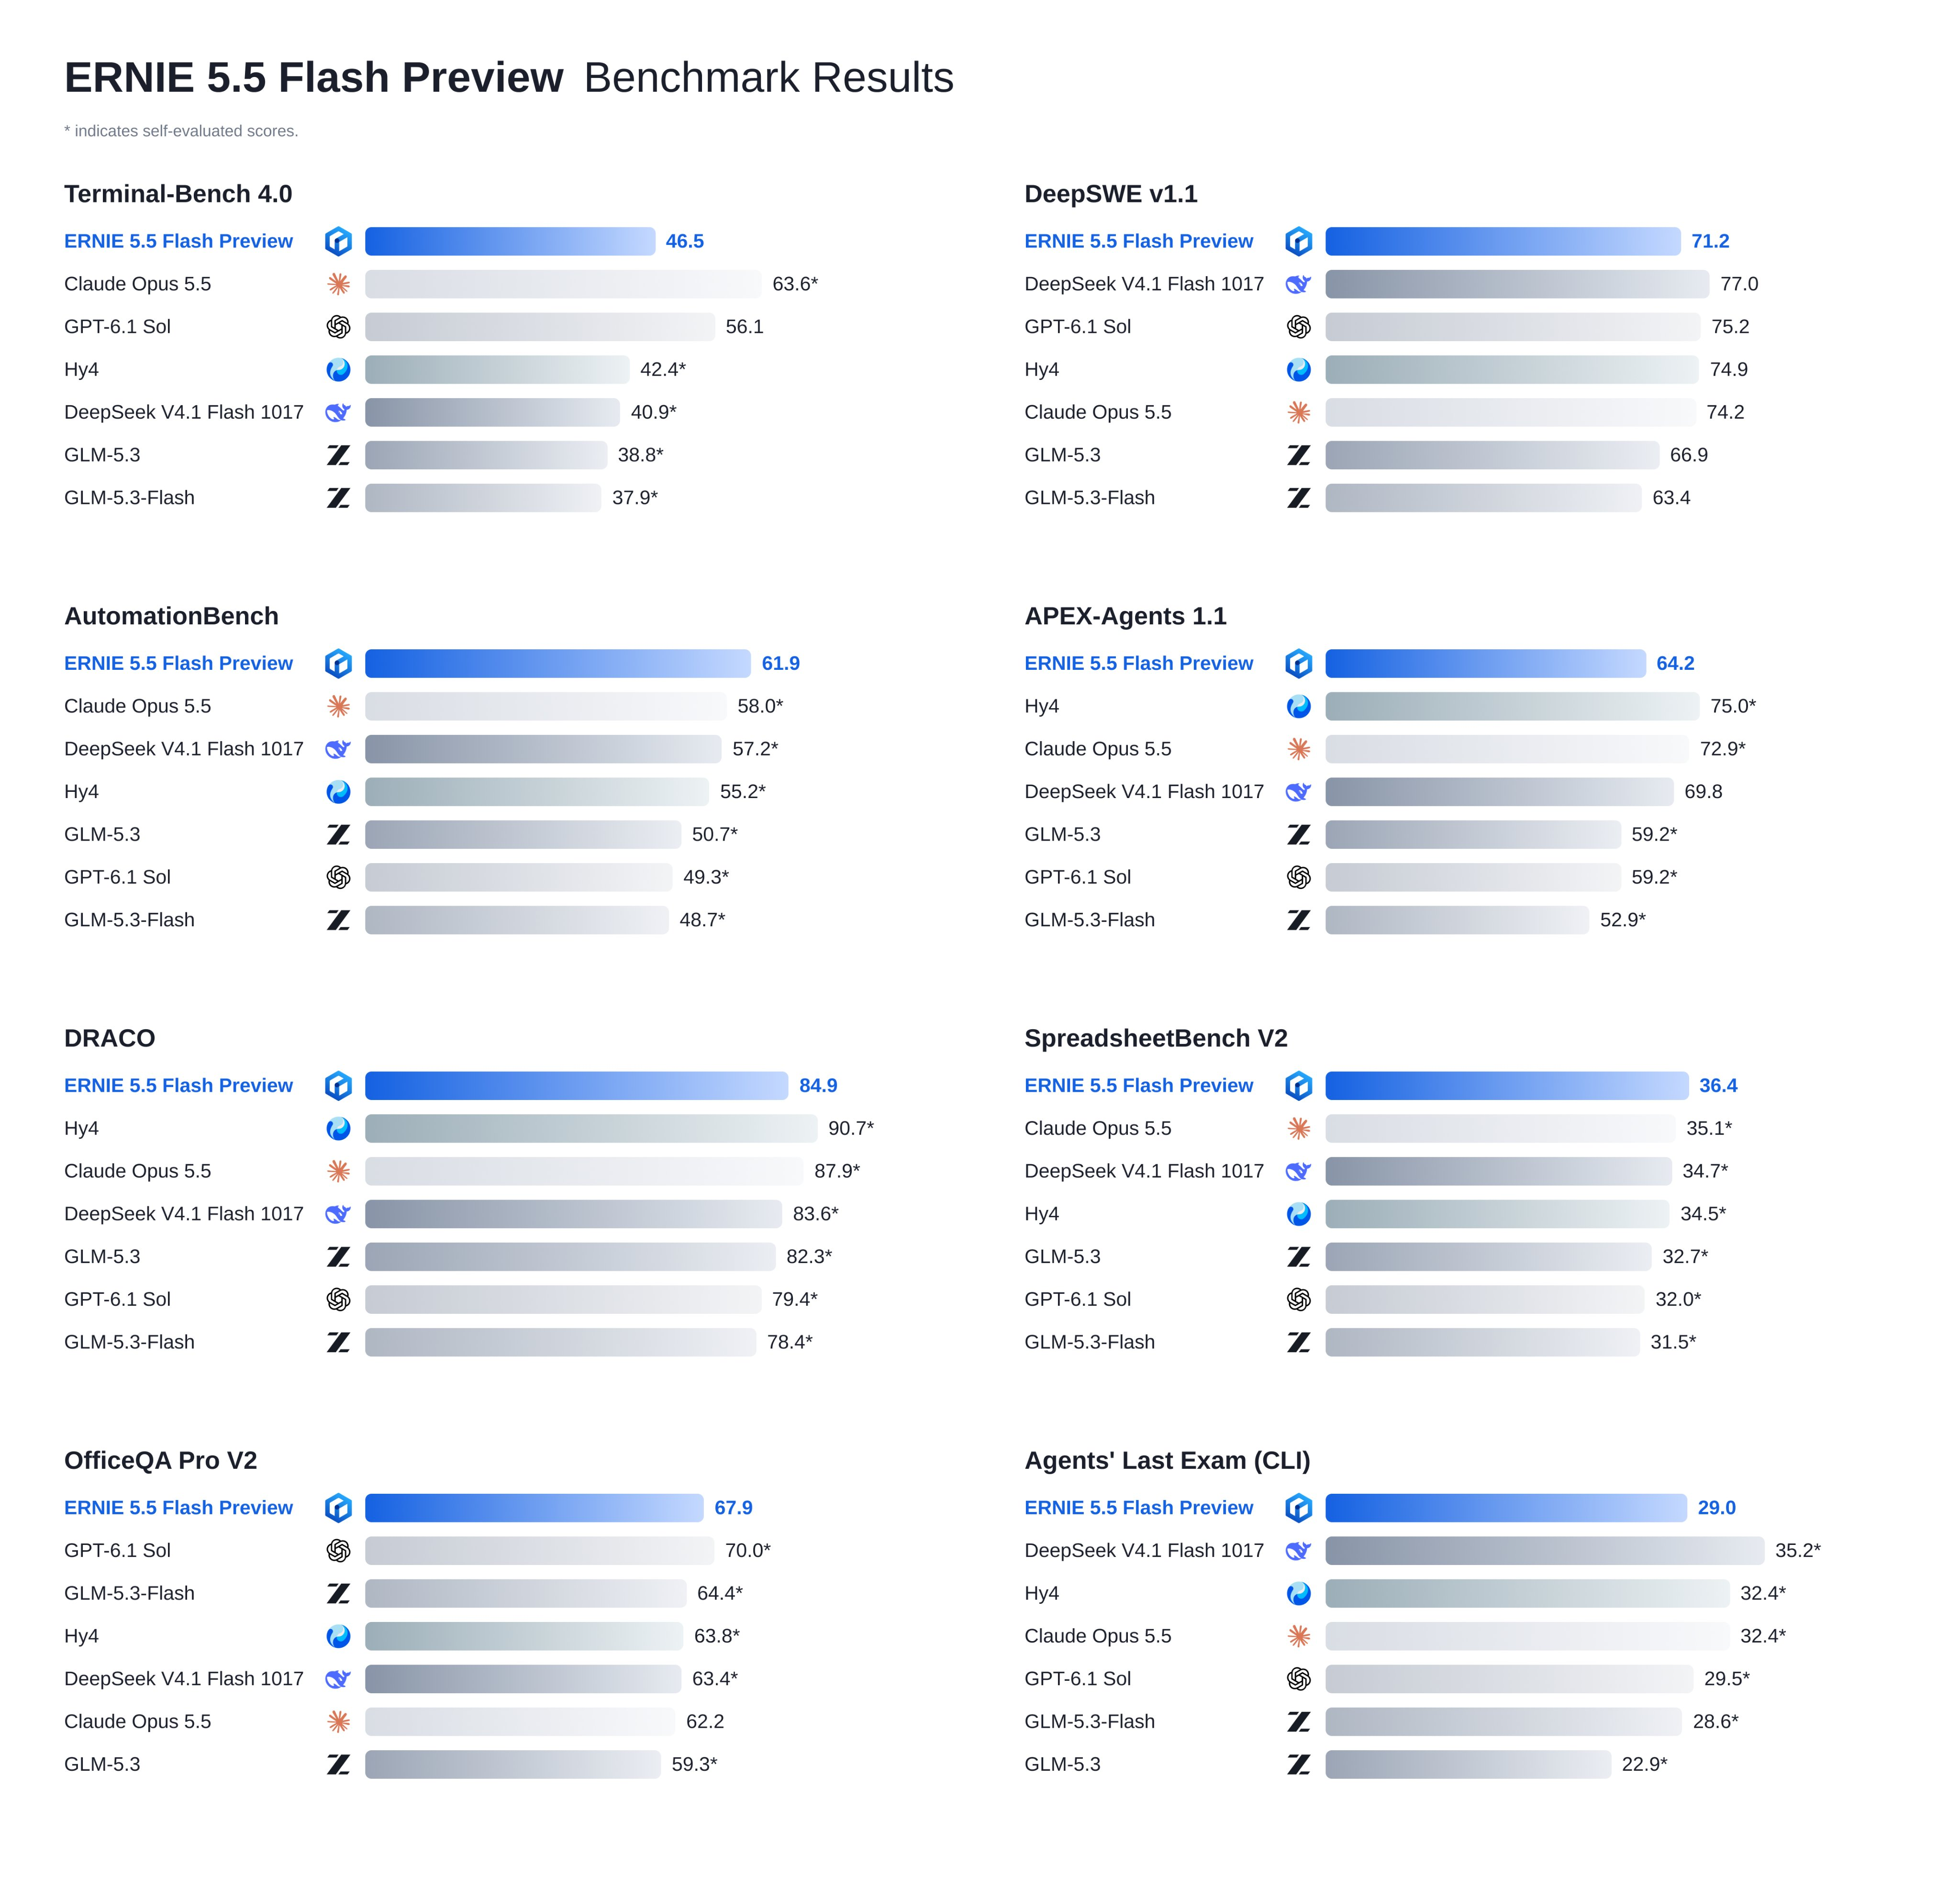
Nếu bạn cần một trợ lý lập trình ngay hôm nay, mô hình Base chạy cục bộ sẽ không đáp ứng được. Nhưng nếu bạn cần điểm khởi đầu cho fine-tuning hoặc nghiên cứu few-shot, Base chính là thứ Baidu xây dựng nó cho mục đích đó.
Yêu cầu phần cứng của ERNIE 5.5 Flash
Trọng số FP8 chiếm khoảng 280 GB bộ nhớ GPU và BF16 khoảng 560 GB, vì vậy đây là công việc cho server đa GPU chứ không phải laptop. README của vLLM-ERNIE liệt kê số GPU tối thiểu đủ chứa trọng số, và plugin chỉ chạy trên GPU NVIDIA.
| Bộ nhớ GPU mỗi card | FP8 (~280 GB trọng số) | BF16 (~560 GB trọng số) |
|---|---|---|
| 288 GB | 2 GPU | 4 GPU |
| 192 GB | 4 GPU | 8 GPU (hoặc 2 node x 4 GPU) |
| 80 GB | 8 GPU | 2 node x 8 GPU |
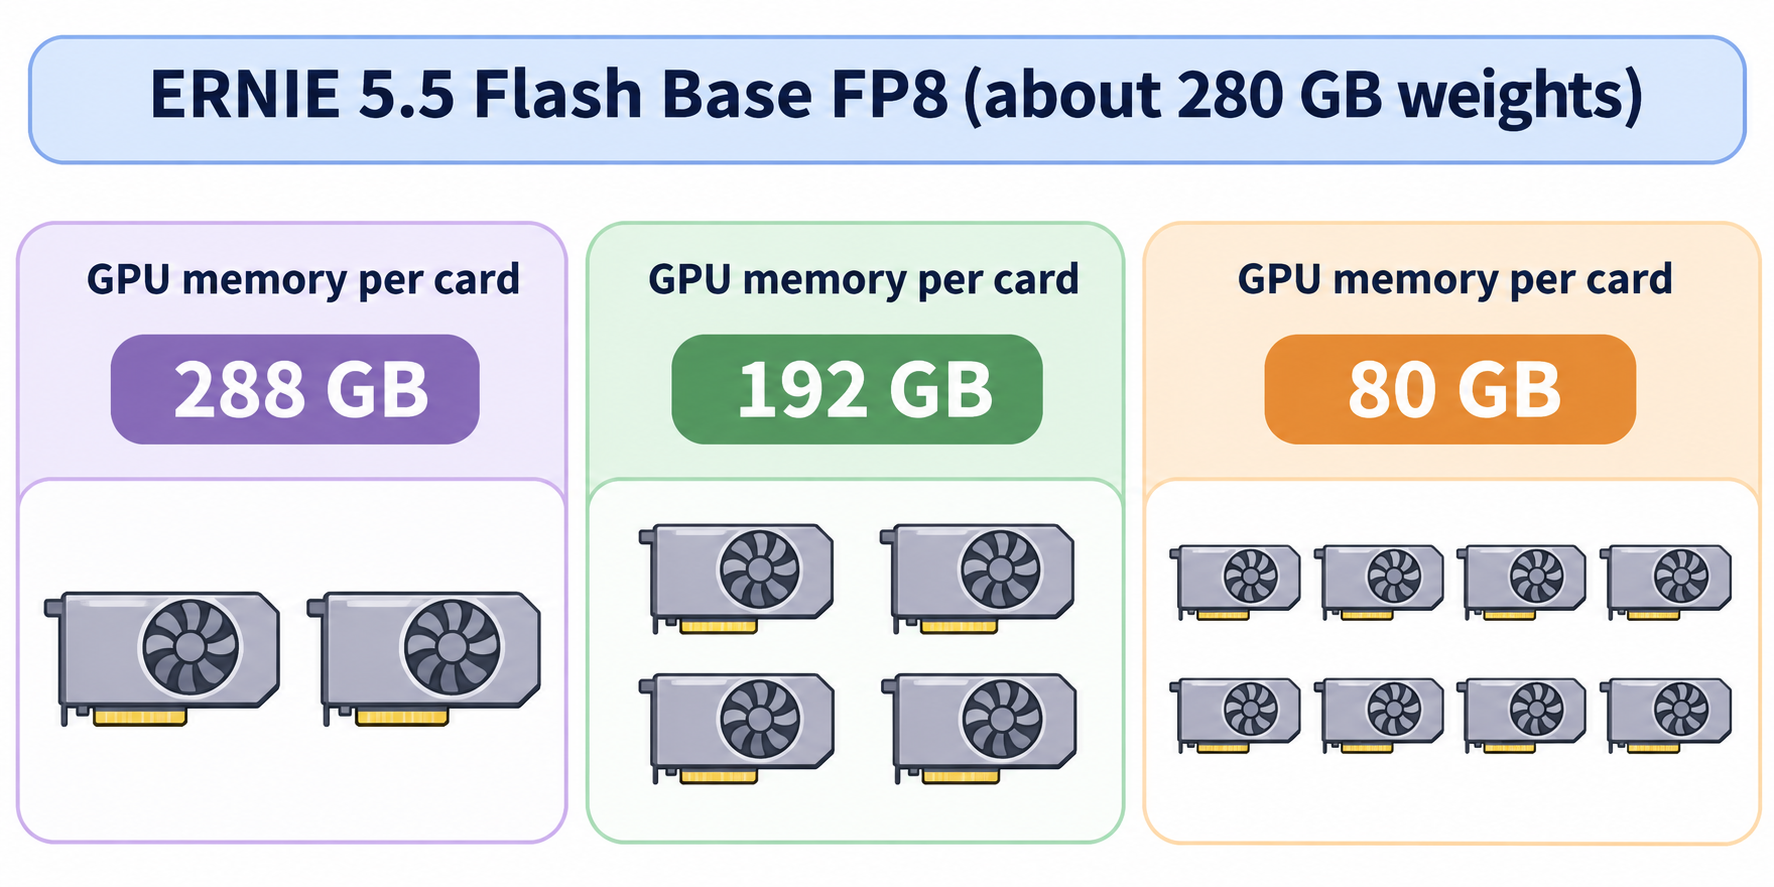
Đó là mức tối thiểu để nạp trọng số. KV cache cần thêm không gian bên trên, đó là lý do chiều dài ngữ cảnh bạn có thể phục vụ phụ thuộc vào card của bạn:
- GPU 80 GB: phục vụ FP8 trên 8 GPU với
--data-parallel-size 8và--gpu-memory-utilization 0.93. Chứa được tối đa 262.144 token; 1 triệu thì không. - Ngữ cảnh 1 triệu token: các giá trị của Baidu dành cho GPU có 184 GiB bộ nhớ, với utilization giảm xuống 0,85 vì một prefill 1 triệu token cần hàng chục GB bộ nhớ tạm.
- Kiến trúc rất quan trọng: các lệnh FP8 truyền
--moe-backend humming, hỗ trợ activation SiTU của mô hình với trọng số FP8 trên GPU Blackwell. Trên GPU Hopper, hãy bỏ cờ này và giữ kernel MoE mặc định của vLLM.
"Cục bộ" nghĩa là phần cứng bạn kiểm soát: một node 8 GPU thuê, server on-prem hoặc cụm máy phòng thí nghiệm.
Cài vLLM và plugin ERNIE
vLLM không hỗ trợ kiến trúc ERNIE 5.5 (Ernie5_5_MoeForCausalLM) ngay từ đầu. Baidu cung cấp nó dưới dạng plugin chạy trên wheel vLLM 0.32.0 đã phát hành, không cần sửa đổi. Tạo môi trường Python 3.12 và cài cả hai:
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
Plugin được nạp qua entry point vllm.general_plugins của vLLM trong mọi tiến trình vLLM. Nếu vllm serve sau đó báo Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported, nghĩa là plugin chưa được cài trong môi trường chạy vllm, hoặc VLLM_PLUGINS được đặt mà không có ernie trong đó.
Để tải trọng số từ ModelScope thay vì Hugging Face, hãy đặt VLLM_USE_MODELSCOPE=True. Tên repo giống nhau trên cả hai nền tảng. Nếu bạn mới làm quen với vLLM, tổng quan về vLLM của chúng tôi giải thích về server và API tương thích OpenAI của nó.
Lệnh vllm serve cho ERNIE 5.5 Flash
Đây là lệnh FP8 từ README của vLLM-ERNIE, dành cho một node 4 GPU ở ngữ cảnh huấn luyện 128K với ECHO speculative decoding bật:
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
Ý nghĩa của từng lựa chọn, theo ghi chú của Baidu:
- Data parallel attention cộng expert parallel MoE (
--data-parallel-size 4 --enable-expert-parallel) giữ được nhiều KV cache nhất và cho throughput cao nhất. Tensor parallelism (--tensor-parallel-size2, 4 hoặc 8) giảm độ trễ ở mức đồng thời thấp nhưng giữ ít KV cache hơn. - KV cache FP8 (
--kv-cache-dtype fp8) lưu cache ở định dạng FP8;autogiữ ở BF16. - ECHO speculative decoding tái sử dụng lớp cuối của chính mô hình như một draft tích hợp sẵn. Ở đây nó draft 2 bước; 1 hoặc 3 bước cũng hoạt động. Bỏ
--speculative-configđể phục vụ không dùng draft.
Thẻ mô hình hiển thị một biến thể ngắn hơn trên cổng 30000, không có cấu hình speculative.
Khóa bảo mật lại server. Các lệnh này liên kết 0.0.0.0 mà không có xác thực. README của Baidu khuyên nên thêm --api-key <key> hoặc liên kết 127.0.0.1 trừ khi mạng là đáng tin cậy. Hãy làm một trong hai trước khi mở cổng ra ngoài.
BF16 và ngữ cảnh 1M
BF16 chạy trên hai node 4 GPU (DP8 cộng EP8) với --data-parallel-size 8, --data-parallel-size-local 4, --data-parallel-address ${HEAD_IP} và --data-parallel-hybrid-lb; node thứ hai thêm --data-parallel-start-rank 4. Sao chép lệnh đầy đủ từ README; nó cũng đặt giao diện mạng giữa các node.
Để dùng toàn bộ cửa sổ 1.048.576 token, hãy truyền --max-model-len 1048576 và --gpu-memory-utilization 0.85, đồng thời giảm --max-num-seqs để KV cache của mỗi rank chứa được các yêu cầu nguyên vẹn 1 triệu token.
Gọi endpoint tương thích OpenAI
vLLM cung cấp các route theo kiểu OpenAI, nhưng mô hình base không có chat template, vì vậy bạn gọi /v1/completions với prompt thô. Với cách dùng few-shot, hãy đưa các ví dụ vào prompt và dừng ở cuối một câu trả lời:
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
README của Baidu cho biết phần văn bản completion trả về là 36. Ba chi tiết dễ khiến người dùng gặp vấn đề:
- Truyền
"temperature": 0để có greedy decoding.generation_config.jsoncủa mô hình đặtdo_sample=false,temperature=1.0vàtop_p=0.95. vLLM áp dụng temperature và top_p nhưng bỏ quado_sample, nên nó sẽ lấy mẫu trừ khi bạn ghi đè. - Đừng tự thêm
<|ERNIE_MASK|>. Tokenizer sẽ tự chèn nó (token id 2) vào trước prompt completion. - Khớp tên mô hình. Dùng
baidu/ERNIE-5.5-Flash-Base-BF16khi phục vụ trọng số BF16.
Bất kỳ OpenAI SDK nào cũng hoạt động nếu bạn trỏ base_url đến http://<host>:8000/v1 và gọi completions chứ không phải chat completions.
Base hay Preview: nên dùng cái nào?
Dùng Base khi bạn định huấn luyện thêm trên nền nó; dùng Preview khi bạn cần một trợ lý hoạt động ngay. Base cho bạn toàn quyền kiểm soát và dữ liệu không bao giờ rời khỏi server của bạn. Preview cho bạn chat, suy luận và gọi công cụ, nhưng chỉ qua Qianfan hoặc OpenRouter.
Khi trọng số Preview ra mắt, plugin đã sẵn sàng hỗ trợ chúng. README tài liệu các cờ bổ sung, được đánh dấu "Coming soon": --reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice, cộng với một mô hình draft DSpark cho speculative decoding. Phần suy nghĩ sẽ xuất hiện trong reasoning_content và các lời gọi công cụ trong message.tool_calls, nên server bạn xây dựng hôm nay trở thành backend chat chỉ bằng việc đổi trọng số và thêm ba cờ.
Giấy phép là điểm khác biệt còn lại. Base phát hành theo Thoả thuận Giấy phép ERNIE 5.5 Flash Base Model v1.0, không phải Apache 2.0. Hãy đọc toàn bộ giấy phép trước khi xây sản phẩm trên nó. Tính đến ngày 12 tháng 11 năm 2026, giấy phép ghi:
- Sử dụng phi thương mại miễn phí, không cần thông báo.
- Sử dụng thương mại khi sản phẩm liên quan thu dưới 50 triệu USD mỗi năm được miễn phí giấy phép, nhưng bạn phải hiển thị "Powered by ERNIE" và gửi Baidu một thông báo một lần.
- Trên 50 triệu USD mỗi năm, bạn cần sự cho phép bằng văn bản riêng từ Baidu trước.
- "Territory" của giấy phép không bao gồm Liên minh châu Âu, Vương quốc Anh và Hàn Quốc.
Đối với một mô hình open-weights nhỏ hơn bạn có thể tự lưu trữ với ít GPU hơn, xem hướng dẫn tự lưu trữ GLM-5.3 của chúng tôi.
Để agent lập trình của bạn kiểm tra endpoint bằng Apidog CLI
Một bản triển khai vLLM mới cần một bài smoke test có thể chạy lại sau mỗi lần thay đổi cờ: trạng thái, schema phản hồi và token mỗi giây. Giao việc đó cho agent lập trình và Apidog CLI thay vì gõ lại curl.
Cài đặt CLI một lần:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho Claude Code, Codex hoặc Cursor một prompt duy nhất:
In Apidog project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?\nAnswer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
Agent sẽ đọc schema payload, xác thực nó, tạo test case và chạy:
apidog environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
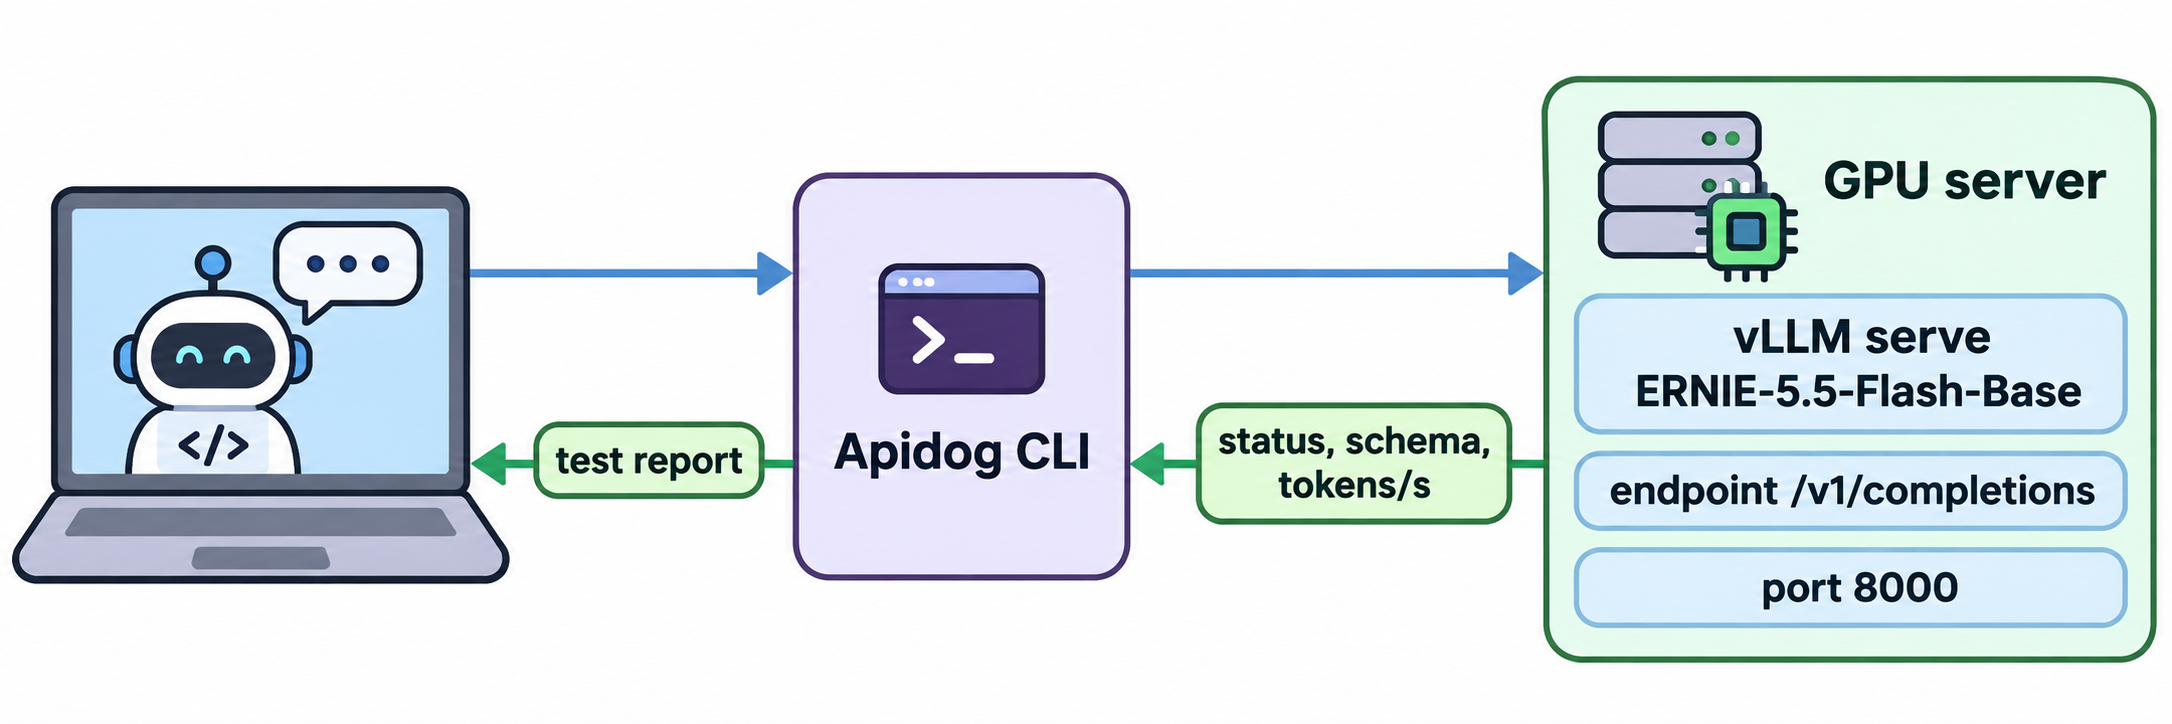
Chạy CLI từ một máy có thể truy cập cổng 8000. Nếu bạn đặt --api-key trên server, hãy yêu cầu agent lưu nó dưới dạng biến môi trường và gửi như một Bearer token. Chạy lại cùng test case sau khi bạn đổi --tensor-parallel-size, bỏ speculative decoding hoặc tăng --max-model-len, và bạn có được một so sánh cùng điều kiện. Thêm -r junit và cùng lần chạy đó sẽ được đưa vào CI. Xem hướng dẫn từng bước thiết lập agent tại Apidog CLI trong Claude Code. Gói Apidog Free hỗ trợ tới 4 người dùng.
Câu hỏi thường gặp
Có thể chạy ERNIE 5.5 Flash trên một GPU cá nhân không? Không. Trọng số FP8 khoảng 280 GB, và cấu hình nhỏ nhất Baidu công bố là 2 GPU 288 GB mỗi card. Với card 80 GB, bạn cần 8 cái. Hãy dùng Preview qua API nếu bạn không có phần cứng đó.
Trọng số ERNIE 5.5 Flash Preview đã có sẵn chưa? Chưa, tính đến 12 tháng 11 năm 2026. Baidu cho biết sẽ mở nguồn theo Apache 2.0 sớm, và plugin vLLM-ERNIE liệt kê mô hình chat là "Coming soon". Chỉ có trọng số Base (FP8 và BF16) trên Hugging Face.
Tại sao /v1/chat/completions bị lỗi trên mô hình Base? Base không được huấn luyện chat và không có chat template. Baidu phục vụ nó qua /v1/completions với prompt văn bản thô. Hãy đưa các ví dụ few-shot vào prompt và dùng stop sequence.
vLLM có hỗ trợ ERNIE 5.5 nguyên bản không? Không, trong lõi vLLM. Bạn cần plugin vLLM-ERNIE của Baidu trên nền vLLM 0.32.0. Nó chỉ chạy trên GPU NVIDIA. SGLang cũng phục vụ mô hình này qua một Docker image riêng được nêu trên thẻ mô hình.
Có thể dùng ERNIE 5.5 Flash Base cho mục đích thương mại không? Có, với điều kiện. Sản phẩm thu dưới 50 triệu USD mỗi năm có thể dùng miễn phí giấy phép với ghi nhận "Powered by ERNIE" và một thông báo một lần cho Baidu. Trên mức đó, bạn cần cho phép bằng văn bản, và phạm vi giấy phép không bao gồm EU, Vương quốc Anh và Hàn Quốc.