
Bạn có thể chạy DeepSeek V4 Flash ngay trên máy本地 mà không cần GPU bằng llama-modchip — một bộ bản vá llama.cpp mã nguồn mở giúp thu gọn mô hình 284B xuống file GGUF 56,56 GiB với mật độ 1,71 bit mỗi trọng số. Trên con chip laptop AMD Zen 5 16 nhân với 64 GB RAM, tốc độ prefill đạt khoảng 44 token/giây và decode đạt 9 đến 15 token/giây, không hề dùng đến swap.
Bài hướng dẫn này sẽ đề cập đến phần cứng cần thiết, các lệnh cụ thể, sự đánh đổi về chất lượng, và cách để agent lập trình của bạn kiểm thử endpoint cục bộ.
llama-modchip thực sự làm gì
llama-modchip là một bộ bản vá kernel ggml và llama.cpp, cùng các bộ mã hóa chuyển đổi lượng tử hóa và công cụ runtime, cho phép chạy các mô hình Mixture-of-Experts thưa hoàn toàn trong RAM hệ thống. Bản phát hành v2.4.0 nhắm đến hai quy mô mô hình: DeepSeek-V4-Flash 284B trên máy 64 GB và các mô hình MoE 30B trên máy 16 đến 32 GB.
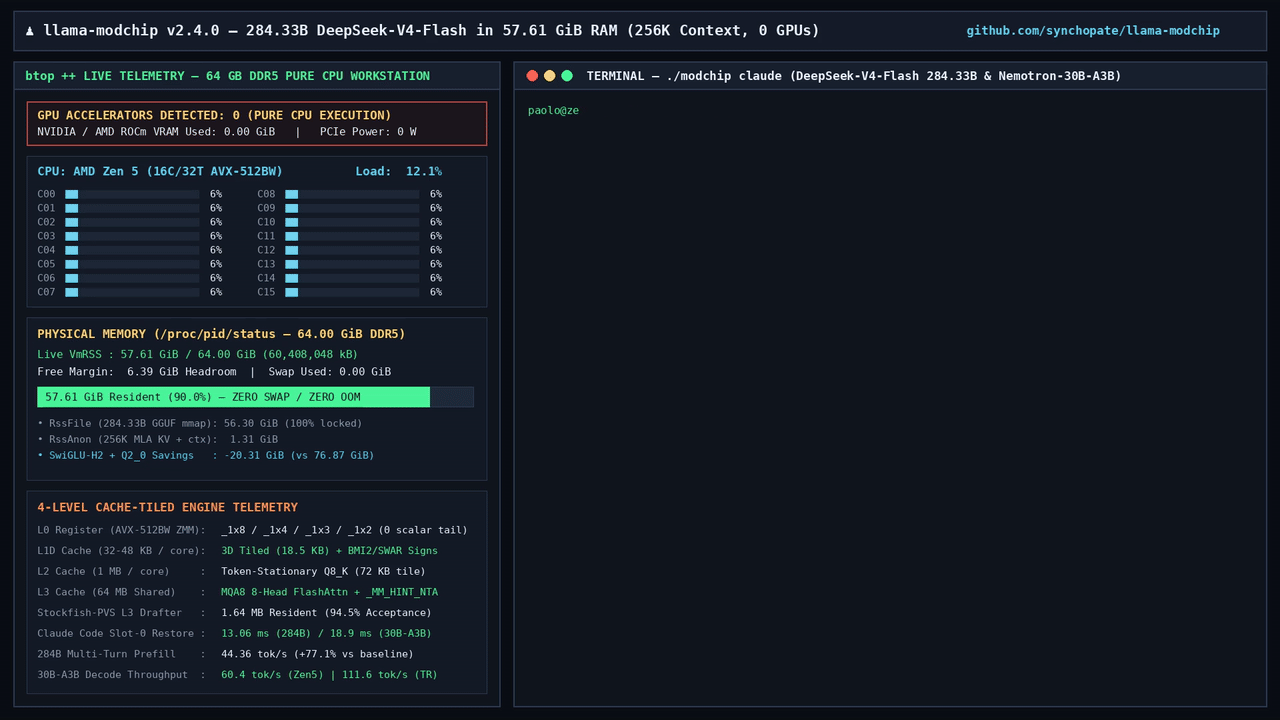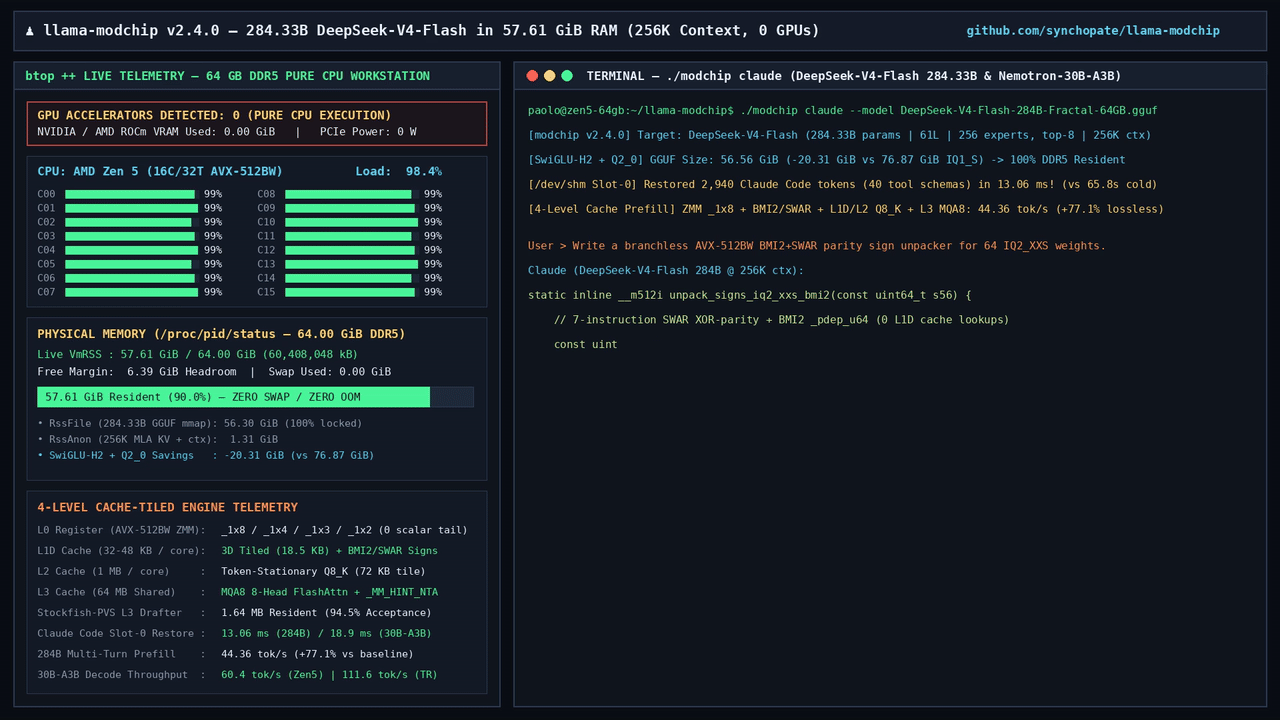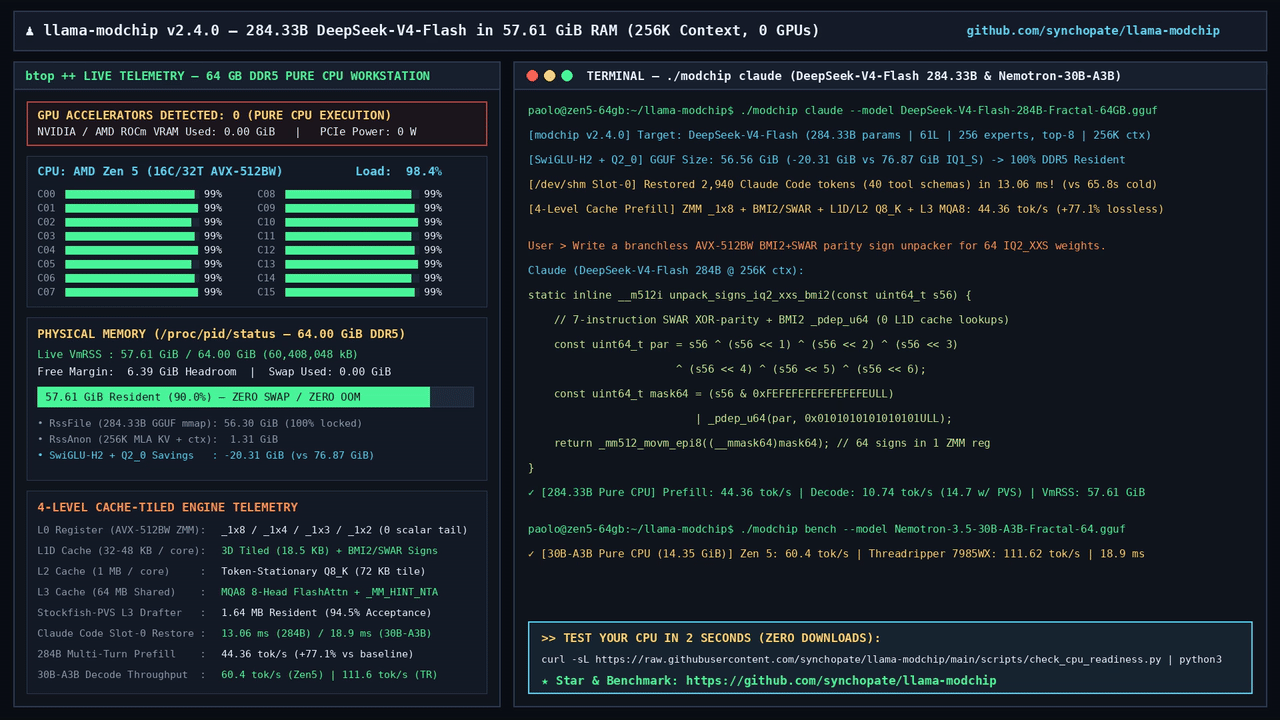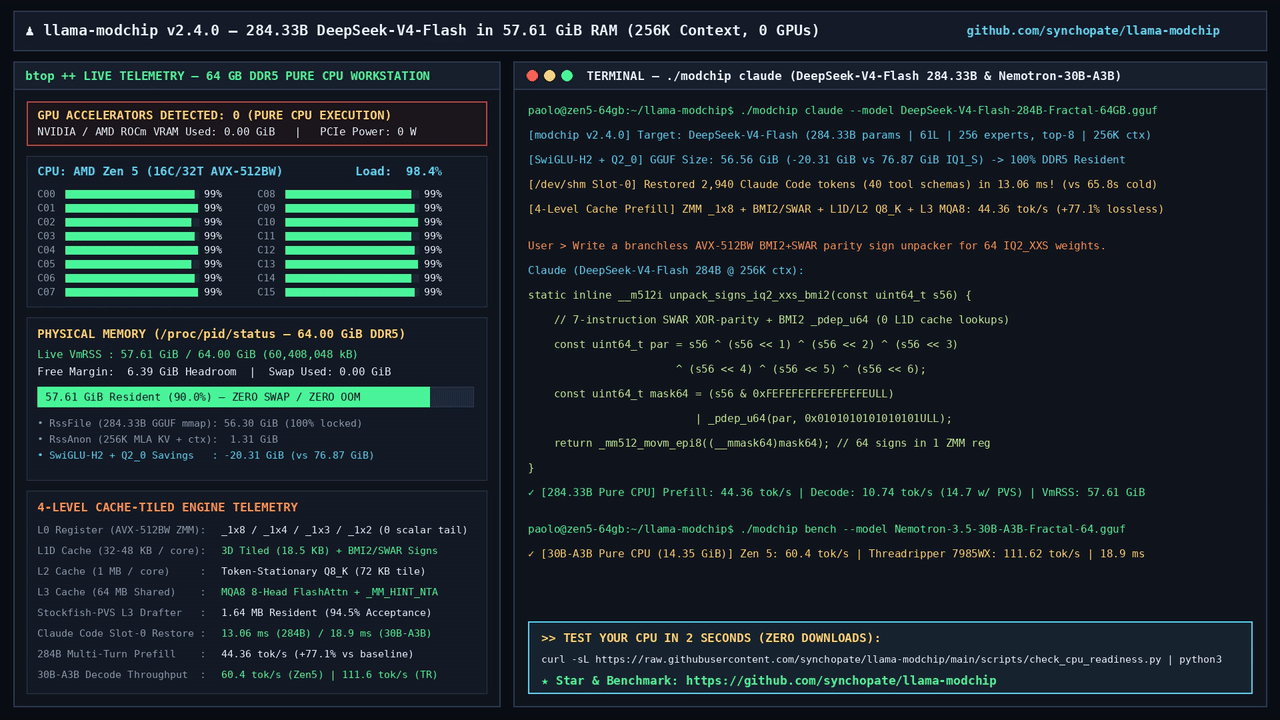
Dự án được đăng lên Hacker News ngày 8 tháng 11 năm 2026 và đạt 370 điểm. Kho mã nguồn được cấp phép Apache 2.0.
Ba yếu tố giúp bản 284B có thể vừa bộ nhớ:
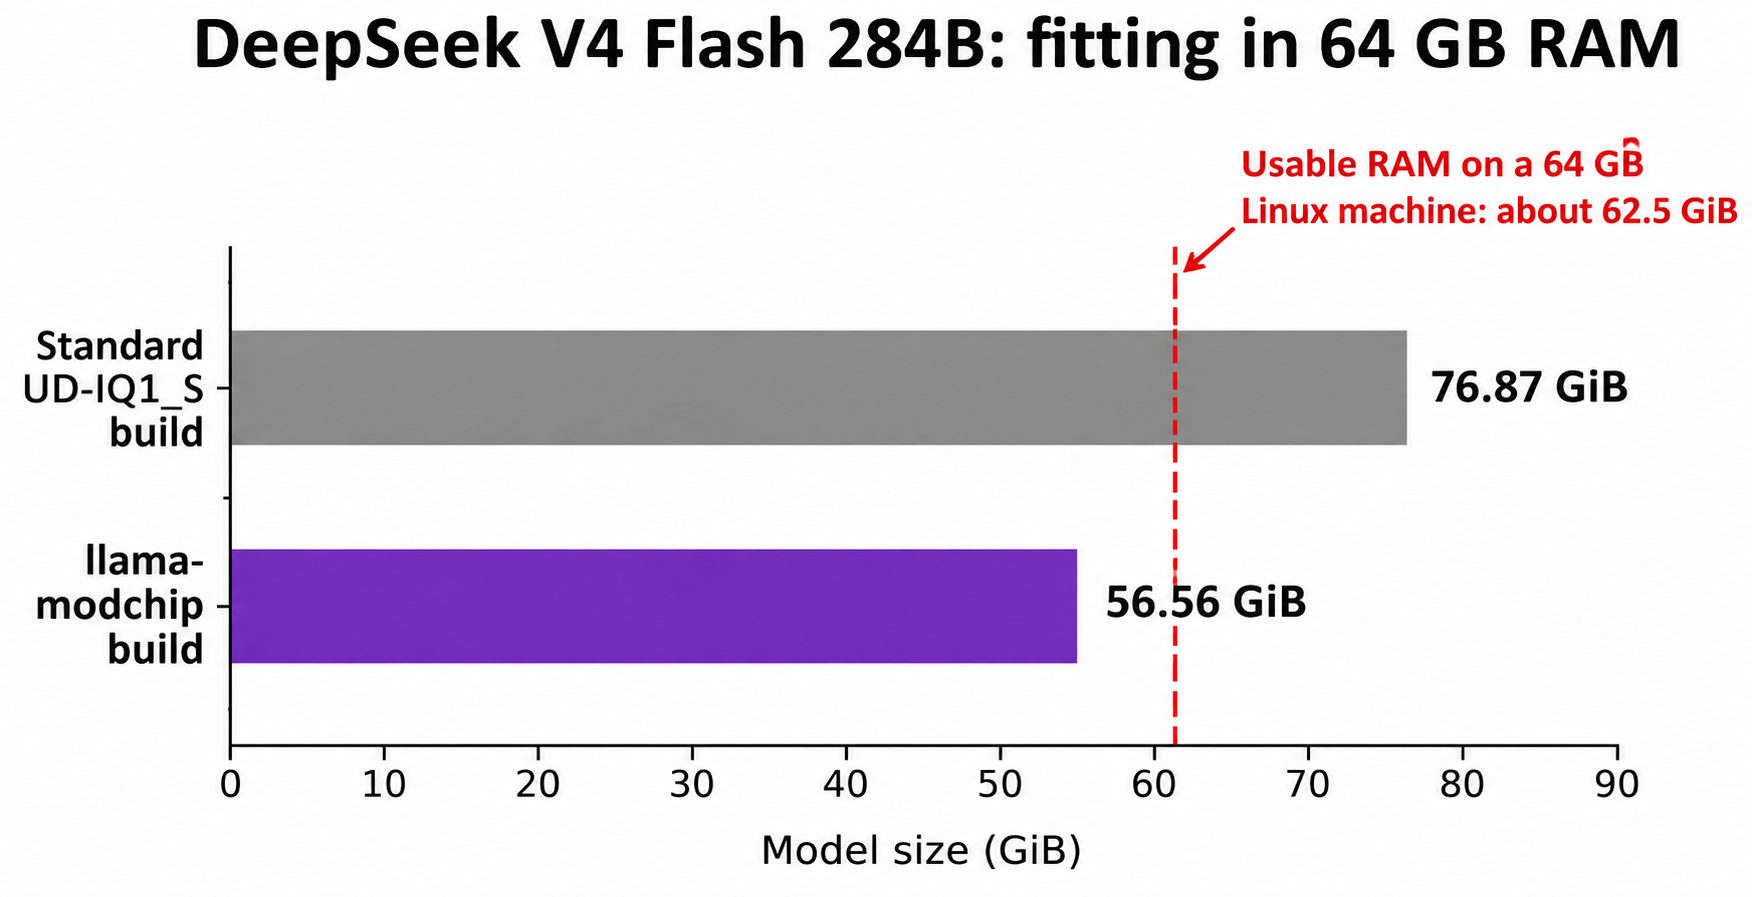
- Checkpoint nhỏ hơn. Bản chuẩn Unsloth
UD-IQ1_Scó dung lượng 76,87 GiB, vượt quá mức khoảng 62,5 GiB mà một máy Linux 64 GB có thể sử dụng. llama-modchip chuyển mã nó xuống 56,56 GiB. - Phân tán cache CPU. Các kernel prefill chia nhỏ công việc trên các thanh ghi và cache L1 đến L3: đạt 25,0 đến 44,36 token/giây trên Zen 5 16 nhân — tăng 77%.
- Tự dự thảo theo dạng speculative. Một bộ dự thảo n-gram dung lượng 1,64 MB nâng tốc độ decode từ khoảng 9 lên tối đa 14,7 token/giây.
Theo mặc định, cả 6 expert được định tuyến cùng expert dùng chung đều chạy ở mọi lớp, nên không có phần nào bị cắt bỏ.
Phần cứng cần có để chạy DeepSeek V4 Flash cục bộ
Bạn cần 64 GB RAM hệ thống và CPU x86_64 đời mới, tốt nhất là có hỗ trợ AVX-512. Mọi con số 284B trong bài này đều do người bảo trì đo trên một máy duy nhất: AMD Ryzen 9 9955HX (16 nhân, 32 luồng, 64 MB L3) với 64 GB DDR5 trên Linux, không dùng GPU.
| Máy của bạn | RAM | Cấu hình trong README | Tốc độ báo cáo (0 GPU) |
|---|---|---|---|
| Laptop hoặc mini PC | 16 đến 32 GB | Nemotron-3.5-30B-A3B, 14,35 GiB | 25,0 đến 60,4 tok/s |
| Máy để bàn hoặc server | 64 GB | DeepSeek-V4-Flash 284B, 56,56 GiB | 44,4 tok/s prefill, 9,1 đến 14,7 tok/s decode |
| Workstation 8 kênh | 128 GB trở lên | DeepSeek 284B hoặc Nemotron 30B | 111,62 tok/s (chỉ bản 30B) |
- Bộ nhớ đạt đỉnh 57,61 đến 58,9 GiB ở ngữ cảnh 256K, vẫn dưới ngưỡng sử dụng được là 62,5 GiB. Hãy đóng mọi thứ khác trước khi tải mô hình.
- Bản nhị phân dựng sẵn chỉ dành cho Linux x86_64 (
llama-server-modchip-linux-x86_64). Tập lệnh cài đặt./modchiphỗ trợ cả Linux và macOS. Các kết quả Apple Silicon trong README áp dụng cho mô hình 30B, không phải bản 284B. [KIỂM CHỨNG] xem bản 284B có chạy được trên máy Mac 64 GB hay không. - Băng thông bộ nhớ là giới hạn tối đa. Phần FAQ cho biết bo m chủ server 8 hoặc 12 kênh tăng tốc decode gấp khoảng 3 đến 4 lần so với DDR5 hai kênh.
Kho mã nguồn có kèm script kiểm tra mức độ sẵn sàng mà không tải về mô hình nào:
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
Hãy đọc script trước khi đưa nó vào Python.
Cách chạy DeepSeek V4 Flash không cần GPU, từng bước
Lối 1: cài đặt có hướng dẫn
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
./modchip chat mở giao diện trò chuyện trong terminal với hiển thị tốc độ token/giây trực tiếp. Các lệnh con khác:
| Lệnh | Chức năng |
|---|---|
./modchip web |
Chat qua web và telemetry tại http://127.0.0.1:8787 |
./modchip bench |
Kiểm tra tốc độ 30 giây kèm bảng điểm có thể chia sẻ |
./modchip claude |
Khởi chạy Claude Code kết nối với engine cục bộ |
./modchip status / stop |
Kiểm tra mức sẵn sàng hoặc dừng các dịch vụ nền |
Lối 2: chạy server trực tiếp
Cách này tải về GGUF và server dựng sẵn từ kho trên Hugging Face rồi khởi chạy trên cổng 8080:
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
Đặt -t theo số nhân vật lý của bạn. Ví dụ dùng ngữ cảnh 32K; các con số 256K dùng -c 262144.
Một bẫy cần lưu ý: llama.cpp bản gốc, Ollama và LM Studio đều không thể tải file này. Checkpoint dùng loại tensor tùy chỉnh (ID 40), nên các bản chưa vá sẽ báo lỗi unknown tensor type 40. Hãy dùng script ./modchip hoặc file nhị phân đi kèm.
Server này là bản llama-server đã vá của llama.cpp, nên nó hỗ trợ route kiểu OpenAI /v1/chat/completions:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
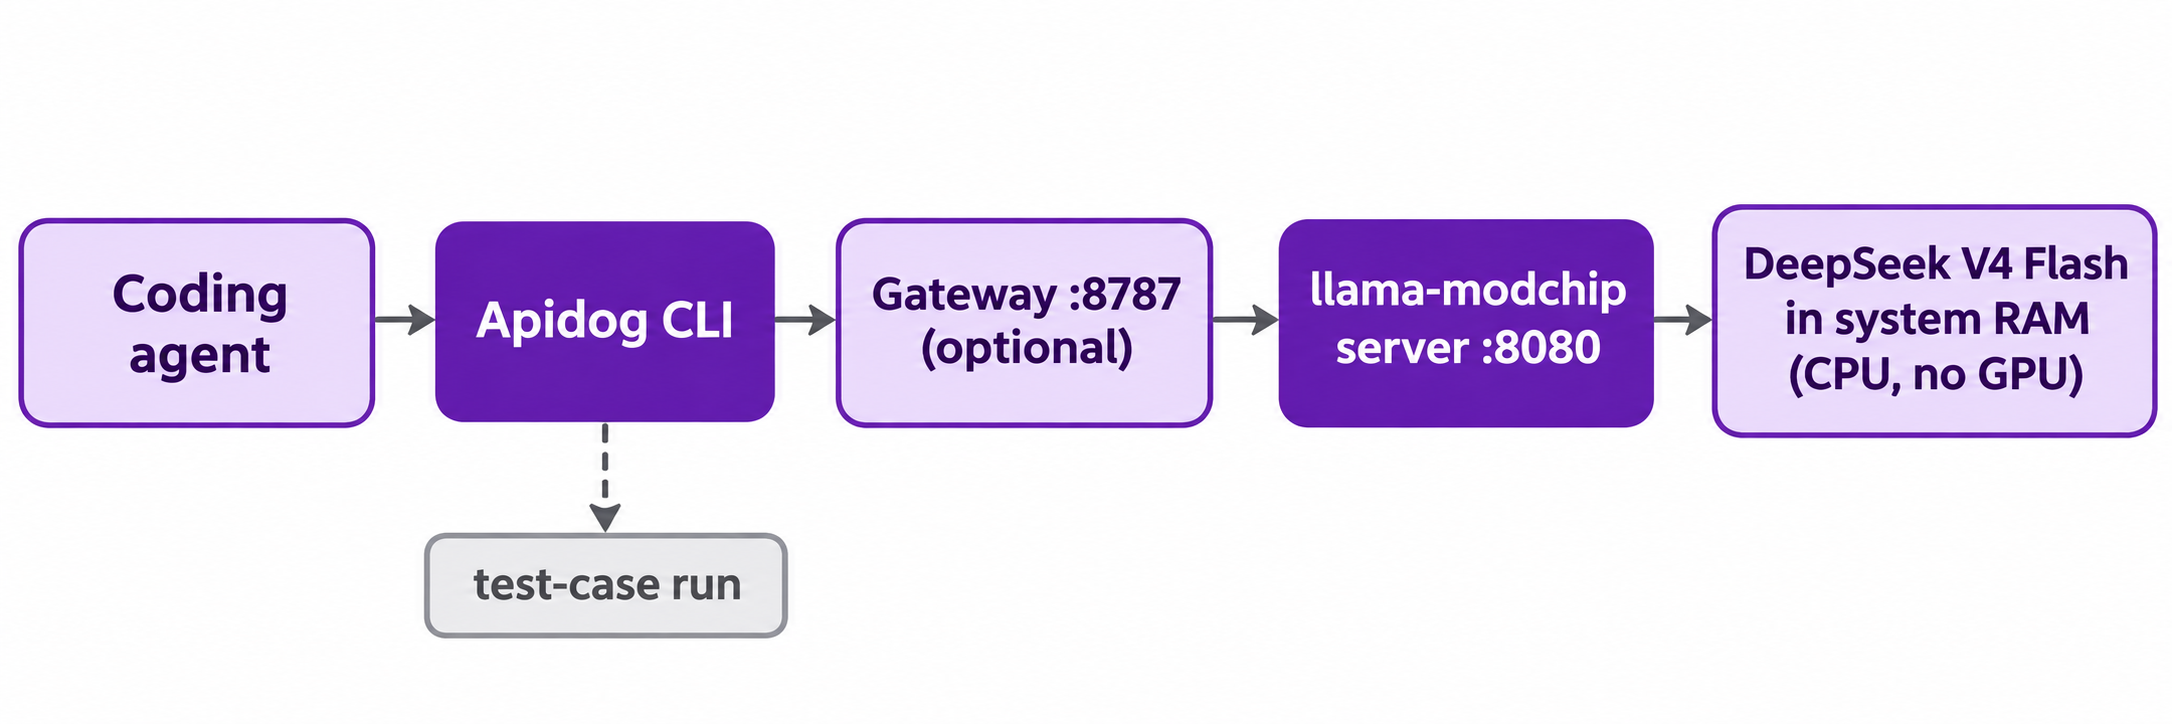
Cổng gateway trên cổng 8787
gateway/sse_gateway.py là một proxy chạy trên 127.0.0.1:8787 chuyển tiếp yêu cầu đến engine (đặt địa chỉ upstream qua biến LLAMA_BACKEND_URL). Nó cung cấp các route /v1/chat/completions, /v1/messages, /v1/models và /health. Đặt GATEWAY_API_KEY để buộc dùng bearer token. ./modchip claude trỏ Claude Code đến đây.
Tốc độ và chất lượng: 1,71 bit mỗi trọng số đánh đổi điều gì
Các con số tốc độ là thật nhưng gắn với điều kiện cụ thể. Đây là bảng của người bảo trì cho DeepSeek-V4-Flash ở ngữ cảnh 256K trên Ryzen 9 9955HX:
| Cấu hình | Prefill | Decode | Decode với bộ dự thảo |
|---|---|---|---|
Bản UD-IQ1_S chưa vá (76,87 GiB) |
OOM hoặc swap trên máy 64 GB | 5,91 tok/s | N/A |
| v2.4.0 mặc định (Top-6, 56,56 GiB) | 43,16 đến 44,36 tok/s | 9,06 đến 9,95 tok/s | 11,5 đến 14,7 tok/s |
| Top-5 ở các lớp sau | 43,16 đến 44,36 tok/s | 9,68 đến 9,87 tok/s | 12,2 đến 15,1 tok/s |
| Top-4 kết hợp gate-first SwiGLU | 43,16 đến 44,36 tok/s | 10,12 đến 10,74 tok/s | 13,0 đến 16,0 tok/s |
Bạn chuyển sang các dòng nhanh hơn bằng LLAMA_MOE_TOP_K=5 hoặc 4. README cho biết Top-5 làm tăng khoảng 0,42% perplexity so với cấu hình mặc định của chính nó.
Hai lưu ý liên tục xuất hiện trên Hacker News:
- "Không mất mát" có nghĩa là không mất mát so với file 1,71 bpw, chứ không phải so với trọng số gốc. Độ tương đồng cosine 1.00000 là so sánh giữa runtime đã vá và chưa vá trên cùng một checkpoint đã nén, nơi hầu hết expert định tuyến nằm ở mức
IQ1_S(khoảng 1,56 bit). Người bình luận lưu ý chất lượng thường giảm xuống dưới mức 4 bit, và README không có so sánh với đầu ra độ chính xác đầy đủ. - Prefill là điểm nghẽn cho agent. Với 44 token/giây, một prompt 10.000 token cần khoảng 225 giây trước khi token đầu tiên xuất hiện. Ảnh chụp KV (khôi phục trong 13,1 đến 32,6 ms cho prompt Claude Code với 40 công cụ) giúp ích ở các lượt tiếp theo, chứ không giúp ích cho ngữ cảnh mới.
Một điểm nữa: đây là checkpoint V4-Flash bản tháng 7 (0731). DeepSeek đã phát hành V4.1 Flash từ đó. Nếu bạn quan tâm đến trọng số mới nhất, hãy đọc trước bài so sánh DeepSeek V4.1 Flash với V4 Pro và V4 Flash.
Hãy coi bản 284B cục bộ như một mô hình riêng tư, hoạt động ngoại tuyến cho việc soạn thảo, xử lý theo lô và thử nghiệm, đồng thời kiểm thử với chính các prompt của bạn trước.
Dùng agent lập trình kiểm thử endpoint cục bộ với Apidog CLI
Mô hình cục bộ vẫn là một API: nó có trả lời không, JSON có hợp lệ không, thay đổi cờ lần trước có làm hỏng gì không? Agent lập trình của bạn có thể thực hiện các kiểm tra đó bằng Apidog CLI, công cụ chạy trên máy của bạn và truy cập trực tiếp vào 127.0.0.1. Cài đặt một lần:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
apidog skill install thêm kỹ năng Apidog để agent của bạn biết các lệnh. Sau đó đưa cho agent, chẳng hạn Claude Code, một prompt:
In Apidog project <projectId>, create an environment called local-dsv4 with base URL
http://127.0.0.1:8080. Add a POST /v1/chat/completions endpoint and a test case that
sends a short prompt, asserts status 200, asserts choices[0].message.content is not empty,
and asserts the response time is under 120 seconds. Run it against local-dsv4 and
summarize any failures.
Agent sẽ đọc schema, xác thực payload, rồi viết và chạy:
apidog environment create local-dsv4 --project <projectId> --base-url http://127.0.0.1:8080
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog test-case run <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 180000
--timeout-request (tính bằng mili giây) rất quan trọng: mô hình 284B chạy trên CPU đủ chậm để vượt quá thời gian chờ mặc định.
Lợi ích nằm ở khả năng so sánh: trỏ một môi trường thứ hai đến API hosted của DeepSeek, chạy cùng một test case, và xem phần lượng tử hóa cục bộ lệch ở đâu. Thêm --upload-report để xem kết quả chạy trong ứng dụng. Xem thêm Apidog CLI trong Claude Code và hướng dẫn cài đặt Apidog CLI. Gói Free của Apidog hỗ trợ tới 4 người dùng.
CPU cục bộ so với GPU so với API hosted
| Phương án | Yêu cầu | Phù hợp nhất cho |
|---|---|---|
| llama-modchip trên CPU | 64 GB RAM, CPU x86_64 đời mới | Công việc riêng tư, ngoại tuyến, không tốn phí API, nếu bạn chấp nhận prefill chậm |
| Phục vụ bằng GPU với vLLM hoặc SGLang | VRAM lớn hoặc máy nhiều GPU | Tự lưu trữ nhanh, độ chính xác cao hơn |
| API hosted của DeepSeek | Một API key | Đầu ra chất lượng đầy đủ với tốc độ sản xuất |
Với hướng GPU, tham khảo bài cách chạy DeepSeek V4 cục bộ, vốn đề cập đến vLLM và SGLang. Với bài toán bộ nhớ của checkpoint mới hơn, xem cách chạy DeepSeek V4.1 Flash cục bộ. Để kiểm thử bất kỳ mô hình cục bộ nào như một API, xem bài kiểm thử LLM cục bộ như API.
Câu hỏi thường gặp
Thực sự có thể chạy DeepSeek V4 Flash không cần GPU không?
Có, với llama-modchip và 64 GB RAM. Người bảo trì báo cáo 44,36 token/giây prefill và 9 đến 15 token/giây decode trên Ryzen 9 9955HX 16 nhân, với toàn bộ mô hình 56,56 GiB nằm trong RAM và không dùng swap.
Nó có hoạt động với Ollama hoặc LM Studio không?
Không. Checkpoint dùng loại tensor tùy chỉnh, và llama.cpp chưa vá, Ollama cùng LM Studio sẽ từ chối với lỗi unknown tensor type 40. Hãy dùng script ./modchip của repo hoặc file nhị phân llama-server-modchip-linux-x86_64 đi kèm.
Nếu tôi chỉ có 16 hoặc 32 GB RAM thì sao?
Hãy chạy mô hình MoE 30B thay thế. README ghép tầng này với Nemotron-3.5-30B-A3B dưới dạng file 14,35 GiB và báo cáo 25,0 đến 60,4 token/giây trên CPU.
Chất lượng đầu ra ở mức 1,71 bit mỗi trọng số như thế nào?
Dự án không so sánh với DeepSeek độ chính xác đầy đủ, và người bình luận trên Hacker News tỏ ra hoài nghi ở kích thước này. Hãy kiểm thử các prompt của bạn với API hosted trước khi tin dùng.
Server cục bộ có tương thích OpenAI không?
Có. Đó là bản llama-server đã vá của llama.cpp, nên /v1/chat/completions hoạt động trên cổng 8080. Gateway tùy chọn trên cổng 8787 cũng phục vụ /v1/messages — route kiểu Anthropic mà Claude Code sử dụng.
Agent lập trình của tôi có thể kiểm thử mô hình cục bộ tự động không?
Có. Cài Apidog CLI, chạy apidog skill install, rồi yêu cầu agent tạo một môi trường trỏ đến http://127.0.0.1:8080 và một test case cho /v1/chat/completions. Sau đó nó chạy apidog test-case run và báo cáo các lỗi.