
Giá Qwen4-Max trên API trả theo token của QwenCloud là 1,50 USD cho mỗi 1 triệu token đầu vào và 4,50 USD cho mỗi 1 triệu token đầu ra tại khu vực Singapore, với đầu vào được cache ở mức 0,075 USD cho mỗi 1 triệu. Chế độ thinking và non-thinking có giá như nhau, và không có các bậc theo độ dài đầu vào. Nếu bạn muốn trả một khoản phí cố định hàng tháng cho các công cụ lập trình, cùng mô hình đó cũng có trên Token Plan, bắt đầu từ 6 USD mỗi tháng.
Nội dung bên dưới: bảng giá, chi phí thực tế của các tác vụ, lợi ích từ cache, so sánh Token Plan với trả theo token, và giá của các đối thủ. Mới làm quen với mô hình này? Hãy bắt đầu với bài viết Qwen4-Max là gì.
Giá API của Qwen4-Max cho mỗi 1 triệu token
Qwen4-Max được tính phí theo mỗi triệu token, với mức giá riêng cho đầu vào, đầu ra, ghi cache và đọc cache. Phần đầu ra bao gồm cả token suy luận (“thinking”) và câu trả lời. Alibaba công bố cột giá Singapore (Quốc tế) và một cột giá thấp hơn cho Bắc Kinh/Toàn cầu.
| Khoản tính phí (mỗi 1M token) | Singapore (Quốc tế) | Bắc Kinh / Toàn cầu |
|---|---|---|
| Đầu vào | $1.50 | $1.413 |
| Đầu ra (thinking + câu trả lời) | $4.50 | $4.24 |
| Ghi cache, TTL 5 phút | $1.875 | $1.767 |
| Ghi cache, TTL 1 giờ | $3.00 | $2.827 |
| Đọc cache (trúng rõ ràng hoặc ngầm định) | $0.075 | $0.071 |
Nguồn: tài liệu định giá QwenCloud và trang mô hình Qwen4-Max, cả hai đều được kiểm tra vào ngày 16 tháng 11 năm 2026. Tài liệu liệt kê triển khai Toàn cầu tại Frankfurt, Hong Kong, Tokyo và Mỹ (Virginia).
Một vài quy tắc chi phối hóa đơn:
- Token thinking được tính là đầu ra. Bật
enable_thinkingvà mọi token suy luận đều được tính 4,50 USD mỗi 1 triệu. - Không phụ thu ngữ cảnh dài. Một yêu cầu 900K token có giá trên mỗi token bằng một yêu cầu 9K token.
- Đọc cache chỉ bằng 5% giá đầu vào. 0,075 USD so với 1,50 USD là mức giảm 95% cho các tiền tố lặp lại.
- Giới hạn: ngữ cảnh 1 triệu token, tối đa 991K đầu vào (983K khi bật thinking), tối đa 393K đầu ra và 5.000.000 token mỗi phút.
Model id là qwen4-max. Nếu bạn chưa từng gọi API, hướng dẫn API Qwen4-Max của chúng tôi sẽ trình bày về API key, base URL và yêu cầu đầu tiên.
Chi phí thực tế của một tác vụ Qwen4-Max
Giá trên mỗi token khá khó cảm nhận. Alibaba đưa ra một con số cụ thể trong bài viết ra mắt: trên benchmark agent Work360, chi phí trung bình mỗi tác vụ giảm từ 4,43 USD với Qwen3.8-Max xuống còn 1,67 USD với Qwen4-Max, thấp hơn 62%. Alibaba cũng báo cáo rằng Qwen4-Max dùng ít hơn khoảng 24% token ở mức effort Xhigh và khoảng 35% ở mức High trên Work360. Đây là số liệu từ nhà cung cấp, vì vậy hãy xem đó là một xu hướng tham khảo, chứ không phải báo giá cho khối lượng công việc của bạn.
Bạn có thể tự ước tính chi phí bằng phép tính đơn giản. Dưới đây là ba ví dụ cụ thể theo giá niêm yết khu vực Singapore:
- Lượt chat ngắn. 2.000 token đầu vào và 500 token đầu ra: 2.000 x $1.50/1M + 500 x $4.50/1M = $0.003 + $0.00225 = $0.0053. Tức khoảng 5,25 USD cho mỗi 1.000 lượt gọi.
- Cùng lượt gọi đó nhưng bật thinking. Giả sử mô hình suy luận 6.000 token trước khi đưa ra câu trả lời 500 token. Đầu ra trở thành 6.500 token, nên lượt gọi có giá $0.003 + $0.02925 = $0.032, đắt hơn khoảng sáu lần.
- Câu hỏi về tài liệu dài. 300.000 token đầu vào và 2.000 token đầu ra: $0.45 + $0.009 = $0.459 nếu không dùng cache, hoặc khoảng 0,032 USD nếu tài liệu 300K trúng cache.
Ví dụ 2 khiến nhiều người bất ngờ: thinking có thể chiếm phần lớn hóa đơn ngay cả khi câu trả lời rất ngắn. Để xem số liệu chi tiết hơn về chất lượng trên mỗi đồng, hãy xem bảng phân tích benchmark Qwen4-Max.
Giá cache ảnh hưởng thế nào đến hóa đơn Qwen4-Max
Context caching là nơi giá Qwen4-Max thực sự thay đổi đáng kể. QwenCloud cung cấp hai chế độ cho qwen4-max trên API trả theo token, và trên các API Chat Completions, DashScope và tương thích Anthropic, hai chế độ này loại trừ lẫn nhau trong mỗi yêu cầu.
| Chế độ | Cách hoạt động | Giá | Đảm bảo trúng? |
|---|---|---|---|
| Cache ngầm định | Tự động, không thể tắt, tái sử dụng tiền tố chung từ 1.024 token trở lên | $0.075 mỗi 1M khi trúng | Không. Hiệu lực không xác định |
| Cache rõ ràng | Bạn đánh dấu điểm ngắt bằng cache_control |
$1.875 (5 phút) hoặc $3 (1 giờ) khi ghi, $0.075 khi đọc | Có, trong thời gian cache còn hiệu lực |
Tài liệu context cache cho biết cache rõ ràng 5 phút sẽ đặt lại bộ đếm thời gian sau mỗi lần trúng, nên vòng lặp agent dày đặc sẽ luôn giữ cache ở trạng thái hoạt động.
Giờ hãy xét một phiên agent: system prompt 200K token cùng định nghĩa công cụ và ngữ cảnh repo, được tái sử dụng qua 50 lượt, với 2K đầu vào mới và 3K đầu ra mỗi lượt.
- Không trúng cache: 10,1 triệu token đầu vào x $1.50 + 150K đầu ra x $4.50 = $15.83.
- Trúng cache ngầm định từ lượt thứ 2: 202K đầu tiên theo giá đầy đủ ($0.30), 9,8 triệu token cache ở $0.075 ($0.74), 98K token mới ($0.15) và đầu ra ($0.68) = $1.86.
- Cache rõ ràng 5 phút: một lần ghi $0.375 thay cho tiền tố đầu tiên theo giá đầy đủ, cùng các lần đọc và đầu ra như trên = khoảng $1.94, với lần trúng được đảm bảo.
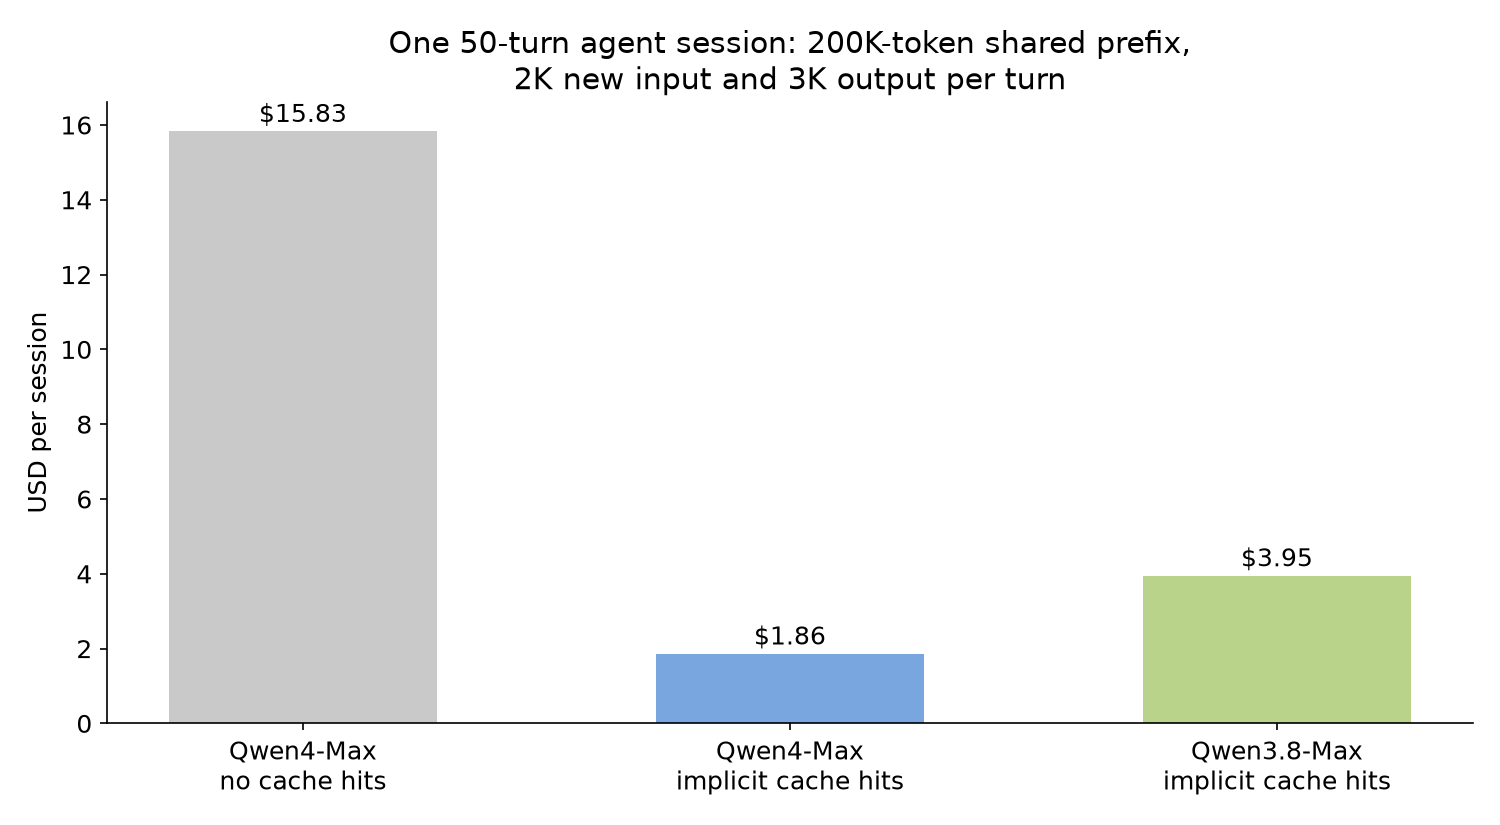
Cùng phiên đó trên Qwen3.8-Max, với giá đầu vào 2 USD, cache ngầm định 0,25 USD và đầu ra 6 USD, tổng cộng là 3,95 USD. Đó là nơi thể hiện tuyên bố của Alibaba về “mức cắt giảm lớn nhất cho đầu vào được cache”: Qwen3.8-Max tính 0,25 USD cho một lần trúng ngầm định, còn Qwen4-Max chỉ tính 0,075 USD.
Hãy dùng cache rõ ràng khi bạn cần lần trúng dự đoán được, và cache ngầm định cho mọi trường hợp còn lại. Kiểm tra kết quả trong usage.prompt_tokens_details.cached_tokens và cache_creation_input_tokens. Nếu bạn đang cân nhắc kinh tế học của caching giữa các nhà cung cấp, bài tính toán prompt caching của Claude Opus 5.5 của chúng tôi sử dụng cùng phương pháp.
Qwen4-Max có giảm giá batch không?
Có, nhưng chỉ ở một khu vực. Batch API của QwenCloud thường tính phí đầu vào và đầu ra bằng 50% giá thời gian thực. Với qwen4-max, tài liệu batch chỉ liệt kê giá này dưới China North 2 (Bắc Kinh), ở mức 0,707 USD đầu vào và 2,12 USD đầu ra mỗi 1 triệu token cho Batch File. Batch Chat ở Bắc Kinh được niêm yết 1,413 USD / 4,24 USD.
Batch không hỗ trợ context caching, không cộng dồn với các giảm giá khác và không được miễn phí theo hạn mức miễn phí. Với tỷ lệ trúng cache cao, API thời gian thực có thể rẻ hơn batch.
Qwen4-Max: trả theo token hay Token Plan
Token Plan là gói đăng ký hàng tháng của QwenCloud cho các công cụ lập trình và agent như Claude Code, Cursor, Qwen Code, Codex và Qoder. Nó tính phí theo Credit, không phải token, và sử dụng các API key riêng dạng sk-sp-. qwen4-max nằm trong danh sách mô hình được hỗ trợ. Các gói cá nhân, theo tài liệu Token Plan tính đến ngày 16 tháng 11 năm 2026:
| Gói | Giá mỗi tháng | Credit mỗi tháng | Agent đồng thời |
|---|---|---|---|
| Lite | $6 ($3 giá dành cho người dùng mới trong thời gian giới hạn) | 20,000 | 1-2 |
| Essential | $10 ($5 giá dành cho người dùng mới trong thời gian giới hạn) | 45,000 | 2-3 |
| Standard | $18 | 80,000 | 3-4 |
| Pro | $43 | 200,000 | 6-8 |
Gói Credit bổ sung có giá 15 USD cho 20.000 Credit (tối đa 5 gói cùng lúc). Khi hết Credit, các lượt gọi bị chặn; chúng không chuyển sang chế độ trả theo token.
Cách chọn:
- Chọn Token Plan nếu một người dùng mô hình qua agent lập trình mỗi ngày và muốn chi phí hàng tháng cố định.
- Chọn trả theo token cho sản phẩm, tác vụ backend, batch, fine-tuning hoặc lưu lượng không đều. Bạn trả theo mức sử dụng và giữ giới hạn 5.000.000 TPM.
Số Credit mỗi yêu cầu Qwen4-Max không theo tỷ lệ token cố định, nên hãy kiểm tra console sau một ngày sử dụng thực tế. Chúng tôi trình bày chi tiết về gói này, bao gồm cả mức sử dụng của Credit, trong bài Qwen4-Max Token Plan: giá cả và có đáng dùng không.
Giá Qwen4-Max so với Qwen3.8-Max và các mô hình flagship đối thủ
Qwen4-Max rẻ hơn thế hệ trước ở đầu vào, đầu ra, đọc cache và ghi cache 5 phút (Qwen3.8-Max niêm yết một mức ghi cache 2,50 USD; mức ghi 1 giờ của Qwen4-Max là 3 USD). Dưới đây là vị thế của nó so với các mô hình flagship khác theo giá niêm yết chuẩn, mỗi mức đều được tra trên trang của chính nhà cung cấp vào ngày 16 tháng 11 năm 2026.
| Mô hình | Đầu vào / 1M | Đầu vào được cache / 1M | Đầu ra / 1M |
|---|---|---|---|
| Qwen4-Max (Singapore) | $1.50 | $0.075 | $4.50 |
| Qwen3.8-Max | $2.00 | $0.25 (ngầm định), $0.17 (đọc rõ ràng) | $6.00 |
| DeepSeek V4 Pro (cao điểm / thấp điểm) | $1.32 / $0.66 | $0.044 / $0.022 | $3.96 / $1.98 |
| OpenAI gpt-5.6-sol | $4.00 | $0.40 | $20.00 |
| Claude Opus 5.5 | $4.00 | $0.20 | $20.00 |
Nguồn: trang mô hình Qwen3.8-Max, định giá DeepSeek, định giá OpenAI API và định giá Claude.
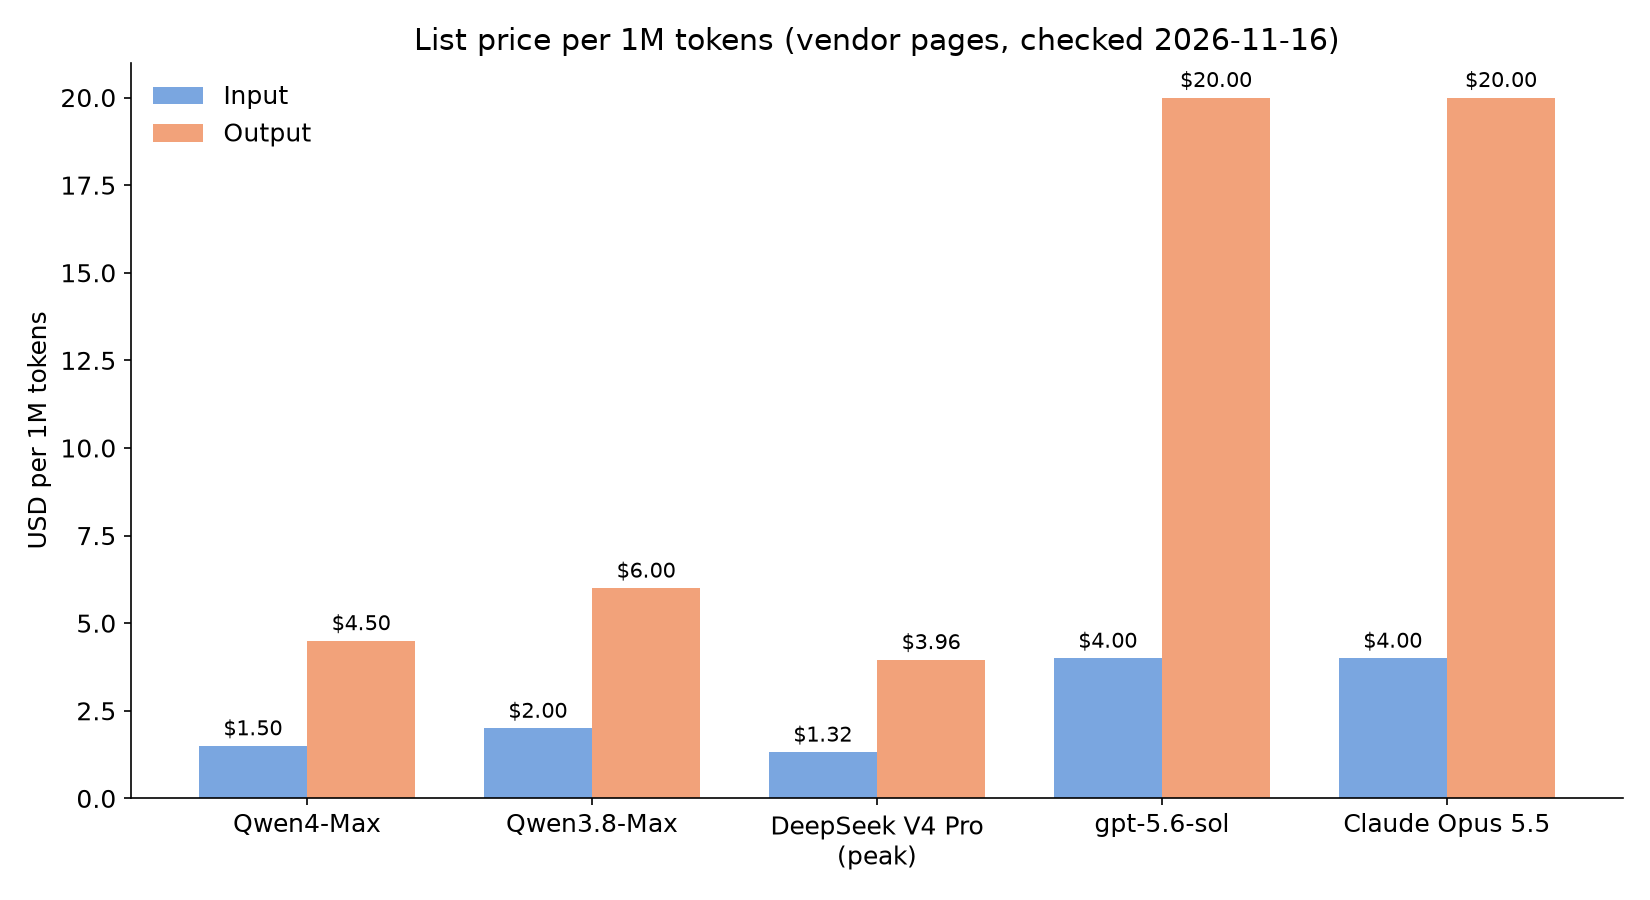
Với agent, đầu ra thường là khoản chi lớn nhất, và mức đầu ra 4,50 USD của Qwen4-Max thấp hơn nhiều so với mức 20 USD mà gpt-5.6-sol và Claude Opus 5.5 tính. DeepSeek V4 Pro rẻ hơn trên mỗi token, đặc biệt vào giờ thấp điểm. Chi phí trên mỗi tác vụ hoàn thành phụ thuộc vào số token mỗi mô hình tiêu tốn cho khối lượng công việc của bạn. Để xem chi tiết về phía Qwen3.8-Max, hãy xem hướng dẫn định giá Qwen 3.8 và so sánh Qwen4-Max với Qwen 3.8 của chúng tôi.
Để agent lập trình của bạn đo chi phí Qwen4-Max bằng Apidog CLI
Cách ước tính chi phí đáng tin cậy duy nhất là đo usage trên chính các prompt của bạn. Hãy để agent lập trình của bạn (Claude Code, Codex, Cursor hoặc tương tự) xây dựng và chạy kiểm tra đó bằng Apidog CLI. Cài đặt một lần:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
Sau đó đưa cho agent một prompt:
In Apidog project <projectId>, create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable for my DashScope API key. Add a POST /chat/completions endpoint for model
qwen4-max and two test cases: one with enable_thinking true, one false. Assert
status 200, a non-empty choices array and a usage object. Run both and report
prompt_tokens, completion_tokens and cached_tokens side by side.
Agent sẽ kiểm tra cấu trúc của từng payload theo schema của CLI trước khi ghi bất kỳ thứ gì, rồi chạy các test case:
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case-thinking.json
apidog test-case create --project <projectId> --file case-thinking.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
So sánh hai con số completion_tokens và nhân với 4,50 USD mỗi 1 triệu: đó chính là phụ phí thinking, tính trên chính prompt của bạn. Thêm --upload-report vào lệnh apidog run để xem lần chạy trong ứng dụng Apidog, hoặc đưa cùng lệnh đó vào CI với -r junit như hướng dẫn trong bài chạy Apidog CLI trong CI/CD. Mới dùng CLI? Hướng dẫn cài đặt Apidog CLI và Apidog CLI trong Codex sẽ giúp bạn chạy được trong vài phút. Gói Free của Apidog hỗ trợ tới 4 người dùng.
FAQ
Qwen4-Max giá bao nhiêu mỗi 1 triệu token? 1,50 USD cho đầu vào và 4,50 USD cho đầu ra tại khu vực Singapore, với đọc cache ở mức 0,075 USD. Cột Bắc Kinh/Toàn cầu thấp hơn một chút, lần lượt là 1,413 USD và 4,24 USD.
Chế độ thinking có tốn kém hơn trên Qwen4-Max không? Mức giá là như nhau, nhưng token suy luận được tính như đầu ra với giá 4,50 USD mỗi 1 triệu, nên phần suy luận dài sẽ làm tăng chi phí của một lượt gọi.
Qwen4-Max có rẻ hơn Qwen3.8-Max không? Có. Đầu vào giảm từ 2 USD xuống 1,50 USD, đầu ra từ 6 USD xuống 4,50 USD, và lần trúng cache ngầm định từ 0,25 USD xuống 0,075 USD mỗi 1 triệu token. Alibaba cũng báo cáo chi phí mỗi tác vụ trên Work360 giảm từ 4,43 USD xuống 1,67 USD.
Có thể dùng Qwen4-Max miễn phí không? QwenCloud dành cho các mô hình mới một hạn mức miễn phí tại khu vực Singapore, thường là 1 triệu token có hiệu lực 90 ngày, sau khi bạn thêm thông tin thanh toán. Hãy kiểm tra trang Free Tier trong console cho qwen4-max, và xem hướng dẫn dùng Qwen4-Max miễn phí của chúng tôi cho mọi con đường chi phí 0 USD.
Qwen4-Max có hỗ trợ giá batch không? Chỉ ở khu vực Bắc Kinh: Batch File là 0,707 USD đầu vào và 2,12 USD đầu ra mỗi 1 triệu token, không có context caching.
Nên chọn Token Plan hay trả theo token cho Qwen4-Max? Token Plan phù hợp với một người dùng các công cụ lập trình hàng ngày, từ 6 USD mỗi tháng. Trả theo token phù hợp với ứng dụng, tác vụ backend và công việc batch.