
Điểm benchmark của Qwen4-Max, tóm gọn trong một câu: bảng biểu của Alibaba cho thấy Qwen4-Max vượt Qwen3.8-Max trên tất cả 15 bài kiểm tra mà cả hai đều xuất hiện, và đứng đầu tổng thể trên 4 trong 16 bài, nhưng phần lớn những con số này đến từ các lần chạy của chính Alibaba. Trên Work360, nó đạt 52,69 so với 47,74, và chi phí trung bình mỗi tác vụ giảm từ 4,43 USD xuống 1,67 USD.
Một benchmark chỉ hữu ích khi bạn trả lời được câu hỏi "ai đã chạy nó, và như thế nào?". Bài viết này bao quát mọi điểm số Alibaba công bố ngày 16/11/2026, phân loại thành tự báo cáo và của bên thứ ba, và kết thúc bằng cách để bạn tự chạy một bài kiểm tra riêng với API Qwen4-Max. Với kiến thức cơ bản, hãy bắt đầu với Qwen4-Max là gì và cách truy cập.
Điểm benchmark của Qwen4-Max trong một cái nhìn tổng quan
Bài đăng ra mắt của Alibaba so sánh Qwen4-Max với Qwen3.8-Max-0902, Opus 5.5, GPT-6.1 Sol, GPT-6 Astra và Kimi K3.1 trên 16 benchmark.
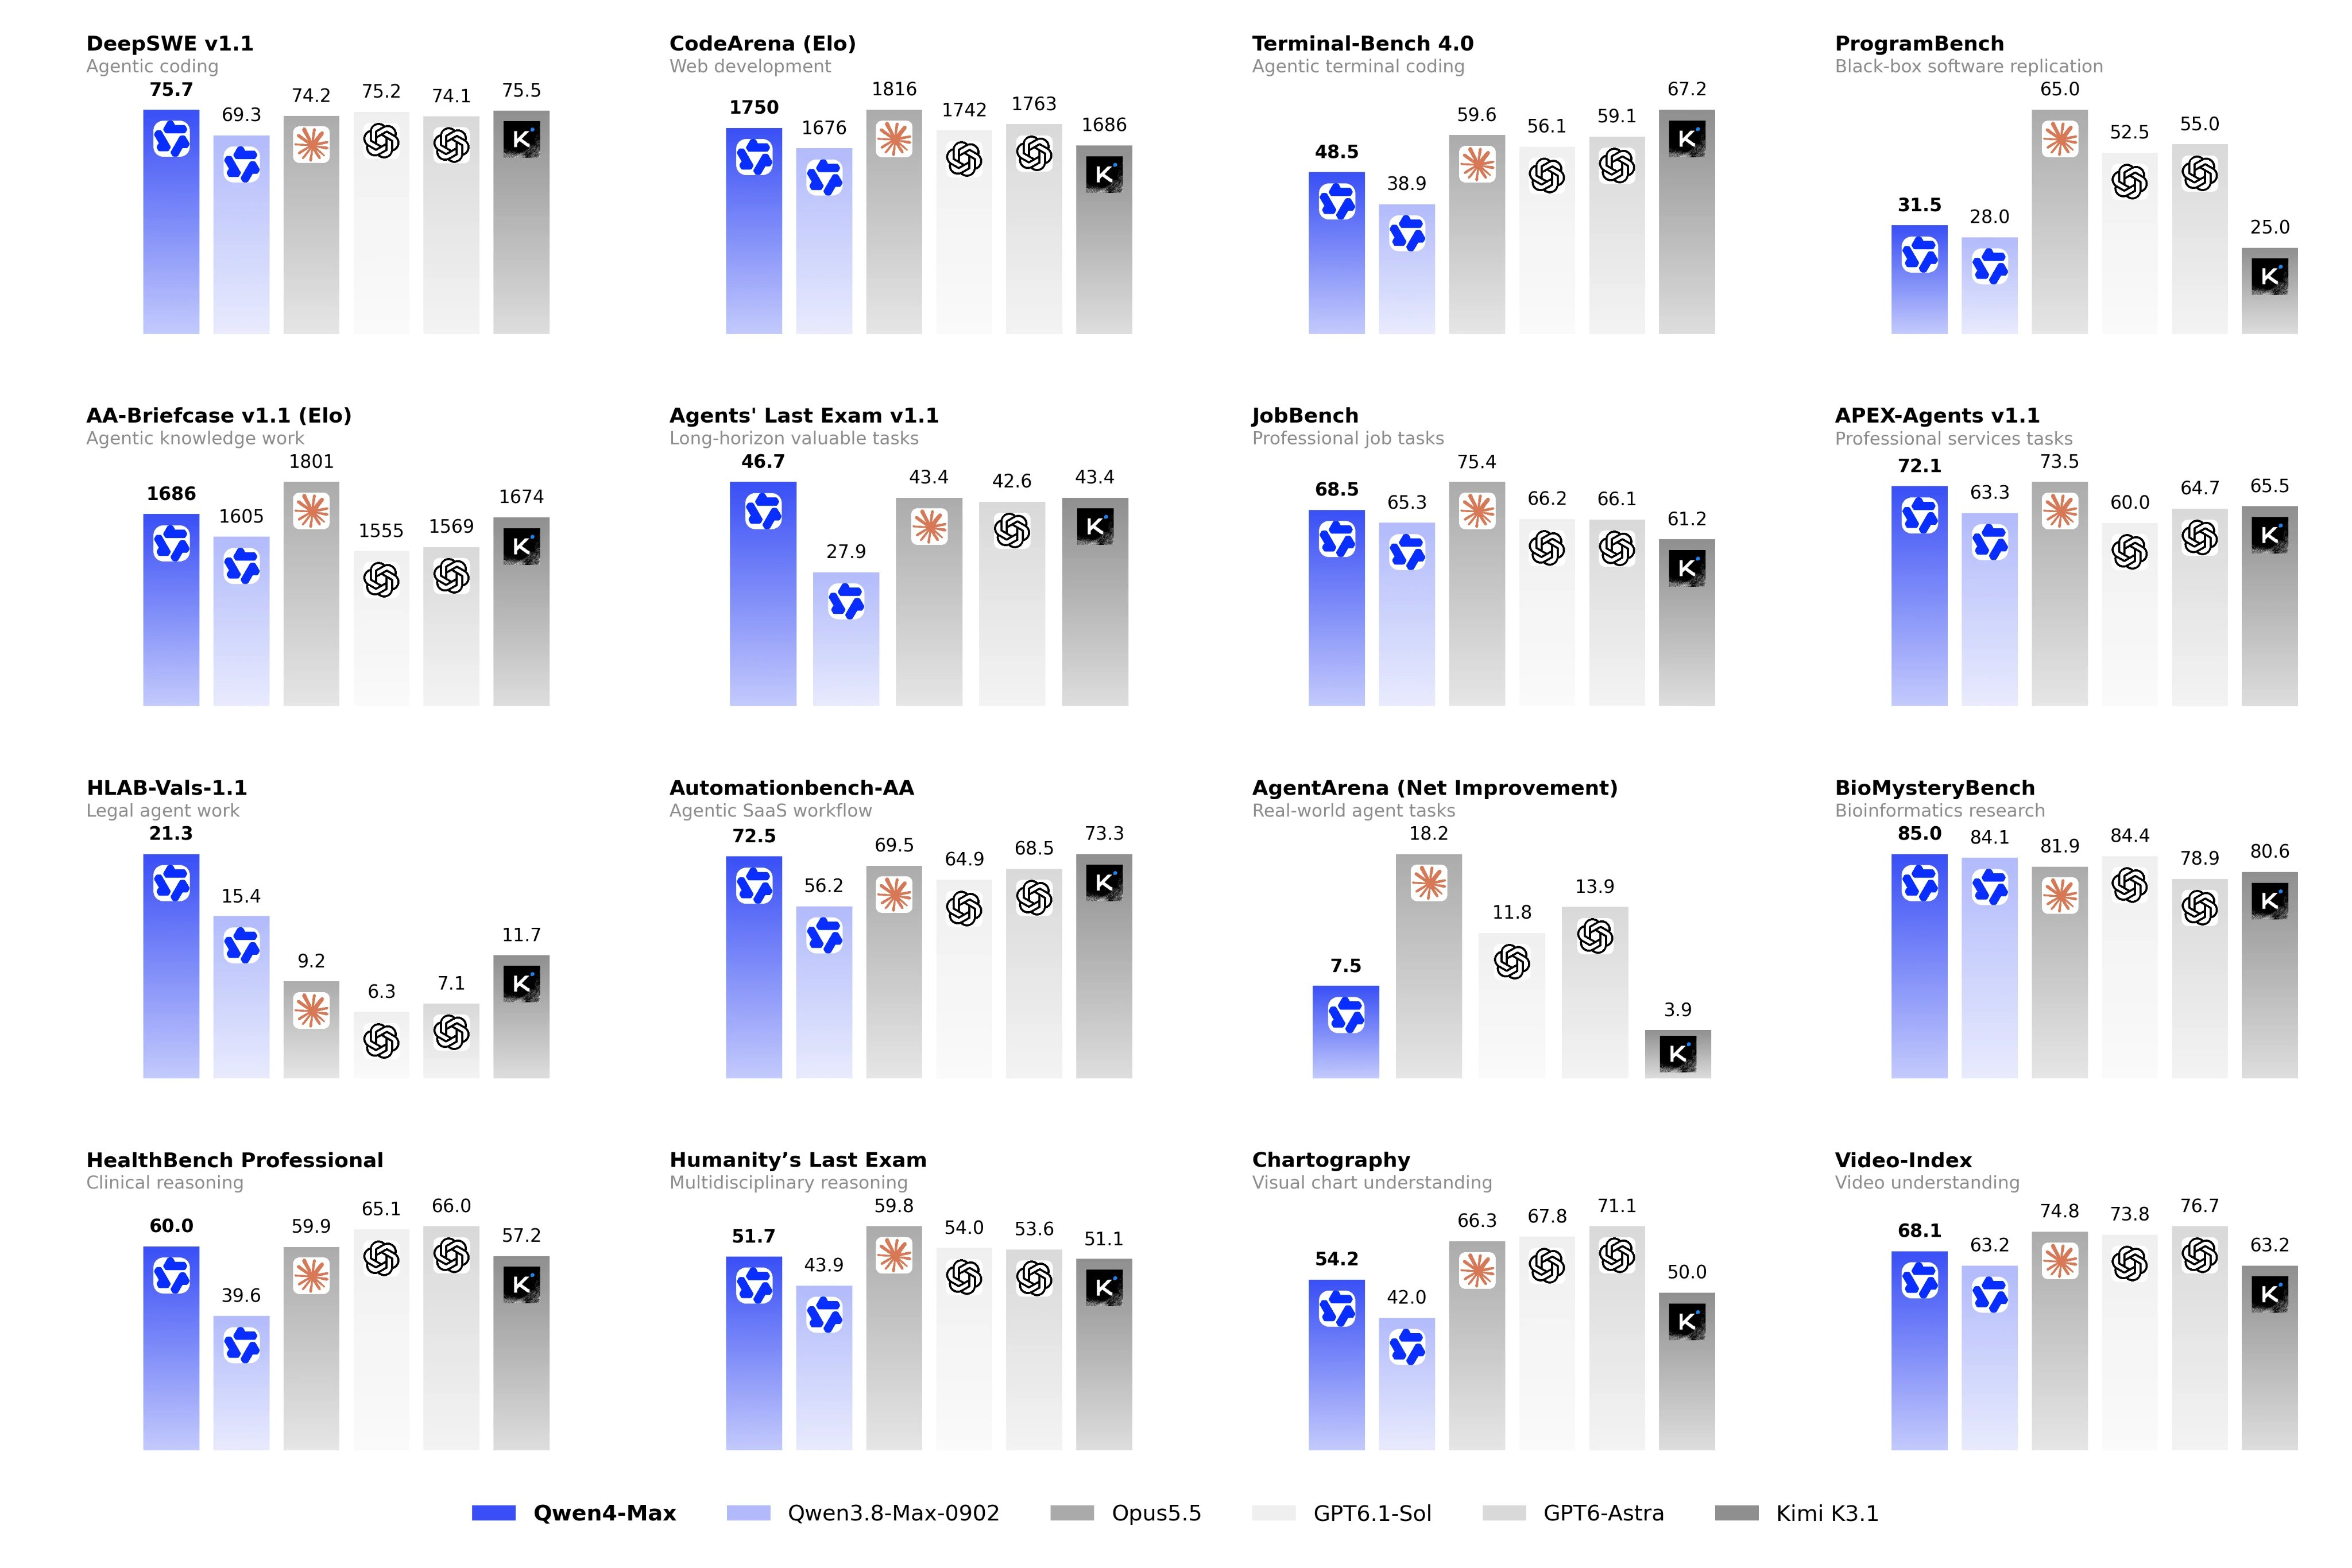
Chữ in đậm đánh dấu điểm cao nhất trong bảng biểu. "Alibaba" có nghĩa là phần chú thích không dẫn đến bảng xếp hạng bên ngoài nào cho bài kiểm tra đó, vì vậy hãy xem đó là lần chạy của chính Alibaba (chú thích của JobBench và Chartography chỉ mô tả cấu hình của Alibaba).
Tự báo cáo so với bên thứ ba: ai đã chạy mỗi bài kiểm tra
Mười trong 16 điểm số là tự báo cáo. Sáu điểm được trích từ các bảng xếp hạng công khai do bên khác vận hành. Sự phân chia này là bộ lọc hữu ích nhất mà bạn có thể áp dụng.
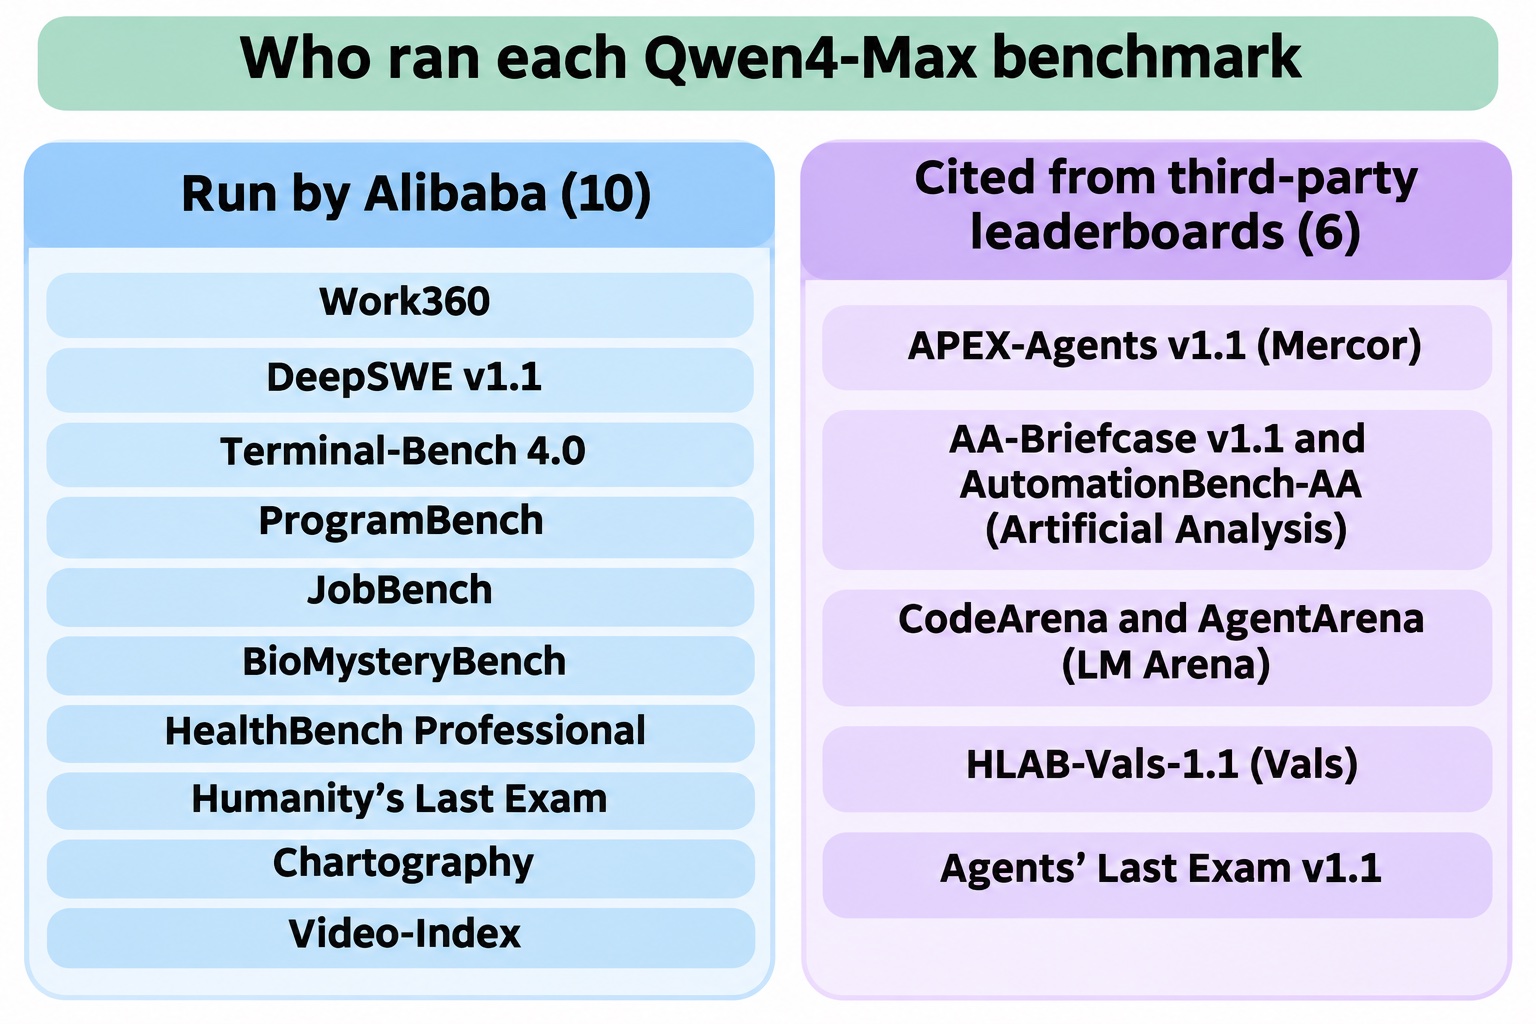
Nhóm bên thứ ba, theo chú thích của bài đăng ra mắt:
- APEX-Agents v1.1: trích từ bảng xếp hạng Mercor APEX-Agents
- AA-Briefcase v1.1 và AutomationBench-AA: trích từ Artificial Analysis
- CodeArena và AgentArena: trích từ LM Arena
- HLAB-Vals-1.1: trích từ Vals Index
- Agents' Last Exam v1.1: trích từ bảng xếp hạng riêng của nó
Một con số độc lập mà bạn có thể kiểm tra ngay hôm nay: Vals Index (phiên bản 2.2, cập nhật ngày 15/11/2026) xếp Qwen 4 Max ở mức 63,20% tổng thể, hạng 11, với giá 9,33 USD mỗi bài kiểm tra. Điều đó đặt nó sau mười mô hình, dẫn đầu là Claude Fable 5.2 với 71,31%, và chỉ hơi vượt Kimi K3.1 Pro (62,52%) và Qwen 3.8 Max 0902 (59,05%). Đây là bức tranh khiêm tốn hơn so với biểu đồ tiêu đề.
Work360: benchmark công việc do chính Alibaba xây dựng
Work360 là benchmark của Alibaba dành cho các tác vụ ngành phức tạp, trải rộng trên 26 lĩnh vực, 182 phân lĩnh vực và 721 chuyên ngành. Qwen4-Max đạt 52,69, tăng từ 47,74 của Qwen3.8-Max.
Hãy đọc con số này thận trọng: Alibaba thiết kế benchmark và tự chạy các mô hình, so sánh công bố của họ chỉ bao gồm Qwen4-Max và Qwen3.8-Max, và chưa có bảng xếp hạng công khai nào cho nó. Đây là con số giữa các thế hệ, không phải thứ hạng so với các phòng thí nghiệm khác.
Điều Work360 mang lại cho bạn là một con số chi phí: chi phí trung bình mỗi tác vụ giảm từ 4,43 USD xuống 1,67 USD, cắt giảm 62%, nhờ ít token hơn mỗi tác vụ và giá thấp hơn. Qwen4-Max niêm yết 1,50 USD mỗi 1M token đầu vào và 4,50 USD mỗi 1M token đầu ra trên trang mô hình QwenCloud. Xem phân tích đầy đủ trong hướng dẫn giá Qwen4-Max của chúng tôi.
Terminal-Bench 4.0 và hiệu suất token
Terminal-Bench đo lường các agent hoàn thành tác vụ thực tế trong terminal. Alibaba báo cáo 48,5 cho Qwen4-Max trên phiên bản 4.0, tăng từ 38,9 của Qwen3.8-Max. Trên biểu đồ của chính Alibaba, bốn mô hình không phải Qwen đạt từ 56,1 đến 67,2, tất cả đều cao hơn.
Khẳng định lớn hơn là hiệu suất. Alibaba cho biết mức sử dụng token giảm khoảng 48% ở mức nỗ lực Xhigh và 49% ở mức High trên Terminal-Bench 4.0, và khoảng 24% (Xhigh) và 35% (High) trên Work360. Biểu đồ điểm-so-với-token của họ cho thấy hình dạng của điều này:
- Trên Work360, Qwen4-Max ở mức High đã hơi vượt Qwen3.8-Max ở mức Xhigh, với khoảng 96K token mỗi tác vụ so với khoảng 165K (đọc từ biểu đồ, nên chỉ là gần đúng).
- Trên Terminal-Bench 4.0, Qwen4-Max ở mức Xhigh đạt 48,5 với khoảng 150K token mỗi tác vụ, trong khi Qwen3.8-Max ở mức Xhigh đạt khoảng 38 với khoảng 290K.
Ít token hơn cho điểm số tốt hơn là hướng đi đúng nếu bạn trả tiền theo token. Nhưng đây cũng là số tự báo cáo.
Một điểm kiểm tra đáng biết: bảng xếp hạng Terminal-Bench công khai hiện mặc định là phiên bản 4.1, và Qwen4-Max chưa được liệt kê ở đó tính đến ngày 16/11. Qwen3.8-Max-0902 hiển thị 27,0% trên 4.1 (chạy với Claude Code ở mức nỗ lực tối đa), so với 38,9 trên biểu đồ 4.0 của Alibaba. Phiên bản và harness khác nhau, nên đừng lấy con số này trừ con số kia, nhưng nó cho thấy điểm số thay đổi bao nhiêu tùy theo cấu hình.
Qwen4-Max dẫn đầu ở đâu, và tụt lại ở đâu
So với các mô hình tiên phong khác trong biểu đồ, bức tranh khá lẫn lộn:
Dẫn đầu (4 trong 16): DeepSWE v1.1 (75,7, hơn 0,2 điểm so với Kimi K3.1), Agents' Last Exam v1.1 (46,7), HLAB-Vals-1.1 (21,3) và BioMysteryBench (85,0, hơn chưa đầy một điểm so với GPT-6.1 Sol).
Về nhì sát nút: APEX-Agents v1.1 (72,1 so với 73,5), AutomationBench-AA (72,5 so với 73,3) và AA-Briefcase (1686 so với 1801 Elo).
Thua rõ rệt: ProgramBench (31,5 so với 65,0), Terminal-Bench 4.0 (48,5 so với 67,2), AgentArena (7,5 so với 18,2), Chartography (54,2 so với 71,1) và Humanity's Last Exam (51,7 so với 59,8).
Hai trong bốn vị trí dẫn đầu, Agents' Last Exam và HLAB-Vals, đến từ các bảng xếp hạng bên thứ ba, điều này khiến chúng trở thành những tuyên bố vững chắc nhất trên biểu đồ. Về lập trình, có sự phân hóa: dẫn đầu sít sao trên DeepSWE, nhưng khoảng cách lớn trên ProgramBench và Terminal-Bench. Nếu bạn chạy các terminal agent dài hơi, hãy kiểm tra trước khi chuyển đổi. Để biết những gì đã thay đổi so với thế hệ trước, xem Qwen4-Max vs Qwen 3.8.
Số liệu về lập trình an toàn và tiền huấn luyện
Lập trình an toàn. Trên Last Secure Code Bench, trong chế độ "tái tạo mã không có gợi ý bảo mật" với cả chức năng và lỗ hổng đều được kiểm tra, tỷ lệ pass ở cấp hàm tăng từ 22,0% của Qwen3.8-Max lên 31,8%. Tỷ lệ mã vượt qua cả ba cấp (hàm, tệp và kho mã) tăng từ 8% lên 14,7%. Khoảng hai phần ba đầu ra cấp hàm vẫn không qua được kiểm tra, nên việc rà soát bảo mật vẫn là việc của bạn.
Tiền huấn luyện. Trên các đánh giá nội bộ về kiến thức, mã, QA và STEM, Qwen4-Max-Base cho thấy bits per byte thấp hơn khoảng 5% đến 13% so với Qwen3.8-Max-Base trong khi chỉ kích hoạt ít hơn 25% tham số. Alibaba lưu ý rằng hai checkpoint trong so sánh đó (GLM-5.3 và Kimi-K3.1-Pro) đã qua hậu huấn luyện, điều này có thể làm sai lệch kết quả.
Những gì còn thiếu
- Cấu hình đánh giá cho phần lớn các bài kiểm tra. Bài đăng ra mắt không cho biết mức nỗ lực nào (High hay Xhigh) hoặc agent harness nào tạo ra mỗi cột.
- Độ biến thiên. Không có thanh sai số hay số lần chạy. Các bảng xếp hạng như Terminal-Bench báo cáo biên độ khoảng 3 đến 4 điểm, lớn hơn một số khoảng cách ở trên.
- Các lần chạy độc lập của Terminal-Bench và Work360. Chưa bài nào xuất hiện trên bảng xếp hạng công khai.
Tự chạy benchmark Qwen4-Max của riêng bạn với Apidog CLI
Không có benchmark công khai nào sử dụng prompt hoặc schema của bạn. Cách kiểm tra trung thực nhanh nhất là một bộ nhỏ các yêu cầu của riêng bạn, chạy theo cùng một cách mỗi lần, có ghi lại mức sử dụng token để bạn có thể tự tính chi phí mỗi tác vụ.
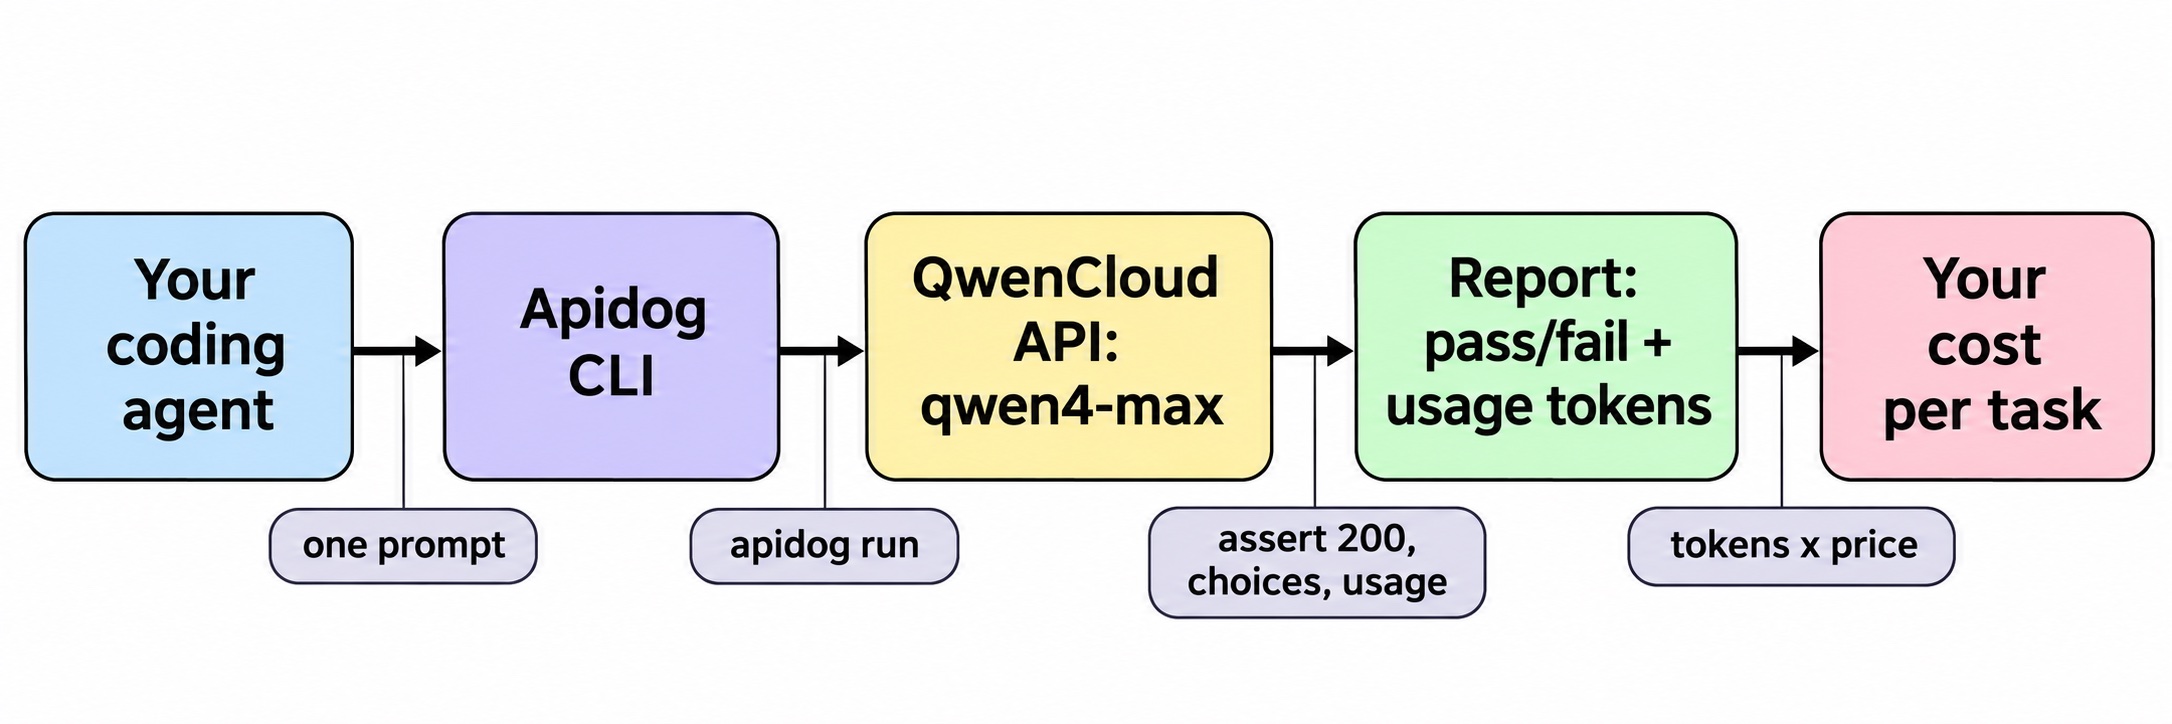
Để agent lập trình của bạn thực hiện việc cài đặt với Apidog CLI. Cài đặt một lần:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_APIDOG_TOKEN>
apidog skill install
apidog skill install dạy agent của bạn cách dùng CLI; hướng dẫn cài đặt bao quát phần token. Sau đó đưa cho nó một prompt:
In Apidog project <projectId>, add POST /chat/completions for the QwenCloud
OpenAI-compatible API (model qwen4-max, Bearer auth from {{DASHSCOPE_API_KEY}}).
Create an environment "qwencloud-sg" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1.
Create a test case that asserts status 200, a non-empty choices array and a
usage object. Run it once per row of ./prompts.csv, save a JSON report, and
give me pass rate plus total prompt and completion tokens.
Agent kiểm tra hình dạng của mỗi payload trước khi viết bất cứ thứ gì. Mọi cờ dưới đây lấy từ apidog <command> --help trên Apidog CLI 2.2.12:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file ./qwen-chat.json
apidog endpoint create --project <projectId> --file ./qwen-chat.json
apidog environment create qwencloud-sg --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -d ./prompts.csv --env-var "DASHSCOPE_API_KEY=$DASHSCOPE_API_KEY" -r cli,json
-d chạy một lần lặp cho mỗi dòng trong tệp prompt của bạn, và --env-var truyền khóa tại thời điểm chạy để nó không bao giờ nằm trong dự án. Agent đọc từng khối usage từ báo cáo JSON trong apidog-reports. Nhân token prompt với 1,50 USD và token hoàn thành với 4,50 USD mỗi triệu, và bạn sẽ có chi phí mỗi tác vụ của riêng mình để so với mức 1,67 USD của Alibaba.
Đổi môi trường để chạy cùng bộ kiểm tra với mô hình hiện tại của bạn, và lặp lại hai đến ba lần để thấy độ biến thiên mà biểu đồ ra mắt không hiển thị. Cùng dòng lệnh apidog run đó đưa vào CI với -r junit; xem hướng dẫn CI/CD. Để biết cách thiết lập agent từng bước, xem Apidog CLI trong Claude Code. Gói Free của Apidog hỗ trợ tối đa 4 người dùng.
FAQ
Các benchmark của Qwen4-Max có độc lập không? Phần lớn là không. Mười trong 16 điểm số trên biểu đồ của Alibaba là các lần chạy của chính họ. Sáu điểm được trích từ các bảng xếp hạng bên thứ ba: APEX-Agents (Mercor), AA-Briefcase và AutomationBench-AA (Artificial Analysis), CodeArena và AgentArena (LM Arena), HLAB-Vals (Vals) và Agents' Last Exam.
Work360 là gì? Benchmark của chính Alibaba dành cho các tác vụ ngành phức tạp trên 26 lĩnh vực. Qwen4-Max đạt 52,69 so với 47,74 của Qwen3.8-Max; chỉ hai mô hình đó xuất hiện trong so sánh công bố của họ.
Qwen4-Max đạt bao nhiêu trên Terminal-Bench 4.0? Alibaba báo cáo 48,5, tăng từ 38,9, với khoảng một nửa số token. Các mô hình tiên phong khác trong biểu đồ đạt từ 56,1 đến 67,2.
Qwen4-Max có chạy rẻ hơn Qwen3.8-Max không? Trên đánh giá Work360 của Alibaba, chi phí trung bình mỗi tác vụ giảm từ 4,43 USD xuống 1,67 USD. Giá niêm yết là 1,50 USD đầu vào và 4,50 USD đầu ra mỗi 1M token. Xem hướng dẫn Token Plan để biết các tùy chọn đăng ký và Qwen4-Max miễn phí để biết các cách dùng không tốn phí.
Live Delivery trong bản ra mắt Qwen4-Max là gì? Một quy trình agent giúp ra mắt sớm phiên bản đầu tiên có thể dùng được và cải tiến nó trong khi bạn điều hướng. Nó không phải là một benchmark. Hướng dẫn plugin Qwen Live Delivery của chúng tôi sẽ bao quát chi tiết.