
API Qwen4-Max đã chính thức ra mắt trên QwenCloud dưới dạng mô hình trả theo token với ID qwen4-max. Hãy tạo một khóa pay-as-you-go trong khu vực của bạn, trỏ OpenAI SDK tới https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 (Singapore), và gọi nó. Giá là 1,50 USD cho mỗi triệu token đầu vào và 4,50 USD cho mỗi triệu token đầu ra, với ngữ cảnh 1 triệu token.
Bài hướng dẫn này bao gồm khóa, base URL, chế độ thinking, vision, công cụ, đầu ra có cấu trúc, caching, lộ trình Anthropic, giới hạn và lỗi. Mọi đoạn mã đều theo tài liệu QwenCloud như đã đọc ngày 16 tháng 11 năm 2026.
Để có thông tin nền tảng, hãy đọc Qwen4-Max là gì. Để sử dụng theo gói đăng ký thay vì trả theo token, xem mọi cách dùng Qwen4-Max và hướng dẫn Token Plan.
API Qwen4-Max mang lại cho bạn những gì
API Qwen4-Max là mô hình flagship của Alibaba được phục vụ qua QwenCloud với các endpoint tương thích OpenAI, tương thích Anthropic và DashScope. Nó nhận đầu vào văn bản, hình ảnh và video, trả về văn bản, tư duy trước khi trả lời theo mặc định, và hỗ trợ function calling, đầu ra có cấu trúc, context caching, công việc batch, tìm kiếm web và fine-tuning.
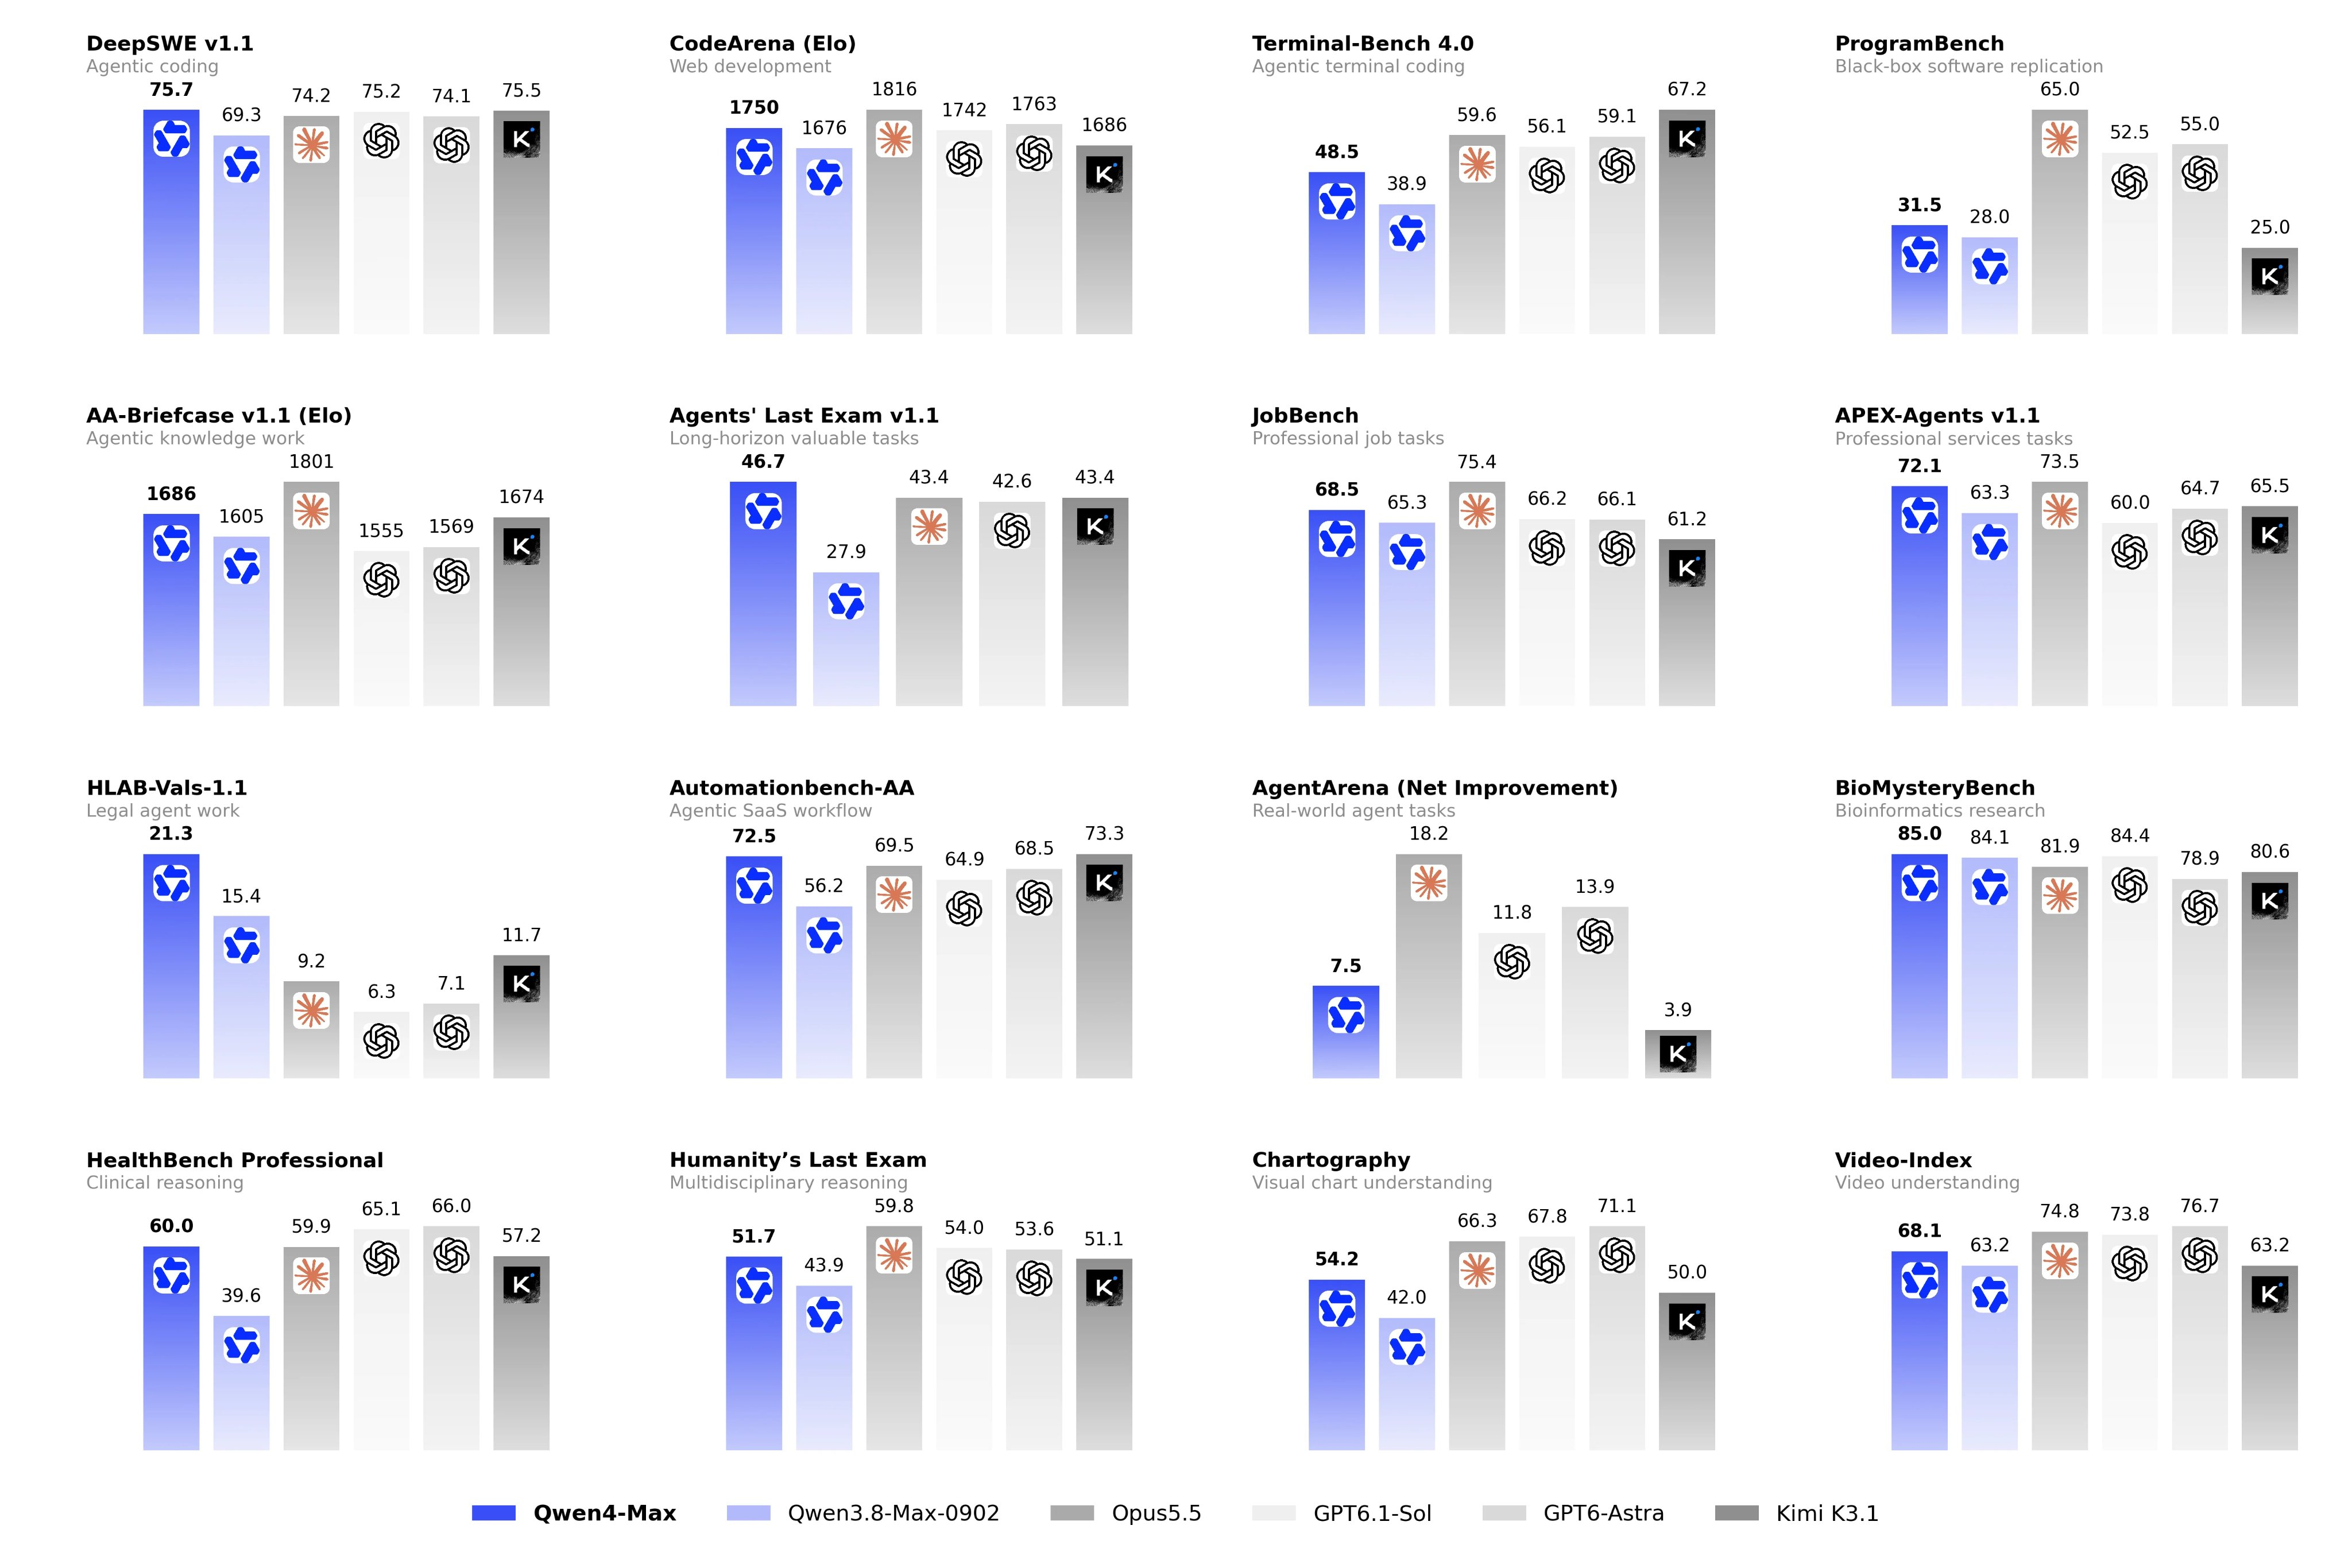
Dưới đây là các con số từ trang mô hình qwen4-max:
| Hạng mục | Giá trị |
|---|---|
| Model ID | qwen4-max |
| Giá đầu vào | 1,50 USD mỗi 1 triệu token |
| Giá đầu ra | 4,50 USD mỗi 1 triệu token |
| Đầu vào cache ngầm định / đọc cache tường minh | 0,075 USD mỗi 1 triệu token |
| Tạo cache tường minh | 1,875 USD (5 phút) hoặc 3 USD (1 giờ) mỗi 1 triệu token |
| Cửa sổ ngữ cảnh | 1 triệu token |
| Đầu vào tối đa | 991K (983K với thinking) |
| Đầu ra tối đa | 393K |
| Suy luận tối đa | 262K |
| Thông lượng | 5.000.000 TPM |
Token thinking được tính phí như token đầu ra. Để biết bảng phân tích chi phí đầy đủ, xem hướng dẫn định giá Qwen4-Max.
Lấy khóa và chọn đúng base URL
Khóa được gắn với một khu vực, và loại khóa phải khớp với endpoint.
- Mở bảng điều khiển QwenCloud và chọn khu vực ở bộ chọn góc trên bên phải.
- Đi tới API Keys, nhấn Create API key, thêm mô tả và nhấn Generate Key.
- Sao chép khóa ngay lập tức. Nó chỉ được hiển thị một lần. Khóa pay-as-you-go mới bắt đầu bằng
sk-ws-. - Xuất nó:
export DASHSCOPE_API_KEY="sk-ws-...".
Mọi khu vực đều dùng tên miền {region}.maas.qwencloudapi.com. Singapore là ap-southeast-1; Frankfurt là eu-central-1, Tokyo là ap-northeast-1 và Mỹ (Virginia) là us-east-1. Sau đó thêm đường dẫn giao thức:
| Giao thức | Base URL (Singapore) |
|---|---|
| Tương thích OpenAI (Chat Completions, Responses) | https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 |
| Tương thích Anthropic | https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic |
| DashScope HTTP | https://ap-southeast-1.maas.qwencloudapi.com/api/v1 |
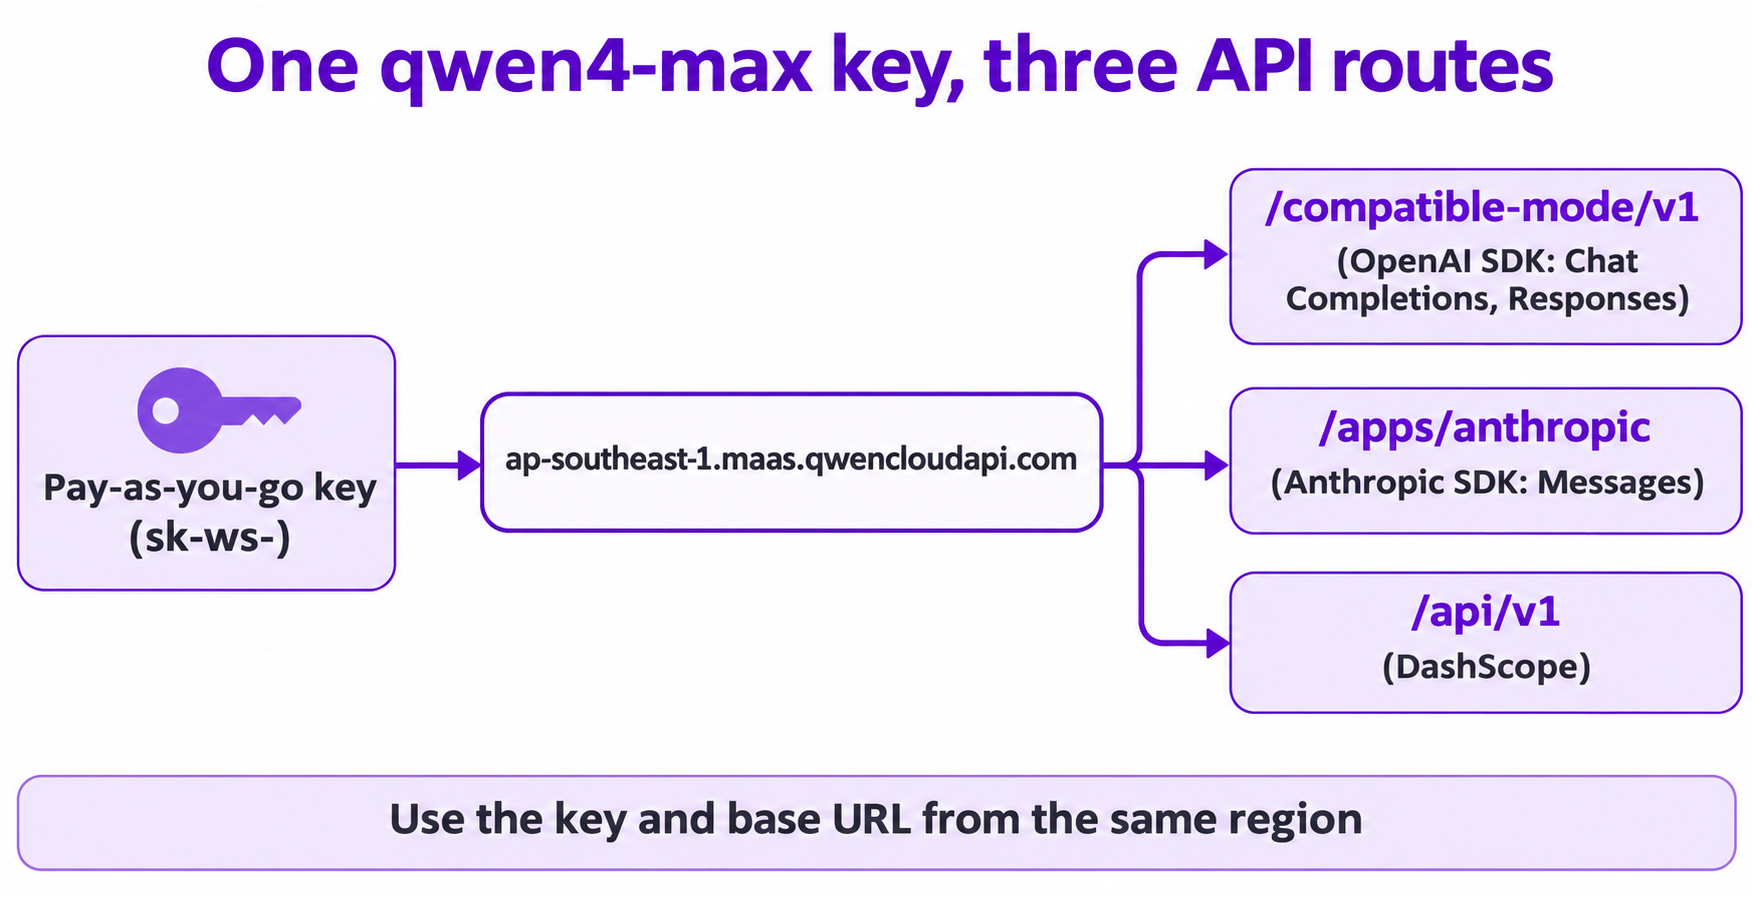
Khóa Token Plan (sk-sp-) chỉ hoạt động trên token-plan.maas.qwencloudapi.com, còn khóa pay-as-you-go chỉ hoạt động trên tên miền của khu vực của nó. Trộn lẫn chúng sẽ gây lỗi 401. Xem khu vực và endpoint.
Lời gọi API Qwen4-Max đầu tiên của bạn
Cài đặt OpenAI SDK (pip install openai) và chạy quickstart từ tài liệu:
import os
from openai import OpenAI

client = OpenAI(
  api_key=os.getenv("DASHSCOPE_API_KEY"),
  base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1"
)
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Summarize the benefits of solar energy in three bullet points."}]
)
print(completion.choices[0].message.content)
Thinking được bật mặc định cho qwen4-max, nên lời gọi này cũng tiêu tốn token suy luận. Với prompt dài, hãy dùng streaming hoặc đặt timeout của client từ 180 giây trở lên.
Chế độ thinking và streaming reasoning_content
Qwen4-Max là mô hình hybrid thinking. Các giá trị mặc định được ghi trong tài liệu là enable_thinking=true, reasoning_effort=high và thinking_budget=131072. Các mức effort là low, high và xhigh; none tắt thinking.
Streaming suy luận và câu trả lời dưới dạng hai pha (điều chỉnh từ mẫu trên trang mô hình):
from openai import OpenAI
import os

client = OpenAI(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1",
)
messages = [{"role": "user", "content": "Who are you"}]
completion = client.chat.completions.create(
    model="qwen4-max",
    messages=messages,
    extra_body={"enable_thinking": True},
    stream=True
)
for chunk in completion:
    if not chunk.choices:
        continue
    delta = chunk.choices[0].delta
    if getattr(delta, "reasoning_content", None):
        print(delta.reasoning_content, end="", flush=True)  # phase 1: thinking
    if delta.content:
        print(delta.content, end="", flush=True)            # phase 2: answer
Ba quy tắc:
- Giới hạn đầu ra bằng
max_completion_tokens. Khi thinking bật,max_tokenschỉ chấp nhận từ 1 đến 32.768 (nếu không sẽ bị lỗi 400).max_completion_tokensbao gồm cả suy luận lẫn phản hồi mà không có giới hạn đó. - Điều chỉnh độ sâu bằng
extra_body. Truyền{"enable_thinking": True, "reasoning_effort": "xhigh"}cho bài toán khó, hoặc"low"cho bài toán đơn giản. - Giữ suy luận trong hội thoại nhiều lượt.
qwen4-maxbậtpreserve_thinkingtheo mặc định, nên hãy gửi lại suy luận trước đó trong trườngreasoning_contentcủa mỗi tin nhắn assistant, không bao giờ đặt bên trongcontent.
Để bỏ qua thinking, truyền {"enable_thinking": False}.
Đầu vào hình ảnh và video
Gửi hình ảnh dưới dạng phần image_url và video dưới dạng phần video_url. Cách làm này tương tự mẫu vision trong tài liệu với mô hình được đặt là qwen4-max:
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{
    "role": "user",
    "content": [
      {"type": "image_url", "image_url": {"url": "https://example.com/invoice.jpg"}},
      {"type": "text", "text": "Describe what you see in this image"},
    ],
  }],
)
Với video, dùng {"type": "video_url", "video_url": {"url": "..."}, "fps": 2}. Tệp cục bộ được gửi dưới dạng Data URI Base64.
Hướng dẫn vision cho phép tối đa 2.048 ảnh URL với kích thước 20 MB mỗi ảnh, 250 ảnh Base64, và 64 MB mỗi yêu cầu. Chi tiết ảnh mặc định là high, tốn nhiều token đầu vào hơn.
Function calling
Truyền một mảng tools giống như mọi mô hình tương thích OpenAI khác:
tools = [{
  "type": "function",
  "function": {
    "name": "get_current_weather",
    "description": "Useful when you want to check the weather for a specific city.",
    "parameters": {
      "type": "object",
      "properties": {"location": {"type": "string", "description": "City or county, such as Singapore or New York."}},
      "required": ["location"],
    },
  },
}]
completion = client.chat.completions.create(model="qwen4-max", messages=messages, tools=tools)
Đọc message.tool_calls, chạy hàm, thêm một tin nhắn tool và gọi lại.
Ở chế độ thinking, tool_choice chỉ chấp nhận "auto" hoặc "none"; để ép gọi một hàm, hãy tắt thinking trước. Khi thinking bật, hãy gửi reasoning_content kèm kết quả công cụ, nếu không độ chính xác sẽ giảm.
Đầu ra có cấu trúc
qwen4-max hỗ trợ chế độ JSON Schema nghiêm ngặt:
completion = client.chat.completions.create(
  model="qwen4-max",
  messages=[{"role": "user", "content": "Extract the name and age: Ana is 31."}],
  response_format={
    "type": "json_schema",
    "json_schema": {
      "name": "user_info",
      "strict": True,
      "schema": {
        "type": "object",
        "properties": {"name": {"type": "string"}, "age": {"type": "integer"}},
        "required": ["name", "age"],
        "additionalProperties": False,
      },
    },
  },
)
Với chế độ lỏng hơn {"type": "json_object"}, từ "JSON" phải xuất hiện trong một tin nhắn, nếu không API sẽ từ chối yêu cầu. Đầu vào hình ảnh hoặc video sẽ quay về json_object, nên schema không được áp dụng cho các lời gọi multimodal.
Context cache và batch
Cache. Không có cài đặt nào, cache ngầm định khớp các tiền tố nhưng không đảm bảo trúng. Để trúng xác định, hãy dùng cache tường minh Qwen4: đánh dấu một khối nội dung bằng "prompt_cache_breakpoint": {"mode": "explicit"} (tin nhắn content phải là một mảng), và đặt TTL bằng extra_body={"prompt_cache_options": {"mode": "explicit", "ttl": "5m"}}. TTL là 5m hoặc 1h, và tiền tố được cache cần ít nhất 1.024 token. Đọc cache có giá 0,075 USD mỗi triệu token, rẻ hơn 95% so với đầu vào mới.
Batch. Hướng dẫn batch tính phí đầu vào và đầu ra bằng 50% giá thời gian thực và trả kết quả trong vòng 24 giờ. Với qwen4-max, Batch File chạy trong một khu vực ngoài Singapore và không hỗ trợ context caching, nên hãy kiểm tra hướng dẫn batch trước khi xây dựng pipeline dựa trên nó.
Lộ trình tương thích Anthropic
Đã xây dựng sẵn trên Anthropic SDK? Chỉ cần đổi base URL và khóa:
import anthropic
import os

client = anthropic.Anthropic(
    api_key=os.getenv("DASHSCOPE_API_KEY"),
    base_url="https://ap-southeast-1.maas.qwencloudapi.com/apps/anthropic",
)
message = client.messages.create(
    model="qwen4-max",
    max_tokens=1024,
    messages=[{"role": "user", "content": "Who are you?"}],
    thinking={"type": "disabled"},
)
print(message.content)
Mẫu này tắt thinking, giống như mẫu trong tài liệu. Base URL phải kết thúc tại /apps/anthropic. Thêm /v1/ sẽ tạo ra /v1/v1/... và lỗi 404. Thinking cũng bật mặc định ở đây, và khi thinking được bật, max_tokens phải lớn hơn ngân sách thinking. Effort dùng output_config.effort (low, high, xhigh), và các công cụ tích hợp sẵn web_search và web_fetch có sẵn trên lộ trình này.
Giới hạn tốc độ của API Qwen4-Max
| Khu vực | RPM | TPM |
|---|---|---|
| Singapore | Động | Các bậc động: 5M, 10M, 20M |
| Frankfurt, Tokyo, Mỹ (Virginia) và các khu vực phạm vi Global khác | 30.000 | 5.000.000 |
Giới hạn áp dụng cho mỗi tài khoản theo khu vực và cả theo giây (RPS = RPM / 60), nên một đợt bùng nổ có thể khiến bạn bị điều tiết dù chưa đạt tổng mỗi phút.
Trang hạn mức miễn phí cho biết hạn mức miễn phí chỉ tồn tại ở Singapore, áp dụng cho từng mô hình (thường là 1.000.000 token), kéo dài 90 ngày và cần có thông tin thanh toán được lưu. Nó không nêu tên qwen4-max, nên hãy kiểm tra trang Free Tier trong bảng điều khiển, hoặc đọc cách dùng Qwen4-Max miễn phí.
Các lỗi phổ biến của API Qwen4-Max
| Mã | Ý nghĩa | Cách khắc phục |
|---|---|---|
401 InvalidApiKey |
Khóa và base URL thuộc các khu vực khác nhau, hoặc khóa Token Plan được dùng trên endpoint pay-as-you-go | Dùng khóa được tạo trong cùng khu vực với URL |
400 InvalidParameter |
Thường là max_tokens ngoài khoảng 1 đến 32.768 khi thinking bật |
Chuyển sang max_completion_tokens |
403 AllocationQuota.FreeTierOnly |
Hạn mức miễn phí đã dùng hết trước khi thiết lập thanh toán | Thêm thông tin thanh toán trên trang Free Tier |
404 ModelNotFound |
qwen4-max không được cung cấp ở khu vực bạn đã gọi |
Kiểm tra giá Model cho khu vực đó |
429 Throttling |
Đạt giới hạn RPM hoặc TPM | Chờ rồi thử lại, hoặc phân tán tải theo từng giây |
Để agent lập trình của bạn kiểm thử API Qwen4-Max bằng Apidog CLI
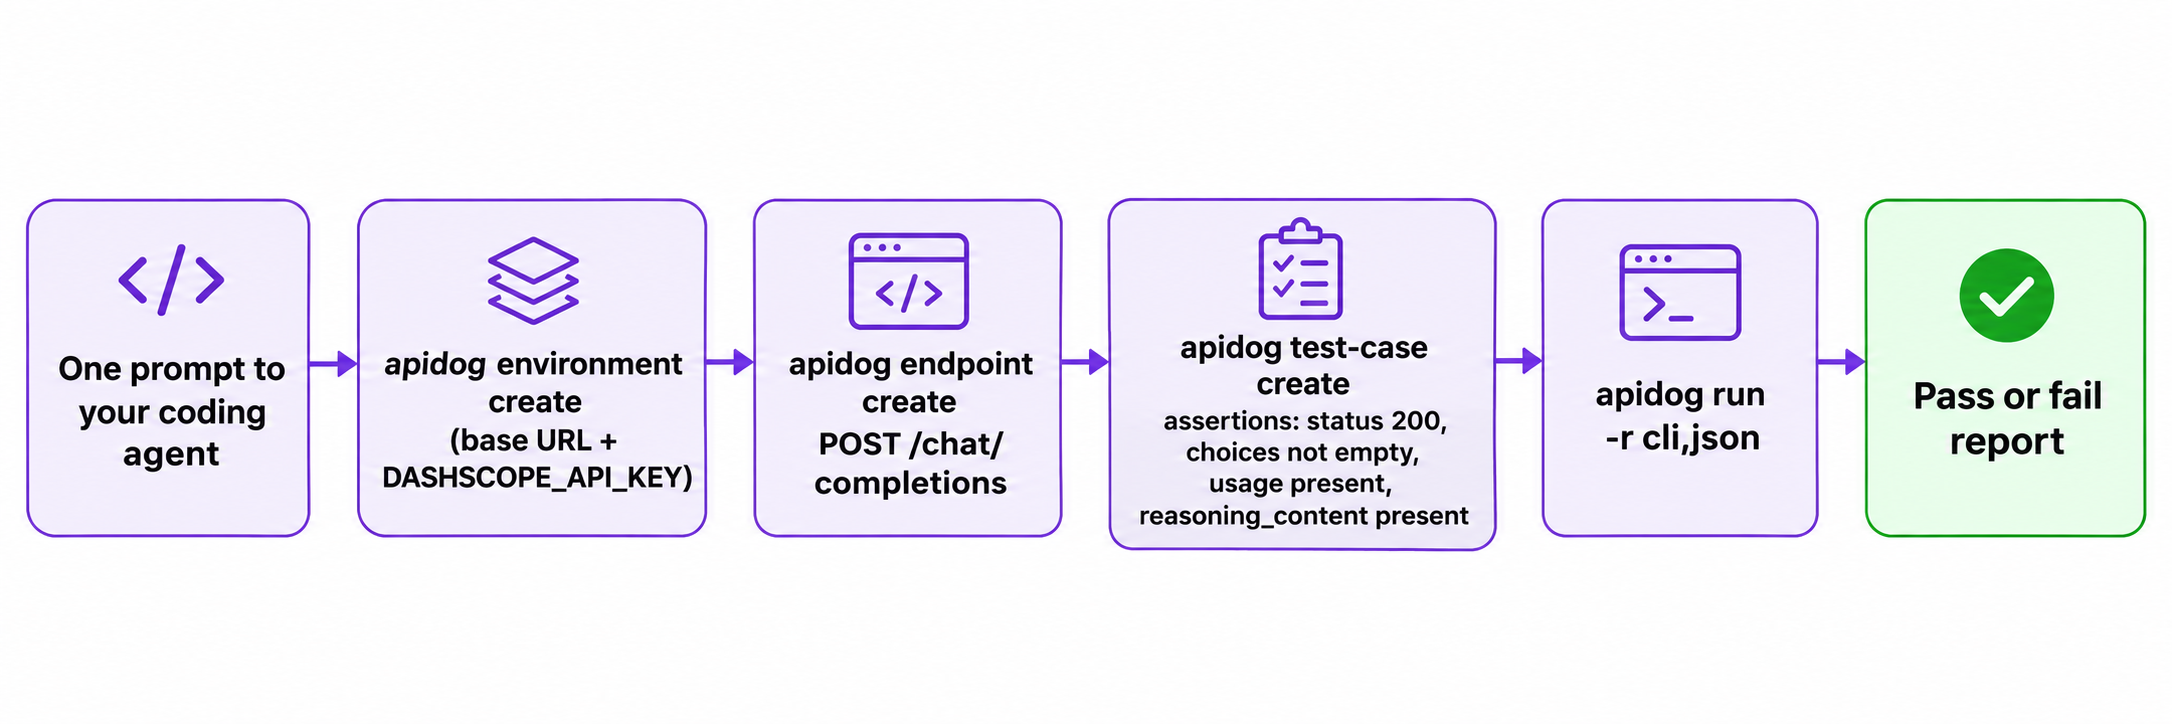
Agent lập trình của bạn viết phần tích hợp, vậy hãy để nó viết cả bài kiểm thử hồi quy. Apidog CLI cho phép nó lưu endpoint, lưu khóa và chạy các kiểm tra khẳng định.
Thiết lập một lần:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho agent một prompt:
In Apidog project <projectId>, create an environment "Qwen Singapore" with base URL
https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1 and a secret
variable DASHSCOPE_API_KEY. Add POST /chat/completions with a Bearer auth header,
model qwen4-max and enable_thinking true. Create a test case asserting status 200,
a non-empty choices array, a usage object, and reasoning_content present on the
first choice's message. Run it and summarize any failures.
Agent đọc schema của mỗi payload trước khi viết, rồi chạy test case:
apidog environment create "Qwen Singapore" --project <projectId> --base-url https://ap-southeast-1.maas.qwencloudapi.com/compatible-mode/v1
apidog cli-schema get environment-update
apidog environment update <envId> --project <projectId> --file env.json
apidog cli-schema get endpoint-create
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Trình báo cáo cli in kết quả đạt hay không đạt; json ghi ra báo cáo mà agent đọc được. Đưa cùng lệnh apidog run ... -r junit vào CI với hướng dẫn CI/CD Apidog CLI, và xem Apidog CLI trong Claude Code để có thêm các prompt. Gói Free của Apidog hỗ trợ tới 4 người dùng.
Câu hỏi thường gặp
Model ID của API Qwen4-Max là gì?
ID ổn định là qwen4-max. ID qwen4-max-preview trước đó chỉ dành cho Token Plan trong giai đoạn preview bắt đầu ngày 11 tháng 11 năm 2026.
API Qwen4-Max có tương thích OpenAI không?
Có. Hãy dùng OpenAI SDK với base URL /compatible-mode/v1 cho Chat Completions và API Responses. Cũng có sẵn một endpoint tương thích Anthropic và API DashScope.
Làm sao tắt thinking trong API Qwen4-Max?
Truyền extra_body={"enable_thinking": False}. Bạn sẽ mất reasoning_content, nhưng độ trễ và số token đầu ra giảm. So sánh các mô hình? Xem Qwen4-Max vs Qwen3.8.
API Qwen4-Max có giá bao nhiêu?
1,50 USD mỗi triệu token đầu vào và 4,50 USD mỗi triệu token đầu ra, với lượt đọc cache giá 0,075 USD mỗi triệu.
Tôi có thể dùng khóa Token Plan với API trả theo token không?
Không. Khóa Token Plan (sk-sp-) chỉ hoạt động trên token-plan.maas.qwencloudapi.com, còn khóa pay-as-you-go chỉ hoạt động trên tên miền của khu vực của nó.