OpenAI và Anthropic đã cắt giảm mạnh giá API kể từ tháng 7 năm 2026, và các đợt cắt giảm này nằm trên chính trang giá của họ. GPT-5.6 Luna giảm 80% chỉ sau một đêm, GPT-6.1 Sol niêm yết ở mức $2/$10 so với $5/$30 của GPT-5.6 Sol, Claude Opus 5.5 cắt giảm giá đọc cache 60%, và Claude Haiku 5.5 niêm yết bằng một phần mười Haiku 4.5. Nếu mô hình chi phí, quy tắc định tuyến hoặc cảnh báo ngân sách của bạn có từ trước tháng 9, thì giờ chúng đã sai, phần lớn theo hướng có lợi cho bạn. Dưới đây: giá trước/sau đã được xác minh, phép tính theo từng yêu cầu, những cạm bẫy vẫn làm phồng hóa đơn, và cách để coding agent của bạn biến ngân sách token thành các bài kiểm tra.
Điểm khởi đầu là bài luận của Max Woolf OpenAI và Anthropic cắt giảm giá LLM tới 80% trong vòng vài tháng. Tại sao? và luồng thảo luận trên Hacker News của nó. Chúng tôi đã đề cập khía cạnh thị trường trong cuộc chiến giá mô hình AI tháng 9 năm 2026; bài viết này nói về những gì một nhóm nên thay đổi.
Giá trước/sau đã được xác minh
USD trên một triệu token (đầu vào / đầu ra / đầu vào được cache), hạng tiêu chuẩn, dưới ngưỡng ngữ cảnh dài. Các hàng của OpenAI lấy từ trang giá OpenAI API đọc ngày 2026-10-26, với giá “trước” từ các bản lưu trữ của trang đó. Các hàng của Anthropic lấy từ tài liệu giá Claude, liệt kê các mô hình cũ và mới cạnh nhau.
| Thay đổi mô hình | Trước | Sau | Thay đổi | Thời điểm |
|---|---|---|---|---|
| GPT-5.6 Luna (cắt giảm giá) | $1 / $6 / $0.10 | $0.20 / $1.20 / $0.02 | -80% toàn bộ | 2026-07-30 |
| GPT-5.6 Terra (cắt giảm giá) | $2.50 / $15 / $0.25 | $2 / $12 / $0.20 | -20% | 2026-07-30 |
| GPT-5.6 Sol (khuyến mãi) | $5 / $30 / $0.50 | $4 / $20 / $0.40 | -20% đầu vào, -33% đầu ra | 2026-08-21 |
| GPT-5.6 Sol niêm yết sang GPT-6.1 Sol | $5 / $30 / $0.50 | $2 / $10 / $0.10 | -60% đầu vào, -67% đầu ra, -80% cache | 2026-09-29 |
| GPT-5.6 Luna sang GPT-6 Luna | $0.20 / $1.20 / $0.02 | $0.10 / $0.50 / $0.01 | -50% đầu vào, -58% đầu ra | 2026-09-22 |
| Claude Opus 5 sang Opus 5.5 | $5 / $25 / $0.50 | $4 / $20 / $0.20 | -20% đầu vào/đầu ra, -60% cache | 2026-09-22 |
| Claude Fable 5 sang Fable 5.1 | $10 / $50 / $1 | $10 / $50 / $0.25 | chỉ -75% cache | Tháng 9 năm 2026 |
| Claude Sonnet 5 sang Sonnet 5.5 | $2 / $10 / $0.20 | $2 / $10 / $0.10 | chỉ -50% cache | Tháng 9-10 năm 2026 |
| Claude Haiku 4.5 sang Haiku 5.5 | $1 / $5 / $0.10 | $0.10 / $0.50 / $0.01 | -90% (prompt tối đa 100K) | Tháng 10 năm 2026 |
Chỉ các hàng GPT-5.6 là cắt giảm trên cùng một mô hình; phần còn lại là các mô hình kế nhiệm rẻ hơn, nên chất lượng và số lượng token khác nhau. Giá ra mắt $2/$10 của Sonnet 5 đã trở thành vĩnh viễn, và tài liệu nói rằng kế hoạch chuyển sang $3/$15 “sẽ không xảy ra”. Ưu đãi GPT-5.6 Sol là khuyến mãi, “có ít nhất đến hết ngày 21 tháng 11 năm 2026”. Giá Luna và Terra trước khi cắt giảm nằm trên trang giá OpenAI lưu trữ từ ngày 29 tháng 7.
Phân tích chi tiết từng mô hình: cắt giảm giá GPT-5.6, giá GPT-6 Sol, giá Claude Haiku 5.5.
Tại sao giá giảm
Lý do chính thức duy nhất đến từ Anthropic: thông báo Claude Opus 5.5 nói rằng mô hình này “cần ít compute hơn để phục vụ so với Opus 5, và giá của nó phản ánh điều đó”, và ước tính chi phí thấp hơn 40% trên các khối lượng công việc thông thường. Các trang của OpenAI không đưa ra lý do. Phần còn lại là ý kiến:
- Cạnh tranh, chi phí chuyển đổi thấp. Woolf lập luận rằng các mô hình giờ đây gần như có thể thay thế cho nhau: việc chuyển đổi chỉ là một nút bật trong harness hoặc một chuỗi mô hình mới thông qua router. Các mô hình trọng số mở được nhiều nhà cung cấp phục vụ (ông đếm được 29 cho một biến thể DeepSeek Flash trên OpenRouter vào ngày 24 tháng 10) đặt ra mức sàn.
- Ăn miếng trả miếng. Các đợt cắt giảm luân phiên giữa hai công ty, và cả hai đều tung ra các mô hình chủ lực rẻ hơn vào ngày 22 tháng 9.
- Thời điểm IPO. Woolf lưu ý rằng cả hai được đồn đoán là đang tiến gần đến IPO và thấy thời điểm này kỳ lạ. Đó là suy đoán về động cơ.
- Hiệu quả. Nhiều bình luận viên trên HN đưa ra câu chuyện đơn giản hơn: cache tốt hơn, mô hình nhỏ hơn, phục vụ rẻ hơn.
Woolf cũng trích dẫn dữ liệu từ Vercel AI Gateway: chi phí trên mỗi token giảm xuống còn 43,3% so với mức tháng 4 năm 2026 trong khi tổng chi tiêu tăng. Token rẻ hơn hiếm khi làm giảm hóa đơn trừ khi bạn thay đổi cách chi tiêu chúng.
Những gì các đợt cắt giảm thay đổi: phép tính theo từng yêu cầu đã thực hiện
Một lượt agent nặng về cache
Lấy một lượt của coding agent: 100.000 token hội thoại đọc từ cache, 2.000 token đầu vào mới, 1.000 token đầu ra.
| Mô hình | Đọc cache | Đầu vào mới | Đầu ra | Chi phí lượt |
|---|---|---|---|---|
| GPT-5.6 Sol (niêm yết) | $0.050 | $0.010 | $0.030 | $0.090 |
| GPT-5.6 Sol (khuyến mãi) | $0.040 | $0.008 | $0.020 | $0.068 |
| GPT-6.1 Sol | $0.010 | $0.004 | $0.010 | $0.024 |
| Claude Opus 5 | $0.050 | $0.010 | $0.025 | $0.085 |
| Claude Opus 5.5 | $0.020 | $0.008 | $0.020 | $0.048 |
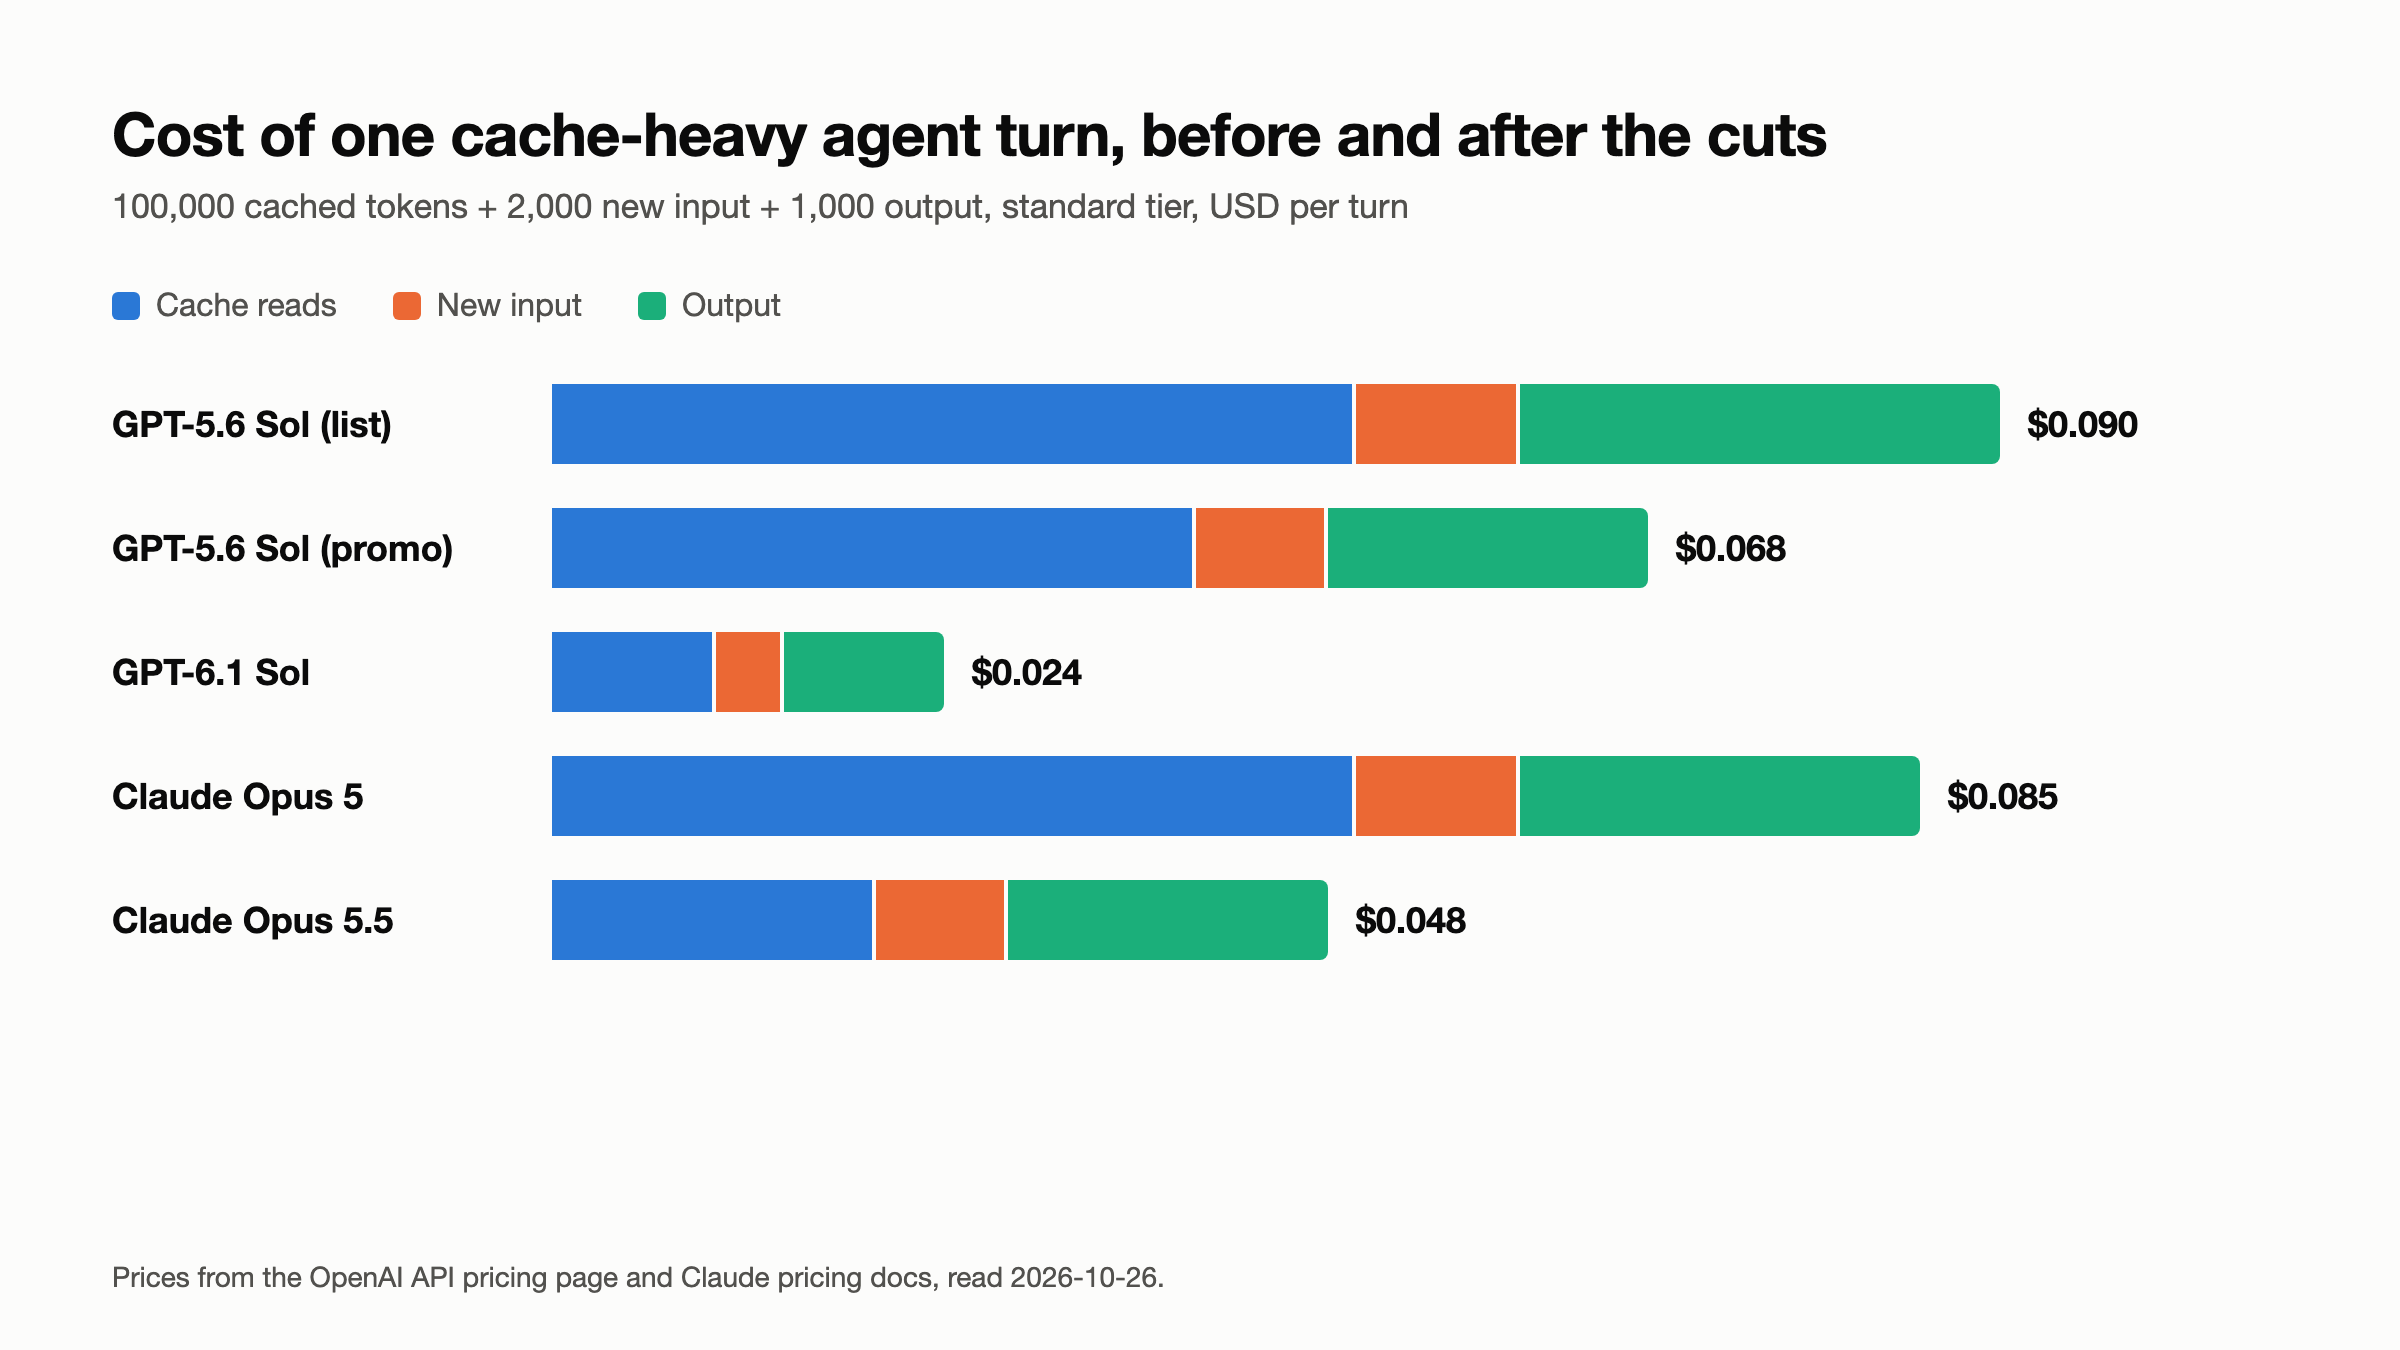
GPT-6.1 Sol thấp hơn 73% so với giá niêm yết của GPT-5.6 Sol trong lượt này, và Opus 5.5 thấp hơn 44% so với Opus 5, gần với mức 40% của Anthropic. Trên các mô hình cũ, đọc cache chiếm hơn một nửa lượt, vì vậy giá đọc cache giờ là con số quan trọng đối với agent. Đó là lý do việc cắt giảm chỉ ở cache của Fable 5.1 quan trọng hơn mức $10/$50 không đổi của nó. Xem phép tính điểm hòa vốn cache của Opus 5.5 và hướng dẫn prompt caching GPT-6 của chúng tôi.
Cần thay đổi gì: xếp hạng các mô hình theo chi phí mỗi lượt ở tỷ lệ cache-hit thực tế của bạn, không phải theo giá đầu vào niêm yết.
Một bộ phân loại khối lượng lớn
Giờ là một router hoặc bộ phân loại: 1 triệu yêu cầu mỗi ngày, mỗi yêu cầu 1.500 token đầu vào và 200 token đầu ra, không cache.
- GPT-5.6 Luna trước ngày 30 tháng 7: 1,5 tỷ đầu vào ở mức $1 cộng 200 triệu đầu ra ở mức $6 = $2,700/ngày
- GPT-6 Luna: $150 + $100 = $250/ngày
- Claude Haiku 4.5: $1,500 + $1,000 = $2,500/ngày
- Claude Haiku 5.5: $150 + $100 = $250/ngày
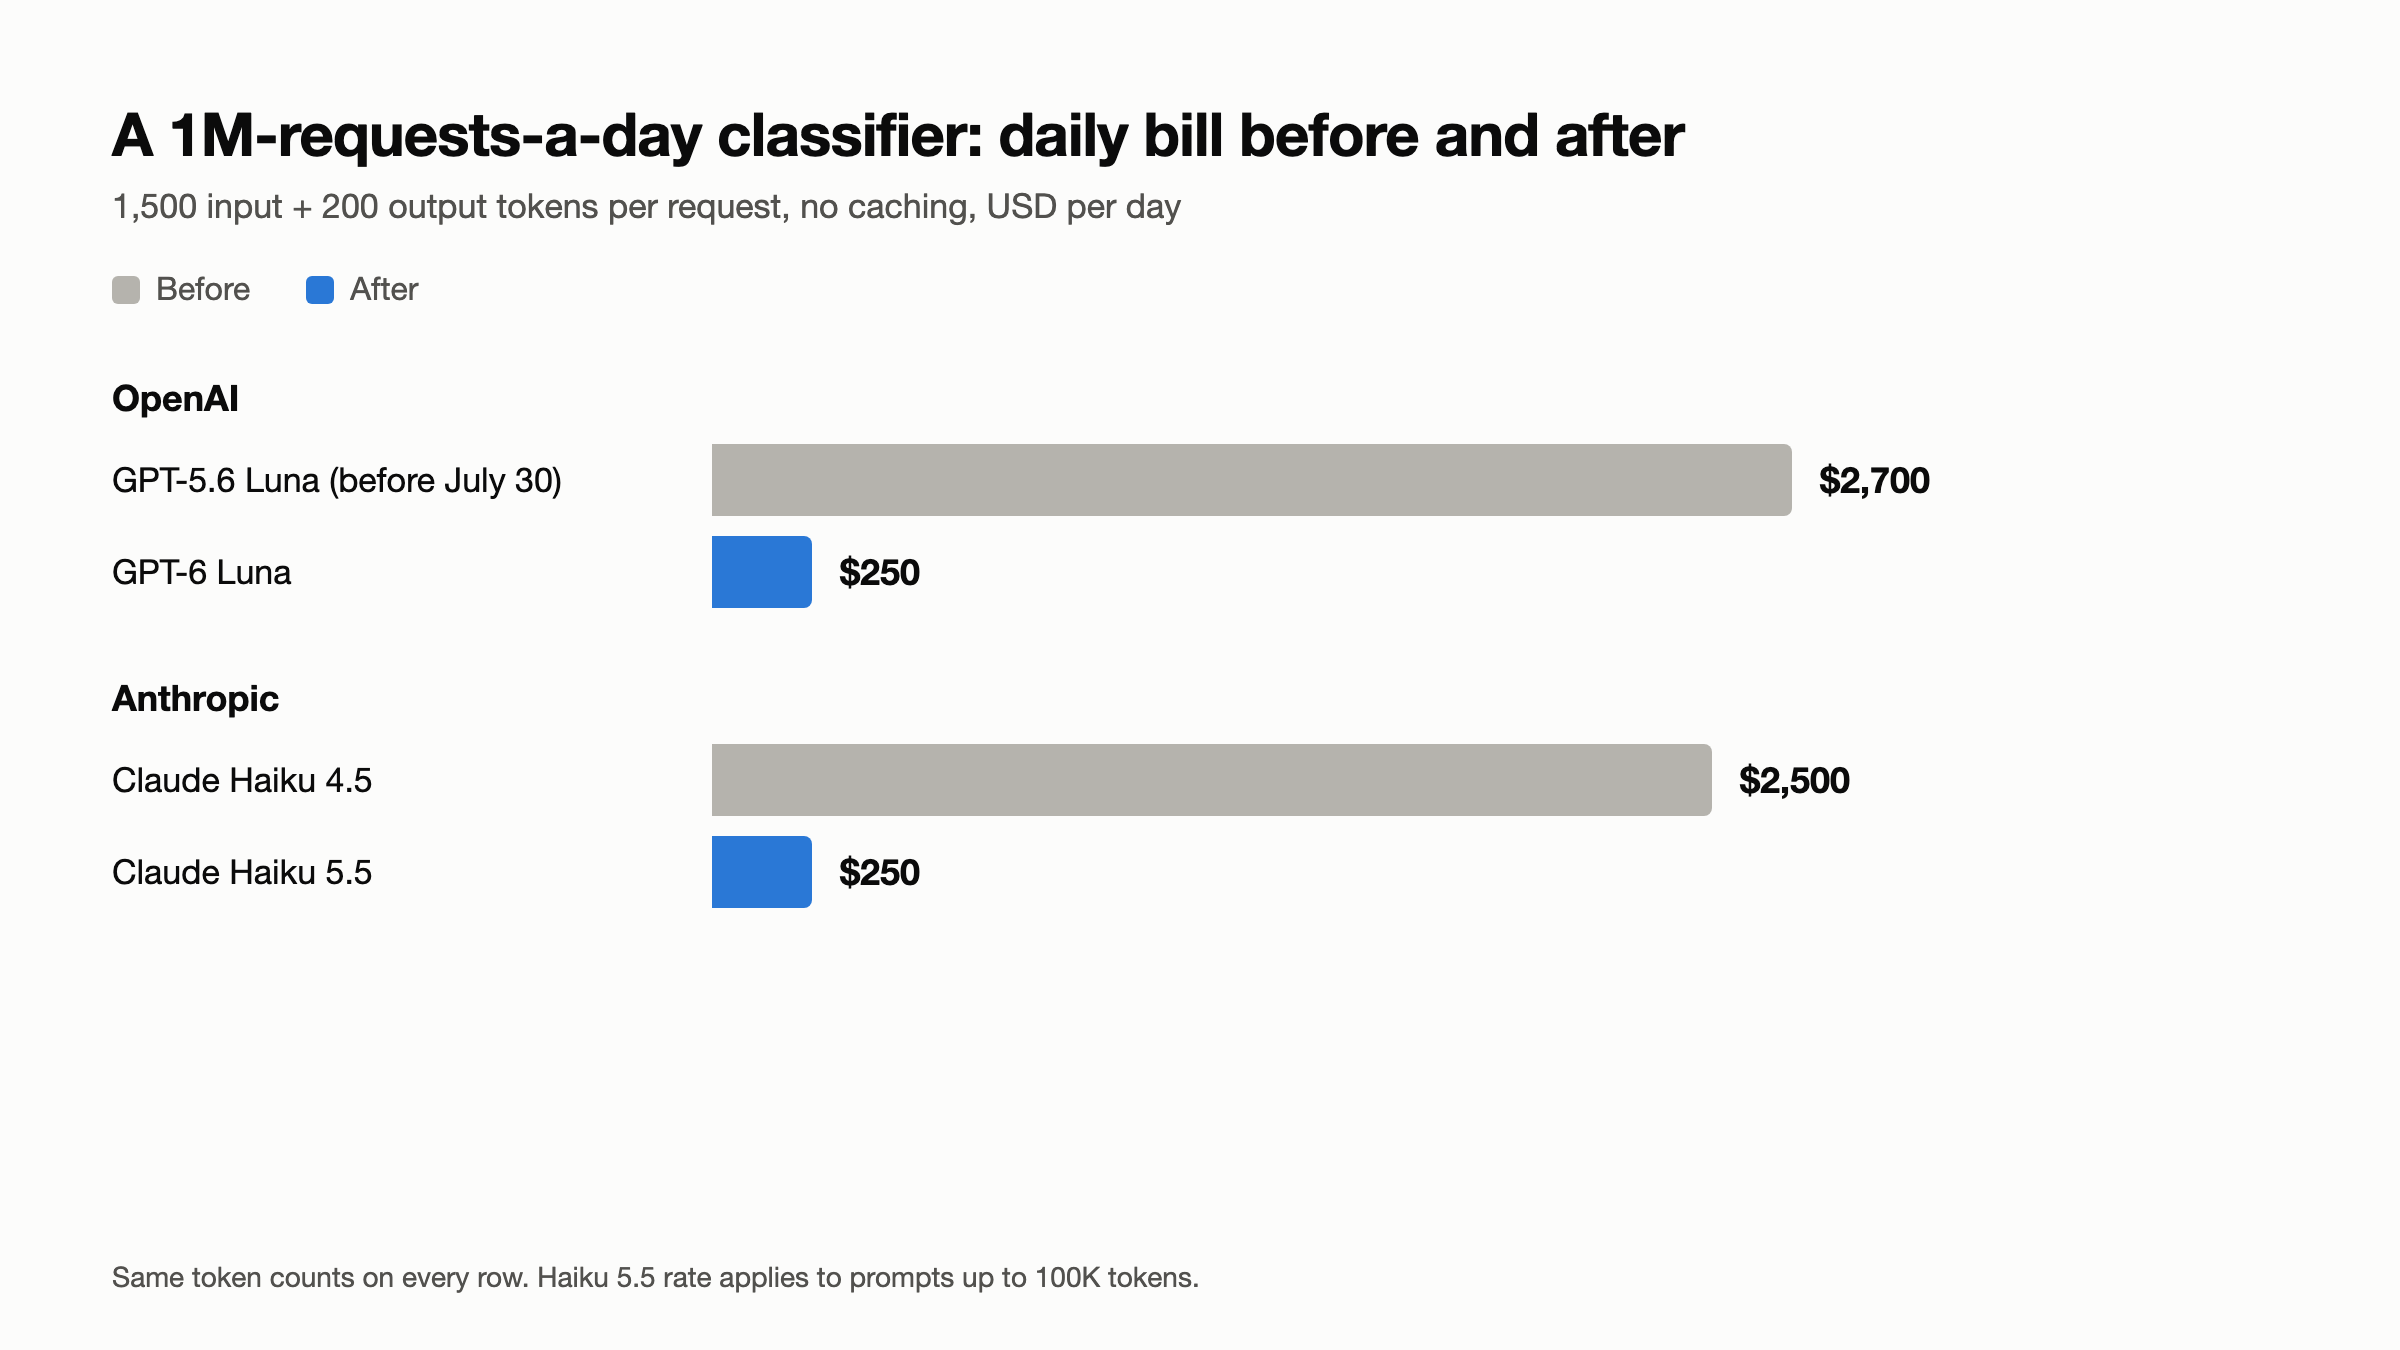
Cần thay đổi gì: ngừng cắt gọt prompt cho các mô hình nhỏ, và kiểm tra xem lưu lượng tầm trung giờ có vừa với một mô hình nhỏ hay không. Chạy bộ đánh giá của bạn trước: giá trên mỗi token không nói lên điều gì về độ chính xác trên dữ liệu của bạn.
Batch: ít đô la hơn, cùng tỷ lệ phần trăm
Cả hai vẫn giảm 50% cho công việc bất đồng bộ: Batch API của Anthropic giảm một nửa đầu vào và đầu ra, và hạng Flex/Batch của OpenAI giảm một nửa mọi thứ, bao gồm cả đầu vào được cache (GPT-6.1 Sol: $1 / $5 / $0.05). Với bộ phân loại ở trên, batch giờ tiết kiệm $125 một ngày. Đối với khối lượng công việc nhỏ, điều đó có thể không còn đủ để biện minh cho cơ sở hạ tầng xếp hàng bổ sung; đối với khối lượng lớn, hướng dẫn OpenAI Batch API vẫn áp dụng.
Những cạm bẫy vẫn làm phồng hóa đơn
Ghi cache tốn kém hơn đầu vào. Anthropic tính 1,25 lần đầu vào cơ bản cho bản ghi 5 phút và 2 lần cho bản ghi 1 giờ. Bảng của OpenAI cũng có cột ghi: 1,25 lần cho 30 phút và 2,5 lần cho 12 giờ (GPT-6.1 Sol: $2.50 và $5 so với $2 đầu vào). Một tiền tố được ghi mà không bao giờ đọc tốn thêm 25% đến 150% so với không cache. Với giá đọc bằng 5% đầu vào, bản ghi ngắn hoàn vốn sau một lần đọc, bản ghi dài sau hai lần.
Hệ số nhân ngữ cảnh dài. Trên GPT-6.1 Sol và GPT-6 Luna, các trang mô hình của OpenAI nói rằng các prompt trên 272K token đầu vào được tính giá bằng 2 lần giá đầu vào và giá cache và 1,5 lần đầu ra “cho toàn bộ yêu cầu”. Claude Haiku 5.5 nhảy từ $0.10/$0.50 lên $0.50/$2.50 khi trên 100.000 token prompt, và Anthropic tính cả đọc và ghi cache vào ngưỡng đó. Các mô hình Claude 4.6 và mới hơn khác tính toàn bộ cửa sổ 1M theo giá tiêu chuẩn. Một prompt quá khổ trên đường dẫn nóng có thể xóa sạch khoản tiết kiệm.
Token suy luận là token đầu ra. Hướng dẫn suy luận của OpenAI nói rằng token suy luận được “tính phí như token đầu ra” và hiển thị chúng trong usage.output_tokens_details.reasoning_tokens. Một phản hồi có thể đạt max_output_tokens trước khi có bất kỳ đầu ra hiển thị nào, và bạn vẫn phải trả tiền. Tài liệu chi phí suy nghĩ của Anthropic tính phí toàn bộ phần suy nghĩ, không phải bản tóm tắt hiển thị, được báo cáo trong usage.output_tokens_details.thinking_tokens. Đầu ra là phía đắt đỏ của mọi hàng, vì vậy cài đặt nỗ lực có thể làm thay đổi hóa đơn nhiều hơn cả việc chọn mô hình.
Phụ phí khu vực. OpenAI cộng thêm 10% cho xử lý khu vực (lưu trú dữ liệu) trên các mô hình phát hành từ ngày 5 tháng 3 năm 2026 trở đi, và 10% cho các endpoint FedRAMP. Anthropic áp dụng hệ số 1,1 khi bạn đặt inference_geo: "us", và các endpoint khu vực trên Bedrock và Google Cloud có phụ phí 10% so với các endpoint toàn cầu.
Tokenizer và khuyến mãi. Tài liệu của Anthropic nói rằng các mô hình Claude 4.7 và mới hơn sử dụng tokenizer tạo ra khoảng 30% token nhiều hơn cho cùng một văn bản so với Sonnet 4.6 và cũ hơn, vì vậy trên cùng một văn bản, Haiku 4.5 sang Haiku 5.5 tính ra gần 87% hơn là 90%. Và nếu bạn đã ghim gpt-5.6-sol để giữ mức giá khuyến mãi, hãy đánh dấu ngày 21 tháng 11 năm 2026 vào lịch của bạn.
Hãy để coding agent của bạn đặt các khẳng định chi phí lên các lệnh gọi LLM của bạn với Apidog CLI
Giá thay đổi hàng tháng; số lượng token thay đổi mỗi khi ai đó sửa prompt hoặc tăng cài đặt nỗ lực. Cách khắc phục bền vững là một bài kiểm tra thất bại khi một lệnh gọi vượt ngân sách, được chạy trên mỗi pull request. Hãy để Claude Code, Codex hoặc Cursor viết nó với Apidog CLI.
Cài đặt CLI và kỹ năng agent một lần:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho agent của bạn một prompt:
In Apidog project <id>, create an environment "openai" with base URL https://api.openai.com
and an endpoint POST /v1/responses. Add a test case that sends our support-ticket summary
prompt to gpt-6.1-sol and asserts: HTTP 200, usage.output_tokens at most 1500 and
usage.output_tokens_details.reasoning_tokens at most 1000. Use an API key variable,
not a literal. Run it and summarize any failures.
Agent đọc từng lược đồ payload, xác thực trước khi ghi, và chạy case:
apidog environment create openai --project <id> --base-url https://api.openai.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <id> --file endpoint.json
apidog test-case category --project <id>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Ngân sách nằm trong postProcessors của case dưới dạng các khẳng định trên JSONPath, với các so sánh như isAtMost và isAtLeast từ lược đồ test-case-create:
{
  "type": "assertion",
  "defaultEnable": true,
  "enable": true,
  "data": {
    "name": "output tokens under budget",
    "subject": "responseJson",
    "comparison": "isAtMost",
    "value": "1500",
    "path": "$.usage.output_tokens"
  }
}
Đối với Claude, trỏ endpoint đến /v1/messages và khẳng định trên $.usage.output_tokens và $.usage.output_tokens_details.thinking_tokens. Sau đó yêu cầu một kịch bản kiểm thử thực hiện cùng một lệnh gọi hai lần và khẳng định $.usage.input_tokens_details.cached_tokens (OpenAI) hoặc $.usage.cache_read_input_tokens (Claude) của phản hồi thứ hai lớn hơn không: khi ai đó phá vỡ tiền tố được cache, bản build thất bại trước khi hóa đơn đến. Cung cấp các prompt đại diện với -d, truyền API key từ CI secrets với --env-var, và sử dụng -r junit trong pipeline của bạn (hướng dẫn CI/CD). Apidog CLI trong Claude Code đề cập đến thiết lập agent.
Câu hỏi thường gặp
OpenAI và Anthropic có thực sự cắt giảm giá 80% không? Với một mô hình, đúng vậy: GPT-5.6 Luna giảm từ $1/$6 xuống $0.20/$1.20 vào ngày 30 tháng 7 năm 2026. Hầu hết các đợt giảm khác đến từ các mô hình kế nhiệm rẻ hơn.
Các đợt cắt giảm có áp dụng cho đăng ký Claude Code và Codex không? Các trang giá chỉ đề cập đến API. Woolf nói rằng khoản tiết kiệm cũng đến với các harness đăng ký, nhưng cũng báo cáo rằng OpenAI đã giảm một nửa hạn mức sử dụng trên gói $200 của Codex, vì vậy hãy kiểm tra giới hạn của gói bạn.
Giá GPT-5.6 Sol có vĩnh viễn không? Không. Đó là giá khuyến mãi, ít nhất đến hết ngày 21 tháng 11 năm 2026. GPT-6.1 Sol dù sao cũng rẻ hơn.
Cách rẻ nhất để cắt hóa đơn của agent bây giờ là gì? Tăng tỷ lệ cache-hit và giảm nỗ lực suy luận. Đọc cache chiếm ưu thế trong các phiên dài, và suy luận được tính theo giá đầu ra.
Bước tiếp theo
Chạy lại phép tính chi phí cho ba lệnh gọi LLM bận rộn nhất của bạn, sau đó để agent của bạn thêm một bài kiểm tra ngân sách token cho mỗi lệnh. Tải Apidog để bắt đầu.