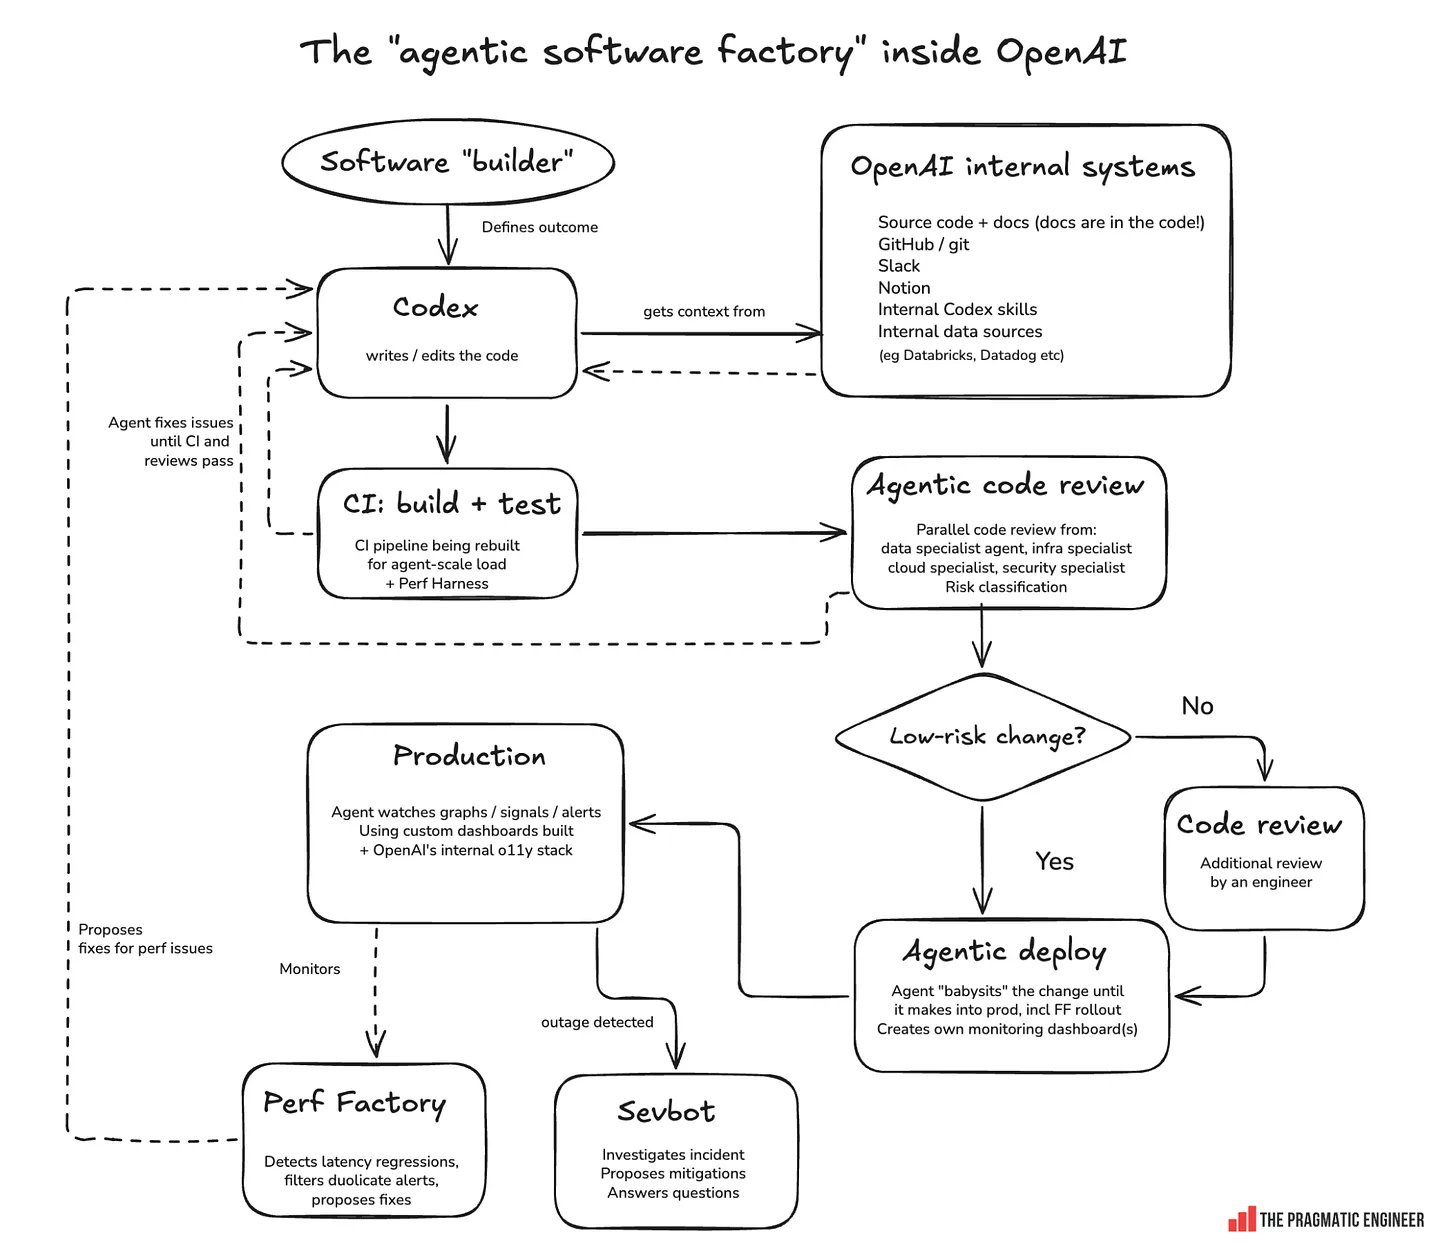
Một sơ đồ về quy trình kỹ thuật nội bộ của OpenAI đã lan truyền một phần trên X tuần này. Nó cho thấy mười ô, từ “người xây dựng phần mềm xác định kết quả” cho đến một tác nhân (agent) giám sát các biểu đồ sản xuất và tự động lập báo cáo sự cố. Nguồn là bản tin The Pragmatic Engineer của Gergely Orosz, trong một bài viết có tên “Nhà máy phần mềm tác nhân của OpenAI”, và chính sơ đồ này đã lan truyền nhanh chóng trên X.
Hầu hết các phản ứng đã bỏ qua một chi tiết quan trọng: một số trong mười ô đó mô tả thiết lập kỹ thuật nội bộ của OpenAI, chứ không phải sản phẩm Codex bạn có thể cài đặt hôm nay. Việc gộp chung hai điều này là sai lầm phổ biến nhất trong các cuộc thảo luận xung quanh sơ đồ này. Bài viết này sẽ đi từng ô một và dừng lại ở giai đoạn mà các nhóm bên ngoài thực sự có thể sao chép: CI.
Mười giai đoạn, theo thứ tự
Sơ đồ được đọc từ trái sang phải như một vòng lặp: một con người đặt ra mục tiêu, một tác nhân viết mã, các cổng tự động kiểm tra nó, và tác nhân tiếp tục lặp lại cho đến khi các cổng đó được thông qua. Dưới đây là toàn bộ trình tự với ranh giới giữa nội bộ và đã phát hành được đánh dấu cho từng giai đoạn.
| # | Giai đoạn | Điều gì xảy ra | Chỉ nội bộ hay đã phát hành trong Codex |
|---|---|---|---|
| 1 | Người xây dựng phần mềm | Một kỹ sư hoặc quản lý sản phẩm (PM) xác định kết quả | Bước của con người, không phải phần mềm |
| 2 | Codex viết/chỉnh sửa mã | Lấy ngữ cảnh từ mã nguồn, tài liệu, GitHub, Slack, Notion, kỹ năng nội bộ và các hệ thống dữ liệu như Databricks và Datadog | Codex đã phát hành viết mã; biểu đồ ngữ cảnh nội bộ (Slack, Notion, dữ liệu nội bộ) chỉ dành cho nội bộ |
| 3 | CI: xây dựng + kiểm thử | Một quy trình đang được xây dựng lại để xử lý tải cấp tác nhân, cộng thêm một “Perf Harness” | Đã phát hành (CI của riêng bạn); công việc mở rộng quy mô cụ thể của OpenAI là nội bộ |
| 4 | Đánh giá mã tác nhân | Đánh giá song song từ các tác nhân chuyên gia về dữ liệu, hạ tầng, đám mây và bảo mật, cộng với phân loại rủi ro | Chỉ nội bộ |
| 5 | Quyết định rủi ro thấp | Các thay đổi rủi ro thấp được tiếp tục; các thay đổi rủi ro cao hơn sẽ được một kỹ sư con người khác xem xét bổ sung | Chỉ nội bộ |
| 6 | Triển khai tác nhân | Một tác nhân “giám sát” sự thay đổi vào môi trường sản xuất, bao gồm triển khai bằng cờ tính năng (feature-flag), và tự xây dựng bảng điều khiển riêng | Chỉ nội bộ |
| 7 | Giám sát sản xuất | Tác nhân giám sát các biểu đồ, tín hiệu và cảnh báo trên ngăn xếp khả năng quan sát nội bộ của OpenAI | Chỉ nội bộ |
| 8 | Phát hiện sự cố -> Sevbot | Điều tra sự cố, đề xuất biện pháp giảm thiểu, trả lời câu hỏi | Chỉ nội bộ |
| 9 | Perf Factory | Lọc cảnh báo trùng lặp, tìm ra các hồi quy độ trễ, đề xuất sửa lỗi | Chỉ nội bộ |
| 10 | Vòng lặp trở lại | Tác nhân khắc phục sự cố cho đến khi CI và các đánh giá được thông qua, sau đó người xây dựng nhận được các bản sửa lỗi được đề xuất | Mô tả vòng lặp nội bộ |
Chính xác một giai đoạn, bước CI, cộng với một phần của giai đoạn 2, là thứ mà một nhóm bên ngoài có thể chỉ vào và nói “chúng tôi cũng có cái đó.” Mọi thứ từ đánh giá tác nhân đến Sevbot đều là sản phẩm nội bộ của OpenAI.
Cột "chỉ nội bộ" đó cũng là một vấn đề về nguồn lực. Các phần mà OpenAI giữ sau tường lửa của mình, bao gồm sự điều phối, cổng đánh giá, sự phê duyệt của con người, chính xác là lớp mà hầu hết các nhóm không có gì để làm. Sharkly là một nơi độc lập với nhà cung cấp để xây dựng nó: một người xây dựng định nghĩa kết quả là một Nhiệm vụ (Task), gán nó cho một Tác nhân (Agent), và Tác nhân chạy trên một Máy tính (Computer) sử dụng bất kỳ Runtime nào bạn đã có, Claude Code hoặc Codex. Sẵn sàng phát hành (Ready for Release) là trạng thái mà một con người phải chuyển trước khi bất cứ điều gì đạt đến Hoàn thành (Done), vì vậy việc phê duyệt vẫn là công việc của con người, không phải của quy trình. Sharkly không thay thế Codex hay tự viết mã; nó chạy Runtime mà bạn đã trả tiền và cung cấp môi trường cho vòng lặp xung quanh.
Giai đoạn 1-2: con người vẫn đặt mục tiêu, Codex vẫn viết mã
Một người xây dựng phần mềm, tức là một kỹ sư hoặc quản lý sản phẩm, xác định kết quả họ muốn. Sau đó, Codex thực hiện một loạt các thay đổi mã cho đến khi đạt được mục tiêu đó và xác minh kết quả hoạt động. Vòng lặp xác minh đó là phần của Codex được phát hành hôm nay: ứng dụng máy tính để bàn (Mac vào tháng 2 năm 2026, Windows vào tháng 3), tích hợp ChatGPT Work từ tháng 7 năm 2026, các plugin và kỹ năng dựa trên vai trò, và lệnh /goal cho các tác vụ chạy trong thời gian dài. Nếu bạn muốn tìm hiểu cơ chế của lệnh đó, chúng tôi đã đề cập đến /goal cho các lần chạy tác nhân tự chủ riêng.
Điều không được phát hành là biểu đồ ngữ cảnh cung cấp thông tin cho Codex nội bộ: gần như mọi hệ thống của OpenAI, từ các chuỗi Slack đến bảng điều khiển Databricks. Bài viết của Orosz nói thẳng: Codex nội bộ của OpenAI “tiên tiến hơn nhiều so với phiên bản bên ngoài của nó vì nó được kết nối với gần như mọi hệ thống của OpenAI.” Khoảng cách giữa Codex nội bộ và bên ngoài đó chính là luận điểm thực sự của bài viết.
Giai đoạn 3: CI là nơi vòng lặp thực sự được thực thi
Đây là giai đoạn đáng để chậm lại, bởi vì nó là một ô duy nhất trong toàn bộ quy trình mà bất kỳ nhóm nào, không chỉ OpenAI, đã sở hữu. Bài viết lưu ý rằng CI tại OpenAI đang được xây dựng lại để tăng tải khoảng 10 lần trong khoảng sáu tháng, bởi vì các tác nhân hiện nay đẩy nhiều thay đổi qua quy trình hơn so với con người. Một “Perf Harness” chạy song song để phát hiện các hồi quy hiệu suất trước khi chúng đến giai đoạn đánh giá.
Đây là phần thường bị bỏ sót: một tác nhân “khắc phục sự cố cho đến khi CI và các đánh giá được thông qua” chỉ đáng tin cậy như những gì CI thực sự kiểm tra. Nếu bộ kiểm thử của bạn bao gồm logic đơn vị nhưng không bao gồm hợp đồng API, một tác nhân có thể lặp lại để tạo ra một bản dựng xanh nhưng vẫn phát hành một thay đổi gây lỗi. Mã trạng thái, hình dạng lược đồ, hành vi xác thực và ngân sách thời gian phản hồi dưới tải là chính xác loại kiểm tra mà hầu hết các nhóm đầu tư không đủ so với kiểm thử đơn vị. Đây là ô mà Apidog phù hợp: chạy các kịch bản kiểm thử của Apidog thông qua Apidog CLI bên trong bước CI của bạn mang lại cho tác nhân một cổng khó hơn để đáp ứng hơn là “mã đã biên dịch.” Chúng tôi đã viết về việc kết nối đó trong Apidog CLI bên trong Codex. Đó là vai trò duy nhất mà Apidog đóng trong quy trình này. Nó không phải là tác nhân, và nó không liên quan đến triển khai, đánh giá hay phản ứng sự cố.
Giai đoạn 4-5: các tác nhân đánh giá chuyên gia và quyết định rủi ro
Sau khi CI được thông qua, thiết lập nội bộ của OpenAI sẽ định tuyến thay đổi qua quá trình đánh giá song song từ các tác nhân chuyên gia về dữ liệu, hạ tầng, đám mây và bảo mật. Orosz mô tả nó là “tương đương với việc có một chuyên gia con người từ mỗi nhóm hạ tầng liên quan xem xét mọi thay đổi,” đây là một tiêu chuẩn đánh giá nặng nề hơn mà hầu hết các nhóm con người không thể đáp ứng cho mọi yêu cầu kéo (pull request). Tính năng đánh giá mã đã phát hành của Codex là một thứ khác, nhẹ hơn so với các tác nhân chuyên gia nội bộ này; nếu bạn đang quyết định xem một trình đánh giá tác nhân đa năng có thể làm gì cho ngăn xếp của riêng bạn, tổng hợp các công cụ đánh giá mã AI của chúng tôi là một điểm khởi đầu công bằng, và bài viết đồng hành của chúng tôi về thiết kế cổng đánh giá tác nhân và rủi ro của OpenAI đi sâu hơn vào ô này (anh chị em, xác nhận trực tiếp trước khi liên kết).
Phân loại rủi ro sau đó quyết định điều gì sẽ xảy ra tiếp theo. Các khu vực mã nguồn có rủi ro thấp có thể cho phép một tác nhân tự động phê duyệt các yêu cầu kéo (PR) của chính nó, loại bỏ hoàn toàn sự phê duyệt của con người ra khỏi vòng lặp đối với loại thay đổi đó. Các thay đổi rủi ro cao hơn sẽ nhận được nhiều lượt đánh giá AI hơn, một đánh giá bắt buộc của con người, hoặc cả hai. OpenAI chưa công bố quy tắc chính xác về những gì được coi là rủi ro thấp, và chúng tôi sẽ không đoán ở đây. Một ý tưởng có thể tổng quát hóa vượt ra ngoài thiết lập cụ thể của OpenAI: một thay đổi gây lỗi đối với hợp đồng API công khai không bao giờ nên được phân loại là rủi ro thấp, bất kể sự khác biệt (diff) trông nhỏ đến mức nào. Công cụ theo định hướng đặc tả (spec-first tooling) giữ định nghĩa OpenAPI và các bài kiểm thử của bạn ở cùng một nơi giúp việc thực thi sự phân biệt đó dễ dàng hơn một cách tự động, vì sự khác biệt lược đồ (schema diff) là một tín hiệu rủi ro rõ ràng hơn nhiều so với sự khác biệt số dòng (line-count diff).
Giai đoạn 6-8: triển khai, giám sát và phản ứng, mà không cần con người được báo động trước
Nếu một thay đổi được thông qua đánh giá, một tác nhân nội bộ sẽ “giám sát” nó vào môi trường sản xuất, bao gồm triển khai bằng cờ tính năng, và tự xây dựng các bảng điều khiển giám sát riêng cho thay đổi cụ thể đó. Sau khi hoạt động, cùng một tác nhân (hoặc một tác nhân liên quan) sẽ giám sát các biểu đồ và cảnh báo trên ngăn xếp khả năng quan sát nội bộ của OpenAI. Khi có sự cố, Sevbot tiếp quản: nó điều tra sự cố, đề xuất các biện pháp giảm thiểu và trả lời các câu hỏi của nhà phát triển trong Slack. Điều đáng nói rõ là Sevbot không làm gì. Nó đề xuất; nó không thực thi. Con người vẫn ủy quyền biện pháp giảm thiểu và vẫn trực ban (oncall). Như bài viết đã nêu rõ, “nhiệm vụ trực ban không phải là chuyện của quá khứ.” Không có giai đoạn nào từ 6 đến 8 tồn tại trong sản phẩm Codex mà bạn có thể mua.
Giai đoạn 9-10: hồi quy hiệu suất và vòng lặp trở lại
Perf Factory nằm cùng với lộ trình xử lý sự cố. Nó sàng lọc các cảnh báo và bảng điều khiển, lọc bỏ các tín hiệu trùng lặp, tìm ra các hồi quy độ trễ thực sự và đề xuất các bản sửa lỗi, sau đó chuyển về cho người xây dựng ban đầu. Cùng với Sevbot, đây là câu trả lời của OpenAI cho tình trạng mệt mỏi vì cảnh báo: thay vì một kỹ sư trực ban phải phân loại mọi thông báo, một tác nhân sẽ lọc trước và chẩn đoán trước. Vòng lặp kết thúc với giai đoạn 10: tác nhân tiếp tục sửa đổi cho đến khi CI và mọi lớp đánh giá được thông qua.
Tại sao ranh giới nội bộ/bên ngoài lại quan trọng đối với nhóm của bạn
Nếu bạn đang đánh giá liệu kỹ thuật tác nhân “kiểu OpenAI” có phải là thứ mà nhóm của bạn có thể áp dụng trong quý này hay không, câu trả lời thành thật là: bạn có thể áp dụng các giai đoạn 1 đến 3 ngay hôm nay, còn các giai đoạn 4 đến 9 mô tả một định hướng, chứ không phải một tính năng có thể mua được. Đó không phải là một lời chỉ trích OpenAI; công cụ nội bộ ở quy mô đó phải mất nhiều năm để phát triển. Một dự án mã nguồn mở, orchflows, là một nỗ lực công khai để mô phỏng vòng lặp này với lệnh /software-factory cho Claude Code và Codex; README của nó thẳng thắn về mục tiêu, lập luận rằng bạn chỉ cần hai kỹ năng thay vì một thư viện các kỹ năng đó. Đây là một dự án sơ khai, không liên kết, không phải là một sản phẩm của OpenAI, vì vậy hãy coi nó như một triển khai tham chiếu chứ không phải một nhà máy có thể sử dụng ngay.
Việc áp dụng bên trong OpenAI đã diễn ra nhanh chóng ở những phần không cần hệ thống ống nước nội bộ tùy chỉnh: việc sử dụng Codex trong các nhóm không phải kỹ thuật đã tăng từ khoảng 0% lên 90% trong bốn tháng, từ tháng 2 đến tháng 5 năm 2026. Đó là một tín hiệu rõ ràng hơn so với sơ đồ quy trình đơn thuần, bởi vì nó cho thấy phần dễ (một tác nhân viết mã hướng tới một mục tiêu đã nêu) đã trở nên bình thường tại OpenAI, trong khi phần khó (triển khai tác nhân, đánh giá và phản ứng sự cố được kết nối vào mọi hệ thống nội bộ) vẫn còn tùy chỉnh riêng.
Điều gì vẫn thuộc về con người
Bài viết cẩn trọng về những điều không thay đổi. Những người xây dựng vẫn xác định kết quả. Con người vẫn phê duyệt các thay đổi rủi ro cao và ủy quyền các biện pháp giảm thiểu sự cố. Ai đó vẫn xem xét những gì Sevbot đã làm sau đó, và các ca trực ban vẫn tồn tại. Câu kết của bài viết nắm bắt sự thay đổi tốt hơn bất kỳ số liệu thống kê nào: “Khả năng phán đoán, ưu tiên và gu thẩm mỹ đang trở nên quan trọng hơn.” Hai lưu ý cũng giữ cho điều này có cơ sở: đánh giá cửa hàng ứng dụng di động vẫn là một nút thắt cổ chai thủ công mà không tác nhân nào có thể vượt qua, và mở rộng hạ tầng là một cuộc chiến hàng tháng, chứ không phải một vấn đề đã được giải quyết.
Nếu bạn đang xây dựng phiên bản riêng của mình cho các giai đoạn 1 đến 3 thay vì chờ đợi một nhà cung cấp phát hành các giai đoạn 4 đến 9, hãy bắt đầu với cổng đã tồn tại trong quy trình của bạn: CI. Bài viết đồng hành của chúng tôi về xây dựng một nhà máy phần mềm nhẹ hơn xung quanh Codex sẽ hướng dẫn cách xây dựng đó (anh chị em, xác nhận trực tiếp trước khi liên kết), và thiết kế Sevbot/Perf Factory được xử lý riêng trong bài viết của chúng tôi về Perf Factory và Sevbot của OpenAI (anh chị em, xác nhận trực tiếp trước khi liên kết). Một tác nhân lặp lại cho đến khi các bài kiểm thử vượt qua chỉ là một ý tưởng hay nếu các bài kiểm thử mà nó đang lặp lại thực sự khẳng định điều gì đó. Apidog giữ các bài kiểm thử hợp đồng API bên cạnh đặc tả để cổng đó luôn trung thực khi các tác nhân, chứ không chỉ con người, bắt đầu đẩy các thay đổi qua đó.