
Trọng số mở Mistral Large 4 đã được đăng lên Hugging Face vào ngày 29 tháng 10 năm 2026. Bạn nhận được cùng mô hình 1,05T tham số mà Mistral phục vụ trên API của họ, theo giấy phép MIT đã sửa đổi, ở dạng checkpoint FP8 và NVFP4 cùng với các bản lượng tử hóa GGUF từ cộng đồng. Bạn có thể tải xuống mà không cần bước phê duyệt, phục vụ nó trên 8 GPU trung tâm dữ liệu với vLLM hoặc SGLang, hoặc bỏ qua phần cứng và gọi mistral-large-4 trên API Mistral với giá 0,70 đô la cho mỗi triệu token đầu vào.
Dưới đây: những gì đã thay đổi kể từ bản xem trước ngày 6 tháng 10, kích thước tải xuống, phần cứng cho từng lộ trình và giấy phép. Để xem tổng quan về mô hình, hãy đọc bài phân tích ra mắt Mistral Large 4 của chúng tôi; để biết định dạng yêu cầu và mã SDK, xem hướng dẫn API Mistral Large 4.
Trọng số mở Mistral Large 4 là gì?
Trọng số mở Mistral Large 4 là các checkpoint có thể tải xuống của mô hình chủ lực của Mistral, có biệt danh là "Le Chonk." Đây là một mô hình hỗn hợp chuyên gia (mixture-of-experts) đa phương thức với khoảng 1,05T tổng tham số, khoảng 49B tham số hoạt động cho mỗi token (52B nếu tính cả lớp embedding và lớp đầu ra), một bộ mã hóa thị giác 1,6B và cửa sổ ngữ cảnh 1M token, được phát hành theo Giấy phép Trọng số Mở Hệ sinh thái Mistral.
Thẻ mô hình chính thức liệt kê 72 lớp văn bản và 128 chuyên gia được định tuyến, với 4 chuyên gia được chọn cho mỗi token cộng thêm 1 chuyên gia chia sẻ.
Bản phát hành này không phải là bản sao đóng băng của bản xem trước. Thông báo trọng số mở của Mistral cho biết mô hình đã trải qua thêm ba tuần học tăng cường tập trung vào lập trình và an ninh mạng trước khi trọng số được phát hành.
Những gì đã thay đổi kể từ bản xem trước ngày 6 tháng 10
Nếu bạn đã thử nghiệm Large 4 trong bản xem trước, hiện có bốn điểm khác biệt.
| Lĩnh vực | Bản xem trước ngày 6 tháng 10 | Bản phát hành mở ngày 29 tháng 10 |
|---|---|---|
| Trọng số | Chỉ có API, trọng số được hứa sẽ phát hành sau | FP8 và NVFP4 trên Hugging Face, không giới hạn |
| Chế độ lý luận | high hoặc none |
low, medium, high (mặc định high); low thay thế none |
| Terminal-Bench 4.0 (do Mistral báo cáo) | 28% | 41%, với ít hơn khoảng 30% token đầu ra |
| Khả năng chống tấn công của B3 Agent Security (do Mistral báo cáo) | 93,3% | 97,1% |
| Giá API mỗi 1M token | Hiển thị với mức giảm giá xem trước | 0,70 đô la đầu vào, 0,07 đô la đầu vào được lưu cache, 2,10 đô la đầu ra |
Thay đổi về lý luận làm hỏng mã. Nếu tích hợp bản xem trước của bạn gửi reasoning_effort: "none", hãy chuyển nó sang "low": bài đăng ra mắt trên Hugging Face lưu ý rằng Transformers chạy none ở mức high, vì vậy một cài đặt cũ sẽ tốn token thay vì báo lỗi.
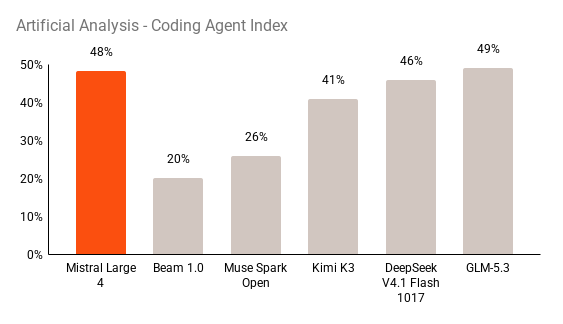
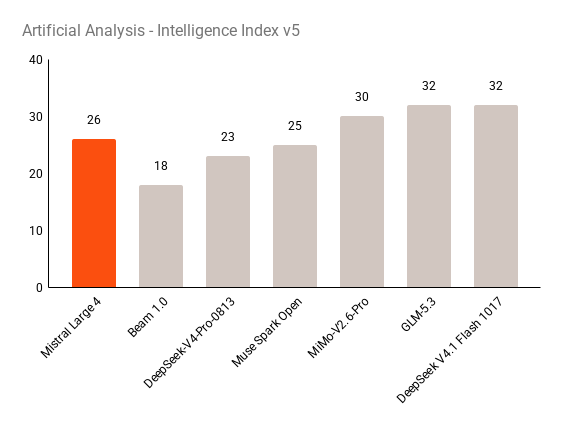
Tất cả các số liệu benchmark trong bài viết này đều do nhà cung cấp báo cáo. Mistral cũng tuyên bố đạt 19,7% trên benchmark FrontierCode 2.0 riêng tư của Cognition, điểm trọng số mở cao nhất trong biểu đồ của họ, và 48% trên Chỉ số Tác nhân Lập trình của Artificial Analysis, gần như ngang bằng với GLM-5.3. Việc kiểm chứng độc lập vẫn đang chờ xử lý khi chúng tôi kiểm tra vào ngày 2 tháng 11.
Ba cách để chạy Mistral Large 4
Bạn có ba lộ trình, và lộ trình đúng phụ thuộc vào việc bạn kiểm soát bao nhiêu phần cứng.
- Gọi API Mistral. ID mô hình
mistral-large-4, 0,70 đô la đầu vào, 0,07 đô la đầu vào được lưu cache và 2,10 đô la đầu ra cho mỗi triệu token. Không cần GPU. - Sử dụng nhà cung cấp lưu trữ. Mistral liệt kê OpenRouter, các endpoint do NVIDIA lưu trữ và một container NIM, cùng Microsoft Foundry, cũng cung cấp các triển khai riêng tư trên Azure.
- Tự lưu trữ trọng số. Tải xuống từ Hugging Face và phục vụ với vLLM, SGLang, Transformers hoặc llama.cpp trên máy của riêng bạn.
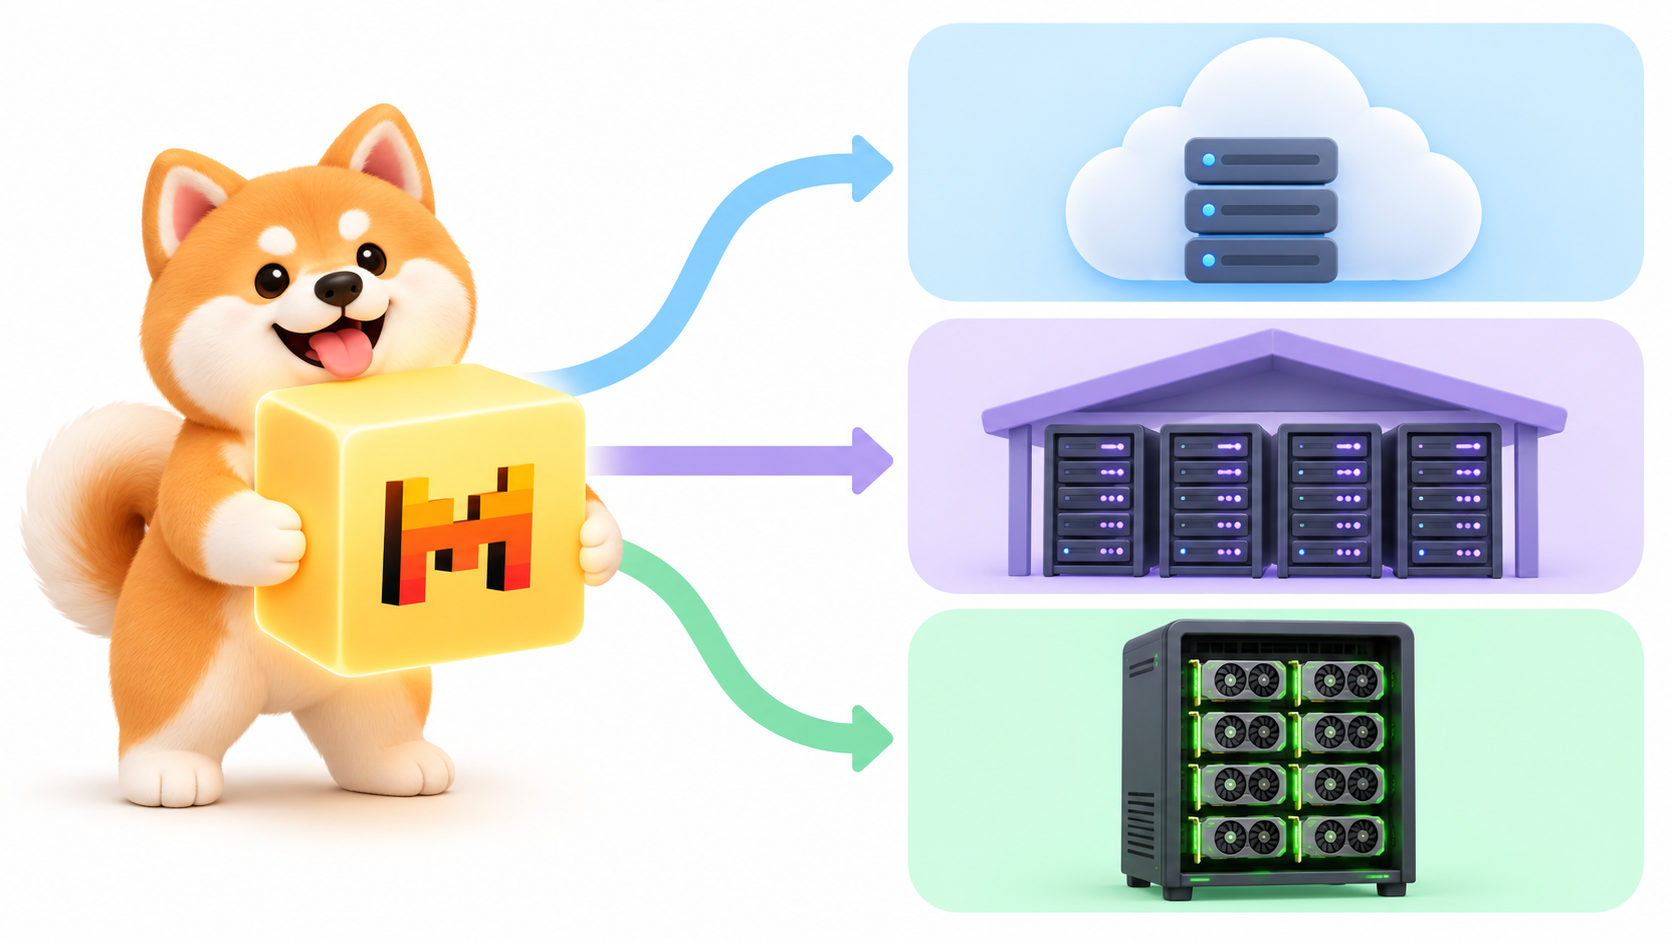
Hãy bắt đầu với lộ trình 1 hoặc 2. Chuyển sang lộ trình 3 vì một lý do cụ thể: dữ liệu không thể rời khỏi mạng của bạn, một bản tinh chỉnh mà bạn cần sở hữu, hoặc khối lượng công việc giữ cho một node 8 GPU luôn bận rộn.
Cách tải xuống Mistral Large 4
Các kho chính thức không bị giới hạn (API Hugging Face báo cáo gated: false cho cả hai), vì vậy bất kỳ tài khoản hoặc ứng dụng khách ẩn danh nào cũng có thể tải chúng. Kích thước mới là rào cản thực sự.
| Kho | Định dạng | Kích thước trên đĩa |
|---|---|---|
mistralai/Mistral-Large-4-1T-A52B |
FP8, chính thức | khoảng 1.061 GB |
mistralai/Mistral-Large-4-1T-A52B-NVFP4 |
NVFP4, chính thức | khoảng 610 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q8_0 | khoảng 1.115 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q4_K_M | khoảng 635 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
Q2_K | khoảng 381 GB |
ggml-org/Mistral-Large-4-1T-A52B-GGUF |
IQ2_XXS | khoảng 298 GB |
Chúng tôi đã tổng hợp những con số này từ danh sách tệp của mỗi kho vào ngày 2 tháng 11 năm 2026. Unsloth cũng phát hành các bản lượng tử hóa GGUF dưới tên unsloth/Mistral-Large-4-1T-A52B-GGUF.
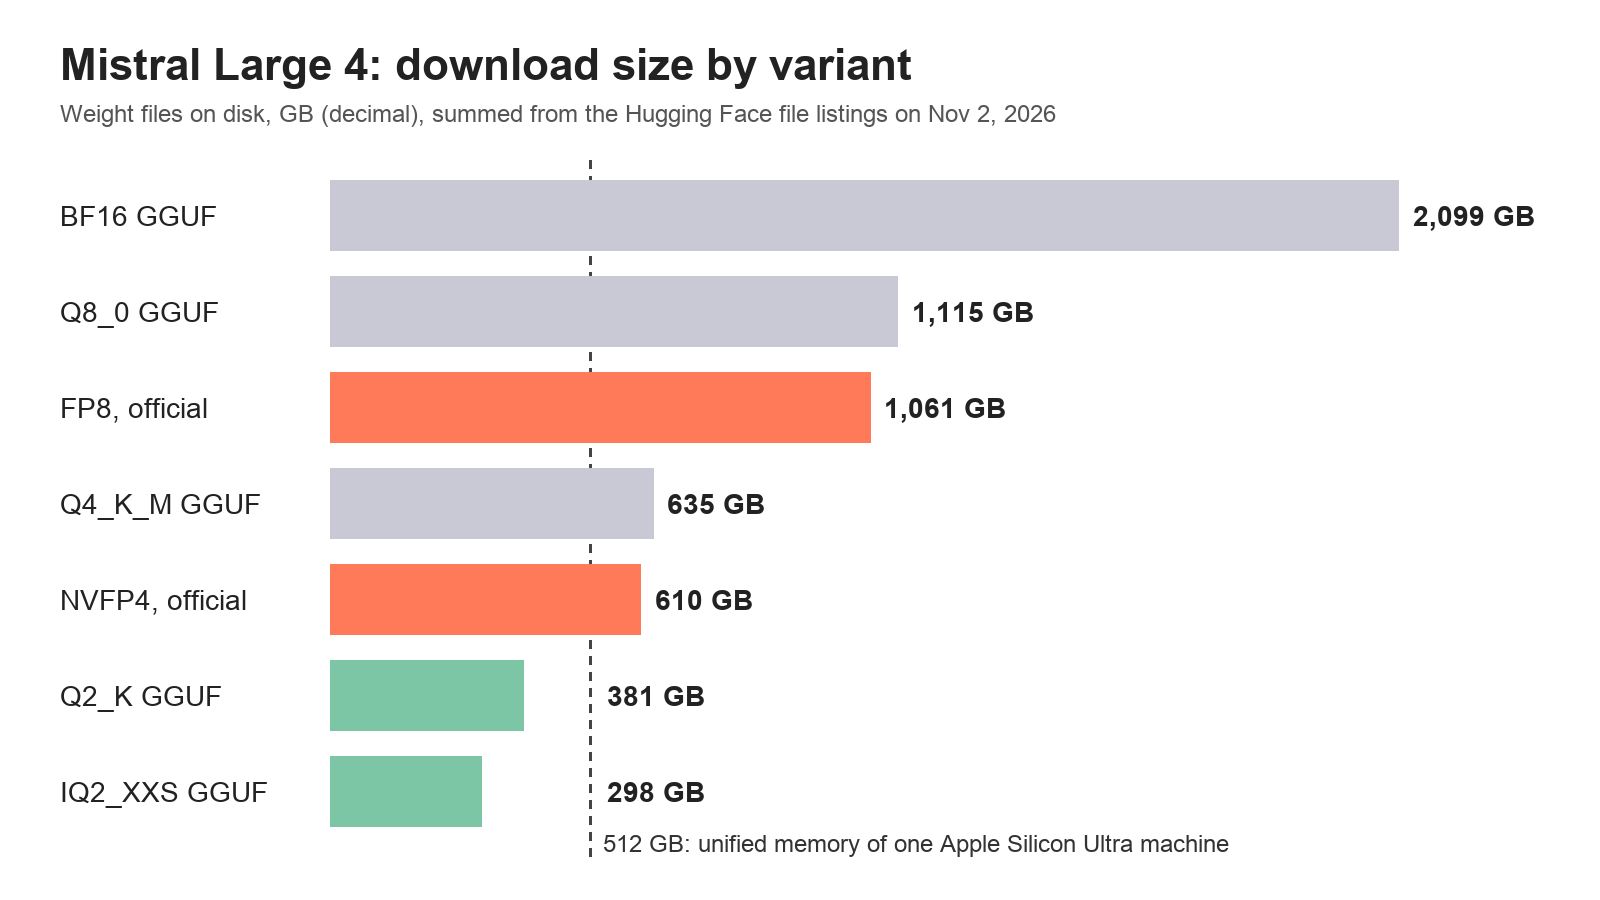
Chỉ tải xuống những tệp bạn cần bằng Hugging Face CLI:
pip install -U huggingface_hub
hf download mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --local-dir ./mistral-large-4-nvfp4
Quá trình tải xuống FP8 mất hơn hai giờ một chút ở tốc độ 1 Gbps duy trì.
Cách tự lưu trữ Mistral Large 4
Mọi ví dụ phục vụ chính thức đều giả định một node với 8 GPU và song song tensor bằng 8. Đây là những gì mỗi engine yêu cầu.
| Engine | Checkpoint | Phần cứng trong các ví dụ chính thức |
|---|---|---|
| vLLM | FP8 | 8 GPU, --tensor-parallel-size 8; Hugging Face Inference Endpoints dùng 8x H200 |
| vLLM | NVFP4 | 8 GPU NVIDIA Blackwell |
| SGLang | FP8 | 8 GPU, --tp-size 8 |
| Transformers | FP8 | 8 GPU thông qua torchrun |
| llama.cpp | Q2_K GGUF | Một máy Apple Silicon Ultra với 512 GB bộ nhớ hợp nhất |
vLLM
Thẻ mô hình khuyến nghị vLLM và cung cấp một Docker image chuyên dụng:
docker run --runtime nvidia --gpus all \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -p 8000:8000 \
  --ipc=host \
  vllm/vllm-openai:mistral-large-4 \
  --model mistralai/Mistral-Large-4-1T-A52B \
  --tensor-parallel-size 8 \
  --tool-call-parser mistral \
  --reasoning-parser mistral \
  --enable-auto-tool-choice \
  --gpu-memory-utilization 0.85
Hãy giữ cả hai cờ parser, nếu không văn bản suy nghĩ sẽ lọt vào content và các lệnh gọi công cụ sẽ đến dưới dạng văn bản thô. Để giải mã nhanh hơn, thẻ mô hình ghi lại một bộ giải mã suy đoán DSpark tùy chọn: thêm --speculative-config '{"method": "dspark", "num_speculative_tokens": 3}'.
Trên 8x H200 với bộ dự thảo đó, Hugging Face đo được khoảng 65 token mỗi giây cho một yêu cầu và tổng cộng khoảng 480 token mỗi giây trên 1.000 cuộc hội thoại ShareGPT dưới tải.
SGLang cũng hoạt động: ví dụ sglang serve trong thẻ mô hình sử dụng --tp-size 8, --speculative-algorithm DSPARK và các parser lý luận và gọi công cụ ở chế độ auto.
llama.cpp trên máy Mac
Nhóm llama.cpp đã phát hành hỗ trợ ngay từ ngày đầu. Bản lượng tử hóa Q2_K (381 GB) vừa trên một máy Apple Silicon Ultra với 512 GB bộ nhớ hợp nhất:
curl -LsSf https://llama.app/install.sh | sh
llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K
Hugging Face báo cáo khoảng 90 token mỗi giây cho prefill và 15 token cho sinh văn bản trên một máy M3 Ultra: tốt cho các thử nghiệm riêng tư, chậm đối với một vòng lặp tác nhân. Bản lượng tử hóa 2-bit cũng làm mất chất lượng, vì vậy hãy thử nghiệm nó trên các tác vụ của riêng bạn trước.
Cấu hình lấy mẫu được Mistral khuyến nghị là temperature=1.0 và top_p=0.95 ở mọi mức lý luận.
Gọi mô hình tự lưu trữ của bạn
Cả vLLM và SGLang đều cung cấp một máy chủ tương thích OpenAI, vì vậy yêu cầu trông giống như bất kỳ hoàn thành trò chuyện nào:
curl http://localhost:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "mistralai/Mistral-Large-4-1T-A52B",
    "messages": [{"role": "user", "content": "Summarize RFC 9110 section 9 in 5 bullets."}],
    "reasoning_effort": "medium",
    "temperature": 1.0,
    "top_p": 0.95
  }'
Trên API được lưu trữ, hãy gửi cùng nội dung đó đến https://api.mistral.ai/v1/chat/completions với "model": "mistral-large-4" và khóa Bearer. Tài liệu máy chủ tương thích OpenAI của vLLM liệt kê các trường mà nó chấp nhận.
Để Claude Code kiểm tra cả hai endpoint với Apidog CLI
Một mô hình tự lưu trữ thất bại một cách âm thầm: một cờ parser bị thiếu làm rò rỉ lý luận vào content, hoặc một lệnh gọi công cụ trả về dưới dạng văn bản thuần. Hãy để tác nhân lập trình của bạn kiểm tra cả hai lộ trình với Apidog CLI thay vì dán các lệnh curl bằng tay.
Thiết lập một lần:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick Claude Code when prompted
Sau đó đưa cho Claude Code một lời nhắc:
In Apidog project <id>, create two environments: "ml4-self-hosted" with base URL
http://localhost:8000 and "ml4-mistral-api" with base URL https://api.mistral.ai.
Add a POST /v1/chat/completions endpoint and a test case that sends a tool-calling
request with reasoning_effort "low", then asserts status 200, that choices[0].message
has a tool_calls array, and that message.content holds no thinking text.
Run it against both environments and tell me where they differ.
Tác nhân đọc từng schema, xác thực payload của nó và chạy test case:
apidog environment create ml4-self-hosted --project <id> --base-url http://localhost:8000
apidog environment create ml4-mistral-api --project <id> --base-url https://api.mistral.ai
apidog cli-schema get endpoint-create
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <selfHostedEnvId> -r cli,json
apidog run --test-case <caseId> --project <id> -e <apiEnvId> -r cli,json
Thêm --upload-report để xem lần chạy trong ứng dụng Apidog, hoặc đặt cùng dòng apidog run ... -r junit vào CI để một bản nâng cấp vLLM không thể phát hành với các lệnh gọi công cụ bị hỏng. Hướng dẫn Apidog CLI trong Claude Code của chúng tôi đề cập chi tiết hơn về việc thiết lập. Gói Miễn phí của Apidog hỗ trợ tối đa 4 người dùng.
Giấy phép: những gì bạn có thể và không thể làm
Giấy phép Trọng số Mở Hệ sinh thái Mistral là giấy phép MIT với một điều kiện bổ sung.
Bạn có thể: chạy, triển khai, tinh chỉnh và sửa đổi mô hình cùng các dẫn xuất của nó, cho mục đích thương mại và phi thương mại, miễn là bạn giữ thông báo bản quyền và quyền hạn trong các bản sao.
Bạn cần một giấy phép thương mại riêng từ Mistral nếu: bạn chạy nó như một "Model as a Service" (Mô hình dưới dạng Dịch vụ), được giấy phép định nghĩa là cho phép bên thứ ba truy cập vào mô hình hoặc các dẫn xuất của nó để suy luận hoặc huấn luyện sau.
Điều kiện đó không áp dụng cho: sử dụng nội bộ, các sản phẩm dành cho người dùng cuối nơi mô hình nằm trong các tính năng hoặc khung cụ thể, chỉ chuyển tiếp yêu cầu đến một mô hình do người khác lưu trữ, và sử dụng thông qua các sản phẩm của chính Mistral.
Một trợ lý lập trình nội bộ hoặc một tính năng sản phẩm được xây dựng trên mô hình là ổn; bán lại suy luận thô cần một thỏa thuận. Đây là bản tóm tắt, không phải tư vấn pháp lý.
Để xem một hướng dẫn tương tự về một mô hình trọng số mở khác, hãy xem hướng dẫn tự lưu trữ GLM-5.3 của chúng tôi.
Bạn nên tự lưu trữ hay gọi API?
Hãy gọi API khi khối lượng công việc của bạn khiêm tốn, bạn muốn ngữ cảnh 1M mà không cần tinh chỉnh giới hạn máy chủ, hoặc bạn chưa vận hành các node 8 GPU. Với giá 0,70 đô la đầu vào và 2,10 đô la đầu ra cho mỗi triệu token, 100 triệu token đầu vào cộng với 20 triệu token đầu ra mỗi tháng tốn 112 đô la, trước bất kỳ khoản giảm giá lưu cache nào.
Hãy tự lưu trữ khi dữ liệu của bạn không thể rời khỏi mạng, khi bạn muốn sở hữu một bản tinh chỉnh (Hugging Face hiển thị huấn luyện LoRA với TRL trên một node 8x B300), hoặc khi khối lượng công việc ổn định giữ cho một node luôn bận rộn. Dịch vụ Forge của Mistral là tùy chọn được quản lý để tinh chỉnh trên dữ liệu của riêng bạn.
Câu hỏi thường gặp
Trọng số mở Mistral Large 4 có miễn phí tải xuống không?
Có. Cả hai kho chính thức trên Hugging Face đều không bị giới hạn, vì vậy bạn có thể tải chúng xuống mà không cần yêu cầu quyền truy cập. Chạy chúng mới là chi phí: checkpoint FP8 chính thức khoảng 1.061 GB và các ví dụ phục vụ sử dụng 8 GPU trung tâm dữ liệu.
Tôi có thể chạy Mistral Large 4 trên một GPU duy nhất không?
Không có công thức chính thức nào chỉ dùng một GPU. Mọi ví dụ vLLM, SGLang và Transformers đều sử dụng 8 GPU với song song tensor. Thiết lập nhỏ nhất được ghi lại là llama.cpp với bản lượng tử hóa Q2_K 381 GB trên một máy Apple Silicon Ultra với 512 GB bộ nhớ hợp nhất.
Mistral Large 4 có phải là mã nguồn mở không?
Đây là trọng số mở, không phải mã nguồn mở theo nghĩa OSI. Bạn nhận được trọng số theo giấy phép MIT đã sửa đổi cho phép sử dụng thương mại, nhưng việc cung cấp mô hình cho bên thứ ba như một dịch vụ suy luận hoặc huấn luyện sau cần giấy phép thương mại riêng từ Mistral.
Mô hình trọng số mở có giống với mô hình API không?
Mistral cho biết checkpoint được phát hành đã trải qua thêm ba tuần học tăng cường sau bản xem trước ngày 6 tháng 10, và API phục vụ mô hình đã cập nhật dưới tên mistral-large-4. Các chế độ lý luận cũng thay đổi: hãy sử dụng low, medium hoặc high.
API Mistral Large 4 có giá bao nhiêu?
Mistral niêm yết 0,70 đô la cho mỗi triệu token đầu vào, 0,07 đô la cho mỗi triệu token đầu vào được lưu cache và 2,10 đô la cho mỗi triệu token đầu ra, tính đến ngày 2 tháng 11 năm 2026.