
Khi một voice agent gặp lỗi trên các cuộc gọi thực tế, nguyên nhân thường không nằm ở LLM hay giọng nói. Vấn đề bắt đầu từ một bước trước đó — ở phần âm thanh mà agent nghe được, dù nó được đưa vào speech-to-text (STT) hay trực tiếp vào một mô hình speech-to-speech. Các mô hình STT hiện đại xử lý tiếng xe cộ hay máy điều hòa rất tốt. Điều chúng không xử lý nổi là một người thứ hai đang nói chuyện: một đồng nghiệp, tiếng TV, hay agent ở bàn cạnh trong call center. Mô hình vẫn nghe cả những tiếng đó, và agent sẽ phản ứng theo những từ mà người gọi chưa bao giờ nói.
Krisp Voice Isolation được đặt phía trước STT và loại bỏ mọi giọng nói trừ giọng của người nói chính. Để đánh giá sản phẩm này, tôi đã đọc benchmark và tài liệu của Krisp, đăng ký API self-serve, rồi chạy tám bản ghi âm thực tế từ bộ dữ liệu công khai của Krisp thông qua nó. Sau đó, tôi chuyển đổi âm thanh trước và sau khi xử lý thành văn bản bằng một mô hình STT mã nguồn mở để xem điều gì thực sự thay đổi.
Kết luận ngắn gọn: nếu agent của bạn nhận cuộc gọi từ văn phòng, nhà riêng, call center hoặc bất kỳ nơi nào có người nói chuyện xung quanh, thì Voice Isolation rất đáng để đưa vào pipeline. Trong bài kiểm tra của tôi, phần tiếng nói nền từng biến thành 331 từ giả trong bản transcript đã giảm về con số 0. Những đánh đổi là có thật nhưng nhỏ: chi phí tăng nhẹ với âm thanh điện thoại sạch, API chỉ có khu vực Mỹ, và số lượng mô hình trên API ít hơn so với SDK.
Vấn đề: tiếng nói nền, không phải tiếng ồn nền
Các mô hình STT được huấn luyện để nhận diện lời nói, chứ không phải để quyết định lời nói của ai là quan trọng. Tiếng ồn có thể được lọc bỏ vì nó không giống lời nói. Nhưng giọng nói thứ hai thì trông giống hệt lời nói, đơn giản vì nó chính là lời nói.
Ví dụ của chính Krisp là một minh họa tốt. Một người gọi yêu cầu hủy đăng ký trong khi một đồng nghiệp ở gần hỏi về bữa trưa. STT trả về một chuỗi từ duy nhất mà không có bất kỳ dấu hiệu nào cho biết từ nào đến từ người gọi, nên nhân viên tư nhân nhận cả hai như một yêu cầu duy nhất.
Điều này làm hỏng voice agent theo ba cách:
- Sai bản ghi chép. Lời của người đứng gần bị lẫn vào bản ghi, và LLM trả lời những điều mà người gọi chưa bao giờ nói.
- Gián đoạn giả. Agent nghe thấy người đứng gần, tưởng rằng người gọi đang ngắt lời, và dừng nói giữa câu.
- Phá vỡ cơ chế luân phiên lượt nói. Lời nói nền khiến agent tưởng rằng người gọi vẫn đang nói, nên agent không thể xác định khi nào lượt nói đã kết thúc.
Trong mọi trường hợp, logic của agent vẫn hoạt động đúng như thiết kế. Nó đang phản ứng với một giọng nói mà lẽ ra nó không bao giờ được nghe thấy.
Các con số cho thấy khoảng cách này lớn đến mức nào. Trong bài kiểm tra ra mắt Voice Isolation 2.5 của Krisp, 10 hệ thống STT có tỷ lệ lỗi từ (WER) trung bình 2,10% trên âm thanh một người nói sạch. Khi có người thứ hai nói chồng lên lời của người gọi, cùng các hệ thống đó có tỷ lệ lỗi trung bình 35,92%. Khử tiếng ồn không thể thu hẹp khoảng cách này, vì nguồn nhiễu chính là lời nói.
Krisp Voice Isolation là gì
Krisp Voice Isolation API & SDK loại bỏ tiếng nói nền và tạp âm khỏi luồng âm thanh trực tiếp, chỉ giữ lại giọng của người nói chính. Công nghệ này được xây dựng cho các voice AI agent, và là cùng một công nghệ lõi mà Krisp cung cấp cho các cuộc gọi của con người dưới tên Background Voice Cancellation (BVC).
Nó được đặt ở đầu pipeline của agent, để mọi mô hình phía sau chỉ nghe thấy một giọng nói duy nhất:
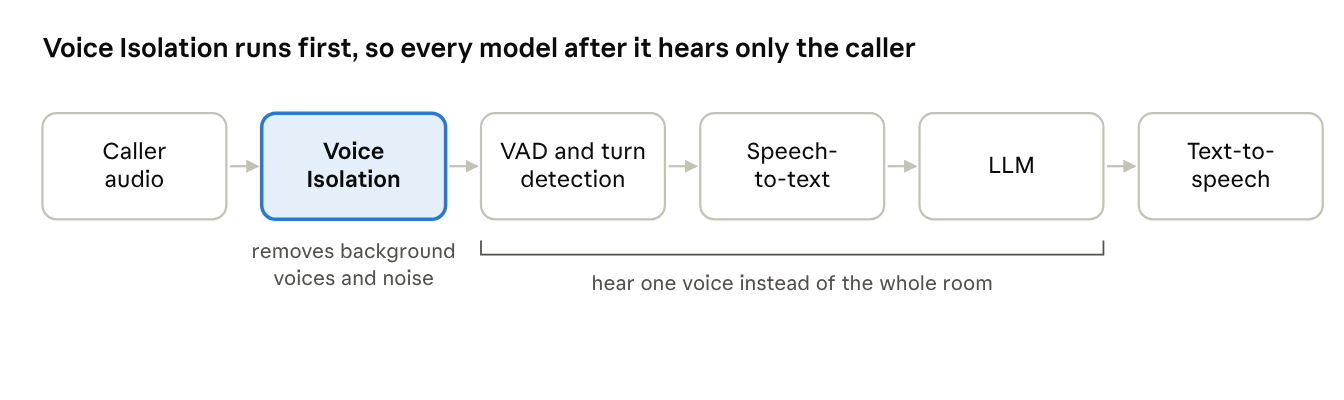
Vị trí của Voice Isolation trong pipeline của voice agent
Vị trí đặt này rất quan trọng. Nếu không có nó, VAD và turn detection cũng sẽ nghe thấy cả người đứng gần đó — và đó chính là nguồn gốc của các lần ngắt lời giả.
Krisp đã dành khoảng chín năm cho lĩnh vực voice AI và cho biết họ xử lý hơn 1 nghìn tỷ phút giọng nói mỗi năm. Voice Isolation là một trong những sản phẩm trong dòng voice AI API và SDK của hãng. Voice Isolation là một phần của VIVA — bộ mô hình thời gian thực cho voice agent của Krisp, cùng với Turn-Taking, Interrupt Prediction và VAD. Nó hoạt động cùng với turn-taking chứ không thay thế nó.
Bốn mô hình này cho phép bạn kiểm soát mức độ loại bỏ mạnh mẽ các giọng nói nền và tiếng ồn. Với mức độ mạnh nhất (cấu hình mặc định), Default loại bỏ nhiều nhất. Balanced xử lý giọng nói chính nhẹ nhàng hơn, với cùng mức tài nguyên tính toán. Lite chỉ sử dụng khoảng một phần ba tài nguyên tính toán so với Default. HD dành cho các luồng WebRTC 32 kHz thay vì âm thanh điện thoại. Mức độ loại bỏ là thiết lập thời gian chạy mà bạn có thể tinh chỉnh mà không cần thay đổi tài nguyên tính toán; trong API, đó chính là tham số suppression_level, với giá trị từ 0 đến 100.
Một giới hạn đáng lưu ý ngay từ đầu: các mô hình loại bỏ giọng nói được thiết kế với giả định người nói ở gần micrô. Theo hướng dẫn sơ bộ, khi vượt quá khoảng 30 cm, giọng nói của chính người nói chính có thể bị loại bỏ. Đây không phải là quy tắc tuyệt đối mà chỉ là khuyến nghị chung, và khoảng cách thực tế còn phụ thuộc vào điều kiện âm học. Đối với các thiết bị xa trường như loa thông minh, Krisp cung cấp một mô hình riêng chỉ loại bỏ tiếng ồn.
Phiên bản 2.5 được phát hành vào tháng 8 năm 2026, và Krisp đã công bố một benchmark và bộ dữ liệu mở vào tháng 9. Mô hình này hiện đã có sẵn dưới dạng API tự phục vụ cũng như SDK.
Benchmark của Krisp cho thấy điều gì
Trên benchmark mở của Krisp, Voice Isolation đã giảm tỷ lệ lỗi từ (word error rate) trung bình từ 23,24% xuống còn 6,24% — mức giảm 73%.
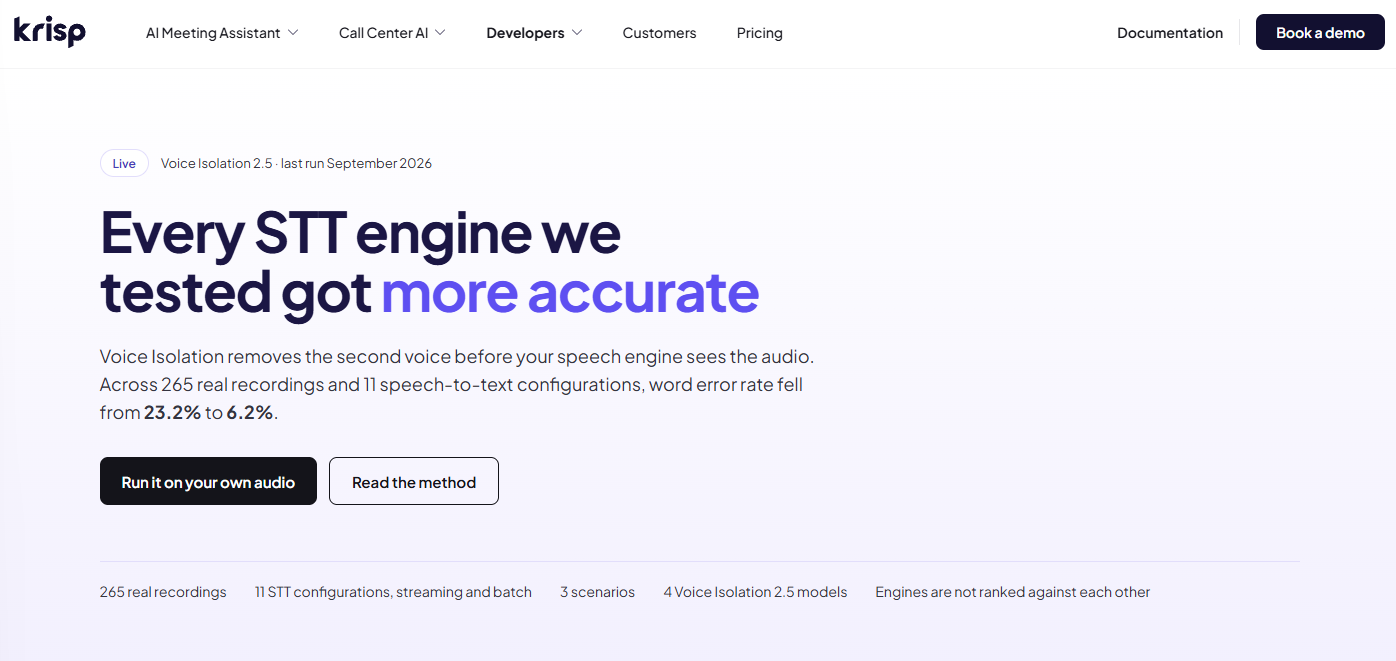
Trang benchmark của Krisp tóm tắt kết quả nổi bật này.
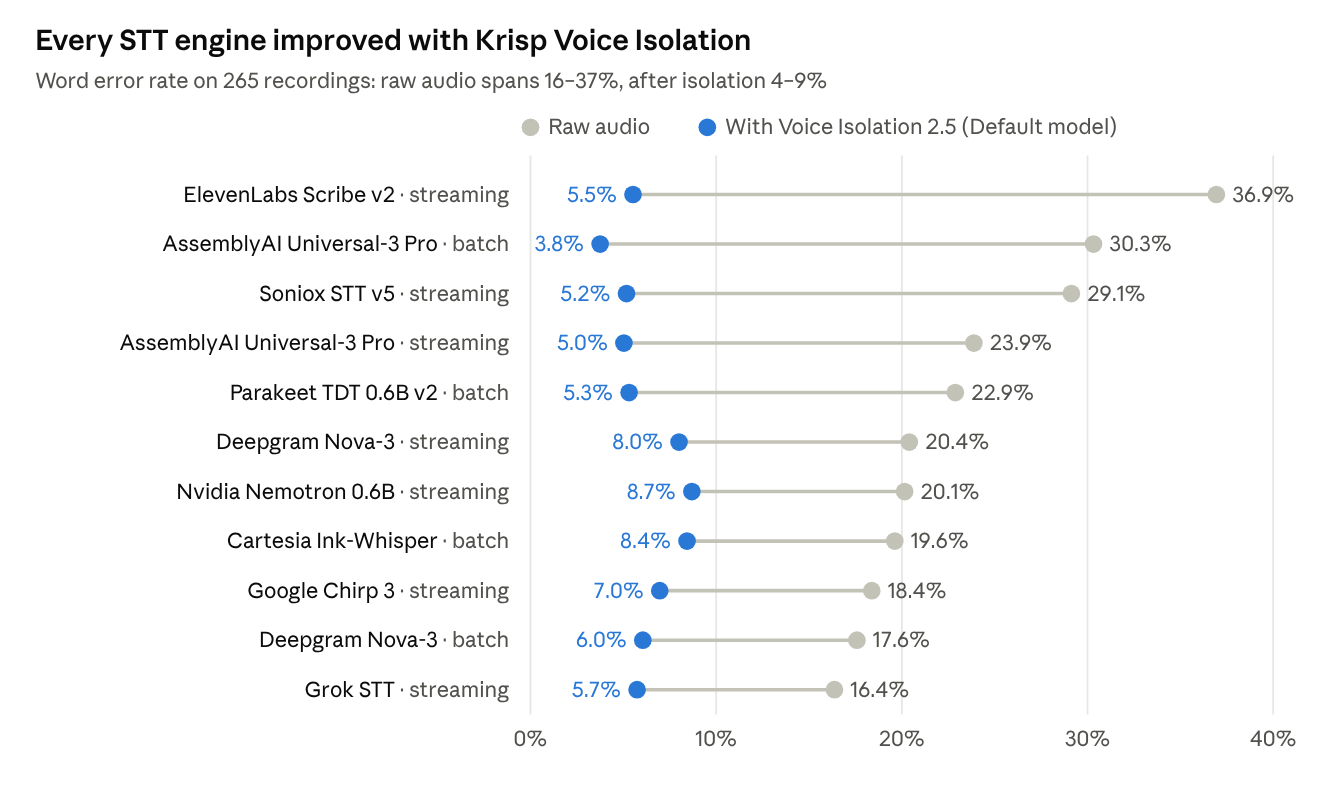
Benchmark sử dụng 265 bản ghi âm thực tế từ văn phòng, nhà ở, bốn tầng call center đang hoạt động và trong xe hơi. Không có gì được mô phỏng hay trộn âm sau đó. Hầu hết các bản ghi đều theo cùng một kịch bản: người nói chính nói chuyện, một người thứ hai tham gia, người nói chính im lặng trong khi người kia tiếp tục nói, rồi người nói chính quay lại. Khoảng thời gian im lặng đó chính là bài kiểm tra thực sự, vì phần văn bản đúng cho nó là trống. Mỗi tệp được chạy qua 11 cấu hình STT từ chín engine, có và không có isolation.
Nguồn: Krisp voice isolation benchmark, tháng 10/2026 · 11 cấu hình STT, gộp chung mọi kịch bản
Mọi engine đều cải thiện và không engine nào xấu đi. Kết quả hữu ích hơn là những gì xảy ra với khoảng cách giữa các engine: trên audio thô, khoảng cách này rộng khoảng 20 điểm, và sau khi áp dụng isolation, nó thu hẹp còn khoảng 5. Nếu agent của bạn nghe thấy giọng nói nền, việc làm sạch đầu vào sẽ cải thiện WER của bạn nhiều hơn là việc chọn một nhà cung cấp STT khác.
Theo từng kịch bản, mức cải thiện phụ thuộc vào việc có giọng nói thứ hai hay không:
Những điểm chưa hiệu quả
Krisp công khai những điểm yếu của mình, và tôi nghĩ đó chính là phần thuyết phục nhất trong bài viết này.
- Âm thanh điện thoại sạch sẽ lại trở nên hơi tệ hơn. Khi không có giọng thứ hai để loại bỏ, việc cách ly chỉ có thể tác động lên giọng chính. WER của cuộc gọi điện thoại tăng từ 3,48% lên 3,91%, và một tệp tăng từ 9,42% lên 21,65%. Mô hình Balanced hoạt động tốt nhất ở đây với 3,53%.
- Vang nặng vẫn là một vấn đề. Trong bài kiểm tra bản phát hành 2.5 riêng biệt, các bản ghi âm một người nói trong điều kiện âm học khó khăn đạt 11,61% khi bật cách ly so với 8,02% khi không bật. Điều đó tốt hơn nhiều so với phiên bản 2.1 (15,42%), nhưng vẫn kém hơn so với việc không can thiệp gì.
- Cách ly quá mức gây ra lỗi thiếu âm thanh. Krisp giải thích rằng các mô hình trước đây đôi khi đã loại bỏ một phần giọng nói chính. Con người vẫn hiểu được âm thanh, nhưng STT lại bỏ sót cả những mệnh đề, và bản ghi đọc trôi chảy nhưng có những chỗ bị khuyết. Phiên bản 2.5 được tinh chỉnh cho STT thay vì cho tai người để khắc phục vấn đề này.
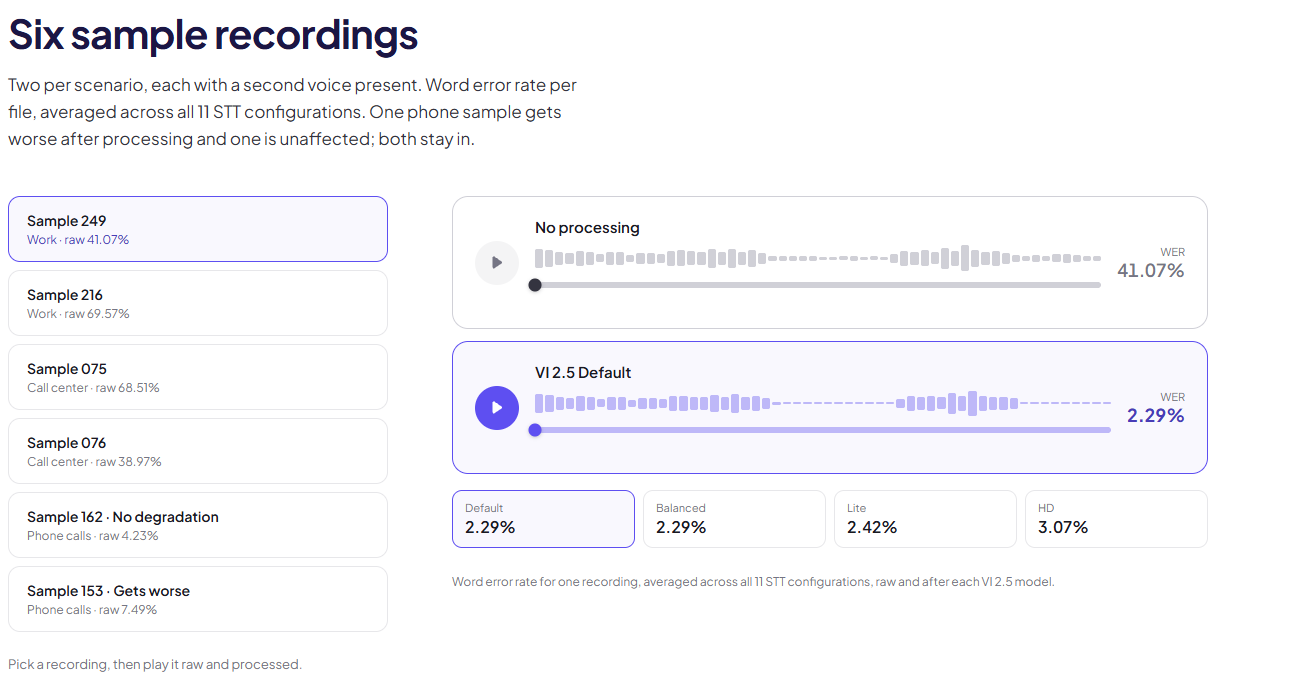
Trang benchmark cho phép bạn nghe sáu bản ghi âm ở dạng gốc và đã qua xử lý. Mẫu 153, một cuộc gọi điện thoại, được gắn nhãn "Gets worse" (Trở nên tệ hơn).
Hai điều khác cần lưu ý. Con số 73% và con số 46,4% mà bạn thấy trên trang web của Krisp đến từ hai bài kiểm tra khác nhau: 265 bản ghi âm trong benchmark mở, và 1.685 bản ghi âm trong bài kiểm tra bản phát hành 2.5. Và kết quả của Krisp so sánh âm thanh có và không có tính năng cách ly của chính họ, chứ không so sánh với các sản phẩm cách ly của nhà cung cấp khác.
Các bản ghi âm, bản ghi chép tay, nhãn phân đoạn và đầu ra của mọi mô hình đều được công khai trên Hugging Face, vì vậy bất kỳ ai cũng có thể chạy lại bài kiểm tra. Đó chính là điều tôi đã làm tiếp theo.
Thực hành: kiểm thử API Voice Isolation
Trong quá trình kiểm thử của tôi, Voice Isolation đã loại bỏ hoàn toàn lời nói nền khỏi bản transcript, và WER gộp giảm từ 40,1% xuống còn 10,2%.
Cài đặt
Việc đăng ký trên Developers Portal rất nhanh chóng, với các lựa chọn đăng nhập bằng Google, Microsoft hoặc email. Gói dùng thử cung cấp cho tôi 30 USD tín dụng và giới hạn hai phiên đồng thời. Từ đó, bạn vào API Keys → Create key, và nhận được một khóa chỉ có thể sao chép một lần duy nhất.
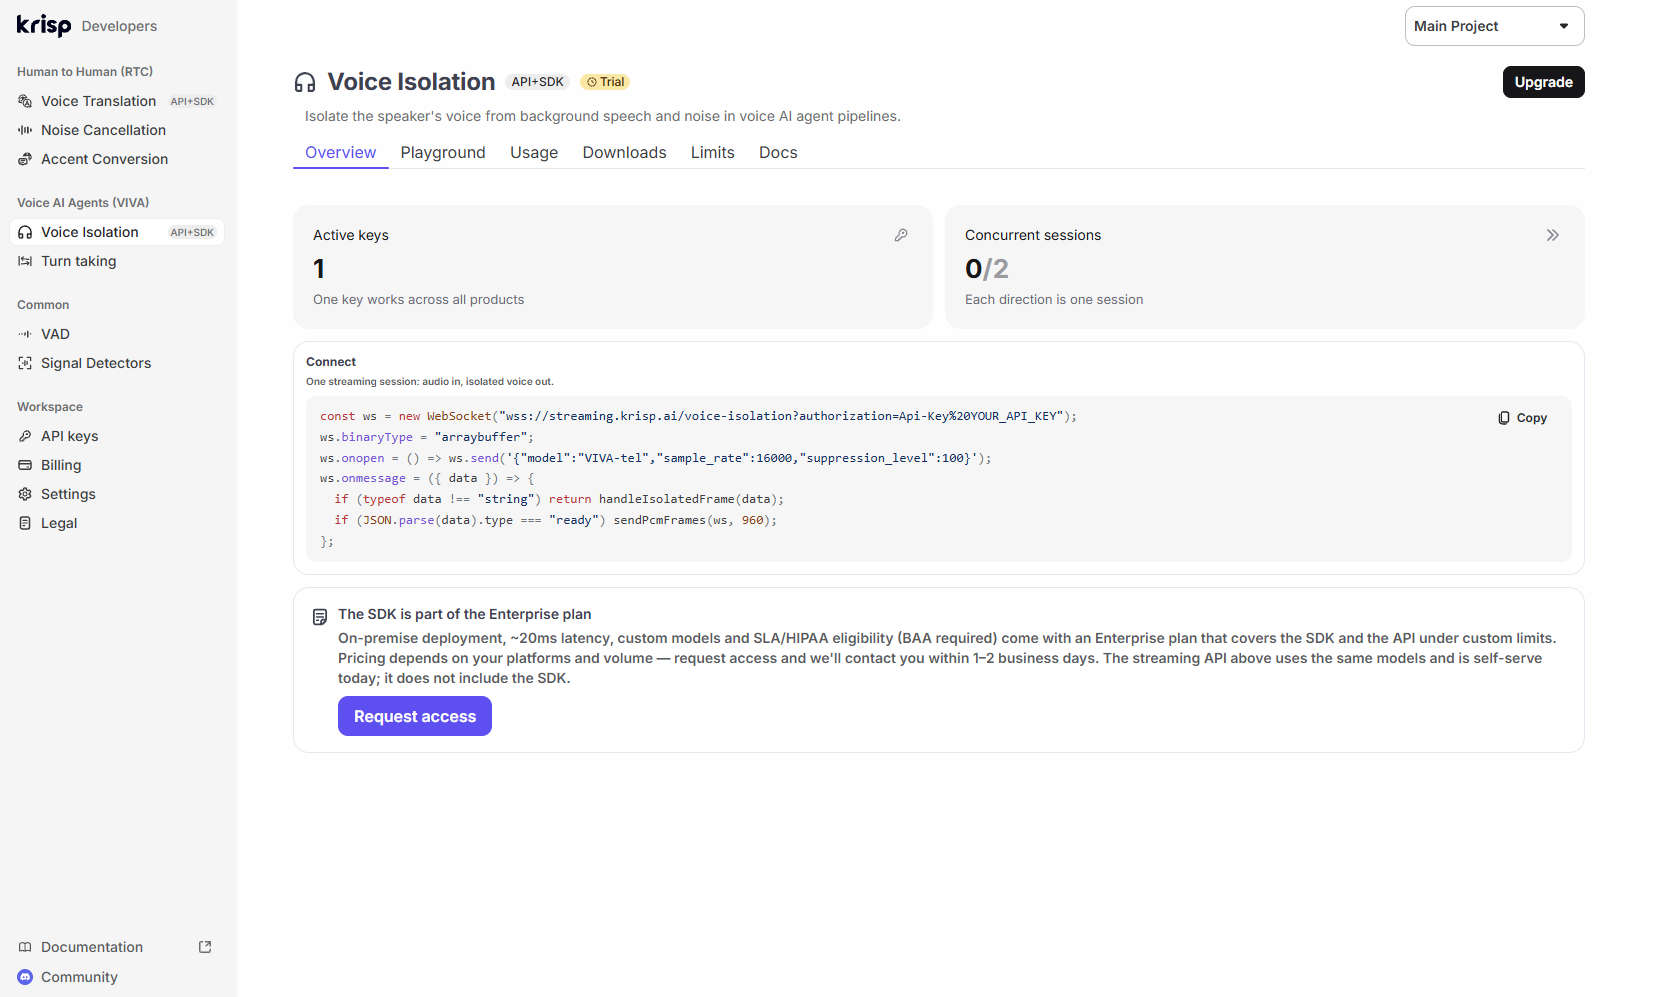
Trang Voice Isolation trong Developers Portal trên gói dùng thử.
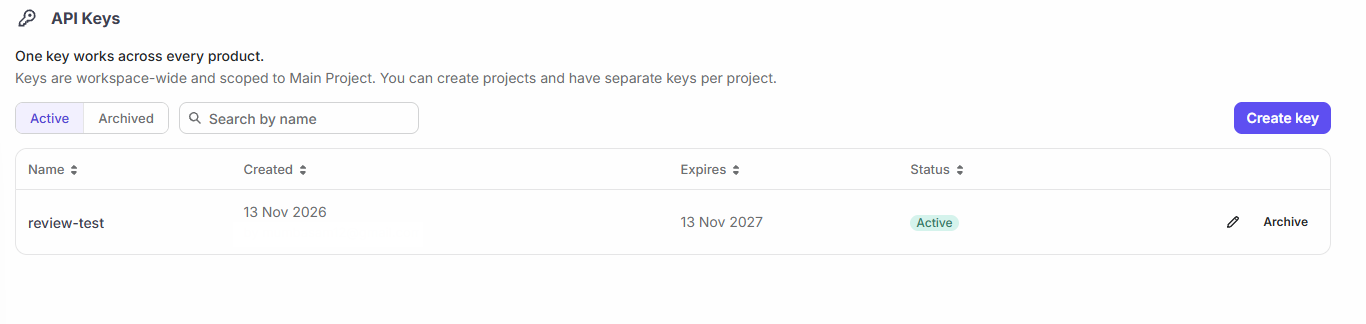
Khóa API tôi tạo cho bài đánh giá này. Một khóa duy nhất hoạt động trên tất cả các sản phẩm Krisp API, bao gồm cả Voice Translation API.
API này là một WebSocket. Backend của bạn đổi khóa API lấy một token phiên tồn tại ngắn hạn, client gửi một lời chào JSON nhỏ, chờ tín hiệu ready, sau đó truyền luồng PCM mono 16-bit và nhận lại âm thanh đã được làm sạch theo từng khung:
URL = "wss://streaming.krisp.ai/voice-isolation"async with websockets.connect(URL, additional_headers={"Authorization": f"api-key {session_token}"}) as ws: await ws.send(json.dumps({"model": "VIVA-tel", "sample_rate": 16000, "suppression_level": 100})) hello = json.loads(await ws.recv()) # {"type": "ready", ...} # then send exactly 30 ms of audio per message (960 bytes at 16 kHz) # and write each binary message you receive to your output
Cách này gần giống với API quickstart của Krisp, một script Python ngắn dùng để làm sạch tệp WAV. Có một quy tắc khiến nhiều người vấp phải: mỗi thông điệp âm thanh phải đúng 30 ms. Kích thước khác bất kỳ sẽ kết thúc phiên với lỗi invalid_frame_duration, vì vậy hãy đệm khung cuối bằng khoảng lặng.
Cho bài kiểm thử, tôi chọn tám bản ghi âm từ bộ dữ liệu công khai của Krisp: ba bản ghi trong văn phòng, ba bản từ sảnh tổng đài-call-center và hai cuộc gọi điện thoại từ trong ô tô, tổng cộng khoảng 11 phút. Tôi truyền từng bản qua API với tốc độ thời gian thực, từ châu Á. Sau đó tôi phiên âm âm thanh thô và âm thanh đã làm sạch bằng Parakeet TDT 0.6B v2 mã nguồn mở của NVIDIA — một trong những động cơ trong benchmark của Krisp — và chấm điểm từng đoạn được gán nhãn so với bản transcript của con người.
Kết quả
API là cách tiếp cận đơn giản nhất: không cần mang theo tệp mô hình và không phải chạy gì trên CPU của bạn. Đổi lại, âm thanh của bạn sẽ được gửi lên đám mây của Krisp, và bạn chỉ có hai mô hình thay vì bốn: VIVA-tel cho âm thanh điện thoại 8 hoặc 16 kHz, và VIVA-pro cho âm thanh dải rộng 32 kHz. VIVA-pro chưa có trong tài liệu tham khảo API, nhưng nó có trong Playground của cổng thông tin, API đã chấp nhận nó trong lần thử nghiệm của tôi, và Krisp xác nhận rằng nó khả dụng.
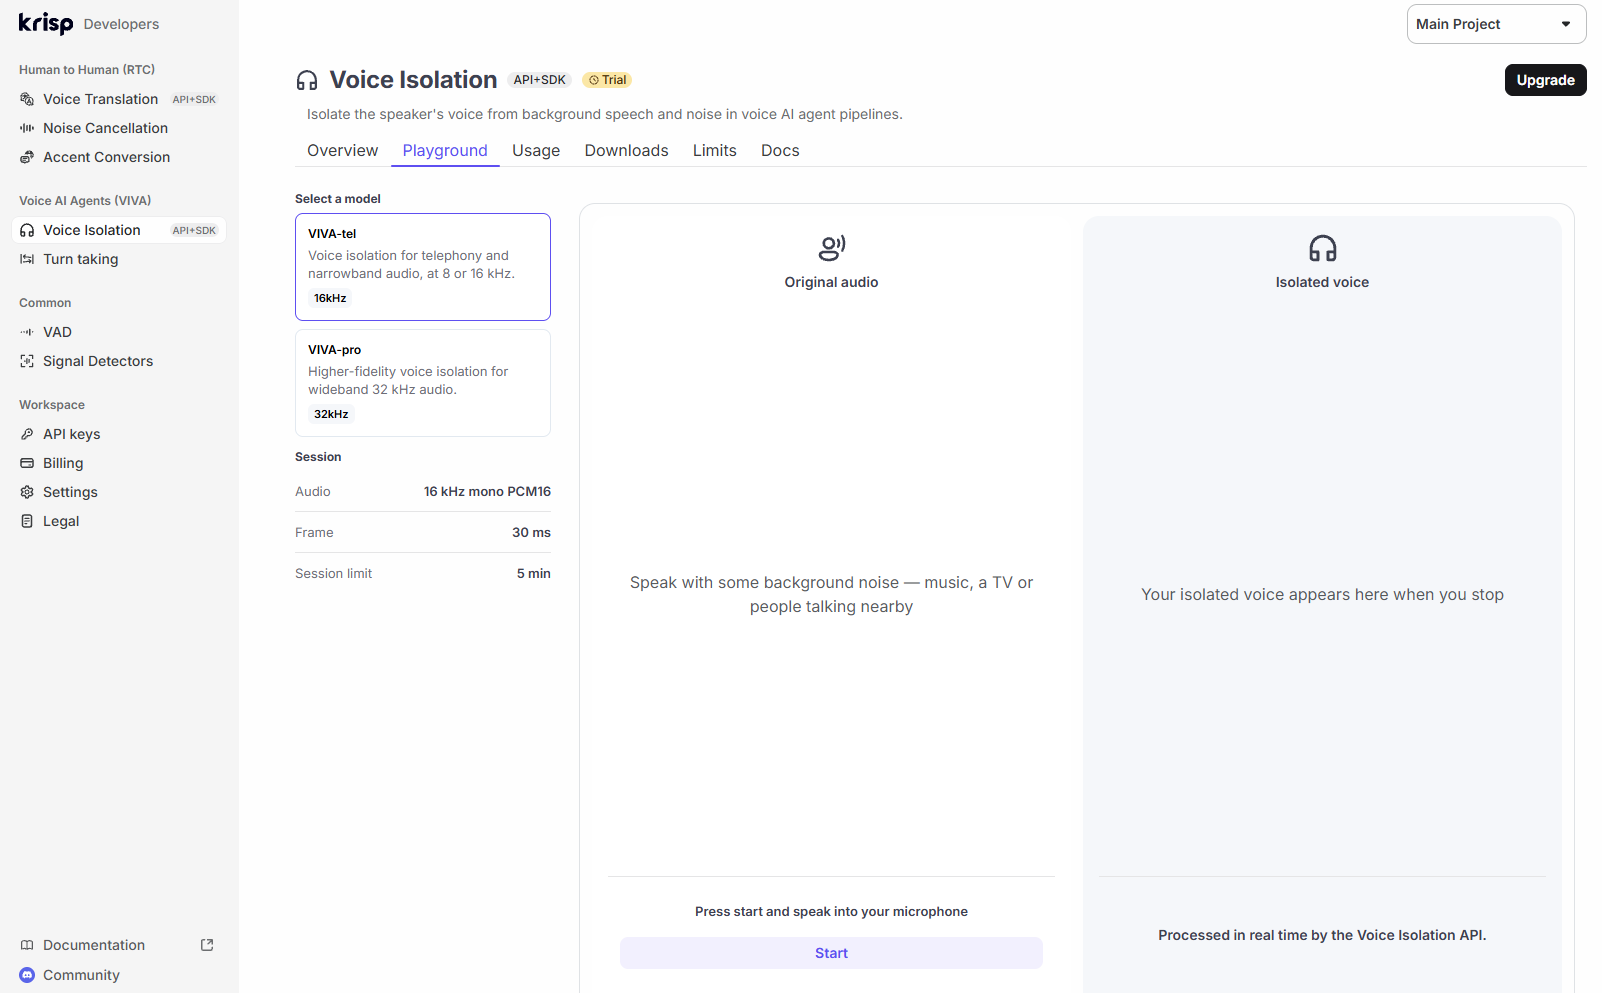
Playground của cổng thông tin cho phép bạn kiểm tra cả hai mô hình API bằng micro của riêng mình trước khi viết bất kỳ đoạn mã nào.
SDK giữ âm thanh trên máy chủ của riêng bạn và chỉ kết nối mạng để kiểm tra giấy phép. Đây cũng là nơi câu chuyện chi phí trở nên thú vị. Bài viết về CPU của Krisp cho thấy chỉ với một cờ SDK duy nhất, enableLowPrecisionExecution, số cuộc gọi mà một máy chủ có thể xử lý trên CPU hỗ trợ FP16 tăng gấp đôi. Một phiên bản AWS Graviton3 với 16 vCPU đã tăng từ 76 cuộc gọi trực tiếp lên 137, và mô hình Lite giữ được khoảng gấp ba số lượng luồng so với các mô hình đầy đủ. Trên các chip Intel Ice Lake cũ hơn, cờ này không có tác dụng gì.
Tích hợp
- Pipecat có sẵn một bộ lọc hoàn chỉnh. Bạn thêm KrispVivaFilter() làm bộ lọc đầu vào âm thanh trên transport của mình, và có thể kết hợp nó với KrispVivaTurn để phát hiện lượt nói. Lưu ý rằng nó sử dụng SDK, vì vậy bạn cần quyền truy cập SDK và các tệp mô hình, không chỉ riêng khóa API.
- LiveKit cung cấp các mô hình Krisp trong LiveKit Cloud, bao gồm tính năng loại bỏ giọng nói nền (noise_cancellation.BVC()) cho các agent. LiveKit tính phí bổ sung cho các mô hình cách ly giọng nói của mình.
- Các pipeline WebRTC và điện thoại có thể sử dụng SDK trực tiếp, và API hoạt động với bất kỳ thứ gì có thể mở WebSocket.
Tài liệu rõ ràng và cập nhật. Quickstart hoạt động ngay từ lần đầu tiên, và các thông báo lỗi cho bạn biết chính xác điều gì đã xảy ra, chi tiết đến cả kích thước khung mong đợi và nhận được. Điều duy nhất khiến tôi chưa hài lòng là cách đặt tên: bài blog nhắc đến Default, Balanced, Lite và HD, các tệp tải xuống SDK dùng tên như krisp-viva-vi-tel-v2.5.1, còn API gọi các mô hình của mình là VIVA-tel và VIVA-pro, với chỉ mô hình đầu tiên xuất hiện trong tài liệu tham khảo API. Một bảng đối chiếu trong tài liệu sẽ rất hữu ích.
Giá cả
API được tính phí theo giờ audio, và mức giá đủ rẻ để chi phí không nên là yếu tố quyết định việc bạn có sử dụng nó hay không.
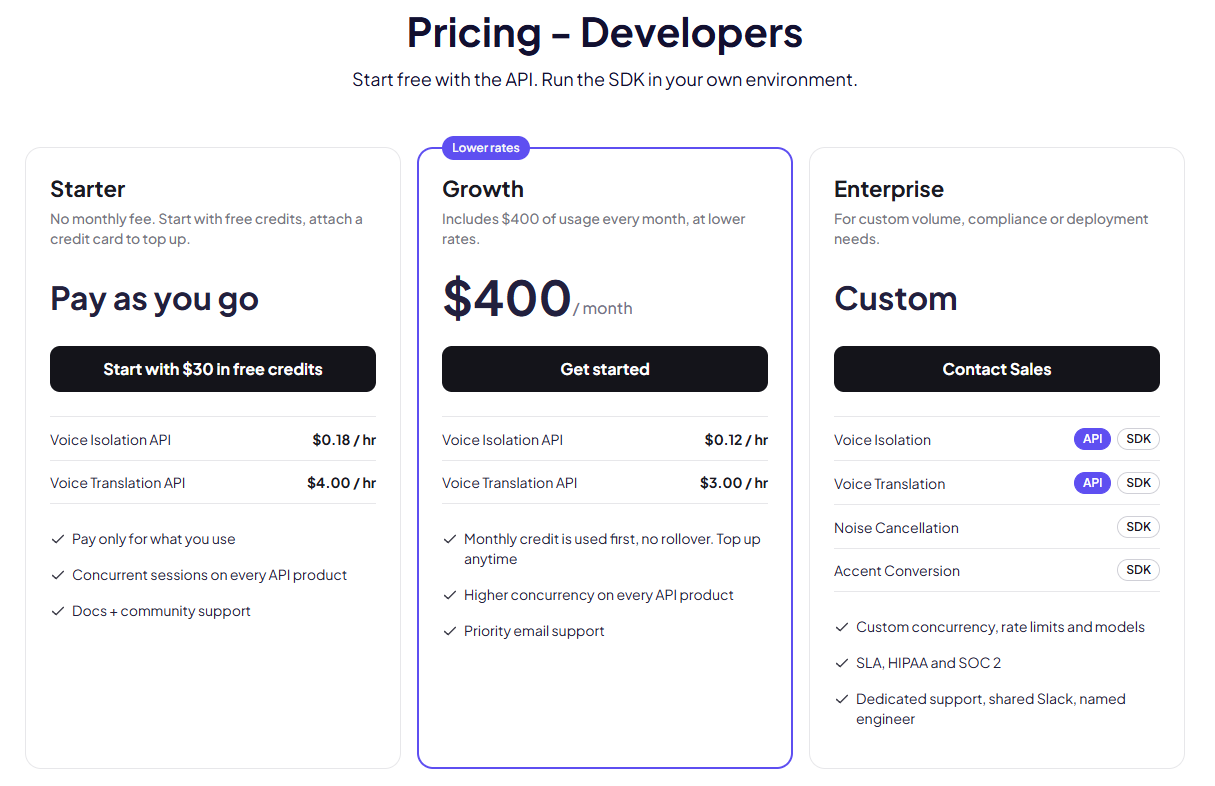
Bảng giá dành cho nhà phát triển của Krisp, tháng 11 năm 2026.
Với gói Starter trả theo mức sử dụng, Voice Isolation API có giá $0.18 mỗi giờ audio, không có phí hàng tháng. Mức giá này giống nhau cho cả hai mô hình API, VIVA-tel và VIVA-pro. Gói Growth có giá $400 mỗi tháng, bao gồm $400 mức sử dụng và giảm giá xuống còn $0.12 mỗi giờ, kèm theo khả năng xử lý đồng thời cao hơn và hỗ trợ ưu tiên. Gói Enterprise có giá tùy chỉnh và là gói duy nhất bao gồm SDK, SLA, cùng các chứng nhận HIPAA và SOC 2.
Khoản tín dụng khởi đầu $30 đủ để xử lý khoảng 166 giờ audio theo mức giá gói Starter — quá đủ cho việc thử nghiệm. Tín dụng có hiệu lực trong 12 tháng và mức sử dụng được tính phí theo từng phút. Để hình dung, một cuộc gọi 5 phút chỉ tốn khoảng 1,5 cent để làm sạch trên gói Starter.
SDK chỉ có trong gói Enterprise, với mức giá thỏa thuận, nên bạn sẽ cần liên hệ với bộ phận kinh doanh nếu muốn chạy các mô hình trên máy chủ của riêng mình. Mức giá được lấy từ trang giá của Krisp, kiểm tra vào tháng 11 năm 2026.
Các phương án thay thế
Krisp không phải là lựa chọn duy nhất để loại bỏ tiếng nói nền, nhưng cho đến nay vẫn chưa có bài kiểm tra đối chiếu độc lập nào giữa các sản phẩm này. Mỗi nhà cung cấp đều công bố số liệu của riêng mình trên dữ liệu của riêng họ, vì vậy hãy coi các con số dưới đây chỉ là tuyên bố từ phía họ.
Điểm nổi bật của Krisp là bằng chứng. Đây là nhà cung cấp duy nhất ở đây có một benchmark mở, có thể tái lập trên 11 thiết lập STT, và họ công khai cả những trường hợp mình thua. Krisp cũng linh hoạt nhất trong việc triển khai: API đám mây, SDK trên máy chủ, hoặc tích hợp sẵn vào LiveKit và Pipecat.
Kết luận
Krisp Voice Isolation là giải pháp nên đến với khi voice agent hoạt động tốt trong môi trường kiểm thử nhưng lại gặp trục trặc trên các cuộc gọi thực tế. Nó loại bỏ những giọng nói mà agent không nên nghe, hoạt động với bất kỳ STT nào bạn đang dùng, và cả benchmark của Krisp lẫn thử nghiệm của riêng tôi đều cho thấy điều tương tự: giọng nói nền không còn lọt vào bản transcript.
Ưu điểm
- Loại bỏ giọng nói nền chứ không chỉ tạp âm — vấn đề mà STT không thể tự xử lý được
- Hoạt động với bất kỳ engine STT nào, không cần cấu hình theo ngôn ngữ hay thu âm giọng mẫu
- Chạy trên CPU với độ trễ thuật toán chỉ 15 ms
- Benchmark công khai, có thể tái lập, bao gồm cả những trường hợp mà nó thua
- API tự phục vụ với 30 USD tín dụng miễn phí, giá rẻ chỉ 0,12–0,18 USD mỗi giờ
- Có sẵn filter cho Pipecat và hỗ trợ LiveKit
Nhược điểm
- Độ chính xác giảm nhẹ trên âm thanh điện thoại sạch, và vẫn kém hơn âm thô gốc trong những căn phòng có tiếng vọng nặng
- API chỉ chạy tại khu vực Mỹ, làm tăng độ trễ đáng kể ở các nơi khác
- API chỉ có hai mô hình so với bốn mô hình của SDK; dùng tại chỗ (on-premise) cần bản SDK Enterprise
Nên dùng nếu: đội ngũ của bạn có các agent nhận cuộc gọi từ tổng đài, văn phòng, nhà riêng, xe cộ hoặc bất kỳ nơi nào có người khác nói chuyện gần đó. Hãy bắt đầu với API để đo lường hiệu quả trên chính các bản ghi âm của bạn, sau đó chuyển sang SDK nếu bạn cần các mô hình khác, độ trễ thấp hơn ngoài nước Mỹ, hoặc âm thanh luôn được giữ trên máy chủ của bạn.
Có thể bỏ qua nếu: các agent của bạn thường xuyên chỉ nhận cuộc gọi từ người dùng ở một mình trong phòng yên tĩnh, hoặc từ các thiết bị far-field như loa thông minh — những nơi mà các mô hình tách giọng nói không được thiết kế để hoạt động.
Bạn có thể dùng thử Krisp Voice Isolation API với tín dụng miễn phí và đưa các bản ghi âm của riêng mình qua nó chỉ trong một buổi chiều.
Câu hỏi thường gặp
Chống ồn giọng nói (voice isolation) có giống khử tiếng ồn (noise cancellation) không? Không. Khử tiếng ồn loại bỏ các âm thanh không phải giọng nói như tiếng xe cộ hay tiếng gõ bàn phím. Voice isolation còn loại bỏ cả giọng nói của người khác — thứ mà khử tiếng ồn vẫn giữ lại.
Krisp Voice Isolation có hoạt động với nhà cung cấp STT của tôi không? Có. Nó xử lý âm thanh độc lập, nên có thể đặt phía trước bất kỳ engine STT nào. Krisp đã thử nghiệm với 11 cấu hình, bao gồm các mô hình của Deepgram, AssemblyAI, ElevenLabs, Soniox, Google, Cartesia và NVIDIA. Nó cũng có thể đặt phía trước các mô hình speech-to-speech. Krisp chưa công bố kết quả cho thiết lập này, nhưng chẳng có gì cản trở bạn thử.
Nó có thay thế phát hiện lượt nói (turn detection) không? Không. Nó đặt trước VAD và turn detection để cung cấp cho chúng âm thanh sạch hơn. Krisp cung cấp Turn-Taking dưới dạng một mô hình riêng trong cùng bộ VIVA SDK.
Người dùng có cần đăng ký giọng nói không? Không. Nó không cần đăng ký hay huấn luyện trên giọng nói của người dùng.
Nó làm tăng bao nhiêu độ trễ? Krisp công bố 15 ms độ trễ thuật toán, và tài liệu SDK của họ ghi rõ độ trễ bổ sung khoảng 20 ms. Với API đám mây, thời gian mạng tới khu vực Mỹ sẽ cộng thêm vào con số đó.
Nó có hoạt động trên cuộc gọi điện thoại không? Có. Nó xử lý được âm thanh điện thoại dải hẹp (narrowband), các codec phổ biến như G.711, G.722, G.729 và Opus, cũng như tai nghe Bluetooth.
Còn với các cuộc gọi người với người thì sao? Cùng công nghệ đó được đóng gói dưới dạng Background Voice Cancellation (BVC) trong RTC SDK của Krisp, chạy trên thiết bị của người dùng qua trình duyệt cũng như ứng dụng desktop và di động. Các trung tâm liên hệ có nhân viên tư vấn con người có thể sử dụng qua sản phẩm call center AI của Krisp, giúp loại tiếng nói của các nhân viên xung quanh khỏi cuộc gọi của khách hàng.


