
Kimi K2.7 Code của Moonshot đã được công bố với các điểm chuẩn so sánh với hai mô hình mà hầu hết các nhà phát triển thực sự trả tiền để sử dụng: Claude Opus và GPT-5.5. Tóm lại, các mô hình tiên tiến đóng vẫn đạt điểm cao hơn trong hầu hết các tác vụ mã hóa, nhưng không phải với biên độ mà giá của chúng gợi ý. Kimi là một mô hình trọng lượng mở mà bạn có thể tải xuống và tự lưu trữ, và nó chỉ cách vài điểm so với các mô hình mà bạn chỉ có thể thuê.
Bản so sánh này đặt các con số cạnh nhau, cân nhắc chúng dựa trên chi phí và tính mở, đồng thời cho bạn biết nên chọn mô hình nào cho công việc cụ thể nào.
Tóm tắt
- Chất lượng mã hóa thô: GPT-5.5 và Claude Opus dẫn đầu trong hầu hết các bộ thử nghiệm. Kimi K2.7 Code theo sau vài điểm.
- Chi phí: Kimi rẻ hơn nhiều (0.95 USD/$4.00 cho mỗi triệu token) và miễn phí tự lưu trữ. Các mô hình đóng tốn kém hơn và không thể tự lưu trữ trên phần cứng của bạn.
- Tính mở: Kimi cung cấp trọng lượng mở theo giấy phép MIT đã sửa đổi. Opus và GPT-5.5 là các mô hình đóng.
- Kết luận: chọn các mô hình tiên tiến để có chất lượng cao nhất trong một lần thực hiện; chọn Kimi khi chi phí, khối lượng hoặc kiểm soát dữ liệu quan trọng hơn những điểm số cuối cùng.
Các đối thủ cạnh tranh trong nháy mắt
| Kimi K2.7 Code | Claude Opus | GPT-5.5 | |
|---|---|---|---|
| Loại | Trọng lượng mở (MIT đã sửa đổi) | Đóng | Đóng |
| Kiến trúc | MoE, tổng 1T / 32B hoạt động | Không tiết lộ | Không tiết lộ |
| Cửa sổ ngữ cảnh | 256K token | Lớn | Lớn |
| Tự lưu trữ | Có | Không | Không |
| Giá (mỗi triệu token) | 0.95 USD vào / 4.00 USD ra | Cao hơn, chỉ thuê | Cao hơn, chỉ thuê |
Sự khác biệt về cấu trúc là điểm chính. Kimi cho bạn biết chính xác nó là gì và cho phép bạn tự chạy nó. Hai mô hình còn lại là các dịch vụ mà bạn gọi.
Điểm chuẩn mã hóa
Đây là các điểm số được Moonshot báo cáo. Hãy coi chúng là cách trình bày của nhà cung cấp, vì một số bộ thử nghiệm là của riêng Moonshot, nhưng mô hình này nhất quán và đáng đọc.
| Điểm chuẩn | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Code Bench v2 | 62.0 | 69.0 | 67.4 |
| Program Bench | 53.6 | 69.1 | 63.8 |
| MLS Bench Lite | 35.1 | 35.5 | 42.8 |
GPT-5.5 đứng đầu ở hai bộ thử nghiệm đầu tiên; Claude Opus dẫn đầu MLS Bench Lite và duy trì gần sát ở mọi nơi. Kimi đứng thấp hơn một bậc ở mỗi bộ. Khoảng cách là có thật nhưng nhỏ trên Kimi Code Bench v2, và rộng hơn trên Program Bench. Nếu công việc của bạn giống như bộ thử nghiệm thứ hai đó, các mô hình tiên tiến sẽ chứng tỏ giá trị của chúng.
Điểm chuẩn tác nhân và sử dụng công cụ
Các tác nhân mã hóa thành công hay thất bại dựa vào các lời gọi công cụ, không chỉ là tạo mã. Ở đây, bức tranh trở nên rõ ràng hơn.
| Điểm chuẩn | Kimi K2.7 Code | GPT-5.5 | Claude Opus |
|---|---|---|---|
| Kimi Claw 24/7 | 46.9 | 52.8 | 50.4 |
| MCP Atlas | 76.0 | 79.4 | 81.3 |
| MCP Mark Verified | 81.1 | 92.9 | 76.4 |
Trên MCP Mark Verified, Kimi thực sự vượt qua Claude Opus, mặc dù GPT-5.5 dẫn trước khá xa. Trên MCP Atlas, cả ba đều nằm trong khoảng năm điểm. Đối với các tác vụ tác nhân, Kimi gần với các mô hình khác hơn so với điểm số mã hóa thô của nó gợi ý, điều này quan trọng vì đó chính là nơi chi phí token tăng lên.
Chi phí là nơi Kimi thắng thế
Điểm chuẩn đo lường chất lượng. Chúng không đo lường hóa đơn. Kimi K2.7 Code có giá 0.95 USD cho mỗi triệu token đầu vào và 4.00 USD cho mỗi triệu token đầu ra, với lượt truy cập bộ nhớ đệm là 0.19 USD cho mỗi triệu. Các mô hình tiên tiến đóng có chi phí mỗi token cao hơn đáng kể, và bạn không thể tránh được điều đó bằng cách tự lưu trữ chúng; không có bản tải xuống.
Hai yếu tố làm tăng thêm khả năng tiết kiệm:
- Trọng lượng mở có nghĩa là một lựa chọn không token. Tự lưu trữ trên phần cứng của riêng bạn và chi phí mỗi token biến mất hoàn toàn. Bạn đổi nó lấy thời gian GPU.
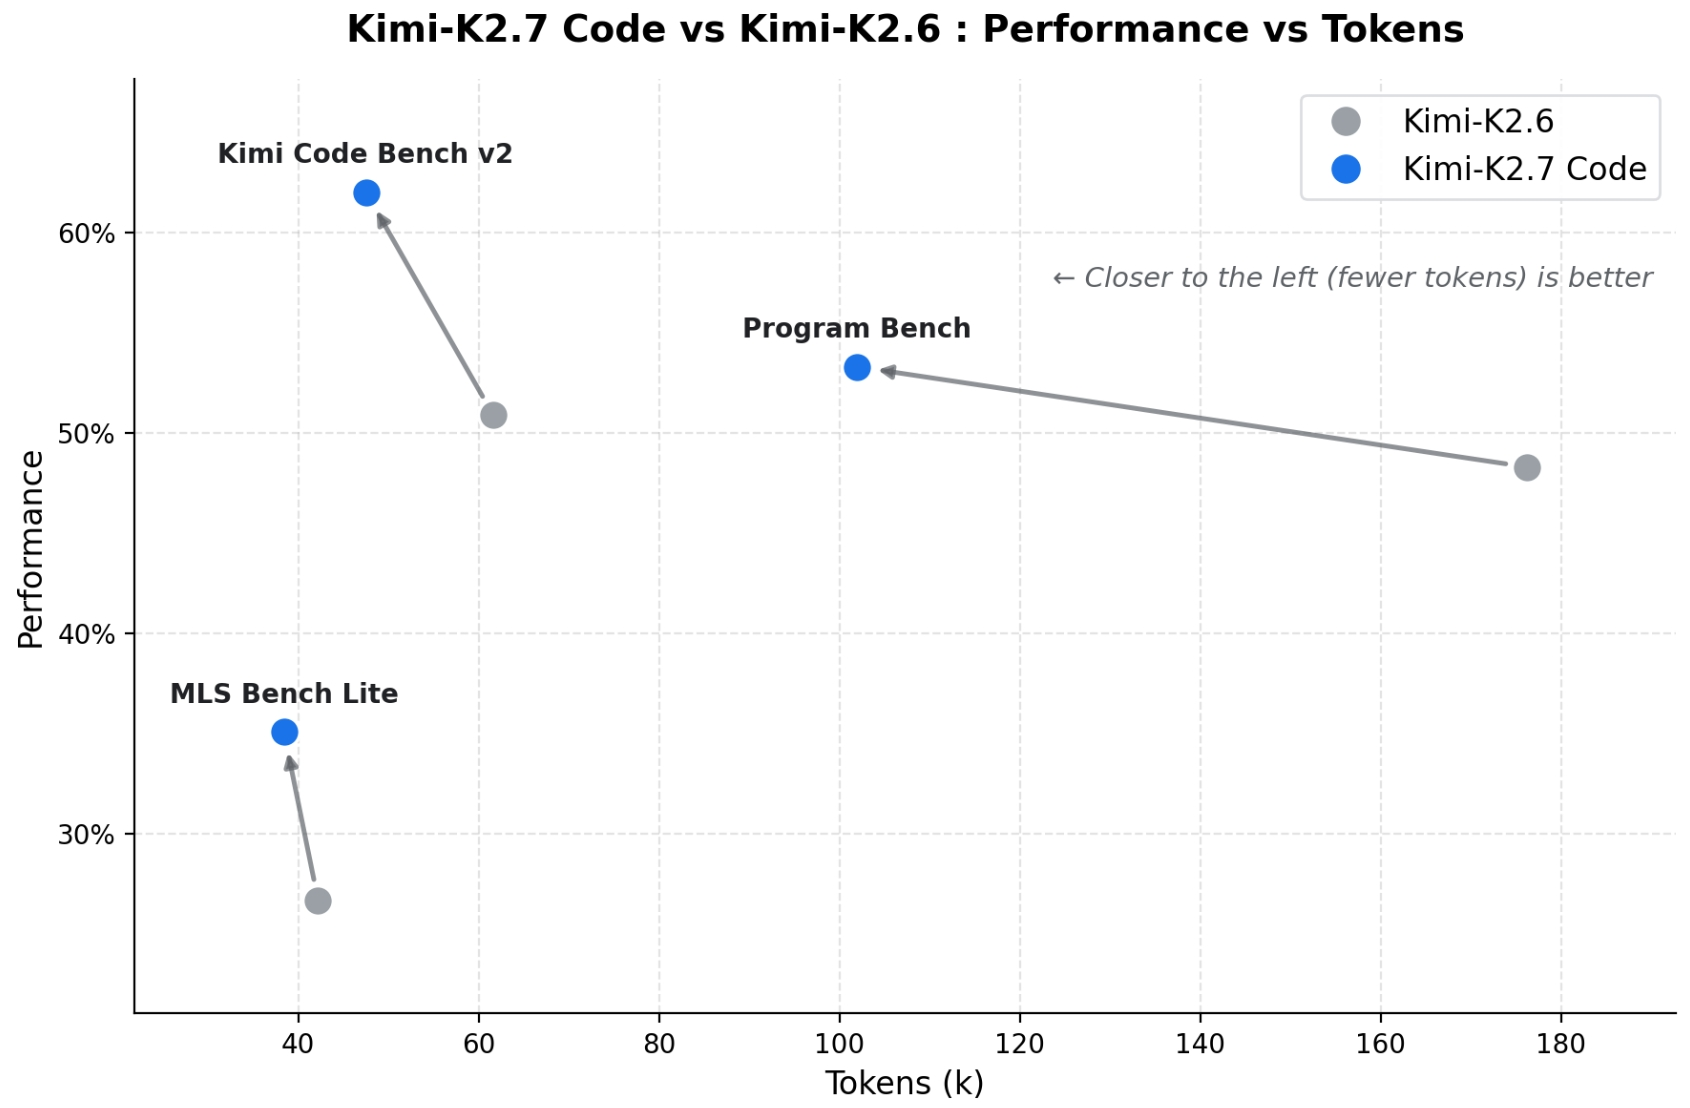
- Suy luận tinh gọn hơn. K2.7 Code sử dụng ít hơn khoảng 30% token suy nghĩ so với K2.6 cho cùng một công việc, vì vậy mỗi bước tác nhân sẽ tốn ít chi phí hơn. Hướng dẫn của chúng tôi về giảm chi phí token tác nhân đi sâu hơn vào lý do tại sao điều đó lại tích lũy.
Đối với một tác nhân thực hiện hàng trăm lời gọi công cụ cho mỗi tác vụ, một mô hình tốt bằng 90% với một phần nhỏ giá tiền thường giành chiến thắng về tổng giá trị.
Ngữ cảnh và tính mở
Cả ba đều xử lý ngữ cảnh dài tốt; cửa sổ của Kimi là 256K token, đủ cho một dịch vụ hoàn chỉnh cộng với các thử nghiệm của nó trong một lời nhắc. Yếu tố khác biệt lớn hơn là giấy phép. Trọng lượng MIT đã sửa đổi của Kimi cho phép bạn tinh chỉnh, kiểm tra và chạy mô hình trong môi trường cách ly (air-gapped). Đối với các nhóm có quy định về tuân thủ hoặc lưu trú dữ liệu, đó không phải là một tính năng 'có thì tốt'; đó là yếu tố quyết định, và các mô hình đóng đơn giản là không thể xem xét.
Khi nào nên chọn từng loại
Chọn GPT-5.5 hoặc Claude Opus nếu:
- Bạn cần chất lượng mã hóa một lần thực hiện cao nhất và vài điểm chuẩn đủ để biện minh cho chi phí.
- Bạn hài lòng với việc thuê một dịch vụ đóng với SLA (Thỏa thuận cấp độ dịch vụ) được quản lý.
- Các tác vụ khó nhất của bạn giống như Program Bench, nơi khoảng cách là rộng nhất.
Chọn Kimi K2.7 Code nếu:
- Bạn chạy các tác vụ tác nhân khối lượng lớn mà chi phí token quyết định khả năng thực thi.
- Dữ liệu phải nằm trên cơ sở hạ tầng của riêng bạn.
- Bạn muốn tinh chỉnh hoặc kiểm tra mô hình.
- Bạn đang tối ưu hóa tổng giá trị, chứ không phải vị trí dẫn đầu bảng xếp hạng.
Để có cái nhìn rộng hơn, bài so sánh MiniMax M3 vs DeepSeek V4 vs Qwen 3.7 của chúng tôi bao gồm các đối thủ trọng lượng mở khác, và DeepSeek V4 vs Claude Opus cho mã hóa đi sâu vào một cuộc đối đầu mở-vs-đóng khác. Nếu bạn đang so sánh các tác nhân thay vì các mô hình, hãy xem Claude Code vs OpenAI Codex.
Hãy tự mình thử so sánh
Điểm chuẩn là một điểm khởi đầu, không phải là phán quyết cho cơ sở mã của bạn. Thử nghiệm trung thực là chạy cả ba trên các tác vụ của riêng bạn và đọc kết quả. Kimi Code CLI cung cấp cho bạn tác nhân miễn phí để bắt đầu, và bạn có thể gọi trực tiếp API của mỗi mô hình để so sánh các đầu ra thô.
Khi bạn làm điều đó, hãy kiểm tra các điểm cuối trong Apidog: gửi cùng một lời nhắc đến mỗi mô hình, lưu các cuộc gọi cạnh nhau và so sánh chất lượng phản hồi, độ trễ và mức sử dụng token ở một nơi. Tải xuống Apidog để chạy cuộc đối đầu.
Câu hỏi thường gặp
Kimi K2.7 Code có tốt hơn Claude Opus hay GPT-5.5 không? Trên các điểm chuẩn mã hóa được Moonshot báo cáo, không; các mô hình đóng đạt điểm cao hơn trong hầu hết các bộ thử nghiệm. Lợi thế của Kimi là trọng lượng mở và chi phí thấp hơn nhiều trong khi vẫn duy trì trong vài điểm.
Kimi rẻ hơn bao nhiêu? Nó có giá 0.95 USD cho mỗi triệu token đầu vào và 4.00 USD cho mỗi triệu token đầu ra, và miễn phí tự lưu trữ. Các mô hình tiên tiến đóng có chi phí mỗi token cao hơn và không thể tự lưu trữ.
Tôi có thể tự chạy Kimi K2.7 Code không? Có. Các trọng lượng là mở theo giấy phép MIT đã sửa đổi; hãy phục vụ chúng bằng vLLM, SGLang, hoặc KTransformers.
Mô hình nào tốt nhất cho các tác nhân mã hóa? Về chất lượng thô, GPT-5.5 dẫn đầu. Đối với các tác nhân khối lượng lớn hiệu quả về chi phí, Kimi là lựa chọn có giá trị tốt hơn, và nó gần sát trên các điểm chuẩn tác nhân.
Các điểm chuẩn này có trung lập không? Một số bộ thử nghiệm là của riêng Moonshot, vì vậy hãy đọc chúng như cách trình bày của nhà cung cấp. Khoảng cách nhất quán đến các mô hình tiên tiến là tín hiệu hữu ích, chứ không phải là những con số chính xác.
Tóm tắt
Kimi K2.7 Code không vượt trội hơn Claude Opus hay GPT-5.5 trên hầu hết các điểm chuẩn mã hóa, và Moonshot cũng không giả vờ rằng nó làm được điều đó. Nó đạt điểm thấp hơn vài điểm nhưng chi phí thấp hơn nhiều và cung cấp trọng lượng mở mà bạn có thể tự chạy. Để có chất lượng cao nhất có thể, các mô hình tiên tiến đóng vẫn thắng thế. Đối với các tác nhân khối lượng lớn, triển khai riêng tư, hoặc bất kỳ ai cân nhắc tổng giá trị hơn vị trí dẫn đầu bảng xếp hạng, Kimi là lựa chọn thông minh hơn. Hãy chạy cả ba trên mã của riêng bạn, so sánh đầu ra trong Apidog, và để khối lượng công việc của bạn quyết định.