
Hầu hết mọi người làm quen với một mô hình mới bằng cách mở hộp trò chuyện và nhập liệu. Jev chống lại phản xạ đó. Đây là mô hình Hệ thống Một của TypeSafe AI, và nó hoàn toàn không tạo ra văn xuôi: bạn cung cấp cho nó trạng thái chương trình cùng với một tập hợp các câu hỏi đã được định kiểu, và nó trả về các quyết định kèm theo xác suất. Sự thay đổi vai trò đó chính là toàn bộ kỹ thuật. Mô hình ngôn ngữ của bạn tiếp tục viết; Jev quyết định điều gì sẽ xảy ra tiếp theo, và mã của bạn quyết định phải làm gì với quyết định đó.
Hướng dẫn này bao gồm kiến trúc xung quanh cuộc gọi, chứ không phải bản thân cuộc gọi. Nếu bạn cần kiến thức cơ bản trước, hãy bắt đầu với Jev là gì, sau đó đọc bài đăng ra mắt của TypeSafe để hiểu cách công ty định hình.
Những điểm Jev vượt trội
Ba nguyên hàm cơ bản bao gồm mọi thứ Jev thực hiện. noul trả về xác suất một tuyên bố về trạng thái là đúng. choice chọn một tùy chọn từ một bản đồ tiêu chí (tối đa 255 tùy chọn) và trả về lựa chọn, phân phối xác suất đầy đủ và giá trị độ tin cậy. score đặt trạng thái vào một thang đánh giá có thứ tự từ 2 đến 10 cấp độ và trả về cấp độ, một chú giải, xác suất và độ tin cậy. Thông tin cơ bản về công ty và dòng mô hình có trong bài viết của chúng tôi về TypeSafe AI.
Bốn thuộc tính quan trọng đối với kiến trúc. Mọi câu trả lời đều đến dưới dạng kiểu mà chương trình của bạn đã hiểu. Mọi câu trả lời đều mang theo sự không chắc chắn của riêng nó, vì vậy "không chắc chắn" trở thành một nhánh thay vì một sự bất ngờ. Nhiều câu hỏi về một trạng thái được giải quyết trong một lần xử lý duy nhất. Và với chi phí 0,042 USD cho mỗi triệu token đầu vào mà không tính phí token đầu ra, bạn có thể hỏi trên mọi sự kiện thay vì chỉ trên một mẫu.
Chạy Jev như người phán xử, không phải người viết
Bốn vai trò, được tách biệt rõ ràng:
- LLM tạo ra. Mã, bản nháp email, tóm tắt, kế hoạch.
- Jev quyết định. Nó phân loại yêu cầu, chấm điểm rủi ro, chọn tuyến đường và kiểm tra đầu ra dựa trên các tiêu chí bạn đã viết ra từ trước.
- Mã của bạn kiểm soát. Ngưỡng và quy tắc quyết định có hành động, thử lại, leo thang hay dừng lại.
- Con người xử lý các trường hợp đặc biệt. Độ tin cậy thấp kèm rủi ro cao sẽ được chuyển cho người.
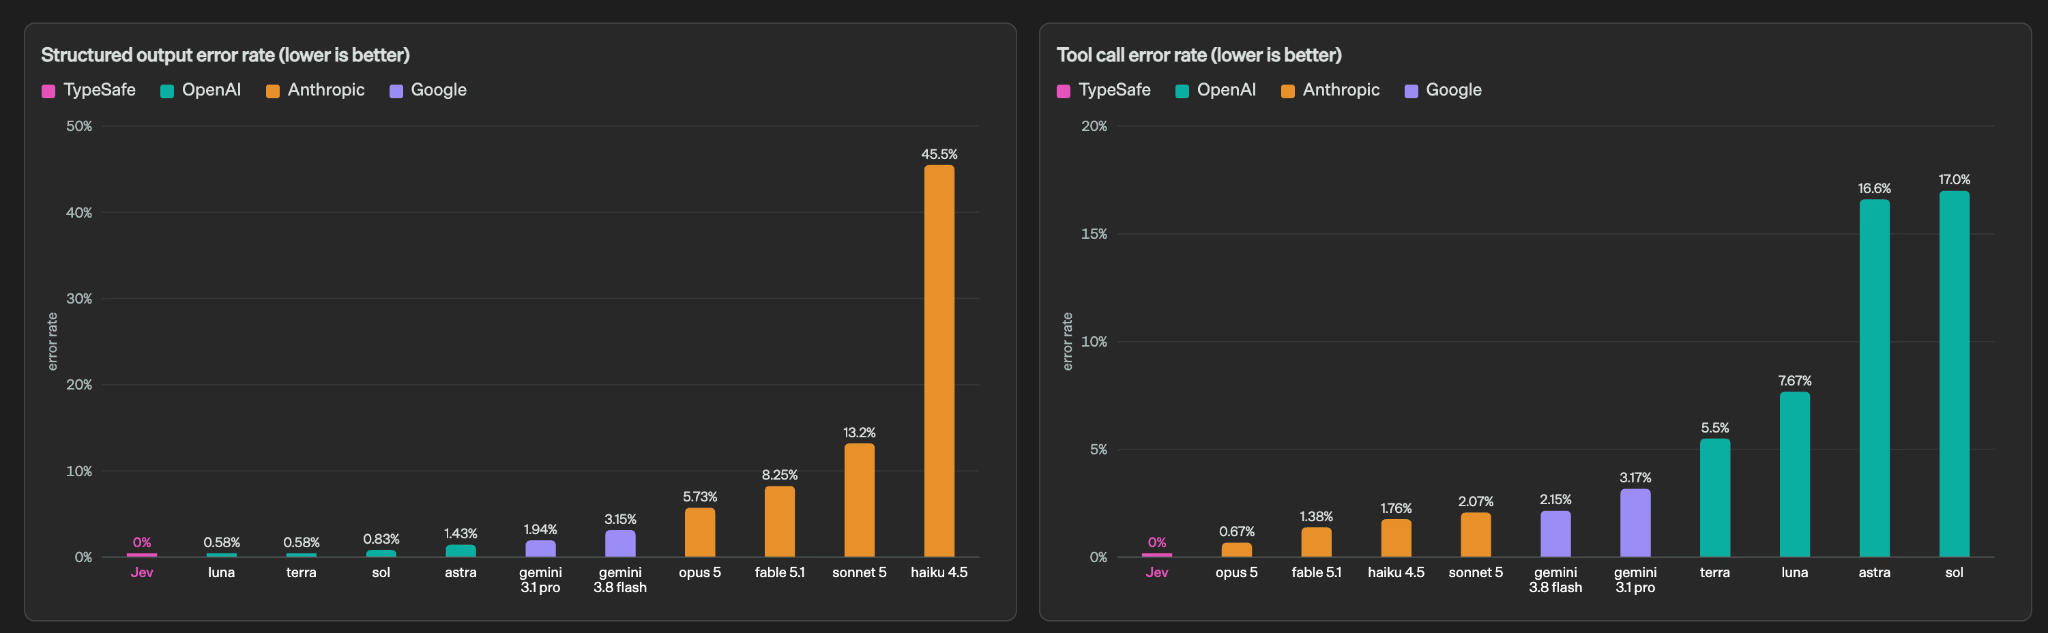
Đây là lý do tại sao sự phân chia này hoạt động. Một mô hình ngôn ngữ linh hoạt vì nó có thể phát ra bất cứ thứ gì, và chính sự tự do đó làm cho nó khó tích hợp sâu vào một quy trình làm việc mà bạn phụ thuộc vào. Định hình của TypeSafe là Jev "từ bỏ việc tạo chuỗi" và đổi lại có được một hợp đồng hẹp: tập hợp các câu trả lời có thể có được cố định trước khi yêu cầu rời máy chủ của bạn, mọi kết quả đều phù hợp với hình dạng đã khai báo, và sự không chắc chắn là một con số mà bạn có thể so sánh với một ngưỡng.
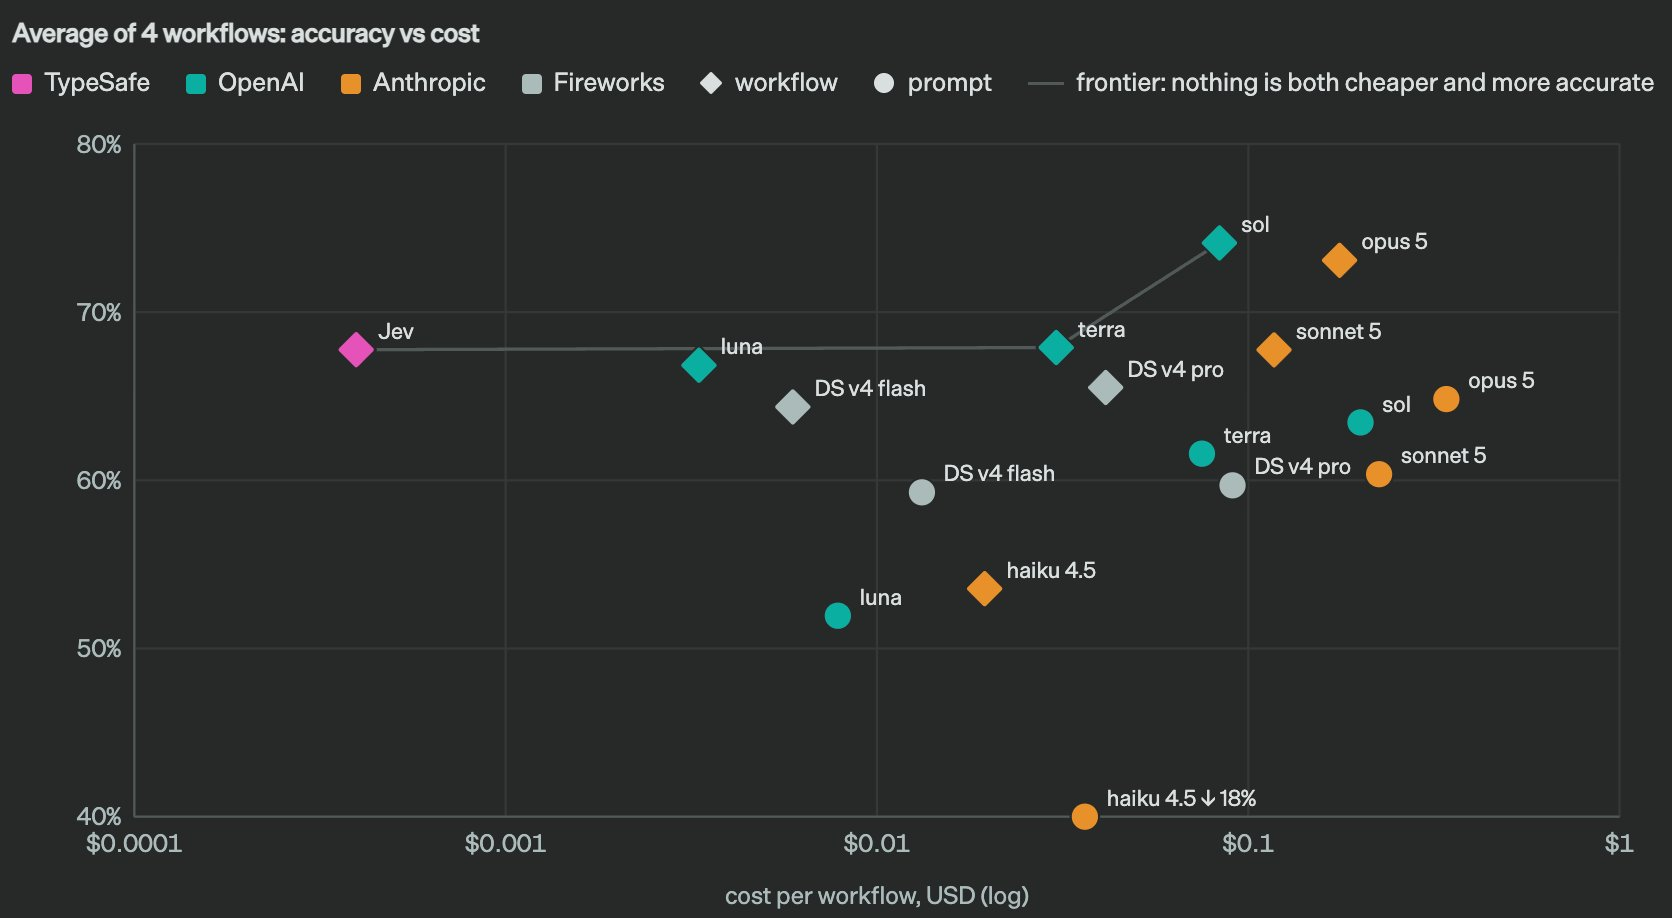
Phía chi phí cũng theo nguyên tắc tương tự. TypeSafe báo cáo thời gian phản hồi từ đầu đến cuối là 70ms đến 500ms, và tuyên bố các con số nhanh hơn 193,6 lần và rẻ hơn 444,6 lần trên các quy trình làm việc mà họ đã kiểm tra. Hãy xem đó là số liệu của nhà cung cấp, không phải các tiêu chuẩn độc lập. Điểm cấu trúc vẫn tồn tại theo cả hai cách: mô hình đắt tiền chỉ chạy khi thực sự có gì đó cần được viết, và các phán đoán lặp lại xung quanh nó được thực hiện ở nơi rẻ hơn.
Thiết kế các câu hỏi mà Jev có thể trả lời
Mọi yêu cầu đều mang một `state` chung và một tập hợp các câu hỏi độc lập. Jev đọc trạng thái một lần và trả lời tất cả. Một cuộc gọi phân loại hỗ trợ trông như thế này:
{
  "model": "jev-latest",
  "state": {
    "message": "I've been trying to connect Stripe for three days. I'm losing sales and I need this fixed today.",
    "plan": "Pro",
    "account_age_months": 14,
    "recent_technical_tickets": 3
  },
  "questions": {
    "department": {
      "type": "choice",
      "instruction": "Which team should own this ticket?",
      "criteria": {
        "billing": "Payments, charges, invoices, subscription changes",
        "technical": "Bugs, broken behavior, failing integrations",
        "sales": "Pricing, plans, questions asked before purchase"
      }
    },
    "frustration": {
      "type": "score",
      "instruction": "How frustrated is this customer?",
      "criteria": [
        "Calm and matter of fact",
        "Frustrated but civil",
        "Extremely frustrated or threatening to leave"
      ]
    },
    "urgent": {
      "type": "noul",
      "instruction": "The customer needs a resolution today."
    }
  }
}
Ba thói quen phân biệt các câu hỏi hiệu quả với các câu hỏi không rõ ràng.
Ngừng viết lời nhắc. Persona, ví dụ đã thực hiện và lời giới thiệu dài dòng định hướng một trình tạo văn bản. Jev không tạo ra văn bản. Nó cần trạng thái, một câu hỏi nguyên tử và mô tả chính xác ý nghĩa của từng câu trả lời. Các tiêu chí mô tả chi tiết tốt hơn các nhãn đơn thuần: “Thanh toán, phí, hóa đơn, thay đổi gói đăng ký” định tuyến tốt hơn từ “thanh toán” riêng lẻ. Đừng yêu cầu nó tự giải thích, vì phản hồi chỉ chứa một quyết định, xác suất và độ tin cậy, và không gì khác.
Một câu hỏi, một phán đoán. “Khách hàng tiềm năng này có giá trị, khẩn cấp và có khả năng mua hàng không?” là ba câu hỏi đội lốt một. Hãy tách chúng ra và kết hợp kết quả trong mã, nơi bạn có thể thấy các trọng số và thay đổi chúng.
Giữ các phép toán số học ra khỏi mô hình. Jev đánh giá ý nghĩa. Chương trình của bạn thực hiện phép toán, áp dụng bảng chiết khấu và kiểm tra các điều khoản hợp đồng. Sự phân chia đó là điều làm cho toàn bộ quá trình có thể kiểm toán được.
TypeSafe cũng cung cấp một kỹ năng bổ trợ dạy các tác nhân mã hóa những quy ước này, có thể cài đặt trong Claude Code bằng `claude plugin marketplace add typesafe-ai/skills` hoặc ở nơi khác bằng `npx skills add typesafe-ai/skills`. Trang kỹ năng tác nhân có chi tiết.
Giữ trạng thái sạch
Trạng thái liên quan quan trọng hơn trạng thái tối đa. Ba phần thường bao gồm: đối tượng đang được đánh giá, ngữ cảnh cần thiết để đọc đối tượng đó và các sự kiện sẽ thay đổi quyết định nếu chúng thay đổi. Mọi thứ khác chỉ là nhiễu bạn phải trả tiền để gửi.
Loại bỏ các dòng nhật ký trùng lặp, lịch sử trước vấn đề hiện tại và bất kỳ câu nào nêu lên kết luận bạn hy vọng mô hình sẽ đạt được. Giới hạn cứng là 64k token cho mỗi yêu cầu, với 32k khả dụng cho trạng thái cộng với câu hỏi dài nhất, nhưng độ chính xác có thể thay đổi đáng kể trước khi bạn đạt đến giới hạn đó. Khi định tuyến trở nên mơ hồ, việc thu hẹp trạng thái thường là một cách khắc phục nhanh hơn là viết lại tiêu chí.
Các câu hỏi song song và ngưỡng tin cậy
Vì Jev đọc trạng thái một lần, câu hỏi thứ mười ba tốn ít chi phí hơn nhiều so với việc thực hiện một chuyến đi khứ hồi thứ hai. Gửi mọi phán đoán độc lập có thể thay đổi một hành động: ý định, rủi ro, mức độ khẩn cấp, cảm xúc, mức độ liên quan, bước tiếp theo cần thiết. Sau đó loại bỏ bất kỳ câu hỏi nào mà câu trả lời của nó không bao giờ thay đổi điều mã của bạn thực hiện. Một tín hiệu không được sử dụng là một chi phí bảo trì không mang lại lợi ích.
Ghép nguyên hàm với hình dạng của phán đoán. Các cấp độ như mức độ nghiêm trọng, chất lượng và sự phù hợp thuộc về `score`, không phải là câu hỏi có/không ép buộc. Một tuyên bố thực tế duy nhất thuộc về `noul`. Một tập hợp các điểm đến cố định thuộc về `choice`.
Ngưỡng là nơi kiến trúc thực sự hoạt động. Một câu trả lời đã được định kiểu vẫn có thể là một câu trả lời sai, vì vậy độ tin cậy quyết định điều gì sẽ xảy ra tiếp theo. Một mẫu bắt đầu có thể áp dụng: tự động hành động trên 0,85, chuyển 0,55 đến 0,85 cho một mô hình mạnh hơn hoặc một lần xử lý thứ hai, và xếp hàng bất cứ thứ gì dưới 0,55 cho một người. Những con số chính xác đó chỉ mang tính minh họa. Mô hình định tuyến độ tin cậy của TypeSafe đặt một ngưỡng riêng cho mỗi hành động dựa trên chi phí của việc sai sót, và trang độ tin cậy của họ khuyên bạn "kiểm tra với dữ liệu của riêng bạn và điều chỉnh khi bạn quan sát kết quả." Khi các ngưỡng của bạn đã được điều chỉnh, hãy ghim mô hình: `jev-latest` theo bản phát hành ổn định mới nhất, trong khi `jev-1.13.0` đóng băng hành vi bạn đã đo lường.
Kiểm tra lớp quyết định trong Apidog
Một lớp quyết định chỉ đáng tin cậy nếu bạn có thể chứng minh cách nó hoạt động. Điều đó có nghĩa là các yêu cầu và khẳng định đã lưu, không phải lịch sử dòng lệnh của các lệnh curl một lần. Apidog cung cấp cả hai, và các khẳng định trông khác với các kiểm thử API thông thường vì bạn đang kiểm tra số và giá trị enum thay vì chuỗi.
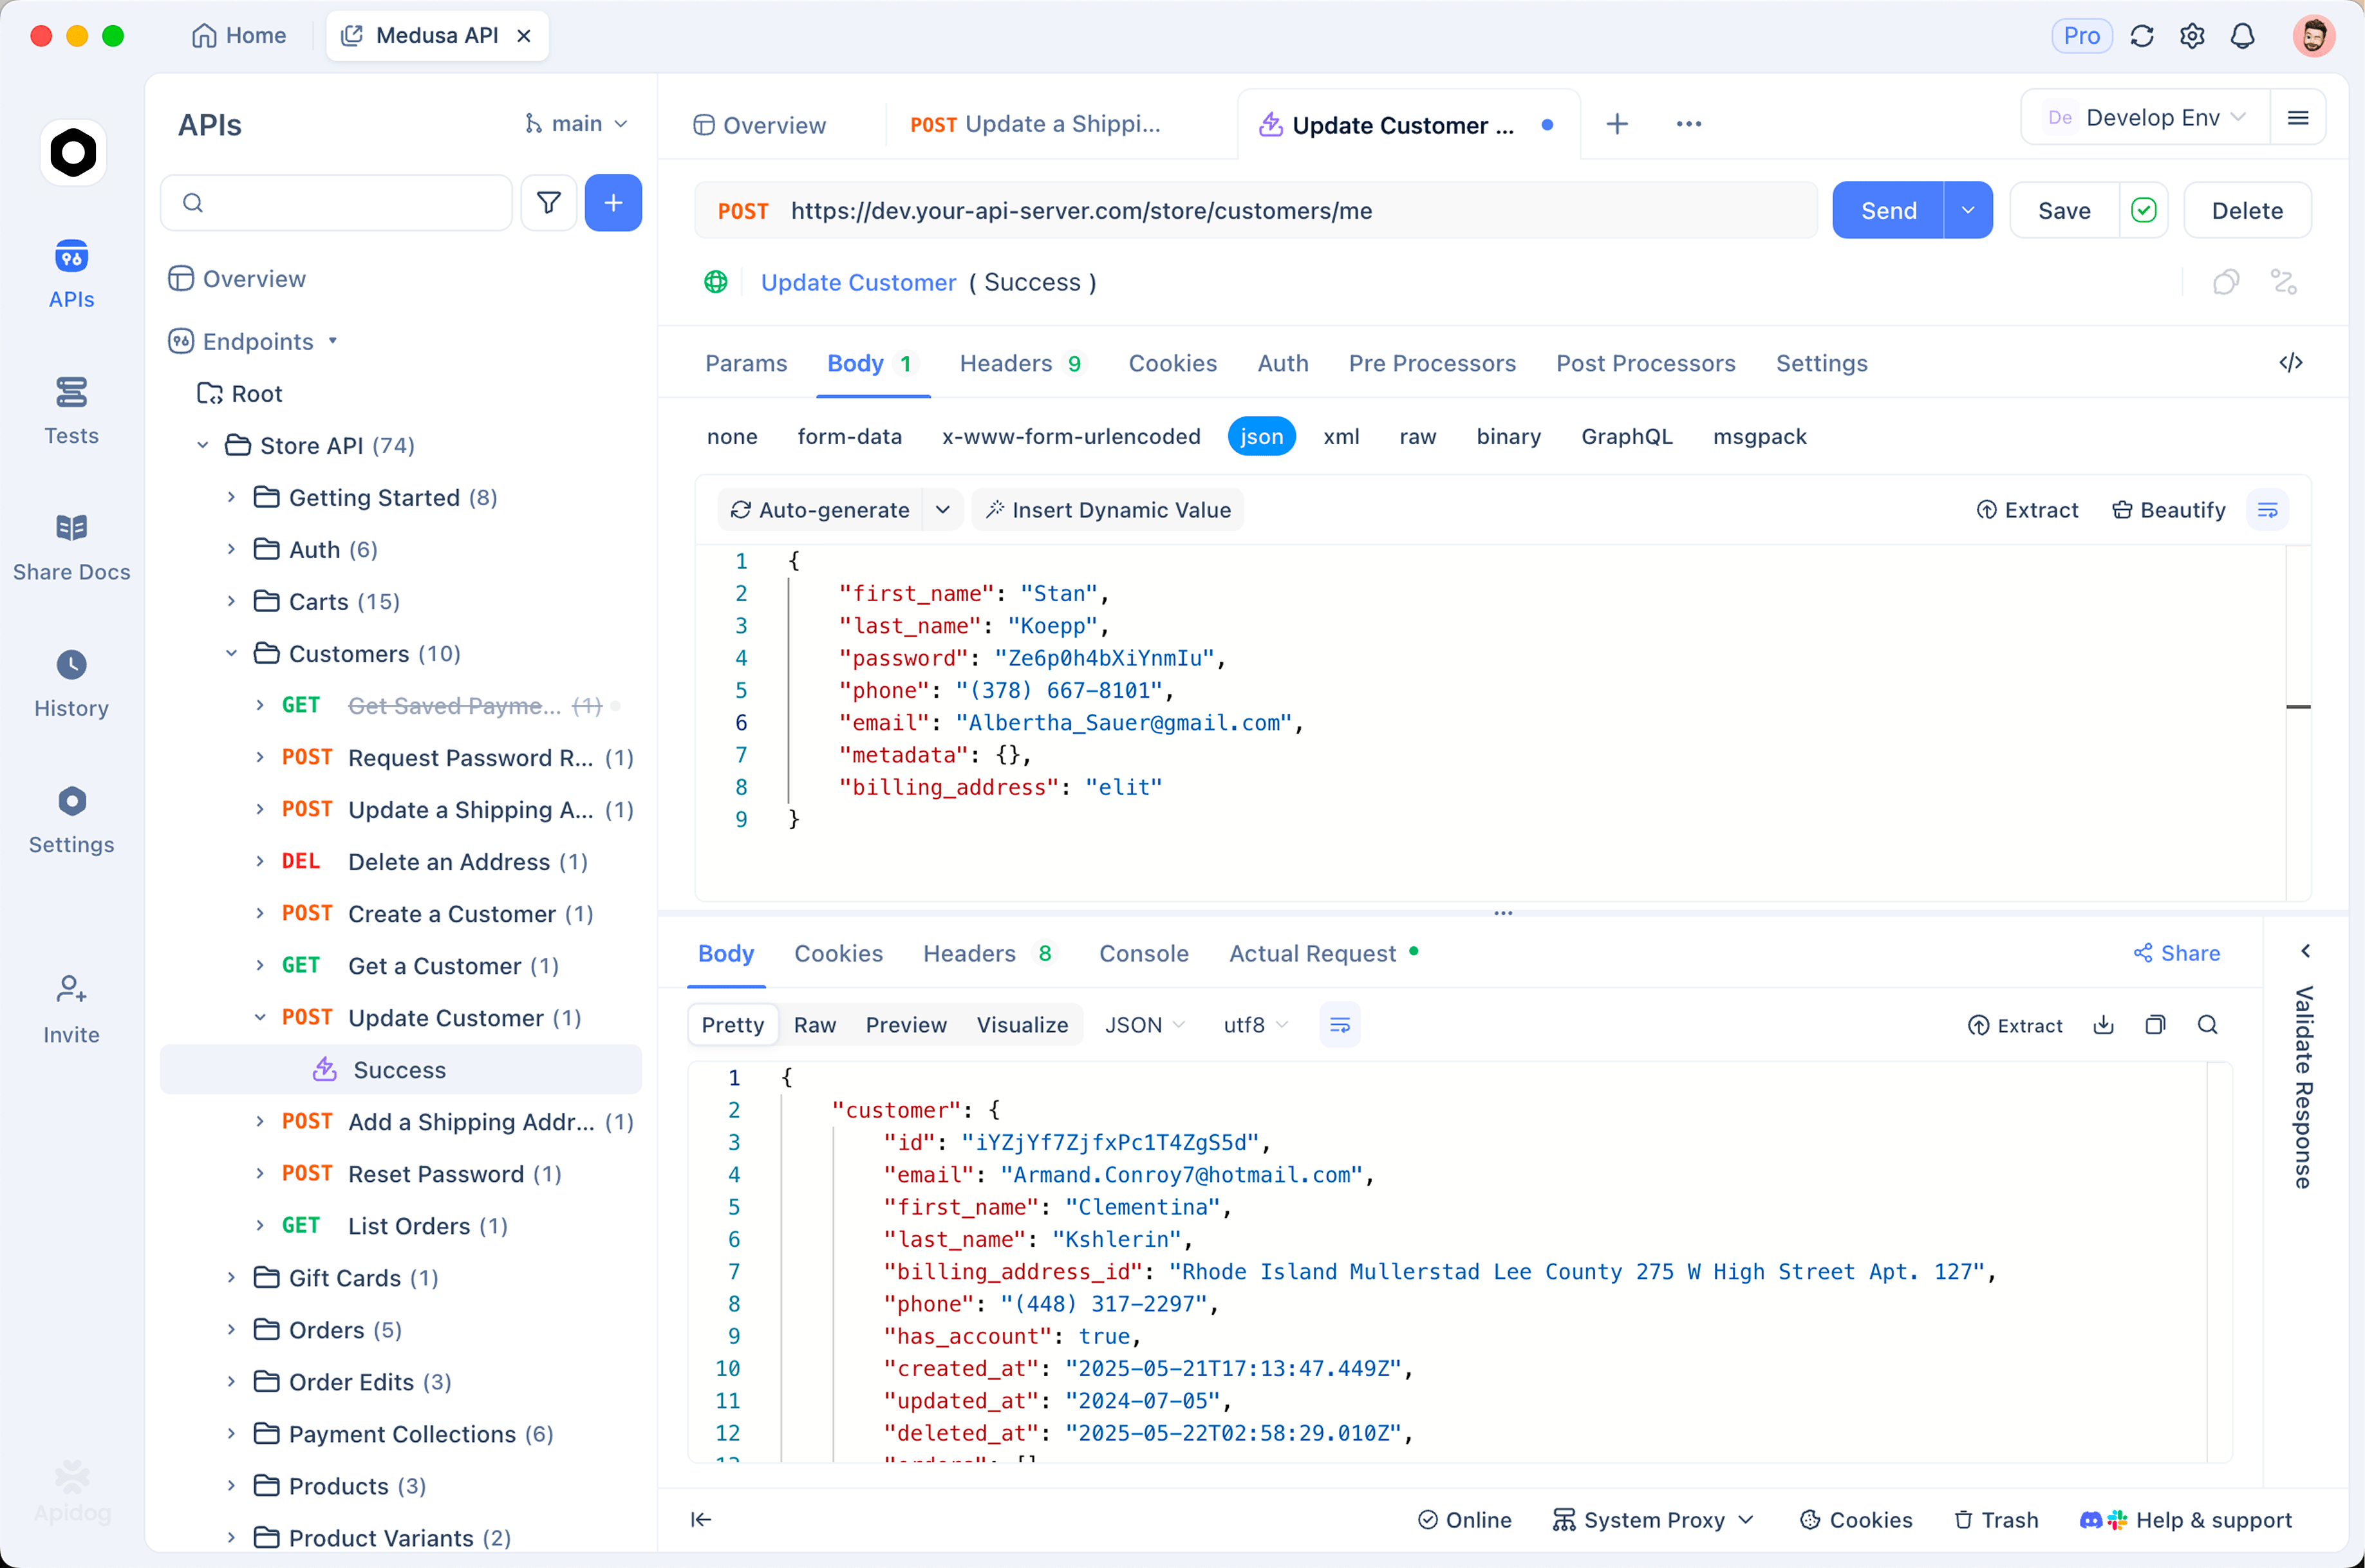
Lưu khóa dưới dạng biến môi trường. Tạo một môi trường tên `TypeSafe`, thêm `TYPESAFE_API_KEY` làm giá trị cục bộ để nó ở lại trên máy của bạn và tham chiếu nó dưới dạng `{{TYPESAFE_API_KEY}}` trong một token Bearer. Hướng dẫn của chúng tôi về môi trường và biến bí mật bao gồm các quy tắc phạm vi.
Gửi cuộc gọi thực tế. `POST https://api.typesafe.ai/v1/systemone` với phần thân chứa trạng thái cộng với các câu hỏi như trên.
Khẳng định về quyết định. Thêm các khẳng định hậu xử lý như `answers.department.choice` bằng `billing`, `answers.urgent.noul` lớn hơn `0.9`, và `answers.frustration.score` lớn hơn `1.5`. Bây giờ, một thay đổi hành vi sẽ làm thất bại một kiểm thử thay vì âm thầm định tuyến sai các yêu cầu.
Sau đó xây dựng kịch bản quan trọng. Lưu một tập hợp nhỏ các trạng thái được gán nhãn làm kịch bản kiểm thử: một câu hỏi bình tĩnh, một lời đe dọa hủy bỏ đầy giận dữ, và một thông điệp cố ý mơ hồ mà một bộ định tuyến tốt nên do dự. Khẳng định độ tin cậy cao trên hai cái đầu tiên và khẳng định rằng độ tin cậy giảm xuống dưới ngưỡng của bạn trên cái thứ ba. Kịch bản đơn lẻ đó biến việc tinh chỉnh ngưỡng thành bằng chứng thay vì phỏng đoán, và nó bắt lỗi khó nhận thấy nhất bằng tay: ai đó diễn đạt lại mô tả tiêu chí, mọi phản hồi vẫn hợp lệ, và định tuyến âm thầm thay đổi. Chạy nó trong CI và việc viết lại làm thất bại bản dựng.
Giả lập hình dạng phản hồi để công việc frontend không tiêu tốn token. Vì đối tượng `answers` được khai báo trước yêu cầu, phản hồi giả lập và phản hồi trực tiếp không thể khác biệt. Tải Apidog để thiết lập điều này; gói miễn phí bao gồm một đội bốn người.
Năm quy trình làm việc mà lớp quyết định tự chứng minh giá trị của nó
- Trình xác minh phổ quát. Bọc mọi cuộc gọi LLM đắt đỏ. Kiểm tra lời nhắc đầu vào để phát hiện injection, công cụ được chọn để phát hiện các sự không khớp rõ ràng, đầu ra cho các yêu cầu bị thiếu, và câu trả lời cuối cùng cho các tuyên bố mà tài liệu gốc không hỗ trợ. Các kiểm tra rẻ tiền xung quanh một bộ não đắt tiền.
- Tháp điều khiển hỗ trợ. Phân loại yêu cầu, phát hiện mức độ khẩn cấp, sự thất vọng, ý định hoàn tiền và rủi ro hủy bỏ trong một cuộc gọi, sau đó định tuyến. Lợi ích là ít yêu cầu hơn trong hàng đợi sai và ít tài khoản giá trị bị bỏ quên.
- Đánh giá chất lượng khách hàng tiềm năng. Chấm điểm mức độ phù hợp với công ty, độ trưởng thành kỹ thuật, vấn đề đã nêu, ý định mua hàng và mức độ khẩn cấp dưới dạng các tín hiệu riêng biệt, sau đó kết hợp chúng với các trọng số bạn sở hữu và có thể bảo vệ trong một cuộc xem xét quy trình.
- Bộ định tuyến mô hình. Quyết định cho mỗi yêu cầu liệu mã xác định, một mô hình nhỏ, một mô hình tiên tiến hay một con người nên xử lý nó. Đây thường là nơi tiết kiệm chi phí xuất hiện đầu tiên.
- Công việc với tập dữ liệu lớn. Chạy các phán đoán ngữ nghĩa tương tự trên nhật ký hỗ trợ, đánh giá, danh sách, bản ghi hoặc dấu vết tác nhân để trích xuất các tính năng có cấu trúc và xếp hạng các bản ghi đáng để con người xem xét. Phân tích này chỉ trở nên khả thi khi mỗi quyết định nhanh chóng và gần như miễn phí.
Câu hỏi thường gặp
Tôi vẫn cần một mô hình ngôn ngữ chứ? Có. Jev không thể viết phản hồi, tóm tắt hoặc mã. Nó quyết định hệ thống nào nên làm, và nó có thể đánh giá bản nháp sau đó dựa trên các tiêu chí rõ ràng như tuân thủ chính sách hoặc liệu câu trả lời có chứa một lời hứa mà bạn không đưa ra hay không.
Điều này khác với chế độ JSON hoặc đầu ra có cấu trúc như thế nào? Đầu ra có cấu trúc giới hạn định dạng của mô hình văn bản; mô hình vẫn tạo ra token và vẫn có thể khẳng định điều gì đó sai trong một hình dạng hợp lệ. Jev trả về một phân phối xác suất trên một tập hợp các câu trả lời bạn đã định nghĩa, vì vậy sự không chắc chắn là một trường hạng nhất. Bài giải thích của chúng tôi về đầu ra có cấu trúc của OpenAI bao gồm khía cạnh còn lại của sự so sánh đó.
Làm thế nào để tôi có quyền truy cập? Jev đang trong giai đoạn truy cập sớm với danh sách chờ, vì vậy đây chưa phải là tự phục vụ. TypeSafe đưa các nhà phát triển ra khỏi danh sách theo đợt, và bạn đăng nhập tại console.typesafe.ai khi bạn được duyệt. Nó cũng có sẵn thông qua Vercel AI Gateway dưới dạng `typesafe-ai/jev` qua `experimental_evaluate` trong AI SDK 7, là chỉ dành cho SDK và không được công khai trên các điểm cuối tương thích với OpenAI. Hướng dẫn của chúng tôi về cách lấy khóa API Jev có chi tiết về yêu cầu và SDK.
Tôi có thể chạy một cái gì đó tương tự cục bộ không? Một số dự án tái tạo một phần ý tưởng với giải mã ràng buộc trên các trọng số mở. Chúng tôi đã so sánh chúng trong OpenJev và các lựa chọn thay thế Jev mã nguồn mở, bao gồm mức độ trung thực của mỗi cái đối với độ tin cậy đã hiệu chuẩn.
Điều này mang lại cho bạn
Jev không phải là mô hình thay thế các mô hình khác của bạn. Đó là lớp quyết định khi nào, ở đâu và liệu chúng có chạy hay không. Xây dựng nó theo cách đó: một trạng thái sạch, các câu hỏi nguyên tử với tiêu chí rõ ràng, đánh giá song song và một ngưỡng tin cậy trước mọi hành động. Sau đó chứng minh cổng hoạt động với một kịch bản đã lưu trong Apidog trước khi nó định tuyến một yêu cầu thực tế nào.