
Để dùng Firecrawl Local, hãy cài đặt bằng cargo install firecrawl-local, chạy firecrawl-local init để đăng ký nó làm MCP server trong Claude Code và Cursor, sau đó khởi động lại cả hai công cụ. Giờ đây agent của bạn có thể scrape, crawl và map các trang web ngay trên máy của mình. Với code, hãy chạy firecrawl-local serve và trỏ bất kỳ SDK Firecrawl nào tới http://localhost:3002.
Hướng dẫn này chỉ từng bước cách dùng Firecrawl Local, kèm theo kết quả thực tế từ lần chạy thử của chúng tôi ngày 19/11/2026 (Firecrawl Local 0.1.0 trên máy Mac arm64), cùng các prompt để đưa cho agent và một cách để agent đó kiểm thử API cục bộ bằng Apidog CLI.
Những gì bạn cần trước khi bắt đầu
Firecrawl Local là một binary Rust duy nhất từ kho Firecrawl. Trước khi cài đặt, hãy kiểm tra xem bạn đã có:
- Rust và trình biên dịch C. Tải Rust tại rustup.rs. Trên macOS chạy
xcode-select --install; trên Debian hoặc Ubuntu càibuild-essential. - Node.js 22 trở lên nếu bạn muốn dùng MCP server. Server này chạy gói npm
firecrawl-mcpthông quanpx. - Chrome hoặc Chromium (tùy chọn). Firecrawl Local dùng trình duyệt bạn đã có sẵn cho các trang cần JavaScript. Các trang tĩnh vẫn hoạt động mà không cần trình duyệt.
- Claude Code, Cursor hoặc một MCP client khác. Lệnh
initcũng hỗ trợ Claude Desktop, Windsurf, Gemini CLI và Codex.
Nếu bạn mới làm quen với Firecrawl, hãy đọc trước hướng dẫn scrape web với Firecrawl của chúng tôi rồi quay lại.
Bước 1: Cài đặt Firecrawl Local
Cài crate từ crates.io và xác nhận phiên bản:
cargo install firecrawl-local
firecrawl-local --version
# firecrawl-local 0.1.0
Cargo sẽ biên dịch từ mã nguồn. Trên máy Mac của chúng tôi, bản build release hoàn tất trong 6 phút 54 giây, và binary nằm tại ~/.cargo/bin/firecrawl-local. Hãy đảm bảo thư mục đó có trong PATH của bạn, hoặc ghi lại đường dẫn đầy đủ: bạn sẽ cần nó nếu thiết lập MCP thủ công.
Bước 2: Chạy lần scrape đầu tiên từ terminal
Trước khi kết nối bất cứ thứ gì vào agent, hãy kiểm tra xem việc lấy nội dung có hoạt động không:
FIRECRAWL_CLOUD=off firecrawl-local scrape https://example.com --markdown
Lệnh này in ra văn bản chính của trang dưới dạng markdown trong 1,2 giây. Bỏ --markdown thì bạn nhận được cùng dạng JSON mà Firecrawl API trả về. --format markdown,links cho phép chọn định dạng; các lựa chọn cục bộ là markdown, html, rawHtml và links.
Tiếp theo, một lệnh crawl ghi ra một file markdown cho mỗi trang:
FIRECRAWL_CLOUD=off firecrawl-local crawl https://docs.firecrawl.dev --limit 20 --out ./pages
Lệnh này tải 20 trang tài liệu Firecrawl trong 4,4 giây và lưu các file có tên như 0005-docs.firecrawl.dev_advanced-scraping-guide.md. Một số flag crawl hữu ích từ firecrawl-local crawl --help:
| Flag | Chức năng |
|---|---|
-l, --limit |
Số trang tối đa (mặc định 100) |
--max-depth |
Độ sâu theo liên kết tối đa |
--include, --exclude |
Regex đường dẫn để giữ lại hoặc bỏ qua, có thể lặp lại |
--entire-domain |
Theo liên kết ra ngoài đường dẫn bắt đầu |
-c, --concurrency |
Số trang tải cùng lúc |
--ignore-robots |
Bỏ qua robots.txt (mặc định vẫn được đọc) |
firecrawl-local map https://firecrawl.dev trả về mọi URL mà nó tìm thấy từ sitemap và trang bắt đầu, dưới dạng một dòng JSON.
Bước 3: Thêm Firecrawl Local vào Claude Code và Cursor bằng init
init sẽ tìm các công cụ AI trên máy bạn và thêm Firecrawl Local vào cấu hình MCP của từng công cụ. Hãy xem trước trước khi chạy:
firecrawl-local init --dry-run
Trên máy Mac của chúng tôi, nó liệt kê mọi công cụ mà nó sẽ tác động:
Firecrawl MCP server:
  Claude Code: would be added in ~/.claude.json
  Claude desktop: would be added in ~/Library/Application Support/Claude/claude_desktop_config.json
  Cursor: would be added in ~/.cursor/mcp.json
  Gemini CLI: would be added in ~/.gemini/settings.json
  Codex: would be added in ~/.codex/config.toml
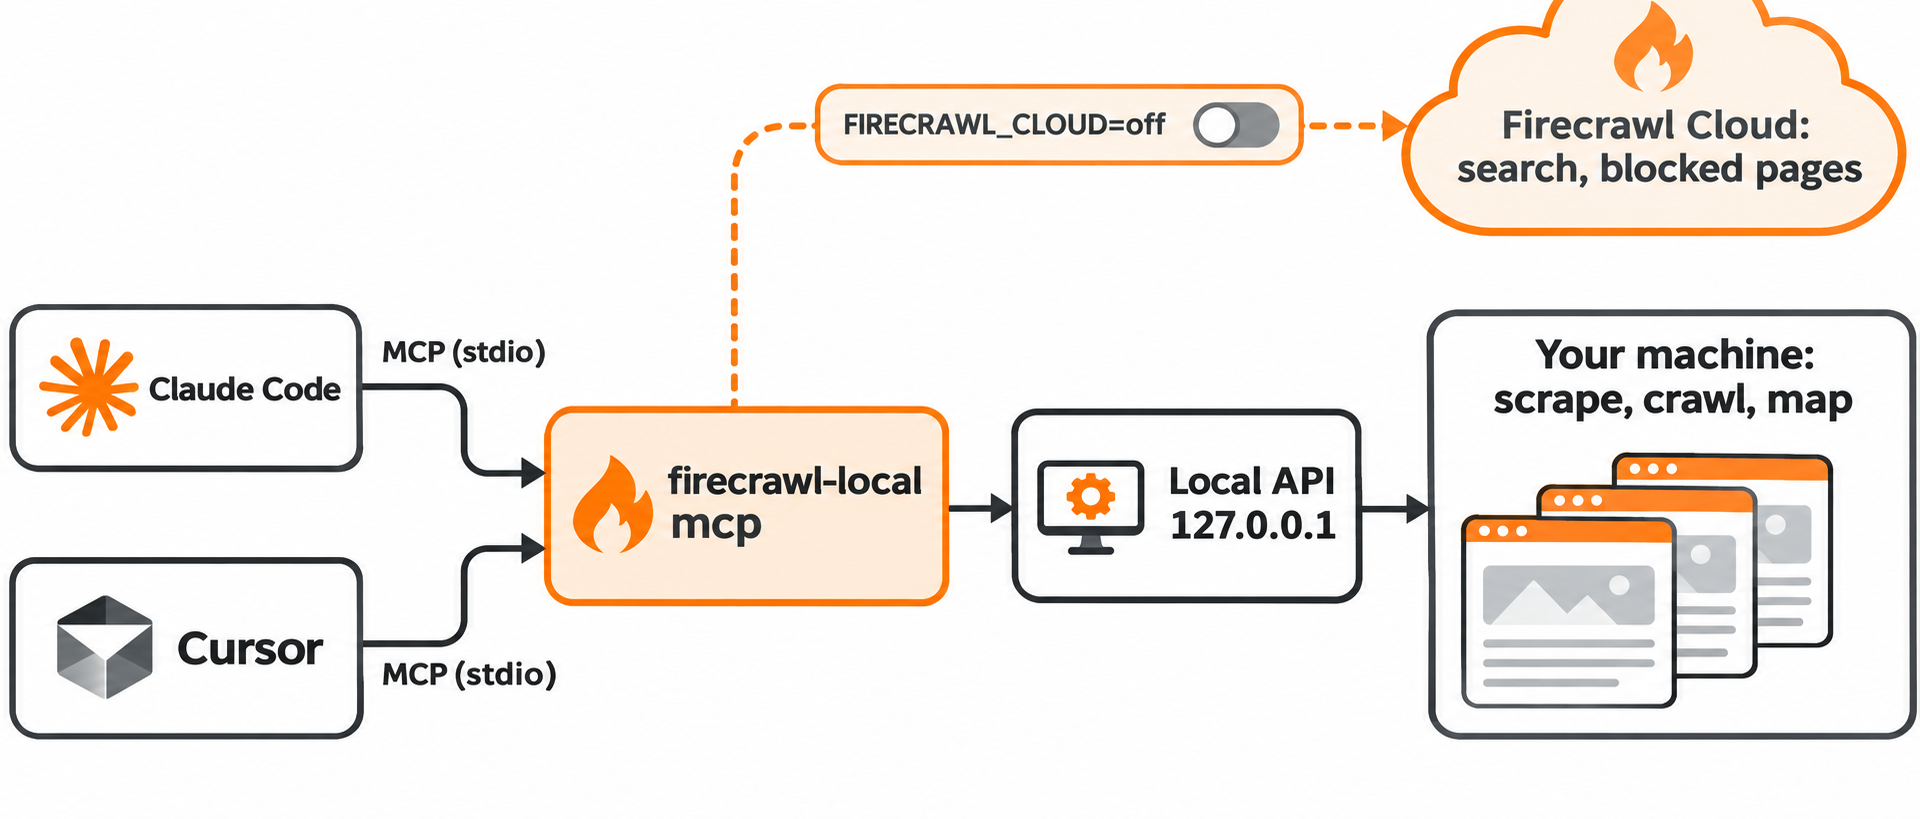
Lần chạy thử cũng in ra những gì sẽ được gửi tới Firecrawl Cloud: các truy vấn tìm kiếm, URL của trang đã chặn máy bạn, các lệnh gọi Alexandria một khi bạn đăng nhập, cùng một install ID ngẫu nhiên và tên công cụ AI của bạn. Những trang tải được cục bộ sẽ không bao giờ bị gửi đi.
Để chỉ thiết lập hai công cụ mà hướng dẫn này đề cập, hãy lặp lại --agent:
firecrawl-local init --agent claude-code --agent cursor
Các tên hợp lệ là claude-code, claude-desktop, cursor, windsurf, gemini và codex. init sẽ sao lưu từng file cấu hình trước khi ghi. Sau đó hãy khởi động lại Claude Code và Cursor để chúng nạp server mới.
Thiết lập Firecrawl Local trong Claude Code thủ công
Nếu bạn không muốn để một công cụ tự sửa cấu hình, hãy tự thêm stdio server bằng lệnh MCP của Claude Code:
claude mcp add firecrawl -e FIRECRAWL_CLOUD=off -- ~/.cargo/bin/firecrawl-local mcp --public-only
Chạy /mcp trong Claude Code để xác nhận server đã kết nối.
Thiết lập Firecrawl Local trong Cursor thủ công
Cursor đọc MCP server từ ~/.cursor/mcp.json (toàn cục) hoặc .cursor/mcp.json (một dự án). Hãy dùng đường dẫn đầy đủ tới binary:
{
  "mcpServers": {
    "firecrawl": {
      "command": "/Users/you/.cargo/bin/firecrawl-local",
      "args": ["mcp", "--public-only"],
      "env": { "FIRECRAWL_CLOUD": "off" }
    }
  }
}
--public-only khiến server từ chối các địa chỉ localhost và mạng riêng. Hãy luôn bật nó khi agent đọc những trang bạn không tin tưởng: nếu không, các chỉ dẫn ẩn trên một trang có thể dẫn dụ agent tới một URL nội bộ.
Bước 4: Các prompt để đưa cho agent
firecrawl-local mcp khởi chạy API cục bộ trên một cổng loopback và chạy gói firecrawl-mcp nhắm vào đó. Agent của bạn sẽ thấy các công cụ Firecrawl MCP tiêu chuẩn; scrape, crawl, map và batch scrape chạy trên máy bạn. Nếu bạn đã từng dùng Firecrawl MCP server được lưu trữ, thì tên các công cụ là như nhau.
Những prompt phù hợp với các công cụ cục bộ:
Map https://docs.example.com, then crawl only the /api/ pages (limit 40)
and write a summary of every endpoint into docs/vendor-api.md.
Scrape the changelog at https://example.com/changelog as markdown and list
every breaking change from the last three releases.
Batch scrape these five pricing pages and build a comparison table of
plan names and limits. Quote only what the pages say.
Hãy tránh các prompt cần tìm kiếm: với FIRECRAWL_CLOUD=off thì công cụ đó không đi đến đâu. Để có thiết lập tìm kiếm hoàn toàn cục bộ, hãy xem hướng dẫn tìm kiếm web mã nguồn mở cho Claude của chúng tôi.
Bước 5: Chạy API Firecrawl Local và trỏ SDK của bạn vào đó
Với script và pipeline, hãy chạy API server:
FIRECRAWL_CLOUD=off firecrawl-local serve
Nó lắng nghe tại 127.0.0.1:3002. Health check phản hồi ngay lập tức:
curl -s localhost:3002/health
# {"status":"ok","engine":"firecrawl-local","version":"0.1.0"}
Một lệnh scrape trả về cấu trúc v2 quen thuộc, với hai dấu hiệu cục bộ trong đó: "engine": "local-fetch" và "source": "local", cùng creditsUsed: 0.
curl -s localhost:3002/v2/scrape -H 'content-type: application/json' \
  -d '{"url":"https://example.com","formats":["markdown","links"]}'
Trỏ các SDK Firecrawl vào đó mà không cần API key. Python:
from firecrawl import Firecrawl

app = Firecrawl(api_url="http://localhost:3002")
print(app.scrape("https://example.com").markdown)
Node:
import { Firecrawl } from "firecrawl";

const app = new Firecrawl({ apiUrl: "http://localhost:3002" });
const doc = await app.scrape("https://example.com");
console.log(doc.markdown);
init cũng gợi ý một cách nhanh hơn: đặt FIRECRAWL_API_URL=http://127.0.0.1:3002 là code Firecrawl hiện có của bạn sẽ chạy cục bộ. Firecrawl CLI dùng chung thông tin đăng nhập đã lưu với Firecrawl Local, nên lệnh login của công cụ nào cũng có tác dụng cho cả hai.
Crawl là bất đồng bộ. POST /v2/crawl trả về ngay một job ID, và GET /v2/crawl/{id} báo status: completed, total: 10, creditsUsed: 0 và expiresInSeconds: 3587 vài giây sau đó. Các job sống trong bộ nhớ, hết hạn sau một giờ kể từ lúc bắt đầu và biến mất khi serve dừng, nên hãy lưu kết quả ngay khi crawl hoàn tất.
Tiến trình server chiếm khoảng 10 MB bộ nhớ thường trú khi rảnh và 43 MB ngay sau lần crawl 10 trang đó, đo bằng ps. bài đăng ra mắt của Firecrawl tuyên bố nhanh hơn 37 lần và dùng ít bộ nhớ hơn 230 lần so với Firecrawl tự lưu trữ; README không công bố phương pháp đo, nên hãy coi đó là số liệu của Firecrawl.
Giữ Firecrawl Local hoàn toàn cục bộ với FIRECRAWL_CLOUD
Mặc định (auto), có ba thứ được gửi tới Firecrawl Cloud: tìm kiếm, các trang chặn máy bạn, và các nhà cung cấp dữ liệu Alexandria (cần một tài khoản miễn phí qua firecrawl-local login). FIRECRAWL_CLOUD kiểm soát việc chuyển giao này:
| Giá trị | Tác dụng |
|---|---|
auto (mặc định) |
Tìm kiếm, dự phòng cho trang bị chặn và Alexandria đều hoạt động |
search |
Chỉ tìm kiếm được gửi tới Firecrawl Cloud |
off |
Không có gì được gửi tới Firecrawl Cloud |
Một giá trị không được nhận diện sẽ được coi là off. Khi tắt cloud, POST /v2/search trả về "code":"CLOUD_ONLY" kèm thông báo bảo bạn đặt FIRECRAWL_API_KEY hoặc FIRECRAWL_CLOUD=auto. Một trang mà cloud tải hộ bạn sẽ mang "source": "firecrawl-cloud", nên bạn luôn có thể biết kết quả đến từ đâu.
serve từ chối các địa chỉ localhost và mạng riêng trừ khi bạn truyền --allow-private, và bind một --host không phải loopback thì bắt buộc phải có --token. Các địa chỉ metadata cloud và link-local bị chặn trong mọi chế độ.
Để coding agent của bạn kiểm thử API Firecrawl Local bằng Apidog CLI
Endpoint crawl là thứ dễ làm hỏng pipeline nhất: nó bất đồng bộ, job hết hạn, và server dừng thì mất job. Thay vì tự polling thủ công, hãy để coding agent của bạn dựng và chạy một bài test bằng Apidog CLI.
Thiết lập một lần:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Sau đó đưa cho Claude Code hoặc Cursor một prompt:
firecrawl-local serve is running on http://localhost:3002. In Apidog project <id>,
import an OpenAPI file for POST /v2/scrape, POST /v2/crawl and GET /v2/crawl/{id},
create an environment for that base URL, and build a test scenario that starts a
crawl of https://docs.firecrawl.dev with limit 10, saves the returned id, polls
GET /v2/crawl/{id} until status is "completed", and asserts total equals completed
and every page has non-empty markdown. Run it and summarize any failures.
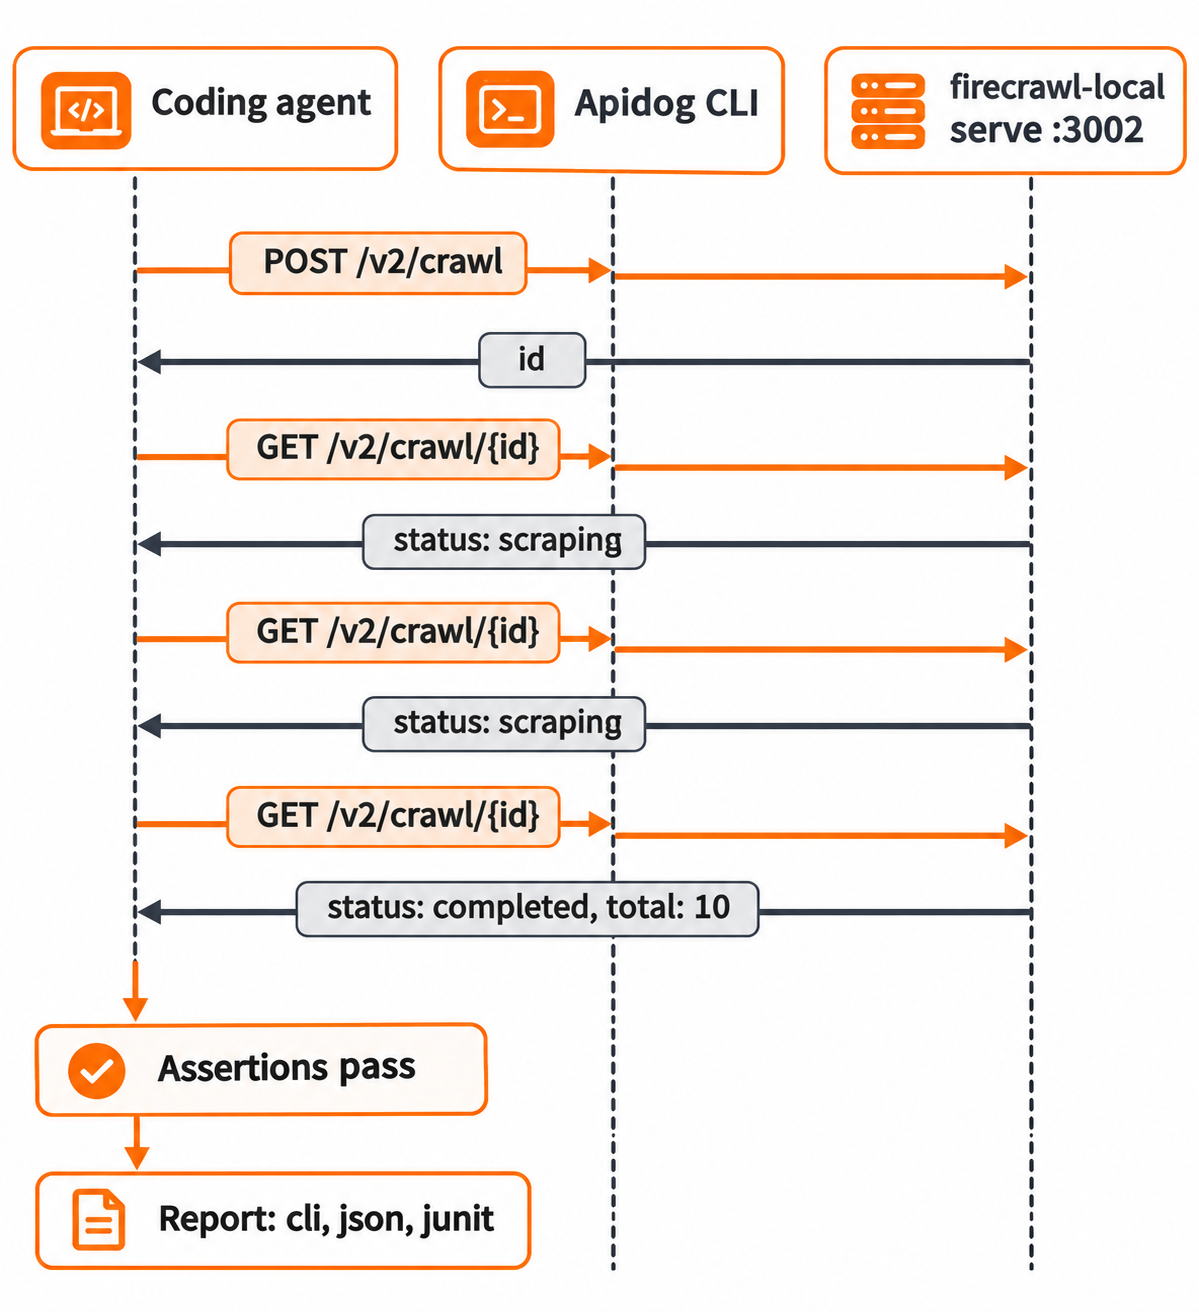
Agent đọc schema của từng payload, kiểm tra tính hợp lệ và chạy các lệnh như sau, tất cả đều lấy từ apidog <cmd> --help trong CLI 2.2.12:
apidog import --project <id> --format openapi --file ./firecrawl-local-v2.yaml
apidog environment create firecrawl-local --project <id> --base-url http://localhost:3002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file ./scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
Apidog CLI gửi request từ máy bạn, nên localhost:3002 là truy cập được. Chuyển sang -r junit để đưa cùng lần chạy đó vào CI; các hướng dẫn Apidog CLI trong Claude Code và Apidog CLI trong Cursor của chúng tôi đề cập phần phía agent. Gói Free của Apidog hỗ trợ đội nhóm tối đa 4 người dùng.
Khắc phục sự cố Firecrawl Local
| Triệu chứng | Cách khắc phục |
|---|---|
404 kèm NOT_FOUND trên /v1/scrape |
Chỉ phục vụ v2; hãy chuyển client của bạn sang /v2/... |
CLOUD_ONLY trên /v2/search |
Đúng như dự kiến khi FIRECRAWL_CLOUD=off; hãy dùng auto hoặc search |
| Agent không liệt kê các công cụ Firecrawl | Khởi động lại công cụ sau init; kiểm tra Node.js 22+ |
| Trang JavaScript trả về nội dung sơ sài | Cài Chrome, hoặc đặt --browser always |
Thiếu định dạng json hoặc summary |
Không được hỗ trợ cục bộ; bạn sẽ nhận được cảnh báo thay thế |
| Không tìm thấy Crawl ID | Job đã hết hạn sau một giờ hoặc serve đã khởi động lại |
Câu hỏi thường gặp
Firecrawl Local có miễn phí không? Scrape, crawl và map cục bộ không gửi gì tới Firecrawl và dùng 0 credit trong các lần kiểm thử của chúng tôi. Mã nguồn theo AGPL-3.0; các SDK theo MIT. Tìm kiếm và Alexandria đi qua Firecrawl Cloud.
Có cần API key để dùng Firecrawl Local không? Không, không cần cho các route cục bộ. Bạn chỉ cần key, qua firecrawl-local login hoặc FIRECRAWL_API_KEY, cho các nhà cung cấp dữ liệu Alexandria.
Firecrawl Local có hoạt động với Windsurf, Codex và Gemini CLI không? Có. init hỗ trợ windsurf, codex và gemini cũng như Claude Code, Claude Desktop và Cursor.
Code Firecrawl hiện có của tôi có thể chạy với nó mà không cần sửa gì không? Với v2 scrape, map, crawl và batch scrape, có: chỉ cần đổi API URL thành http://localhost:3002. Các route v0 và v1 không được phục vụ, và actions của trình duyệt bị bỏ qua.
Firecrawl Local có tuân thủ robots.txt không? Có. Nó đọc robots.txt khi crawl và tự nhận diện trong User-Agent, nên chủ trang web có thể nhắm tới nó với tên FirecrawlLocal. --ignore-robots tắt tính năng đó; chỉ dùng nó trên các trang web bạn sở hữu.