
DeepSeek-V4.1-Flash đã ra mắt chính thức (GA) trên API vào ngày 10 tháng 9 năm 2026, kèm theo hai yếu tố khiến khái niệm "miễn phí" trở thành một câu hỏi thực sự thay vì chỉ là một chiêu trò tiếp thị. Các trọng số (weights) được cấp phép MIT trên Hugging Face, vì vậy bản thân mô hình không tốn phí. Và API chính thức tính phí đầu vào (input) từ bộ nhớ đệm (cache-hit) là 0,003 đô la cho mỗi 1 triệu token vào giờ thấp điểm, đủ gần mức 0 đến nỗi ranh giới giữa miễn phí và gần như miễn phí không còn quan trọng đối với hầu hết các dự án nhỏ.
Hiện vẫn chưa có gói miễn phí vĩnh viễn (permanent free tier) trên DeepSeek API. Bất cứ ai nói với bạn điều ngược lại đang mô tả một chương trình khuyến mãi của bộ định tuyến (router promo) hoặc ứng dụng trò chuyện dành cho người dùng (consumer chat app). Hướng dẫn này xếp hạng mọi cách trung thực để sử dụng V4.1-Flash mà không phải trả tiền, sau đó trình bày các phép tính về lộ trình trả phí để bạn có thể quyết định xem liệu "gần như miễn phí" có đủ tốt hay không. Nếu bạn muốn tìm hiểu về kiến trúc trước, hãy đọc DeepSeek-V4.1-Flash là gì rồi quay lại đây.
Trước hết, một lưu ý. Một số cách sử dụng miễn phí chạy qua các điểm cuối (endpoints) của bên thứ ba, những điểm này có thể giới hạn tốc độ (rate-limit) của bạn và đôi khi tự động thay đổi mô hình mà không báo trước. Việc kiểm tra chúng bằng Apidog, ghi lại phản hồi và xác nhận trường mô hình (model field) sẽ giúp bạn không lãng phí hạn mức miễn phí vào việc gỡ lỗi của riêng mình. Quy trình làm việc đó sẽ được trình bày gần cuối.
Tóm tắt (TL;DR)
Xếp hạng từ "miễn phí hoàn toàn" đến "gần như miễn phí nhưng cần thẻ thanh toán":
- Ứng dụng trò chuyện DeepSeek tại chat.deepseek.com. Miễn phí, không cần thẻ. Tốt nhất để đánh giá chất lượng đầu ra thủ công.
- Các trọng số (weights) mã nguồn mở trên Hugging Face. Miễn phí theo giấy phép MIT, nhưng 552 tỷ tham số đồng nghĩa với việc chi phí nằm ở phần cứng.
- Các bộ định tuyến (routers) của bên thứ ba như OpenRouter. Các gói miễn phí có tồn tại cho một số mô hình vào một thời điểm nhất định, kèm theo giới hạn tốc độ và những đánh đổi về chính sách dữ liệu.
- Tín dụng dùng thử đi kèm trong các công cụ lập trình. Chỉ hữu ích khi công cụ đó đã tích hợp DeepSeek làm backend.
- API chính thức. Không miễn phí, nhưng một dự án cá nhân có thể chạy với chi phí khoảng 1,35 đô la mỗi tháng vào giờ thấp điểm.
Tùy chọn 1: Ứng dụng trò chuyện DeepSeek
Ứng dụng dành cho người dùng tại chat.deepseek.com là cách không gặp rào cản nào. Đăng ký bằng email hoặc số điện thoại, không cần thẻ, và bắt đầu nhập lời nhắc (prompt).
Có hai lưu ý. Thứ nhất, mô hình mà ứng dụng phục vụ sau bản phát hành hôm nay là [XÁC MINH]. Thông báo phát hành chỉ đề cập đến API, và ứng dụng trước đây thường chậm hơn API hoặc chạy một bản dựng được tinh chỉnh riêng. Thứ hai, ứng dụng là một giao diện trò chuyện, không phải API. Bạn không thể viết script, gửi hàng loạt lời nhắc hoặc tích hợp nó vào một sản phẩm.
Vì vậy, ứng dụng trả lời một câu hỏi: liệu V4.1-Flash có xử lý tốt lĩnh vực của bạn để biện minh cho việc tích hợp hay không? Hãy dán đầu vào mà người dùng của bạn gửi, bao gồm cả hình ảnh, vì mô hình này có khả năng đa phương thức tự nhiên (natively multimodal). Nếu các câu trả lời đạt yêu cầu, hãy chuyển sang một trong các cách dưới đây.
Tùy chọn 2: Các trọng số (weights) mã nguồn mở
DeepSeek đã công bố trọng số V4.1-Flash và báo cáo kỹ thuật theo giấy phép MIT. Bạn có thể tải xuống, chạy, tinh chỉnh và phát hành sản phẩm dựa trên chúng mà không cần trả tiền cho DeepSeek hoặc xin phép.
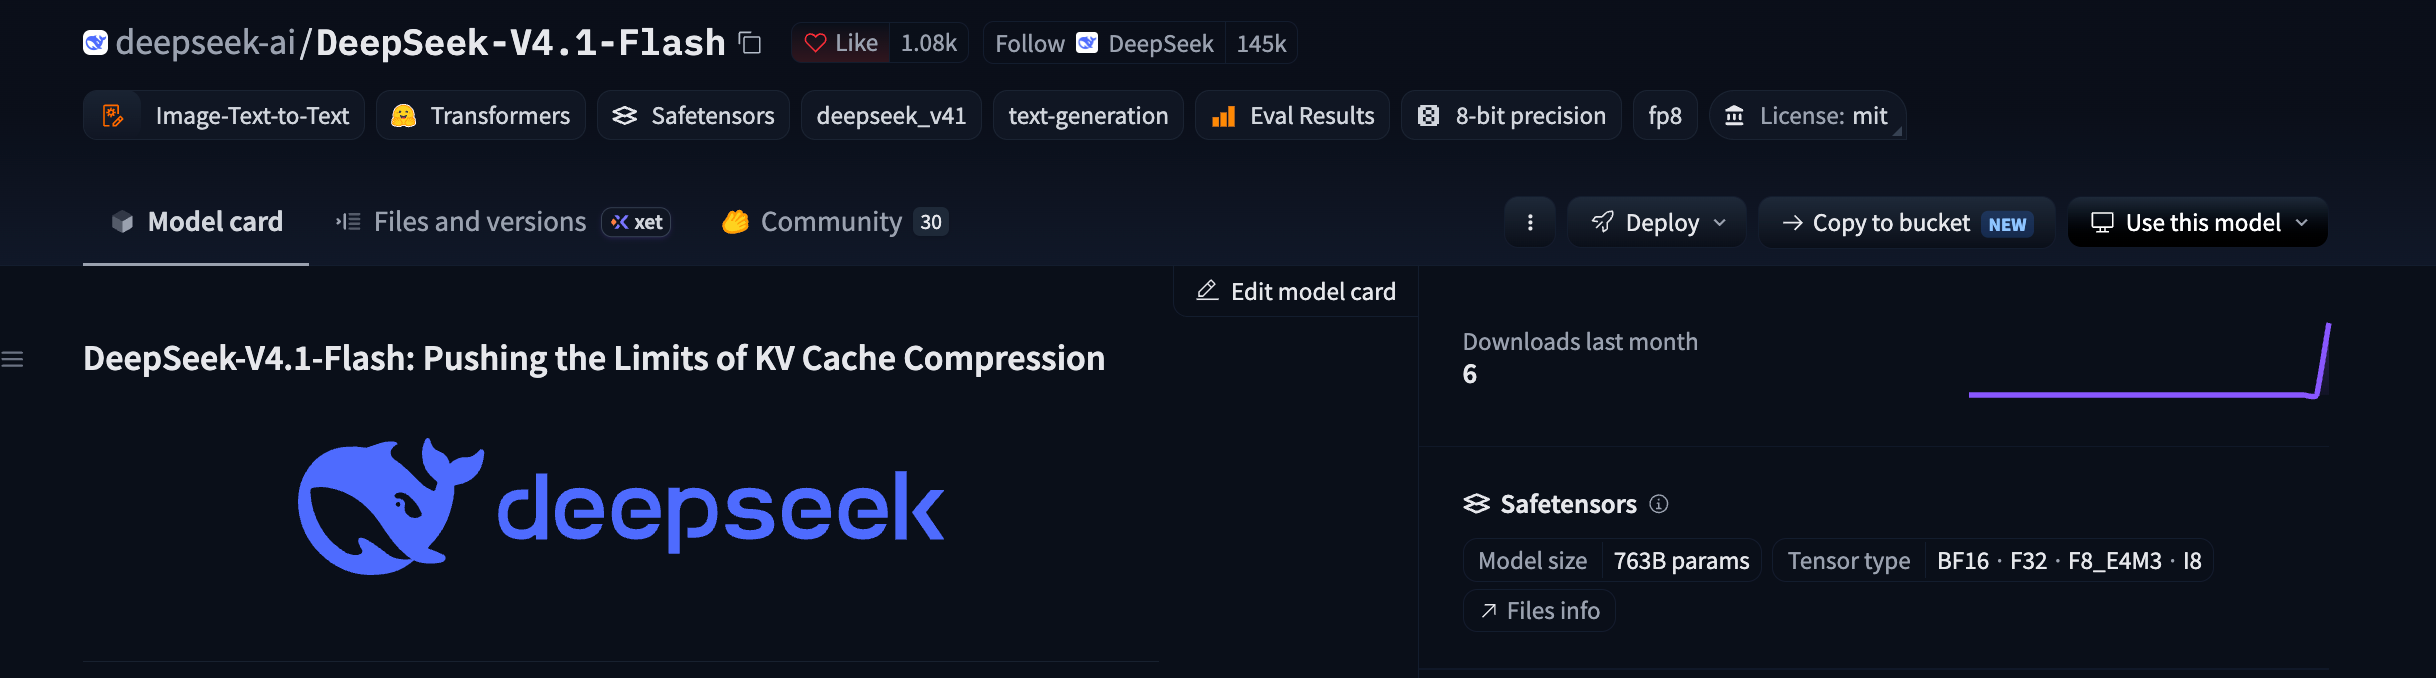
Vấn đề nằm ở kích thước. V4.1-Flash là một kiến trúc hỗn hợp chuyên gia (mixture-of-experts backbone) với 552 tỷ tham số (763 tỷ nếu tính cả bộ mã hóa thị giác - vision encoder). Chỉ 8 tỷ tham số hoạt động trong giai đoạn prefill và 16 tỷ trong giai đoạn decode, nhưng toàn bộ tập tham số vẫn phải được lưu trữ ở đâu đó. Ở chế độ 8-bit, riêng kiến trúc cơ bản đã cần khoảng 552 GB; ở chế độ 4-bit, khoảng 280 GB. Một GPU tiêu dùng thông thường không thể đáp ứng được. Tin tốt là bộ nhớ đệm KV (KV cache): với 890 byte cho mỗi token dưới chế độ bộ nhớ đệm FP4, một ngữ cảnh (context) đầy đủ 1 triệu token chỉ cần khoảng 0,9 GB.
"Miễn phí" ở đây có nghĩa là miễn phí giấy phép, không phải miễn phí để chạy. Hãy đọc cách chạy DeepSeek-V4.1-Flash cục bộ để biết các cấp độ phần cứng và các công cụ suy luận cần kiểm tra trước khi bạn tải xuống 280 GB. Nếu bạn đã có phần cứng, đây là lựa chọn miễn phí bền vững nhất trong bài: không giới hạn tốc độ, không chính sách dữ liệu, không thay đổi mô hình ngầm.
Tùy chọn 3: API chính thức không miễn phí, nhưng gần như vậy
Nền tảng DeepSeek hoạt động theo hình thức trả tiền theo mức sử dụng (pay-as-you-go). Bạn nạp tiền vào tài khoản, tạo một khóa (key), và được tính phí theo từng token. Không có gói miễn phí vĩnh viễn.
Điều khiến nó có mặt trên một trang "miễn phí" chính là giá cả. Dưới đây là bảng giá đầy đủ bằng USD từ trang giá chính thức, có hiệu lực từ 04:00 UTC ngày 10 tháng 9 năm 2026, tính trên mỗi 1 triệu token:
| Loại Token | deepseek-flash giờ thấp điểm | deepseek-flash giờ cao điểm |
|---|---|---|
| Input, cache hit | 0,003 đô la | 0,006 đô la |
| Input, cache miss | 0,15 đô la | 0,30 đô la |
| Output | 0,60 đô la | 1,20 đô la |
Giờ cao điểm là từ Thứ Hai đến Thứ Sáu, từ 01:00 đến 04:00 và từ 06:00 đến 10:00 UTC (09:00 đến 12:00 và 14:00 đến 18:00 giờ Bắc Kinh). Tất cả các thời điểm khác, bao gồm cuối tuần, là giờ thấp điểm với giá bằng một nửa. Bộ nhớ đệm ngữ cảnh (Context caching) là tự động, vì vậy các lời nhắc hệ thống lặp lại sẽ được truy xuất từ bộ nhớ đệm mà không cần thêm mã.
Bây giờ là phép tính. Giả sử một dự án nhỏ gửi 5 triệu token đầu vào mới (cache-miss) và tạo ra 1 triệu token đầu ra trong một tháng, tất cả đều vào giờ thấp điểm:
- 5 triệu token đầu vào cache-miss với giá 0,15 đô la cho mỗi 1 triệu token = 0,75 đô la
- 1 triệu token đầu ra với giá 0,60 đô la cho mỗi 1 triệu token = 0,60 đô la
- Tổng cộng: 1,35 đô la mỗi tháng
Nếu một phần đầu vào đó là một lời nhắc hệ thống lặp lại, chi phí sẽ giảm hơn nữa. 1 triệu token cache-hit vào giờ thấp điểm có giá 0,003 đô la, vì vậy một lời nhắc hệ thống dài 2.000 token được sử dụng lại trong 10.000 yêu cầu (20 triệu token được lưu vào bộ nhớ đệm) chỉ tốn thêm sáu xu. Hóa đơn sẽ chỉ là một khoản tiền nhỏ, và bạn sẽ nhận được chính xác mô hình bạn yêu cầu với giới hạn đồng thời 2.500 yêu cầu. Giải thích giá V4.1-Flash trình bày cách tính toán thay đổi theo cấu trúc lời nhắc.
Một lời gọi tối thiểu, với khối sử dụng được in ra để bạn có thể thấy sự phân chia bộ nhớ đệm:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["DEEPSEEK_API_KEY"],
    base_url="https://api.deepseek.com",
)

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[
        {"role": "system", "content": "You classify support tickets as billing, bug, or feature request."},
        {"role": "user", "content": "Customer says their August invoice shows two charges for one seat."},
    ],
)

print(response.choices[0].message.content)
print(response.usage)
Tùy chọn 4 và 5: Bộ định tuyến (routers), gói miễn phí và tín dụng đi kèm
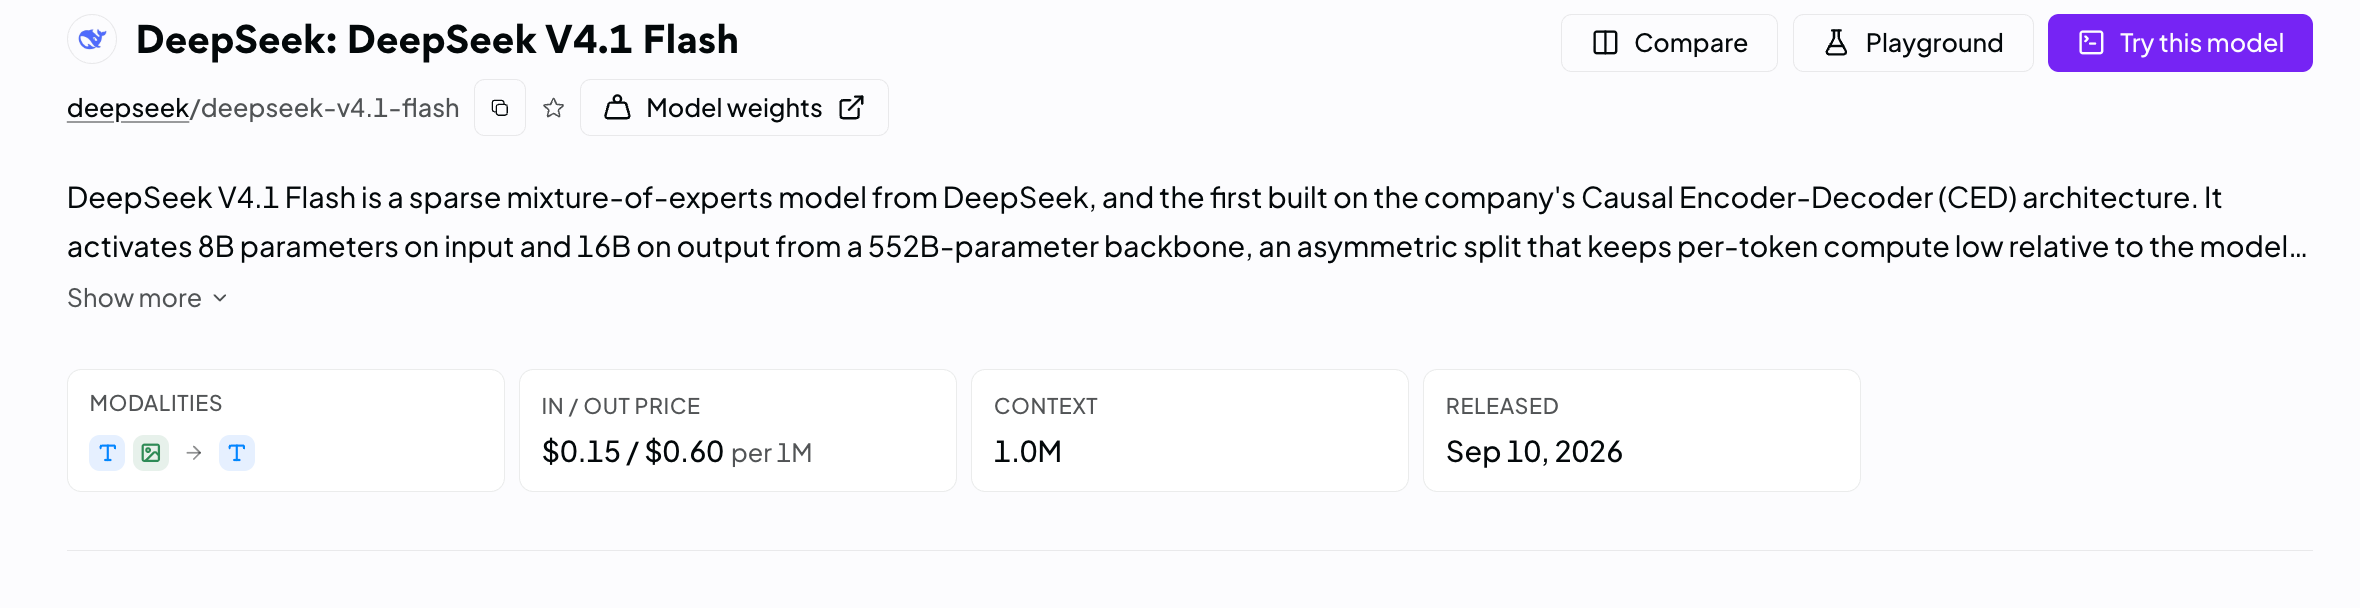
OpenRouter là nơi thường được tìm đến để tìm một điểm cuối miễn phí cho một mô hình mã nguồn mở mới. Các bộ định tuyến tổng hợp nhiều máy chủ (hosts) dưới một API tương thích OpenAI, và các máy chủ đôi khi chạy một gói miễn phí cho một mô hình để thu hút lưu lượng truy cập. Liệu V4.1-Flash có được liệt kê ở đó hôm nay hay không, và liệu có bất kỳ máy chủ nào cung cấp gói miễn phí cho nó hay không, là [XÁC MINH]; mô hình này mới ra mắt được vài giờ và danh sách thay đổi nhanh chóng.
Ba cảnh báo áp dụng cho mọi gói miễn phí của bộ định tuyến:
- Giới hạn tốc độ rất chặt chẽ. Giới hạn mỗi phút và mỗi ngày có nghĩa là một vòng lặp kiểm tra có thể làm cạn kiệt hạn mức một ngày chỉ trong một giờ.
- Chính sách dữ liệu khác nhau tùy theo máy chủ. Lưu lượng miễn phí thường là những gì máy chủ được phép ghi lại hoặc dùng để huấn luyện. Hãy đọc kỹ chính sách trước khi gửi bất kỳ thông tin riêng tư nào.
- Các gói miễn phí thay đổi hàng tuần. Miễn phí vào thứ Hai có thể trở thành trả phí vào thứ Sáu, hoặc được chuyển hướng đến một máy chủ khác. Đừng xây dựng một sự phụ thuộc sản xuất vào chúng.
Điều cần cảnh giác là việc thay thế mô hình một cách âm thầm: bạn yêu cầu V4.1-Flash nhưng một mô hình cũ hơn trả lời vì máy chủ miễn phí bị lỗi. Trường model trong phản hồi là tuyến phòng thủ đầu tiên của bạn, và quy trình làm việc dưới đây sẽ xác nhận về nó.
Một số công cụ lập trình, trong đó có Cursor và các tác nhân kiểu Codex (Codex-style agents), đi kèm với tín dụng dùng thử mà bạn có thể chi tiêu cho bất kỳ backend nào mà công cụ đó hỗ trợ. Nếu một công cụ bạn đang sử dụng liệt kê DeepSeek là một mô hình có thể chọn, thì những tín dụng đó là một cách hợp pháp để sử dụng miễn phí trong suốt thời gian dùng thử. Đừng đăng ký một công cụ chỉ để tiếp cận DeepSeek bằng cách này; số lượng tín dụng và các mô hình đủ điều kiện thay đổi quá thường xuyên để có thể ghi lại.
Tùy chọn nào phù hợp với tình huống của bạn
| Tùy chọn | Chi phí | Mô hình được đảm bảo? | Giới hạn tốc độ | Tốt nhất cho |
|---|---|---|---|---|
| Ứng dụng trò chuyện DeepSeek | Miễn phí | Tùy thuộc vào bản dựng ứng dụng | Giới hạn sử dụng ứng dụng | Đánh giá thủ công, kiểm tra nhanh |
| Trọng số mở (MIT) | Giấy phép miễn phí, phần cứng của bạn | Có, bạn tự chạy | Không | Quyền riêng tư, tinh chỉnh, GPU sở hữu |
| API chính thức | Khoảng 1,35 đô la/tháng ở quy mô dự án cá nhân | Có | 2.500 yêu cầu đồng thời | Bất kỳ sản phẩm nào bạn phát hành |
| Gói miễn phí của bộ định tuyến | Miễn phí trong thời gian có hiệu lực | Không, máy chủ có thể thay đổi | Giới hạn mỗi phút và mỗi ngày | Nguyên mẫu, so sánh |
| Tín dụng công cụ đi kèm | Miễn phí trong thời gian dùng thử | Tùy thuộc vào công cụ | Do công cụ định nghĩa | Lập trình trong công cụ đó |
Nếu bạn có kế hoạch phát hành sản phẩm, hãy chi tiền cho API chính thức. Nếu bạn đang đánh giá, hãy bắt đầu với ứng dụng trò chuyện. Nếu bạn có GPU, các trọng số (weights) sẽ vượt trội hơn mọi lựa chọn khác.
Kiểm tra các điểm cuối miễn phí trong Apidog mà không tốn hạn mức
Các cách miễn phí có hai chế độ lỗi: bạn đạt giới hạn tốc độ khi đang gỡ lỗi mã của mình, và bộ định tuyến đưa cho bạn một mô hình khác mà không báo trước. Cả hai đều có thể được ngăn chặn một cách rẻ tiền bằng Apidog, công cụ kiểm tra lớp API phía trước bất kỳ điểm cuối nào bạn chọn.
- Thêm điểm cuối một lần. Tạo
POST {{BASE_URL}}/chat/completionsvớiBearer {{API_KEY}}trong tiêu đề Authorization. Mọi tùy chọn ngoại trừ ứng dụng trò chuyện đều tuân theo cùng một định dạng tương thích OpenAI, vì vậy một yêu cầu đã lưu có thể dùng cho tất cả. - Tạo một môi trường cho mỗi nhà cung cấp. Một môi trường
officialđặtBASE_URLlàhttps://api.deepseek.comvới khóa DeepSeek của bạn; một môi trườngroutertrỏ đến máy chủ miễn phí. Việc chuyển đổi chỉ là chọn từ menu thả xuống. - Ghi lại phản hồi thực, sau đó mô phỏng chúng. Gửi một vài lời nhắc tiêu biểu qua điểm cuối miễn phí, lưu các phản hồi và phục vụ chúng từ máy chủ mô phỏng của Apidog. Trong khi bạn xây dựng phân tích cú pháp, thử lại và giao diện người dùng, ứng dụng của bạn sẽ gọi đến bản mô phỏng và hạn mức miễn phí vẫn không bị ảnh hưởng.
- Xác nhận trường mô hình. Lưu yêu cầu dưới dạng một trường hợp kiểm thử, khẳng định rằng trường
modeltrong phản hồi chứa chuỗi mà máy chủ trả về cho V4.1-Flash. Chạy nó khi bắt đầu mỗi phiên, và một mô hình bị thay đổi sẽ làm kiểm thử thất bại trước khi bạn dành hàng giờ để tìm kiếm một "hồi quy" (regression) trong các lời nhắc của mình. - Xác nhận khối sử dụng. Kiểm tra xem
usage.prompt_tokensvàusage.completion_tokenscó lớn hơn 0 hay không, và đọc số lượt cache-hit trên API chính thức từ cùng khối đó. Sau một tuần, bạn sẽ biết gói miễn phí đã tiết kiệm cho bạn bao nhiêu và liệu các lời nhắc của bạn có được lưu vào bộ nhớ đệm tốt như bạn nghĩ hay không.
Tải xuống Apidog và vòng lặp chỉ mất dưới mười phút. Khi các xác nhận đã tồn tại, apidog-cli sẽ chạy chúng trong CI để một thay đổi bộ định tuyến làm hỏng bản dựng thay vì một bản demo.
Câu hỏi thường gặp
DeepSeek-V4.1-Flash có miễn phí sử dụng không? Mô hình được cấp phép miễn phí theo MIT và miễn phí sử dụng trong ứng dụng trò chuyện DeepSeek. API chính thức là trả tiền theo mức sử dụng mà không có gói miễn phí vĩnh viễn. DeepSeek có miễn phí không theo dõi cách phân chia đó đã được duy trì trên toàn bộ dòng mô hình.
DeepSeek API có bản dùng thử miễn phí không? Không có bản dùng thử cố định nào. Con đường có chi phí thấp nhất là sử dụng API chính thức vào giờ thấp điểm: 5 triệu token đầu vào cache-miss cộng với 1 triệu token đầu ra có giá 1,35 đô la.
Cách rẻ nhất để gọi V4.1-Flash qua API là gì? Gửi yêu cầu ngoài giờ cao điểm và cấu trúc lời nhắc sao cho các tiền tố (prefixes) được chia sẻ được truy xuất từ bộ nhớ đệm, vì một lượt truy xuất từ bộ nhớ đệm có chi phí thấp hơn 50 lần so với một lượt bỏ lỡ. Bộ nhớ đệm lời nhắc (prompt caching) là gì giải thích cách sắp xếp lời nhắc cho mục đích đó.
Tôi có thể chạy V4.1-Flash trên máy tính xách tay không? Không phải mô hình đầy đủ. 552 tỷ tham số tương đương khoảng 280 GB ở chế độ 4-bit chỉ riêng cho kiến trúc cơ bản. Hướng dẫn cục bộ được liên kết ở trên bao gồm những gì thực tế ở mỗi cấp độ phần cứng.
Phiên bản bộ định tuyến miễn phí có giống với mô hình của API chính thức không? Chỉ khi máy chủ tuyên bố như vậy và các kiểm thử của bạn xác nhận điều đó. Hãy xác nhận trường model và so sánh đầu ra trên một tập hợp lời nhắc cố định với điểm cuối chính thức. Các hướng dẫn về DeepSeek V4 miễn phí và API V4 miễn phí thực hiện cùng một kiểm tra cho thế hệ trước.
Kết luận
V4.1-Flash miễn phí theo hai cách quan trọng nhất: các trọng số (weights) theo giấy phép MIT và ứng dụng trò chuyện không tốn phí. Mọi thứ giữa hai thái cực đó là một gói miễn phí có thể thay đổi hoặc một API chính thức có giá đủ thấp để "miễn phí" không còn đáng để tối ưu hóa. Với 1,35 đô la mỗi tháng, con đường rẻ nhất thường là trả tiền.
Dù bạn chọn điểm cuối nào, hãy đặt Apidog phía trước nó: mô phỏng phản hồi khi bạn xây dựng, xác nhận trường mô hình, ghi lại mức sử dụng. Hạn mức miễn phí là một tài nguyên. Hãy dành nó cho mô hình, không phải cho các lỗi của riêng bạn.