DeepSeek đã phát hành các trọng số DeepSeek-V4.1-Flash trên Hugging Face theo giấy phép MIT vào ngày 10 tháng 9 năm 2026, cùng ngày mô hình này ra mắt chính thức (GA) trên API. Đây là một thời điểm bất thường. Hầu hết các phòng thí nghiệm thường triển khai điểm cuối được lưu trữ trước, sau đó mới phát hành trọng số vài tuần sau đó, hoặc thậm chí không bao giờ.
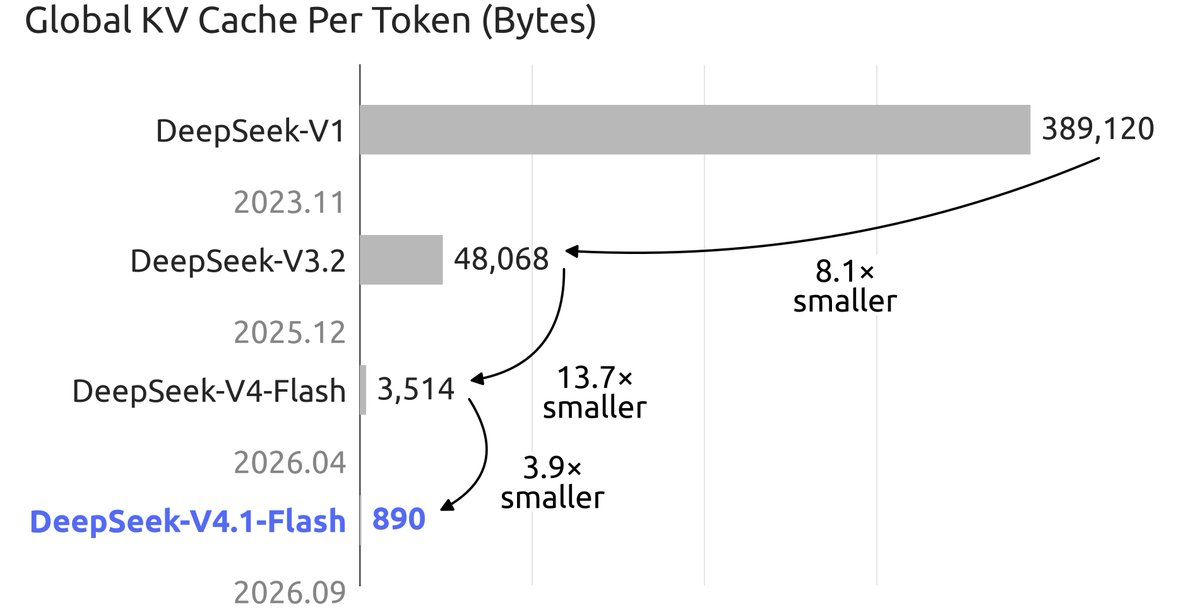
Con số tiêu đề có thể khiến nhiều độc giả e ngại: 552 tỷ tham số trong xương sống (backbone), và 763 tỷ nếu tính cả bộ mã hóa thị giác (vision encoder). Tuy nhiên, thiết kế bên dưới lại thân thiện hơn với việc tự lưu trữ (self-hosting) so với kích thước mà nó gợi ý. Chỉ có 8 tỷ tham số hoạt động trong giai đoạn prefill và 16 tỷ trong giai đoạn decode, và bộ nhớ đệm KV FP4 mới chỉ tốn 890 byte cho mỗi token, xấp xỉ một phần tư so với những gì V4-Flash cần. Tính toán thì rẻ. Bộ nhớ mới là rào cản.
Dù sao đi nữa, mọi người sẽ thử. Hướng dẫn này cung cấp cho bạn các phép tính về bộ nhớ, các con đường thực tế ở mỗi cấp độ phần cứng, các lệnh thiết lập chung và cách để kiểm tra một điểm cuối tương thích OpenAI cục bộ so với API được lưu trữ trong Apidog. Nếu bạn muốn có cái nhìn tổng quan về mô hình trước, hãy đọc DeepSeek-V4.1-Flash là gì? và quay lại.
TL;DR (Tóm tắt)
- Trọng số: xương sống MoE 552B, giấy phép MIT. Khoảng 552 GB ở 8-bit, khoảng 280 GB ở 4-bit, chỉ riêng phần xương sống.
- Bộ nhớ đệm KV: 890 byte mỗi token. Một ngữ cảnh 1 triệu token đầy đủ cần khoảng 0.9 GB. Phần này đã được giải quyết.
- Để phục vụ thực tế ở 4-bit cần 4 đến 8 GPU loại 80 GB. Mọi thứ thấp hơn mức đó đều là tắt tải CPU hoặc SSD, và chậm.
- API được lưu trữ tính phí 0.15 USD cho mỗi 1 triệu token đầu vào không trúng bộ nhớ đệm ngoài giờ cao điểm. Đối với hầu hết các nhóm, chi phí này còn thấp hơn cả tiền điện.
Bạn đang tải xuống gì
Thẻ mô hình mô tả một xương sống Mixture-of-Experts (MoE) 552 tỷ tham số với bố cục Causal Encoder-Decoder mới: 40 lớp, chia thành 20 bộ mã hóa và 20 bộ giải mã. Mỗi lớp định tuyến qua 384 chuyên gia cộng thêm 1 chuyên gia chia sẻ. Bộ mã hóa thị giác DeepSeek-ViT đẩy toàn bộ checkpoint lên 763 tỷ tham số, và bạn sẽ tải xuống toàn bộ ngay cả khi bạn chỉ cần văn bản.
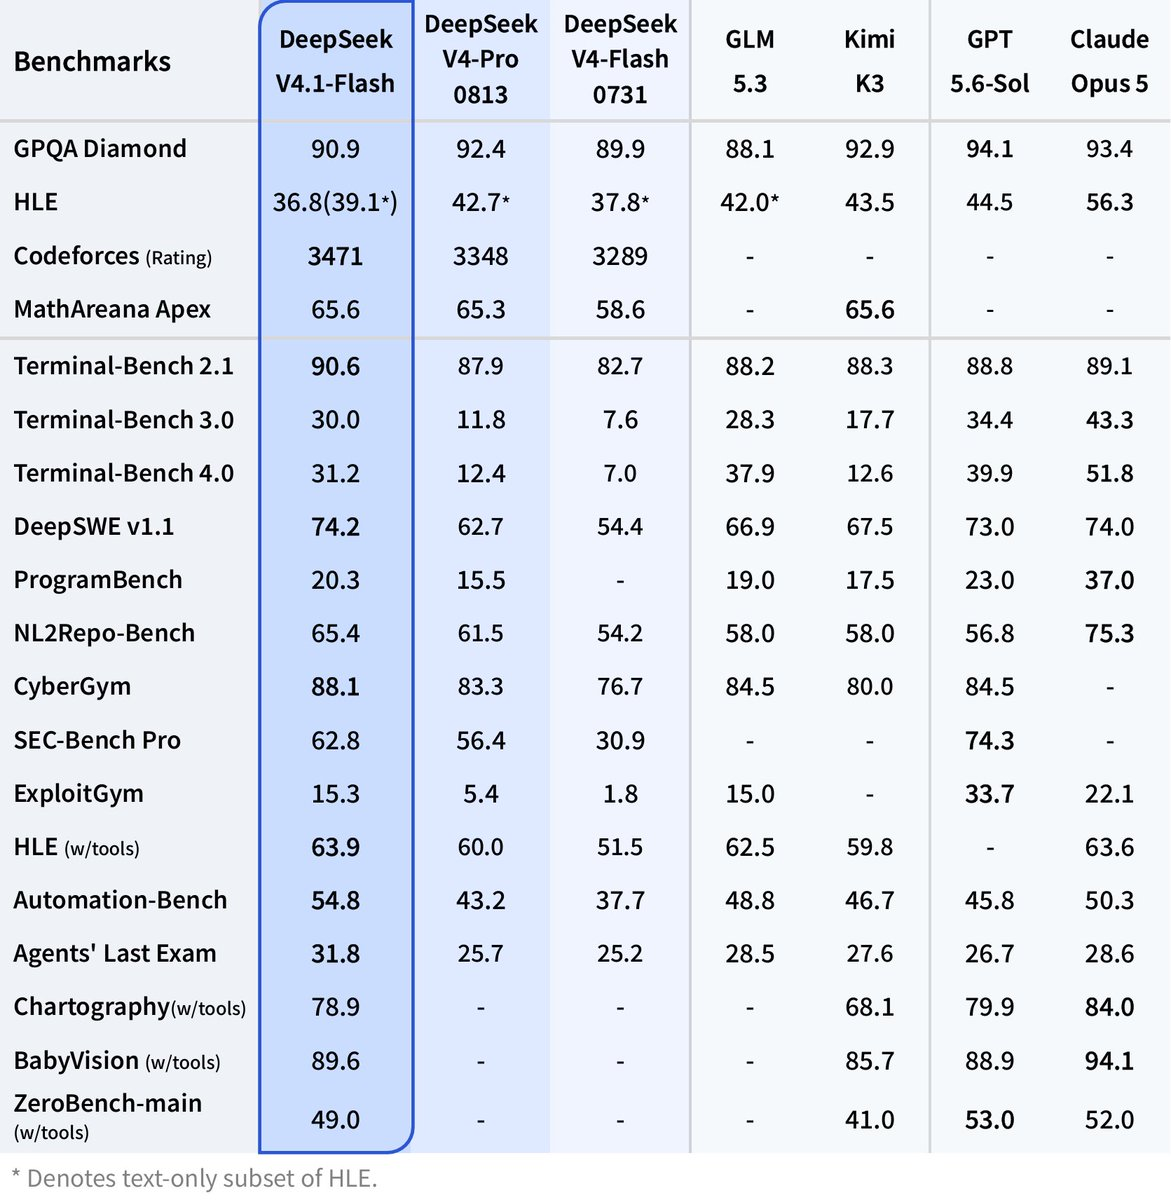
Ba chi tiết quan trọng đối với suy luận cục bộ:
- Các tham số hoạt động nhỏ. 8B hoạt động trong giai đoạn prefill, 16B trong giai đoạn decode. FLOPs trên mỗi token trông giống như một mô hình dày đặc (dense model) cỡ trung bình. Vấn đề là mỗi một trong 552B tham số phải nằm ở một nơi nào đó mà quá trình chuyển tiếp (forward pass) có thể tiếp cận.
- Bộ nhớ đệm KV là FP4. Ghi chú phát hành cho biết bộ nhớ đệm sử dụng 1/4 HBM và 1/8 dung lượng lưu trữ SSD so với thế hệ trước. Với 890 byte cho mỗi token, ngữ cảnh dài không còn là vấn đề về bộ nhớ như trước đây.
- Cơ chế Attention được thiết kế thưa thớt (sparse). Compressed Sparse Attention 2 với ba chế độ tĩnh đã được huấn luyện với ngữ cảnh 64K và mở rộng lên 1M vào cuối quá trình chạy 45T-token. Đó là lý do tại sao các con số KV vẫn nhỏ ở 1M.
Báo cáo kỹ thuật bao gồm toàn bộ kiến trúc. Mọi số liệu benchmark trên thẻ đều do DeepSeek báo cáo; hãy xem chúng như những tuyên bố.
Phép tính bộ nhớ
Các con số dưới đây là phép nhân đơn thuần, không phải đo lường, và chúng không bao gồm chi phí chung của engine, các kích hoạt (activations) và bộ mã hóa thị giác.
| Thành phần | Kích thước | Cách tính |
|---|---|---|
| Trọng số xương sống, 8-bit | ~552 GB | 552 tỷ tham số x 1 byte |
| Trọng số xương sống, 4-bit | ~280 GB | 552 tỷ tham số x 0.5 byte |
| Bộ nhớ đệm KV, mỗi token | 890 byte | Từ thẻ mô hình |
| Bộ nhớ đệm KV ở ngữ cảnh 128K | ~0.11 GB | 890 x 128,000 |
| Bộ nhớ đệm KV ở ngữ cảnh 1M | ~0.89 GB | 890 x 1,000,000 |
Hai điều nổi bật. Thứ nhất, bộ nhớ đệm KV là một sai số làm tròn. Một phiên 1 triệu token có thể nằm gọn trong dưới một gigabyte, vì vậy bạn có thể duy trì hàng chục phiên dài mà không ảnh hưởng đến ngân sách trọng số. Thứ hai, trọng số là toàn bộ vấn đề. Không có thủ thuật lượng tử hóa nào có thể làm cho 552 tỷ tham số vừa vặn trên một GPU tiêu dùng duy nhất, và thiết kế 8B-active cũng không giúp ích gì, bởi vì định tuyến MoE vẫn cần mọi chuyên gia được tải và có thể truy cập được.
Đó cũng là lý do tại sao các thiết lập tắt tải (offloaded setups) cảm thấy không cân xứng. Prefill xử lý hàng loạt trên toàn bộ lời nhắc và bị giới hạn bởi tính toán. Decode tải 16B tham số hoạt động từ RAM hoặc SSD cho mỗi token. Băng thông, chứ không phải FLOPs, quyết định số token mỗi giây của bạn.
Các cấp độ phần cứng thực tế
Không có số liệu thông lượng nào ở đây. Không ai ngoài DeepSeek có đủ thời gian sử dụng trọng số để công bố các điểm chuẩn đáng tin cậy.
Cấp 1: máy chủ đa GPU, 4 đến 8 card thuộc loại 80 GB. Bốn card 80 GB cung cấp cho bạn 320 GB, đủ cho trọng số 4-bit với một khoảng trống nhỏ cho bộ nhớ đệm KV và chi phí chung của engine. Tám card cung cấp cho bạn 640 GB, đủ cho checkpoint 8-bit hoặc triển khai 4-bit thoải mái với các lô lớn. Đây là cấp độ duy nhất mà "chạy cục bộ" có nghĩa là phục vụ cấp độ sản xuất với song song hóa tensor, và đó là một khoản mua sắm năm hoặc sáu chữ số hoặc thuê đám mây nhiều đô la mỗi giờ.
Cấp 2: máy trạm đơn với bộ nhớ cao và tắt tải CPU. Một máy có 512 GB RAM hệ thống trở lên và một hoặc hai GPU có thể giữ trọng số 4-bit trong RAM và truyền các lớp chuyên gia đến GPU theo yêu cầu. Nó hoạt động, nhưng chậm, vì băng thông giải mã là bus DDR5 của bạn thay vì HBM. Sử dụng nó cho các công việc theo lô và đánh giá qua đêm, không phải cho trò chuyện tương tác.
Cấp 3: Apple Silicon với truyền tải SSD. Con đường của những người có sở thích. Một chiếc Mac Studio 512 GB có thể giữ trọng số 4-bit trong bộ nhớ hợp nhất (unified memory), đây là một lựa chọn thực tế nếu bạn đã sở hữu một chiếc. Dưới mức đó, bạn sẽ gặp phải tình huống giống như trong chủ đề Kimi K3 HN: trọng số được chia trên nhiều SSD ngoài, mmap thực hiện công việc nặng nhọc, tốc độ khoảng 1 token mỗi giây. Nó chứng minh mô hình chạy được, chứ không phải nó hữu ích trên cỗ máy đó. Hướng dẫn chạy Kimi K3 cục bộ của chúng tôi đề cập đến những đánh đổi tương tự trên một mô hình lớn hơn, và cách chạy DeepSeek V4 cục bộ đề cập đến thế hệ trước.
Đường dẫn thiết lập
Với phần cứng đã có sẵn, quy trình là: tải xuống, phục vụ thông qua một điểm cuối tương thích OpenAI, kiểm tra.
pip3 install -U "huggingface_hub[cli]"
huggingface-cli download deepseek-ai/DeepSeek-V4.1-Flash \
  --local-dir ./models/deepseek-v4.1-flash \
  --max-workers 8
Với đường truyền 1 Gbps, mỗi 100 GB mất khoảng 15 phút ở tốc độ tối đa. Hãy dành ra một giờ hoặc hơn.
Phục vụ là nơi cần lưu ý. Hỗ trợ ngay lập tức trong vLLM, SGLang, llama.cpp và Ollama cho kiến trúc CED và cơ chế attention CSA2 là [XÁC MINH]; một loại lớp mới thường cần một bản vá engine trước khi trọng số được tải, và ghi chú phát hành không nêu tên các engine cụ thể. Hãy tìm kiếm “DeepSeek-V4.1” trong nhật ký thay đổi của từng dự án trước khi bạn quyết định tải xuống. Khi đã có hỗ trợ, việc phục vụ bằng vLLM trên 8 GPU trông như thế này:
vllm serve ./models/deepseek-v4.1-flash \
  --tensor-parallel-size 8 \
  --max-model-len 131072 \
  --served-model-name deepseek-flash \
  --port 8000
Một llama-server của llama.cpp hoặc một mô hình Ollama sẽ hiển thị cùng một điểm cuối kiểu http://localhost:8000/v1 sau khi có chuyển đổi GGUF, vì vậy bất kỳ client OpenAI SDK nào cũng hoạt động chỉ bằng cách thay đổi một dòng:
from openai import OpenAI

client = OpenAI(base_url="http://localhost:8000/v1", api_key="local")

response = client.chat.completions.create(
    model="deepseek-flash",
    messages=[{"role": "user", "content": "Summarize this incident report and list the three root causes."}],
    temperature=1.0,
    top_p=0.95,
)
print(response.choices[0].message.content)
Các giá trị temperature=1.0 và top_p=0.95 phù hợp với cài đặt được đề xuất trong thẻ mô hình. Đối với Ollama, hướng dẫn Ollama của chúng tôi đề cập đến quy trình Modelfile, và hướng dẫn vLLM đề cập chi tiết các cờ đa GPU.
Giải pháp thay thế thực dụng: API được lưu trữ
Ngoài giờ cao điểm, trang giá liệt kê deepseek-flash với 0.15 USD cho mỗi 1 triệu token đầu vào không trúng bộ nhớ đệm, 0.003 USD cho mỗi 1 triệu token đầu vào trúng bộ nhớ đệm, và 0.60 USD cho mỗi 1 triệu token đầu ra. Giờ cao điểm giá tăng gấp đôi. Vì vậy, 1 tỷ token đầu vào cộng với 200 triệu token đầu ra mỗi tháng có giá khoảng 270 USD ngoài giờ cao điểm và 540 USD vào giờ cao điểm, trước khi các lượt trúng bộ nhớ đệm làm giảm chi phí đầu vào hơn nữa. Một máy chủ 8-GPU loại 80 GB tốn nhiều hơn thế mỗi tháng chỉ riêng tiền điện và làm mát khi hoạt động liên tục, chưa kể chi phí khấu hao phần cứng hoặc thuê người trông nom. Trừ khi bạn có quy định về cư trú dữ liệu hoặc phần cứng đã không được sử dụng, API sẽ thắng về chi phí. Việc chuyển đổi chỉ là thay đổi một base_url; hướng dẫn API DeepSeek-V4.1-Flash của chúng tôi sẽ hướng dẫn bạn qua đó.
Triển khai cục bộ thắng thế khi ràng buộc không phải là tiền: môi trường không có kết nối mạng (air-gapped), dữ liệu prompt bạn không thể gửi đi đâu, hoặc nghiên cứu cần sửa đổi trọng số.
Kiểm tra điểm cuối cục bộ so với API được lưu trữ trong Apidog
Dù bạn chọn con đường nào, hãy chứng minh rằng máy chủ cục bộ hoạt động giống như tham chiếu trước khi bạn chuyển lưu lượng truy cập đến nó. Lệch lượng tử hóa (quantization drift), mẫu trò chuyện sai, hoặc thiếu token dừng đều có thể xuất hiện dưới dạng các khác biệt nhỏ trong đầu ra. Dưới đây là quy trình làm việc trong Apidog:
- Tạo hai môi trường. Một môi trường tên là
localvớibase_urlđược đặt thànhhttp://localhost:8000/v1, một môi trường tên làhostedvớibase_urlđược đặt thànhhttps://api.deepseek.comvà khóa thực của bạn. Mọi yêu cầu đều sử dụng{{base_url}}/chat/completionsvàBearer {{api_key}}. - Lưu một tập hợp prompt nhỏ làm yêu cầu. Năm đến mười prompt đại diện cho khối lượng công việc của bạn: trích xuất JSON, sửa lỗi mã, tóm tắt ngữ cảnh dài. Đặt
modelthànhdeepseek-flashtrong tất cả chúng; nó hoạt động trên cả hai máy chủ. - Thêm các xác nhận (assertions). Đối với tác vụ JSON, xác nhận rằng phản hồi được phân tích cú pháp và một khóa bắt buộc tồn tại. Đối với mỗi yêu cầu, xác nhận
finish_reasonbằngstop, điều này giúp phát hiện lỗi cắt bớt do cài đặt ngữ cảnh sai. - Chạy tập hợp trên cả hai môi trường. Chuyển đổi menu thả xuống môi trường từ
hostedsanglocalvà chạy lại cùng một kịch bản kiểm thử. Một lỗi chỉ xuất hiện trênlocallà vấn đề về lượng tử hóa hoặc mẫu của bạn, được cô lập chỉ với một cú nhấp chuột. - Xem luồng (streaming). Đặt
stream: truevà sử dụng chế độ xem SSE để thấy các sự kiện đến từng cái một. Một máy chủ cục bộ đệm toàn bộ phản hồi trước khi gửi sẽ trông ổn trên một cuộc gọi không truyền luồng nhưng sai ở đây. - Đưa vào CI. Chạy kịch bản với
apidog-clitrên mỗi lần nâng cấp engine, để một mẫu trò chuyện bị hỏng sẽ làm lỗi một pipeline thay vì người dùng.
Tải Apidog và toàn bộ quy trình sẽ chạy từ một dự án.
Câu hỏi thường gặp
Tôi có thể chạy DeepSeek-V4.1-Flash trên máy tính xách tay không? Không hữu ích. Xương sống 4-bit có dung lượng khoảng 280 GB. Máy tính xách tay có thể truyền tải nó từ SSD theo cách thí nghiệm Kimi K3 đã làm, với tốc độ khoảng 1 token mỗi giây, đây chỉ là một bản demo chứ không phải quy trình làm việc. Hãy sử dụng API hoặc một trong các tùy chọn trong cách sử dụng DeepSeek-V4.1-Flash miễn phí.
8B tham số hoạt động có nghĩa là tôi chỉ cần 8 GB VRAM? Không. Các tham số hoạt động đặt ra lượng tính toán trên mỗi token, chứ không phải bộ nhớ. Định tuyến MoE có thể chọn bất kỳ chuyên gia nào trong số 384 chuyên gia mỗi lớp cho bất kỳ token nào, vì vậy tất cả 552 tỷ tham số phải được tải và có thể truy cập được.
Ngữ cảnh 1 triệu token cần bao nhiêu bộ nhớ? Khoảng 0.89 GB bộ nhớ đệm KV với 890 byte cho mỗi token. Đó là phần rẻ tiền của mô hình này. Trọng số mới là phần đắt tiền.
Giấy phép có an toàn cho mục đích thương mại không? Có. Trọng số tuân thủ giấy phép MIT, theo thẻ mô hình Hugging Face.
Tóm lại
DeepSeek-V4.1-Flash là mã nguồn mở theo cách quan trọng về mặt pháp lý và kỹ thuật: trọng số MIT, một báo cáo kỹ thuật công khai và thiết kế bộ nhớ đệm KV giúp các phiên 1 triệu token gần như miễn phí về bộ nhớ. Nó không mở theo cách cho phép bạn chạy nó trên máy tính dưới bàn của mình. Đối với hầu hết các nhóm, động thái đúng đắn là sử dụng API được lưu trữ với 0.15 USD cho mỗi 1 triệu token đầu vào ngoài giờ cao điểm, với việc triển khai cục bộ dành riêng cho dữ liệu không thể rời khỏi tòa nhà.
Dù bằng cách nào, hãy kiểm tra trước khi tin tưởng. Hướng Apidog đến cả hai điểm cuối, chạy cùng các yêu cầu đã lưu và để các xác nhận cho bạn biết liệu bản dựng cục bộ của bạn có khớp với tham chiếu hay không.