
Grok 4.6 ra mắt vào ngày 12 tháng 8 với tuyên bố định hình lại quyết định về mô hình tiên phong: khả năng thông minh ngang ngửa GPT-5.6 Sol trên Chỉ số Phân tích Nhân tạo, với giá 6 đô la cho mỗi triệu token đầu ra thay vì 30 đô la. Hầu hết các bài viết so sánh bạn sẽ tìm thấy vẫn đánh giá Grok 4.5, vốn bị tụt hậu đáng kể so với mô hình tiên phong đến mức giá không còn quan trọng. Tình hình không còn như vậy nữa, vì vậy bài so sánh này bắt đầu lại với các số liệu của 4.6.
Câu trả lời ngắn gọn: GPT-5.6 Sol vẫn là lựa chọn mạnh mẽ nhất cho các tác nhân mã hóa quy mô kho lưu trữ, Claude Fable 5 dẫn đầu công việc tự động hóa dài hạn trong gang tấc, và Grok 4.6 hiện là lựa chọn giá trị có khả năng đủ gần để khiến hai lựa chọn kia phải biện minh cho mức giá của chúng. Lựa chọn đúng đắn phụ thuộc vào khối lượng công việc của bạn, vì vậy dưới đây là các con số, các cân nhắc về API và một cách có thể tái tạo để kiểm tra cả ba trên ngăn xếp của riêng bạn. Nếu bạn muốn chạy thử nghiệm đó ngay hôm nay, Apidog cho phép bạn truy cập cả ba API song song từ một không gian làm việc, miễn phí.
button
TL;DR
- Chỉ số thông minh: Claude Fable 5 dẫn đầu ở mức 62; Grok 4.6 và GPT-5.6 Sol hòa ở mức 61.
- Giá (đầu ra, mỗi 1 triệu token): Grok 4.6 ở mức 6 đô la, Claude Opus 4.8 ở mức 25 đô la, GPT-5.6 Sol ở mức 30 đô la, chênh lệch gấp 5 lần.
- Context: GPT-5.6 Sol 1.05M token, Claude Fable 5 1M, Grok 4.6 500K.
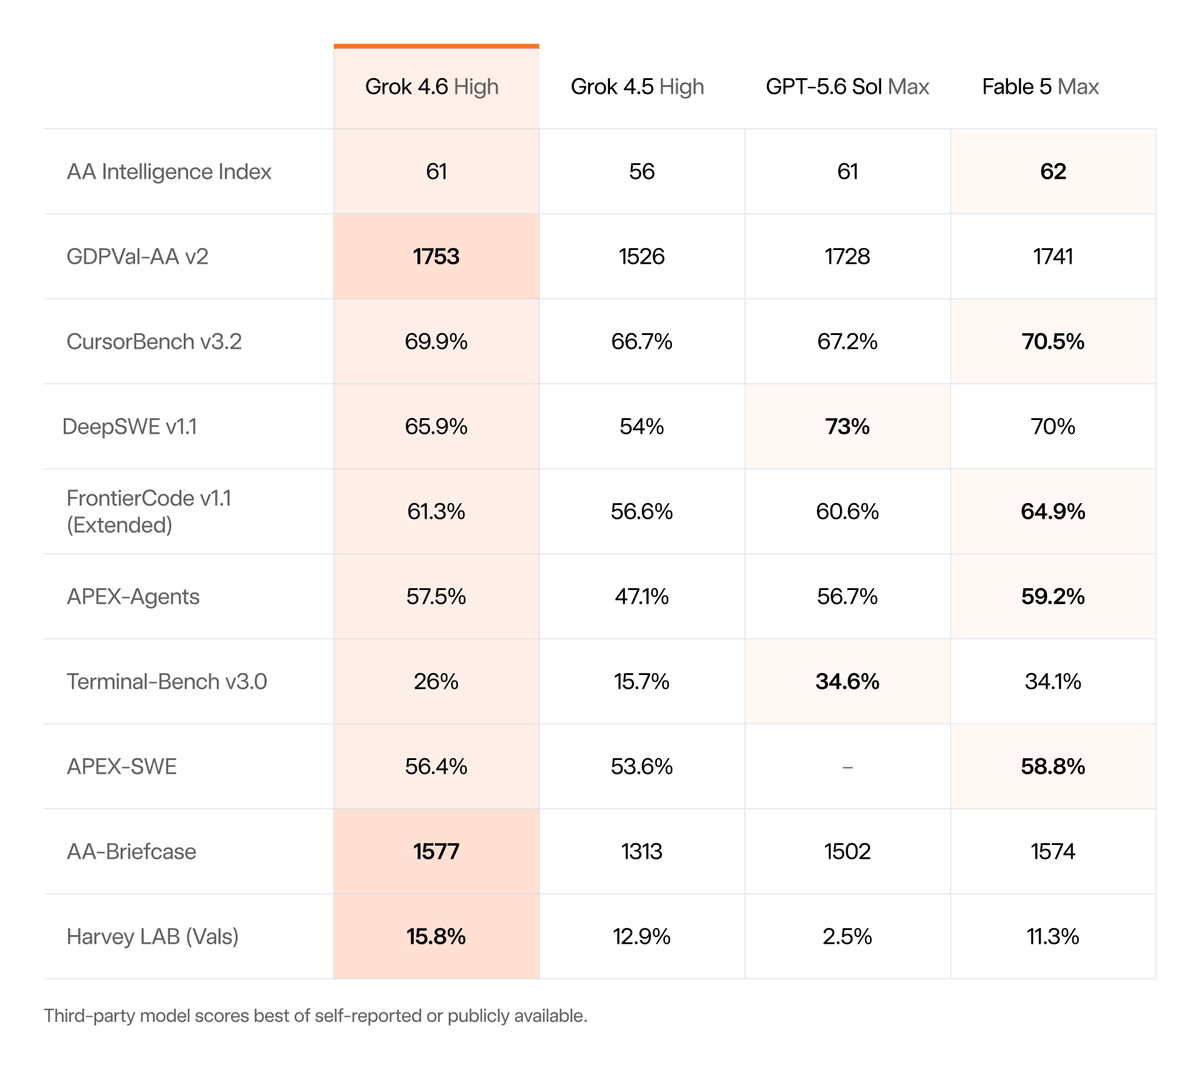
- Mã hóa: Sol Max dẫn đầu DeepSWE (73.0% so với 65.9% của Grok); Fable 5 Max dẫn đầu FrontierCode (63.6% so với 61.3%).
- Tác nhân (Agents): Fable 5 Max dẫn đầu APEX-Agents ở mức 59.2%; Grok 4.6 (57.5%) vượt Sol Max (56.7%).
- Chi phí cho mỗi tác vụ hoàn thành: Grok 4.6 được đo ở mức 0.84 đô la bởi Artificial Analysis, thấp nhất trong số các mô hình tiên phong.
- Đừng chỉ dựa vào điểm chuẩn: hãy chạy một bài kiểm tra 20 câu lệnh trên khối lượng công việc của riêng bạn (phương pháp dưới đây).
Thông số kỹ thuật và giá cả song song
| Grok 4.6 | GPT-5.6 Sol | Claude Fable 5 | |
|---|---|---|---|
| Nhà phát triển | xAI | OpenAI | Anthropic |
| Chỉ số thông minh | 61 | 61 | 62 |
| Cửa sổ ngữ cảnh | 500K | 1.05M | 1M |
| Giá đầu vào / 1M | $2 | $12 | $10 |
| Giá đầu ra / 1M | $6 | $30 | $25* |
| Biến thể nhanh/cao cấp | Giá gấp 2 lần | Phiên bản Sol Max | Phiên bản Fable 5 Max |
| Phong cách API | Tương thích OpenAI | OpenAI gốc | Tin nhắn Anthropic |
| Cắt giảm kiến thức | Tháng 2 năm 2026 |
*Giá Claude hiển thị cho Opus 4.8; giá phiên bản Fable 5 thay đổi tùy theo cài đặt nỗ lực. Xem hướng dẫn giá GPT-5.6 và phân tích giảm chi phí Claude của chúng tôi để biết các ma trận đầy đủ.
Sự bất đối xứng về giá là điểm đáng chú ý. Ở phía đầu vào, Grok tính phí bằng một phần sáu so với OpenAI; ở phía đầu ra là một phần năm. Đối với khối lượng công việc trò chuyện thì điều này rất tốt; đối với khối lượng công việc của tác nhân (agent), nơi một tác vụ duy nhất có thể tạo ra hàng tá lệnh gọi mô hình và bản ghi sử dụng công cụ dài, điều này tổng hợp thành sự khác biệt giữa tác nhân 50 đô la/ngày và 250 đô la/ngày.
Điểm chuẩn mã hóa: Sol cho độ sâu, Grok cho giá trị
Dựa trên các con số ra mắt, mỗi mô hình đều có lãnh thổ riêng:
| Điểm chuẩn | Grok 4.6 | GPT-5.6 Sol Max | Claude Fable 5 Max |
|---|---|---|---|
| DeepSWE v1.1 (sửa lỗi quy mô kho lưu trữ) | 65.9% | 73.0% | |
| FrontierCode v1.1 Mở rộng | 61.3% | 60.6% | 63.6% |
| CursorBench v3.2 | 69.9% | ||
| APEX-Agents | 57.5% | 56.7% | 59.2% |
| Terminal-Bench v2.1 | 88.4% |
Hãy đọc nó như sau:
- DeepSWE của GPT-5.6 Sol Max dẫn trước 7 điểm là thực tế và rất quan trọng. Sửa lỗi quy mô kho lưu trữ là điểm chuẩn mã hóa khó nhất, có giá trị kinh tế nhất. Nếu tác nhân của bạn làm việc trên các codebase lớn hiện có với sự giám sát tối thiểu, Sol vẫn là lựa chọn an toàn nhất. So sánh GPT-5.6 Sol vs Claude Fable 5 của chúng tôi đề cập sâu đến sự đối đầu này.
- Claude Fable 5 thắng về tính nhất quán. Nó dẫn đầu chỉ số tổng hợp, FrontierCode và APEX-Agents. Không có gì đột biến, nó hiếm khi tệ hơn vị trí thứ hai. Hồ sơ này phù hợp với công việc tự động hóa dài hạn, nơi một bước sai lầm có thể làm hỏng một giờ tiến độ.
- Grok 4.6 không bao giờ tụt hậu xa, và đôi khi còn dẫn trước. Dẫn đầu CursorBench và Terminal-Bench trong khi vẫn giữ khoảng cách gần với các vị trí khác, với một phần nhỏ chi phí, chính xác là hồ sơ của một mô hình mà bạn định tuyến phần lớn lưu lượng truy cập của mình đến, chỉ mở rộng các trường hợp khó.
Một lưu ý chân thành: đây là các con số ra mắt tuần đầu, phần lớn do nhà cung cấp báo cáo. Điểm chuẩn ra mắt của Grok 4.5 cần đọc kỹ, và sự thận trọng tương tự áp dụng cho mọi nhà cung cấp ở đây.
Chi phí cho mỗi tác vụ, không phải chi phí cho mỗi token
Giá token có thể gây hiểu lầm khi các mô hình khác nhau về độ dài và tỷ lệ thử lại. Một mô hình rẻ tiền mà thất bại trong một lần chạy cuối cùng sẽ tạo ra công việc xem xét và sửa chữa tốn kém hơn số token đã tiết kiệm. Chỉ số tốt hơn là chi phí cho mỗi tác vụ hoàn thành, và ở đây, phép đo độc lập của Artificial Analysis rất đáng chú ý: Grok 4.6 có mức trung bình 0.84 đô la cho mỗi tác vụ trên các đánh giá tác nhân của nó, thấp nhất trong số các mô hình tiên phong, nhờ việc sử dụng token tương đối kỷ luật chứ không chỉ do giá thấp.
Một ví dụ cụ thể. Giả sử tác nhân mã hóa của bạn trung bình 500K token đầu vào và 100K token đầu ra cho mỗi tác vụ hoàn thành:
| Mô hình | Chi phí đầu vào | Chi phí đầu ra | Mỗi tác vụ |
|---|---|---|---|
| Grok 4.6 | $1.00 | $0.60 | $1.60 |
| Claude Opus 4.8 | $5.00 | $2.50 | $7.50 |
| GPT-5.6 Sol | $6.00 | $3.00 | $9.00 |
Với 1.000 tác vụ mỗi tháng, Grok tiết kiệm khoảng 6.000–7.400 đô la so với các lựa chọn thay thế, nếu tỷ lệ thành công trên khối lượng công việc của bạn được duy trì. Điều kiện này là toàn bộ trò chơi, đó là lý do tại sao bạn kiểm tra trước khi cam kết.
Khả năng sử dụng API: chi phí thực sự của việc tích hợp
- Grok 4.6 tương thích với OpenAI. Nếu bạn có bất kỳ client nào kiểu OpenAI, bạn chỉ cần trỏ
base_urltớihttps://api.x.ai/v1và bạn đã có thể chạy. Nó cũng có sẵn trên OpenRouter, Vercel và Cloudflare cho người dùng gateway. - GPT-5.6 Sol có hệ sinh thái sâu rộng nhất: API Responses, gọi công cụ theo chương trình và SDK chính hãng ở khắp mọi nơi. Xem cách sử dụng API GPT-5.6 để biết cấu trúc cấp bậc.
- Claude Fable 5 sử dụng API Messages của Anthropic, có hình dạng yêu cầu khác, độ tin cậy sử dụng công cụ xuất sắc và một tham số nỗ lực (effort parameter) cân bằng chi phí với khả năng trong một mô hình.
Ma sát di chuyển thấp nhất giữa Grok và OpenAI (định dạng chung), cao nhất khi di chuyển đến hoặc từ Anthropic. Nếu bạn dự đoán việc chuyển đổi hoặc định tuyến giữa các mô hình, sự bất đối xứng đó thuộc về quyết định kiến trúc của bạn.
Cửa sổ ngữ cảnh: khi 500K là đủ
Trên lý thuyết, cửa sổ 1.05M token của GPT-5.6 Sol gấp đôi 500K của Grok 4.6, với 1M của Claude Fable 5 theo sát phía sau. Trên thực tế, câu hỏi là khối lượng công việc của bạn thực sự chứa gì trong ngữ cảnh.
Một cửa sổ 500K chứa khoảng 350.000 từ: toàn bộ codebase của một dịch vụ cỡ trung, bản ghi hỗ trợ một năm, hoặc vài trăm trang tài liệu pháp lý. Hầu hết các tác vụ của tác nhân không bao giờ đạt đến mức đó. Các khối lượng công việc thực sự cần cấp độ một triệu token rất hẹp: phân tích toàn bộ monorepo, các bản ghi tác nhân nhiều phiên rất dài mà bạn từ chối tóm tắt, và xử lý một lần các bộ tài liệu lớn.
Hai lưu ý thực tế chống lại việc chỉ chọn dựa trên kích thước cửa sổ. Thứ nhất, mọi mô hình đều suy giảm khi ngữ cảnh đầy; chất lượng truy xuất ở mức 80% dung lượng kém hơn ở mức 20% trên cả ba, vì vậy các kiến trúc nhồi nhét cửa sổ hiếm khi đánh bại các kiến trúc truy xuất chọn lọc. Thứ hai, token đầu vào là nơi ngân sách cạn kiệt: việc điền đầy cửa sổ của Sol tốn khoảng 12.60 đô la mỗi yêu cầu theo giá niêm yết, trong khi điền đầy của Grok tốn 1 đô la. Nếu các prompt của bạn thường xuyên vượt quá 400K token, bạn không chỉ cần một cửa sổ lớn hơn, bạn cần một chiến lược lưu trữ và truy xuất, bất kể bạn chọn nhà cung cấp nào.
Giới hạn kiến thức và độ chín muồi của hệ sinh thái
Grok 4.6 ra mắt với giới hạn kiến thức là ngày 1 tháng 2 năm 2026, mới nhất trong ba mô hình, điều này quan trọng đối với các tác nhân mã hóa tham chiếu các framework thay đổi nhanh. Đó là một lợi thế thực nhưng nhỏ: bất kỳ stack tác nhân nghiêm túc nào cũng dựa vào các công cụ truy xuất và tài liệu thay vì tin tưởng vào kiến thức tham số.
Hệ sinh thái là câu chuyện ngược lại. OpenAI có bề mặt tích hợp bên thứ ba sâu rộng nhất, Anthropic có thị phần framework tác nhân mạnh nhất, và xAI là người mới dựa vào khả năng tương thích OpenAI để vay mượn cả hai. Cược đó phần lớn hiệu quả: bất cứ thứ gì nói định dạng hoàn thành trò chuyện đều chạy với Grok hôm nay, và tính khả dụng của gateway thông qua OpenRouter, Vercel và Cloudflare có nghĩa là bạn có thể áp dụng nó mà không cần chạm vào cơ sở hạ tầng của mình. Điều bạn phải từ bỏ là sự hoàn thiện từ bên thứ nhất, các API hàng loạt, các cấp bộ nhớ đệm và kiểm soát sử dụng chi tiết ít trưởng thành hơn so với các nhà cung cấp hiện tại.
Mô hình nào cho công việc nào
- Tác nhân mã hóa quy mô kho lưu trữ tự động, chất lượng hàng đầu: GPT-5.6 Sol. Lợi thế DeepSWE dẫn đến ít lỗi hơn trên các codebase lớn.
- Công việc tri thức dài hạn và các phiên tác nhân kéo dài nhiều giờ: Claude Fable 5. Điểm tổng hợp tốt nhất, điểm chuẩn tác nhân tốt nhất, lịch sử tốt nhất về việc duy trì ổn định.
- Lưu lượng tác nhân lớn, sản phẩm nhạy cảm về chi phí, hoặc mô hình mặc định của một bộ định tuyến: Grok 4.6. Đầu ra cấp tiên phong với giá cấp hàng hóa; mở rộng 10% các tác vụ khó nhất sang Sol hoặc Fable.
- Mã hóa tương tác trong IDE: Lợi thế CursorBench của Grok 4.6 cộng với biến thể nhanh gấp 2 lần của nó khiến nó trở thành một đối thủ nghiêm túc; nó thực sự được xây dựng cho việc này sau khi được đào tạo trên các phiên Cursor thực tế.
Kiểm tra cả ba trên ngăn xếp của bạn trong một buổi chiều
Các điểm chuẩn dự đoán mức trung bình, không phải khối lượng công việc của bạn. Dưới đây là một bài kiểm tra có thể tái tạo bằng cách sử dụng Apidog:
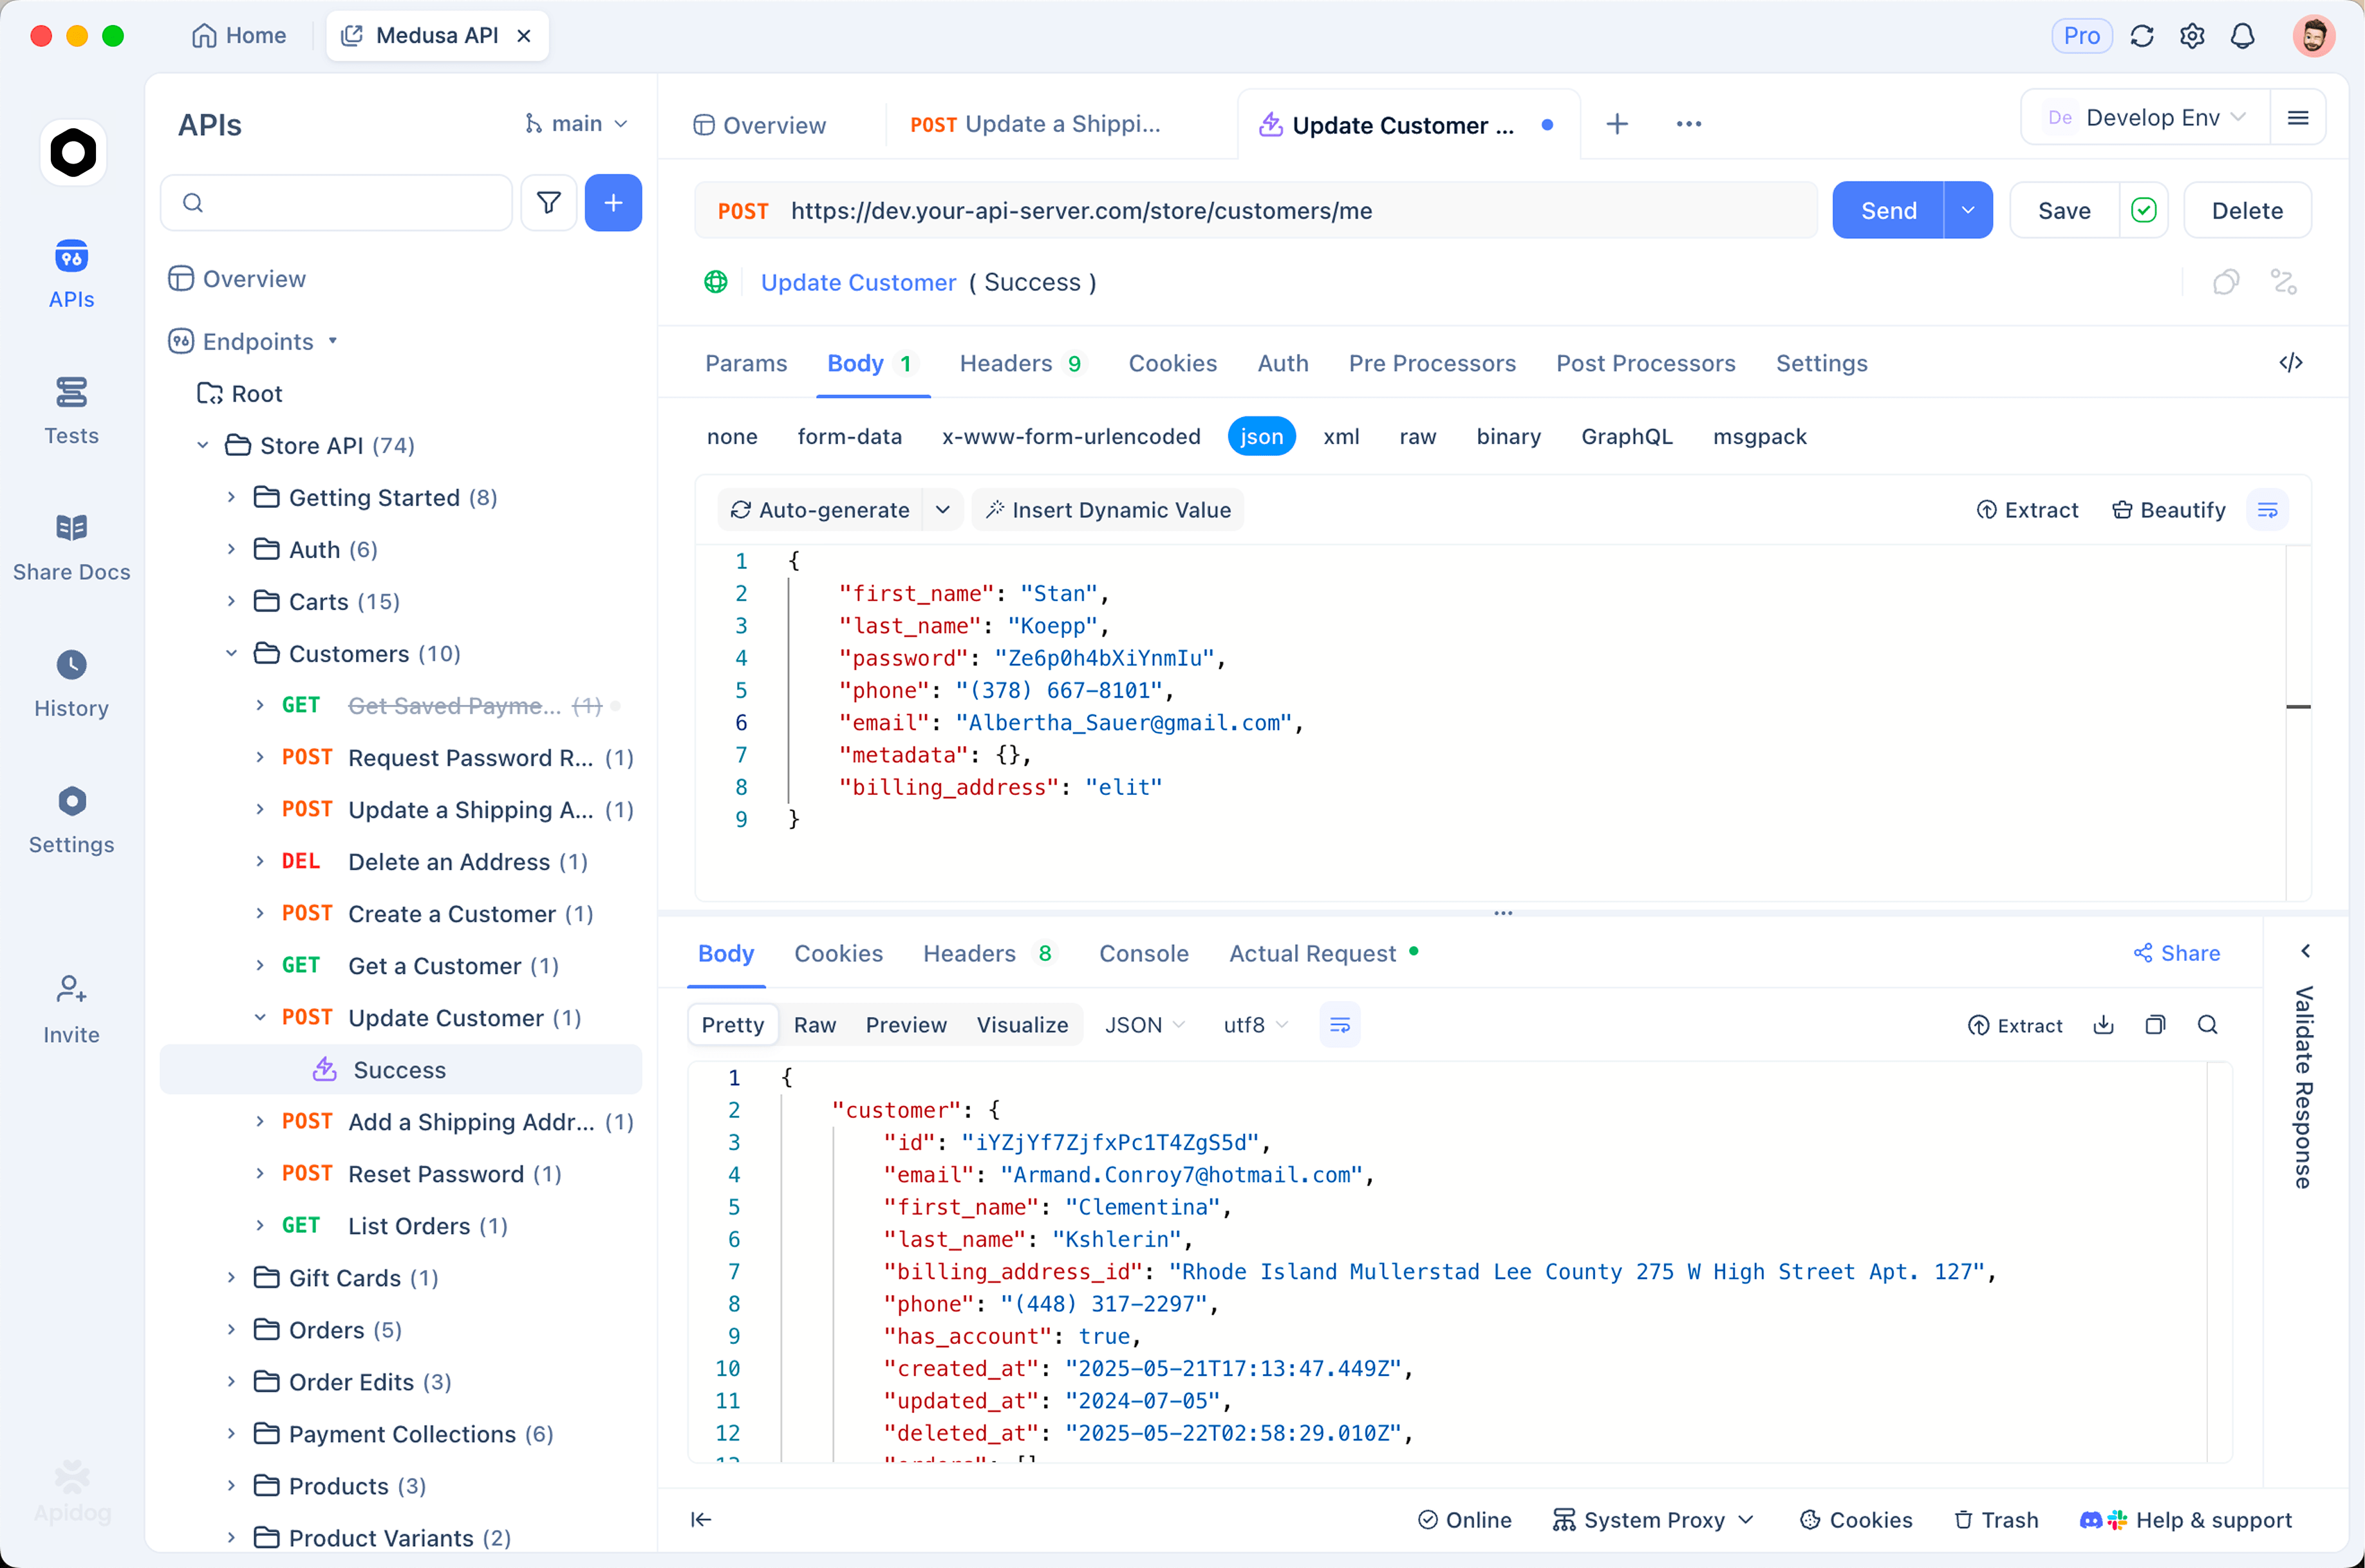
- Một dự án, ba môi trường. Tạo môi trường cho xAI (
api.x.ai/v1), OpenAI và Anthropic, mỗi môi trường mang thông tin xác thực riêng. Cùng một yêu cầu chuyển đổi nhà cung cấp chỉ với một menu thả xuống. - Thu thập 20 prompt thực tế. Lấy các tác vụ thực tế từ sản phẩm của bạn, không phải các câu hỏi nhỏ. Bao gồm prompt hệ thống của bạn, định nghĩa công cụ của bạn nếu bạn sử dụng gọi hàm, và ít nhất năm trường hợp khó đã biết.
- Xác nhận những gì bạn quan tâm. Thêm xác nhận Apidog cho tính hợp lệ của phản hồi, mức sử dụng token từ đối tượng
usagevà ngưỡng độ trễ. Đối với khối lượng công việc gọi công cụ, xác nhận JSON gọi công cụ phân tích cú pháp và khớp với schema của bạn, các mô hình thất bại ở đây thường xuyên hơn là trong văn xuôi. - Chạy như một kịch bản thử nghiệm, ba lần cho mỗi mô hình. Đầu ra LLM thay đổi; ba lần chạy sẽ cho thấy sự khác biệt mà một bản demo duy nhất che giấu. Xuất kết quả và so sánh tỷ lệ thành công và chi phí cho mỗi lần thành công, không phải chi phí cho mỗi token.
- Giữ bộ thử nghiệm. Khi phiên bản mô hình tiếp theo ra mắt (theo nhịp độ hiện tại, trong vòng vài tháng), hãy chạy lại. Lựa chọn mô hình giờ đây là một quyết định hàng quý, và các nhóm có hệ thống đánh giá cố định chuyển đổi nhanh hơn vài tuần so với các nhóm quyết định lại bằng giai thoại.
FAQ
Grok 4.6 có tốt hơn GPT-5.6 Sol không? Chúng hòa nhau trên chỉ số tổng hợp ở mức 61. Sol rõ ràng dẫn đầu về mã hóa quy mô kho lưu trữ (DeepSWE 73.0% so với 65.9%); Grok dẫn đầu CursorBench và Terminal-Bench và chi phí ít hơn 5 lần ở phía đầu ra. "Tốt hơn" phụ thuộc vào việc khối lượng công việc của bạn giống DeepSWE hơn hay giống một phiên IDE hơn.
Grok 4.6 có tốt hơn Claude Fable 5 không? Fable 5 dẫn đầu về chỉ số (62 so với 61), FrontierCode và APEX-Agents, tất cả đều sát nút. Lợi thế của Grok là giá cả. Đối với công việc tự động hóa quan trọng về độ chính xác, Fable 5; đối với khối lượng nhạy cảm về chi phí, Grok.
Mô hình AI nào rẻ nhất ở cấp độ tiên phong vào năm 2026? Grok 4.6, với giá 2 đô la/6 đô la cho mỗi triệu token và được đo độc lập là 0.84 đô la cho mỗi tác vụ tác nhân. Token đầu ra của đối thủ tiên phong gần nhất có chi phí cao hơn khoảng 4 lần.
Tôi có nên chuyển tác nhân sản xuất của mình sang Grok 4.6 không? Không chỉ dựa vào các điểm chuẩn. Hãy chạy bài kiểm tra trên khối lượng công việc thực tế của bạn trước, khoảng cách giá gấp 5 lần chỉ mang lại lợi ích nếu tỷ lệ thành công được duy trì trên các tác vụ của bạn.
Tôi có thể sử dụng cả ba mô hình đằng sau một định dạng API không? Phần lớn là có. Grok 4.6 nói định dạng hoàn thành trò chuyện của OpenAI một cách tự nhiên, vì vậy nó chia sẻ mã client với GPT-5.6. Claude yêu cầu API Messages của Anthropic, hoặc một gateway như OpenRouter chuẩn hóa cả ba đằng sau một giao diện duy nhất với một mức tăng nhỏ.
Cửa sổ ngữ cảnh nhỏ hơn của Grok 4.6 có quan trọng không? Đối với hầu hết các khối lượng công việc tác nhân và trò chuyện, không; 500K token vượt xa mức sử dụng điển hình, và cả ba mô hình đều suy giảm gần giới hạn của chúng. Nó quan trọng nếu bạn thường xuyên xử lý toàn bộ monorepo hoặc các bộ tài liệu lớn trong một lần gọi duy nhất, nơi cửa sổ 1.05M của Sol mang lại lợi thế thực sự.
button