
Sự khác biệt giữa GPT-Live-1.1 và GPT-Realtime nằm ở kiến trúc. GPT-Live-1.1 là một frontend thoại song công hoàn toàn (full-duplex), chuyển phần suy luận và công cụ sang một mô hình backend riêng và tính phí $0.05 mỗi phút hoạt động. GPT-Realtime-2.1 là một mô hình speech-to-speech duy nhất, vừa nghe, vừa suy luận, vừa gọi công cụ và vừa nói, tính phí theo token. Hãy chọn GPT-Live-1.1 khi bạn đã có sẵn một text agent; chọn Realtime khi bạn muốn một mô hình đảm nhận mọi thứ.
OpenAI đã đưa GPT-Live-1.1 vào API ngày 20/11/2026, vì vậy giờ đây bạn có hai voice stack với endpoint, cách tính phí và mô hình công cụ khác nhau. Bài viết GPT-Live vs GPT-Realtime hồi tháng 7 của chúng tôi đã so sánh tính năng ChatGPT với API; bài này là so sánh API với API.
GPT-Live-1.1 vs GPT-Realtime: cái nhìn tổng quan
Dưới đây là so sánh giữa hai stack, được tổng hợp từ trang mô hình GPT-Live-1.1, trang mô hình gpt-realtime-2.1 và trang giá của OpenAI vào ngày 20/11/2026:
| GPT-Live-1.1 | gpt-realtime-2.1 | |
|---|---|---|
| Endpoint | v1/live/sessions |
v1/realtime |
| Thiết kế | Thoại song công hoàn toàn cộng backend được ủy thác | Một mô hình suy luận speech-to-speech duy nhất |
| Đầu vào | Âm thanh, văn bản | Âm thanh, văn bản, hình ảnh |
| Đầu ra | Âm thanh, văn bản | Âm thanh, văn bản |
| Cách tính phí | $0.05/phút hoạt động, $0.02/phút chờ | $32 đầu vào, $64 đầu ra mỗi 1 triệu token âm thanh |
| Suy luận và công cụ | Mô hình backend, tính phí riêng | Nằm trong cùng mô hình và cùng mức giá |
| Function calling | Thông qua ủy thác | session.tools |
| Phương thức truyền tải | WebRTC, WebSocket, SIP (gọi vào và gọi ra) | WebRTC, WebSocket, SIP (gọi vào) |
| Giới hạn tần suất | Số phiên đồng thời | Số request và token mỗi phút |
Hướng dẫn voice agent của OpenAI tóm tắt sự phân chia này trong bảng kiến trúc. GPT-Live dành cho "hội thoại song công hoàn toàn với một backend riêng." Realtime API dành cho "giọng nói, suy luận và sử dụng công cụ trong một phiên duy nhất."
Kiến trúc: ủy thác so với một mô hình duy nhất
GPT-Live-1.1 tách việc nói khỏi việc suy nghĩ. Mô hình thoại xử lý cuộc hội thoại trong thời gian thực và vẫn lắng nghe trong khi đang nói. Khi một yêu cầu cần suy luận, tìm kiếm hoặc gọi công cụ, nó ủy thác công việc đó cho một mô hình backend và tiếp tục cuộc hội thoại trong lúc công việc kia đang chạy.
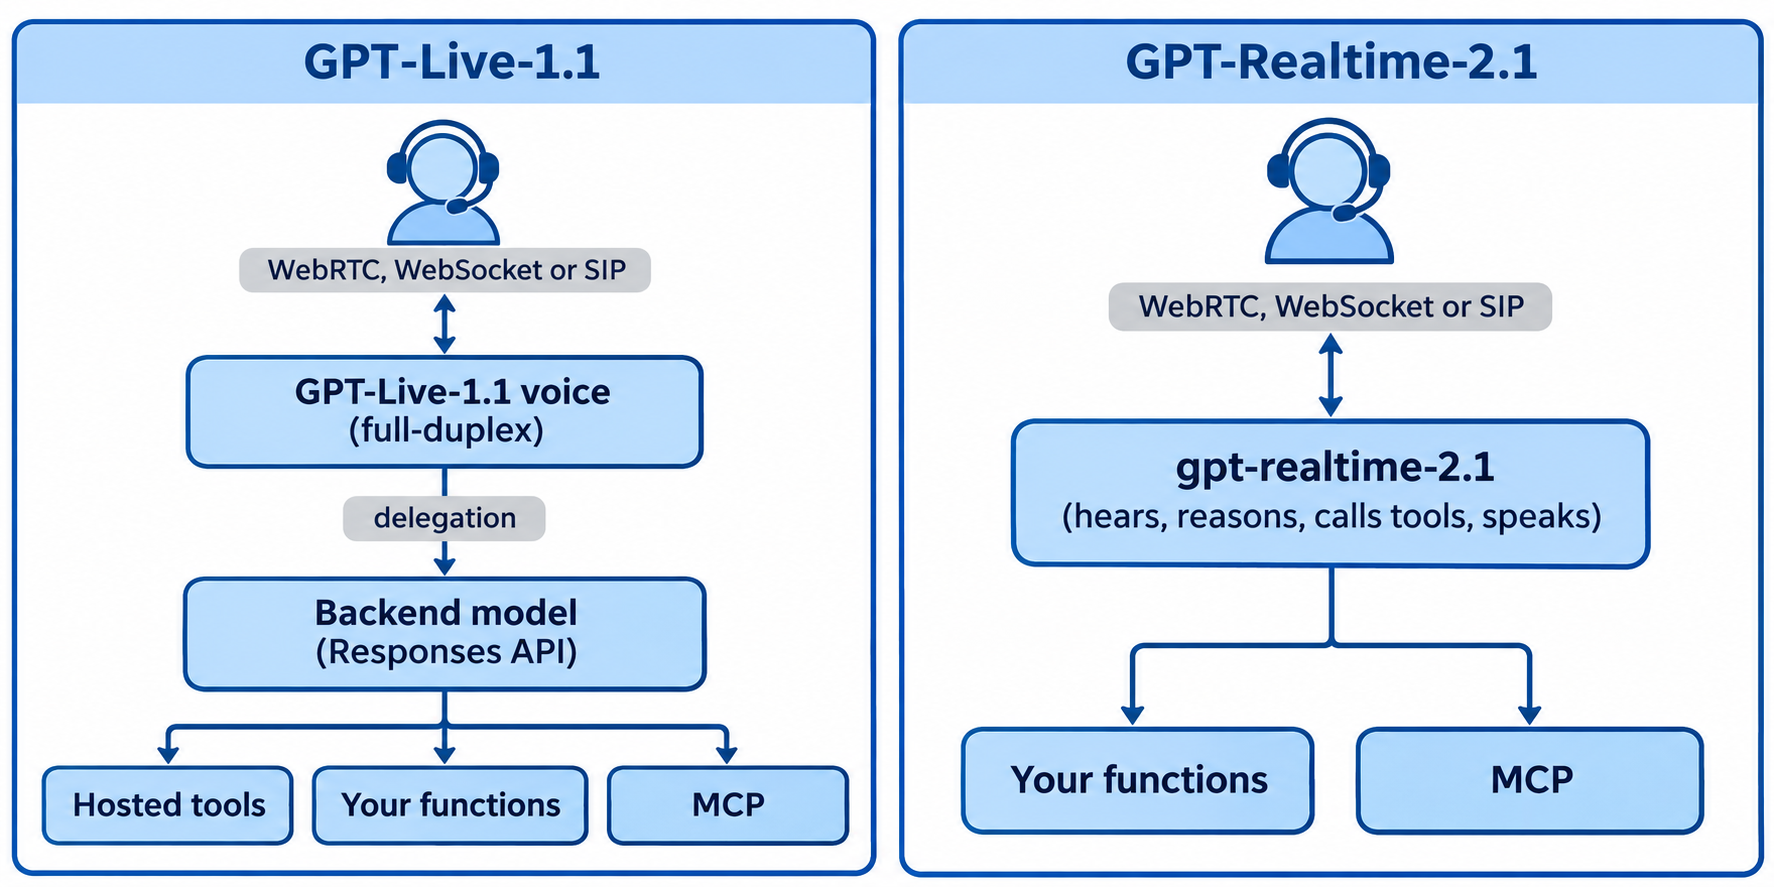
Bạn thiết lập ủy thác một lần, khi tạo phiên, theo hướng dẫn live conversation. Có hai chế độ:
responses: OpenAI vận hành backend thông qua Responses API. Bạn chọn mô hình trongdelegation.responses.modelvà thêminstructions,tools,tool_choice,reasoningvàservice_tier. Tài liệu gợi ý bắt đầu vớigpt-6-lunavà chuyển sanggpt-6-solcho các tác vụ khó hơn.client: ứng dụng của bạn vận hành backend. GPT-Live gửi một sự kiệnsession.delegation.created, và bạn trả kết quả về bằng các sự kiện nhưsession.instructions.append.
Chế độ không thể thay đổi giữa phiên; muốn đổi thì phải tạo phiên mới. Các cài đặt backend bên trong thì có thể thay đổi bằng session.update.
gpt-realtime-2.1 đi theo hướng ngược lại: một mô hình suy luận duy nhất diễn giải âm thanh, gọi công cụ và trả lời bằng giọng nói. Không có mô hình thứ hai, không có bàn giao, mọi ngữ cảnh nằm ở một nơi.
Với GPT-Live-1.1, bạn có thể thay backend, hoặc giữ nguyên text agent hiện có, mà không cần đụng đến lớp thoại. Với Realtime, mô hình thoại chính là agent.
Giá: theo phút so với theo token
GPT-Live-1.1 tính phí theo thời gian, còn Realtime tính phí theo token. Điều này khiến chi phí của hai bên biến động rất khác nhau khi người gọi tạm dừng, nói lan man hoặc giữ máy.
| Hạng mục chi phí | GPT-Live-1.1 | gpt-realtime-2.1 | gpt-realtime-2.1-mini |
|---|---|---|---|
| Âm thanh | $0.05/phút hoạt động, $0.02/phút chờ | $32 đầu vào, $64 đầu ra mỗi 1 triệu token | $10 đầu vào, $20 đầu ra mỗi 1 triệu token |
| Văn bản | Tính phí theo thời lượng phiên | $4 đầu vào, $24 đầu ra mỗi 1 triệu token | $0.60 đầu vào, $2.40 đầu ra mỗi 1 triệu token |
| Đầu vào được cache | không áp dụng | $0.40 mỗi 1 triệu token | $0.30 âm thanh, $0.06 văn bản mỗi 1 triệu |
| Suy luận và công cụ | Mô hình backend theo mức giá riêng | Đã bao gồm trong giá token | Đã bao gồm trong giá token |
GPT-Live tính phí theo từng giây, nên một cuộc gọi 90 giây tốn $0.075 tiền thời gian thoại, chứ không phải $0.10. Một phiên WebRTC bị tính 15 giây trong lúc khởi tạo, và khoản này được ghi có lại khi phiên bắt đầu chạy.
Chế độ chờ (standby) là đòn bẩy chi phí mà Realtime không có. Trên WebRTC, đặt wake_policy.type thành "speech" và idle_timeout_s thành một số nguyên từ 5 đến 60. Sau số giây đó không có giọng nói, phiên sẽ hạ xuống $0.02 mỗi phút cho đến khi có người nói lại. Standby chỉ được tài liệu hóa cho WebRTC, nên các phiên WebSocket và SIP sẽ bị tính phí mỗi giây kết nối ở mức giá hoạt động.
Để so sánh hai bên cho lưu lượng của chính bạn, hãy dùng một con số điểm hòa vốn thay vì đoán. $0.05 mua được khoảng 1.560 token âm thanh đầu vào hoặc 780 token âm thanh đầu ra trên gpt-realtime-2.1, và khoảng 5.000 token đầu vào hoặc 2.500 token đầu ra trên 2.1-mini. Lấy số token âm thanh mỗi phút từ các sự kiện sử dụng Realtime của bạn. Nếu một phút hoạt động trung bình của bạn dùng nhiều hơn con số đó, thời gian thoại của GPT-Live sẽ rẻ hơn; sau đó cộng thêm hóa đơn token của mô hình backend để thấy bức tranh đầy đủ.
Realtime gộp chi phí suy luận vào giá token; GPT-Live cộng thêm hóa đơn backend cho mỗi tác vụ được ủy thác nhưng cắt giảm chi phí của những khoảng lặng nhờ chế độ chờ. Về phía token, xem hướng dẫn gpt-realtime-2.1-mini của chúng tôi.
Function calling và công cụ
Cả hai stack đều gọi hàm của bạn, nhưng từ những nơi khác nhau.
Trên Realtime, công cụ nằm trên phiên. Hướng dẫn công cụ Realtime trình bày một công cụ "type": "function" trong session.tools, được gửi kèm session.update. Client của bạn chạy hàm và trả về một item function_call_output. Các MCP server từ xa cũng hoạt động: thêm một công cụ với "type": "mcp", một server_label và một server_url, và Realtime API sẽ gọi server thay bạn. Bạn cũng có thể giới hạn công cụ cho một lượt bằng response.tools.
Trên GPT-Live-1.1, công cụ nằm ở backend. Bạn đặt các công cụ hàm, MCP server và các công cụ được lưu trữ như web search, file search và Code Interpreter vào delegation.responses.tools. Các sự kiện của backend đến với bạn được bọc trong phong bì response.event, và kết quả hàm của bạn được gửi trả về dưới dạng các item function_call_output theo sau là response.create.
Ưu điểm: lớp thoại vẫn phản hồi nhanh trong khi một công cụ chậm đang chạy ở backend. Cái giá: hai mô hình, hai luồng sự kiện và hai hóa đơn.
Lượt nói, ngắt lời và phương thức truyền tải
Đây là nơi hai bên tạo cảm giác khác biệt nhất với người gọi.
Lượt nói. GPT-Live-1.1 là song công hoàn toàn: nó xử lý âm thanh đến trong khi vẫn tạo đầu ra, nên có thể lắng nghe, đáp lại bằng những tín hiệu ngắn (backchannel) và điều chỉnh ngay giữa câu. Realtime hoạt động theo từng lượt được phát hiện bằng voice activity. Hướng dẫn Realtime VAD liệt kê hai chế độ trong session.audio.input.turn_detection.type:
server_vad, mặc định, được tinh chỉnh bằngthreshold,prefix_padding_msvàsilence_duration_ms.semantic_vad, được tinh chỉnh bằngeagerness(low,medium,highhoặcauto, vớiautotương đươngmedium).
Realtime xử lý việc chen ngang (barge-in) bằng interrupt_response. GPT-Live không cần cài đặt đó, vì nó đã lắng nghe trong khi nói.
Phương thức truyền tải. Cả hai đều hỗ trợ WebRTC trên trình duyệt và WebSocket trên server. Điện thoại thì khác. Theo hướng dẫn SIP, GPT-Live hỗ trợ SIP gọi vào và gọi ra, và gọi ra "khả dụng cho mọi tổ chức thông qua Live API, không phải endpoint tạo cuộc gọi của Realtime API." Một cuộc gọi SIP GPT-Live đang kết nối bị giới hạn tối đa 2 giờ. Hướng dẫn SIP của Realtime đề cập đến các cuộc gọi vào thông qua webhook realtime.call.incoming.
Giới hạn và ngữ cảnh
| Giới hạn | GPT-Live-1.1 | gpt-realtime-2.1 |
|---|---|---|
| Ngữ cảnh | 128.000 token mỗi phiên, được quản lý tự động | 128.000 token |
| Số token đầu ra tối đa | Chưa công bố | 32.000 |
| Instructions | Tối đa 16.384 token | Chưa công bố |
| Giới hạn tần suất | Số phiên đồng thời, theo từng mô hình | 400 RPM và 200.000 TPM ở hạng Build |
GPT-Live đếm số phiên đồng thời, không đếm token. Trang GPT-Live-1 liệt kê 50 phiên đồng thời ở hạng Build, 300 ở hạng Launch và 500 ở hạng Grow, không có quyền truy cập hạng Free. GPT-Live-1.1 có giới hạn riêng, và trang của nó chưa công bố con số, nên hãy kiểm tra trang giới hạn của tổ chức bạn trước khi ra mắt.
Giới hạn của Realtime có thể mở rộng lên 10.000 RPM ở hạng Launch và 20.000 RPM ở hạng Grow.
Bạn nên dùng voice API nào của OpenAI?
Hãy dùng GPT-Live-1.1 khi lớp thoại chỉ là một tầng phủ lên agent mà bạn đã tin tưởng, và dùng Realtime khi mô hình thoại nên chính là agent.
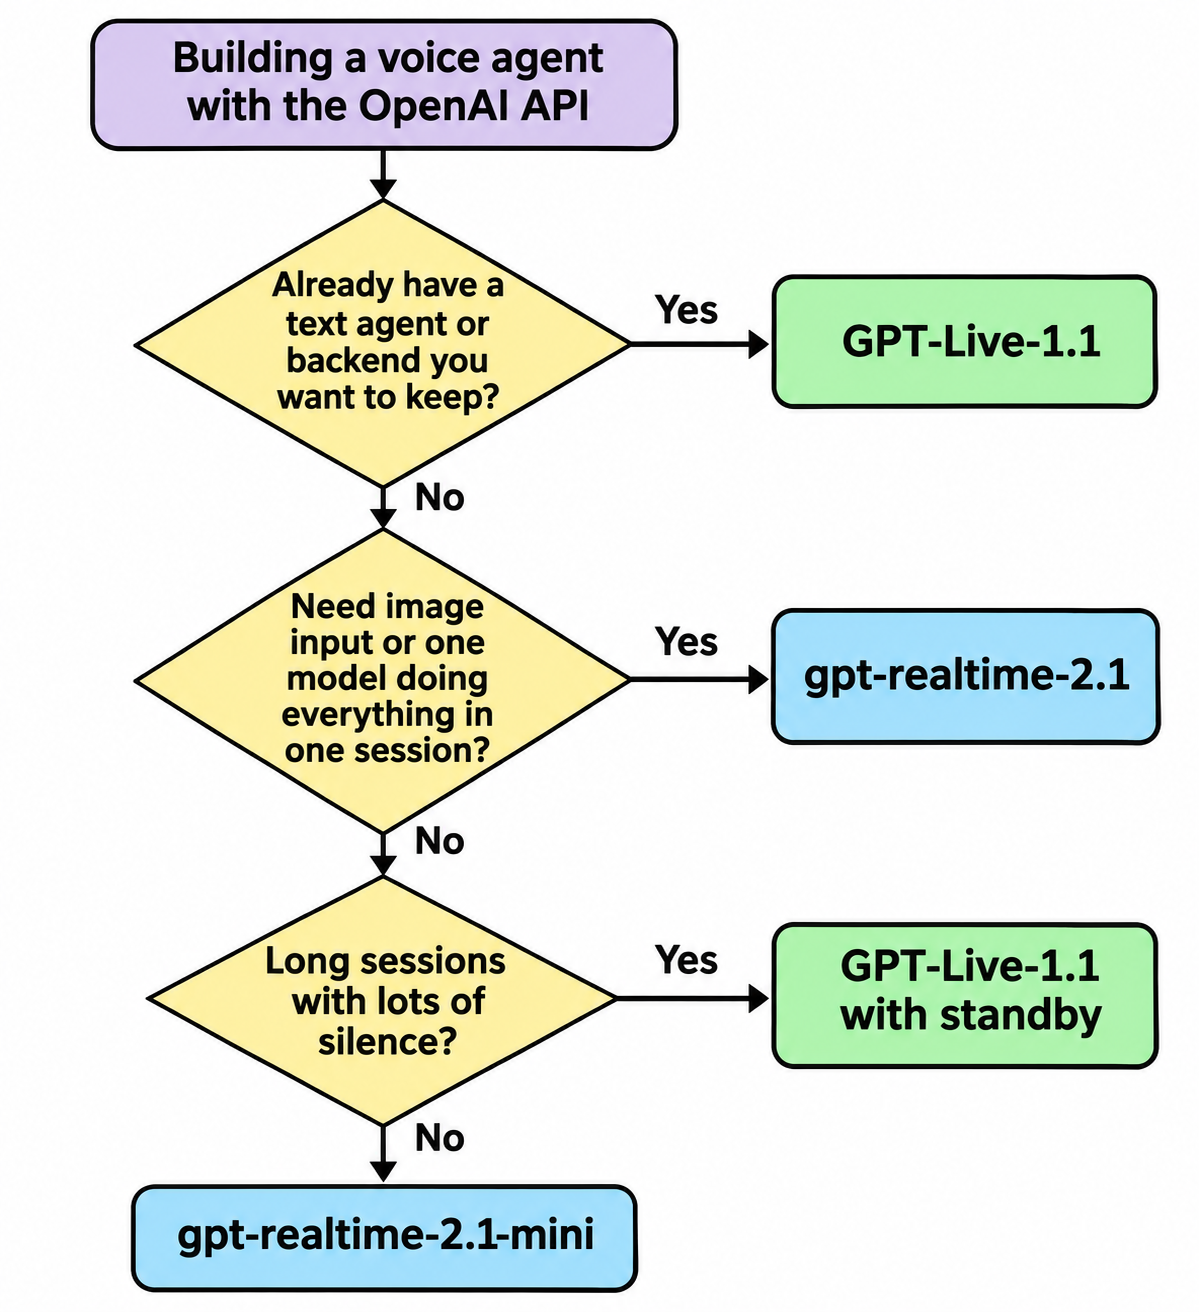
Chọn GPT-Live-1.1 khi:
- Thêm lớp thoại vào một text agent, bot hỗ trợ hoặc workflow hiện có mà không cần xây lại.
- Phiên dài có nhiều khoảng lặng, chẳng hạn gia sư, huấn luyện hay companion, nơi chế độ chờ phát huy tác dụng.
- Cuộc gọi điện thoại gọi ra, thứ chỉ Live API cung cấp.
- Hội thoại cần sự chồng lấn và phản hồi tự nhiên (backchanneling).
Chọn gpt-realtime-2.1 khi:
- Voice agent khép kín, nơi một mô hình đảm nhận cả suy luận lẫn hành động.
- Ứng dụng gửi kèm hình ảnh cùng với giọng nói.
- Đội ngũ muốn một luồng sự kiện và một hóa đơn duy nhất.
Chọn gpt-realtime-2.1-mini cho các tác vụ thoại ngắn, lưu lượng lớn, chi phí thấp, nơi giá theo token rẻ hơn giá theo phút. Hướng dẫn GPT-Realtime-2 API của chúng tôi trình bày chi tiết cách thiết lập Realtime.
Để coding agent của bạn kiểm thử tool API bằng Apidog CLI
Dù stack nào thắng, cả hai đều gọi cùng một thứ: tool API của bạn. Một lần tra cứu chậm đều là khoảng lặng chết người như nhau, nên hãy kiểm thử độ trễ và hợp đồng của nó trước khi bất kỳ người gọi nào nghe thấy. Hãy để Claude Code, Codex hoặc Cursor làm việc đó với Apidog CLI.
Thiết lập một lần:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Sau đó đưa cho agent của bạn một prompt:
Import ./voice-tools-openapi.yaml into Apidog project <projectId>. Build a test scenario
that calls GET /orders/{order_id} and GET /customers/{id} in sequence, asserts 200 and
the fields my voice agent reads aloud, and fails any request slower than 800 ms.
Run it 20 times against staging and tell me which step is slowest.
Agent sẽ import spec, kiểm tra hình dạng payload, xây dựng kịch bản và chạy nó:
apidog import --project <projectId> --format openapi --file ./voice-tools-openapi.yaml
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <projectId> --file scenario.json
apidog test-scenario import-steps <scenarioId> --project <projectId> --source endpoint --ids <endpointIds> --sync manual
apidog run -t <scenarioId> --project <projectId> -e <envId> -n 20 --timeout-request 800 -r cli,json
-n 20 lặp lại việc chạy để một phản hồi may mắn không che giấu được cái đuôi chậm, và --timeout-request 800 sẽ đánh dấu thất bại cho bất kỳ cuộc gọi nào chậm đến mức khiến người gọi phải chờ. Đổi -r cli,json thành -r junit trong CI để một lỗi hồi quy chặn được việc triển khai, như hướng dẫn Apidog CLI CI/CD của chúng tôi trình bày. Mới làm quen với workflow agent? Hãy bắt đầu với Apidog CLI trong Claude Code. Gói Free của Apidog hỗ trợ tối đa 4 người dùng.
Câu hỏi thường gặp
Cái nào rẻ hơn, GPT-Live-1.1 hay GPT-Realtime? Điều đó phụ thuộc vào số token âm thanh mỗi phút và backend của bạn. Thời gian thoại của GPT-Live tốn $0.05 mỗi phút hoạt động cộng thêm token của mô hình backend. Trên gpt-realtime-2.1, $0.05 mua được khoảng 1.560 token âm thanh đầu vào hoặc 780 token âm thanh đầu ra. Hãy so sánh với log sử dụng của chính bạn.
Tôi có thể dùng function calling với GPT-Live-1.1 không? Có, thông qua ủy thác. Đặt các công cụ hàm vào delegation.responses.tools, hoặc tự vận hành backend ở chế độ ủy thác client. Mô hình thoại không nhận trực tiếp danh sách công cụ như session.tools của Realtime.
GPT-Realtime có hỗ trợ tính phí chế độ chờ không? Không. Chế độ chờ với giá $0.02 mỗi phút là tính năng của GPT-Live, và chỉ áp dụng cho các phiên WebRTC được cấu hình với wake_policy và idle_timeout_s. Realtime tính phí theo token mà mỗi phiên sử dụng.
GPT-Live-1.1 có thể thực hiện cuộc gọi điện thoại gọi ra không? Có. Tạo một phiên với transport.type: "sip" và thông tin SIP trunk của bạn trên POST /v1/live/sessions. Tài liệu của OpenAI cho biết SIP gọi ra chạy qua Live API, không phải endpoint tạo cuộc gọi của Realtime API.
GPT-Live-1.1 có nhận đầu vào hình ảnh không? Không. Trang mô hình liệt kê âm thanh và văn bản ở cả đầu vào lẫn đầu ra. Nếu voice agent của bạn cần nhìn thấy hình ảnh, gpt-realtime-2.1 nhận đầu vào hình ảnh với giá $5 mỗi 1 triệu token.