
GPT-Live-1.1 tính phí theo thời gian, không theo token. OpenAI tính phí phiên giọng nói với giá $0,05 mỗi phút hoạt động và $0,02 mỗi phút chờ, tính theo giây và không làm tròn lên phút kế tiếp. Các lệnh gọi model backend và công cụ được tính phí riêng theo mức giá thông thường. Một giờ trò chuyện liên tục tốn $3,00 phí giọng nói; một giờ để ở chế độ chờ tốn $1,20.
Bảng giá rất ngắn gọn. Điều quan trọng là cách nó vận hành trong một ứng dụng thực tế, nơi người dùng tạm dừng, backend xử lý lâu và các phiên bị mở quá lâu. Dưới đây là ba ví dụ tính toán chi tiết cùng các cài đặt giúp hóa đơn luôn dự đoán được.
Tổng quan về giá GPT-Live-1.1
GPT-Live-1.1 có hai mức giá giọng nói và một hóa đơn riêng cho phần backend. Dưới đây là những gì trang model GPT-Live-1.1 và trang giá của OpenAI liệt kê tính đến ngày 20/11/2026:
| Khoản phí | Mức giá | Mỗi giờ | Ghi chú |
|---|---|---|---|
| Thời gian phiên hoạt động | $0,05 mỗi phút | $3,00 | Nói, im lặng trước khi hết idle timeout, chờ backend xử lý |
| Thời gian phiên chờ (standby) | $0,02 mỗi phút | $1,20 | Chỉ dành cho WebRTC, khi inference tạm dừng |
| Model backend Responses | Giá token thông thường | Thay đổi | Tùy model bạn chọn để ủy thác xử lý |
| Công cụ hosted | Giá công cụ thông thường | Thay đổi | Web search, file search, Code Interpreter và các công cụ khác |
Ba chi tiết quan trọng hơn cả mức giá quảng cáo:
- Tính phí theo giây. Một cuộc gọi 90 giây tốn $0,075, chứ không phải $0,10; thời lượng không được làm tròn lên nguyên phút.
- Giá bằng GPT-Live-1. Cả hai model dùng chung mức giá giống hệt nhau, nên việc nâng cấp không làm thay đổi hóa đơn giọng nói.
- Phí khởi tạo 15 giây. Việc tạo phiên WebRTC bị tính 15 giây trong khi khởi tạo, và được hoàn lại khi phiên chạy. Khoản này chỉ phát sinh chi phí cho các phiên bạn tạo rồi bỏ dở.
Để tìm hiểu thêm về các kiến trúc giọng nói, xem GPT-Live so với GPT-Realtime.
Thời gian nào tính là hoạt động và thời gian nào tính là chờ
Phút hoạt động là bất kỳ khoảng thời gian nào inference đang chạy. Phút chờ là thời gian phiên WebRTC vẫn kết nối nhưng inference tạm dừng, chờ giọng nói. Khoảng chênh lệch $0,03 mỗi phút giữa hai mức này quyết định phần lớn hóa đơn giọng nói của bạn.
Hướng dẫn chi phí của OpenAI nêu rõ những gì rơi vào nhóm hoạt động:
- Thời gian người dùng hoặc model đang nói.
- Thời gian im lặng trước khi idle timeout hết hạn.
- Thời gian chờ backend xử lý trong khi inference vẫn đang chạy.
Tắt microphone không kích hoạt chế độ chờ; phiên vẫn tính phí $0,05 mỗi phút.
Chế độ chờ cần hai cài đặt khi tạo phiên, được ghi trong hướng dẫn live conversations:
{
  "session": {
    "model": "gpt-live-1.1",
    "wake_policy": { "type": "speech", "vad_threshold": 0.5 },
    "idle_timeout_s": 15
  }
}
wake_policy.type: "speech" báo cho phiên chờ có giọng nói trước khi bắt đầu inference. idle_timeout_s nhận một số nguyên từ 5 đến 60 và đưa phiên trở về chế độ chờ sau số giây đó nếu không có transcript đầu vào hay đầu ra. Nếu bỏ qua timeout, inference sẽ giữ hoạt động cho đến khi phiên kết thúc, nghĩa là bạn không bao giờ được áp mức giá chờ.
Hai lưu ý: chế độ chờ chỉ dành cho WebRTC, nên các phiên WebSocket và SIP đều tính mỗi giây kết nối theo mức giá hoạt động, và phản hồi đầu tiên sau khi ra khỏi chế độ chờ có thể chậm hơn.
Các ví dụ tính chi phí cụ thể
Mức giá giọng nói là giá công bố; số token backend chỉ là giả định minh họa. Giá backend lấy từ trang giá của OpenAI: gpt-6-luna với $0,10 đầu vào và $0,50 đầu ra mỗi 1M token, gpt-6-sol với $2,00 đầu vào và $10,00 đầu ra mỗi 1M token (bậc chuẩn, ngữ cảnh ngắn). Hướng dẫn delegation của OpenAI khuyên nên bắt đầu với gpt-6-luna và thử gpt-6-sol cho các tác vụ backend khó hơn.
Ví dụ 1: một đường dây hỗ trợ khách hàng
Một cuộc gọi hỗ trợ qua điện thoại hoặc WebSocket kéo dài 6 phút. Chế độ chờ không áp dụng, nên cả 6 phút đều được tính là hoạt động. GPT-Live ủy thác 4 truy vấn cho gpt-6-luna, mỗi truy vấn dùng khoảng 6.000 token đầu vào và 400 token đầu ra.
| Khoản mục | Cách tính | Chi phí |
|---|---|---|
| Giọng nói | 6 phút x $0,05 | $0,30 |
| Backend đầu vào | 24.000 token x $0,10 / 1M | $0,0024 |
| Backend đầu ra | 1.600 token x $0,50 / 1M | $0,0008 |
| Mỗi cuộc gọi | $0,3032 |
Với 10.000 cuộc gọi mỗi tháng, chi phí khoảng $3.032, trong đó $3.000 là thời gian giọng nói. Rút ngắn 30 giây khỏi thời lượng gọi trung bình tiết kiệm được nhiều hơn toàn bộ hóa đơn backend.
Ví dụ 2: gia sư ngôn ngữ trên trình duyệt
Một buổi học WebRTC kéo dài 30 phút với idle_timeout_s đặt là 15. Học viên dành nhiều thời gian dài để đọc và suy nghĩ, nên phiên chạy 18 phút hoạt động và 12 phút ở chế độ chờ. Gia sư ủy thác 10 phần giải thích cho gpt-6-sol, mỗi phần khoảng 8.000 token đầu vào và 600 token đầu ra.
| Khoản mục | Cách tính | Chi phí |
|---|---|---|
| Giọng nói hoạt động | 18 phút x $0,05 | $0,90 |
| Giọng nói chờ | 12 phút x $0,02 | $0,24 |
| Backend đầu vào | 80.000 token x $2,00 / 1M | $0,16 |
| Backend đầu ra | 6.000 token x $10,00 / 1M | $0,06 |
| Mỗi buổi | $1,36 |
Nếu không có chế độ chờ, cùng 30 phút giọng nói đó sẽ tốn $1,50 thay vì $1,14, tức chế độ chờ cắt giảm hóa đơn giọng nói 24%.
Ví dụ 3: trợ lý desktop luôn bật
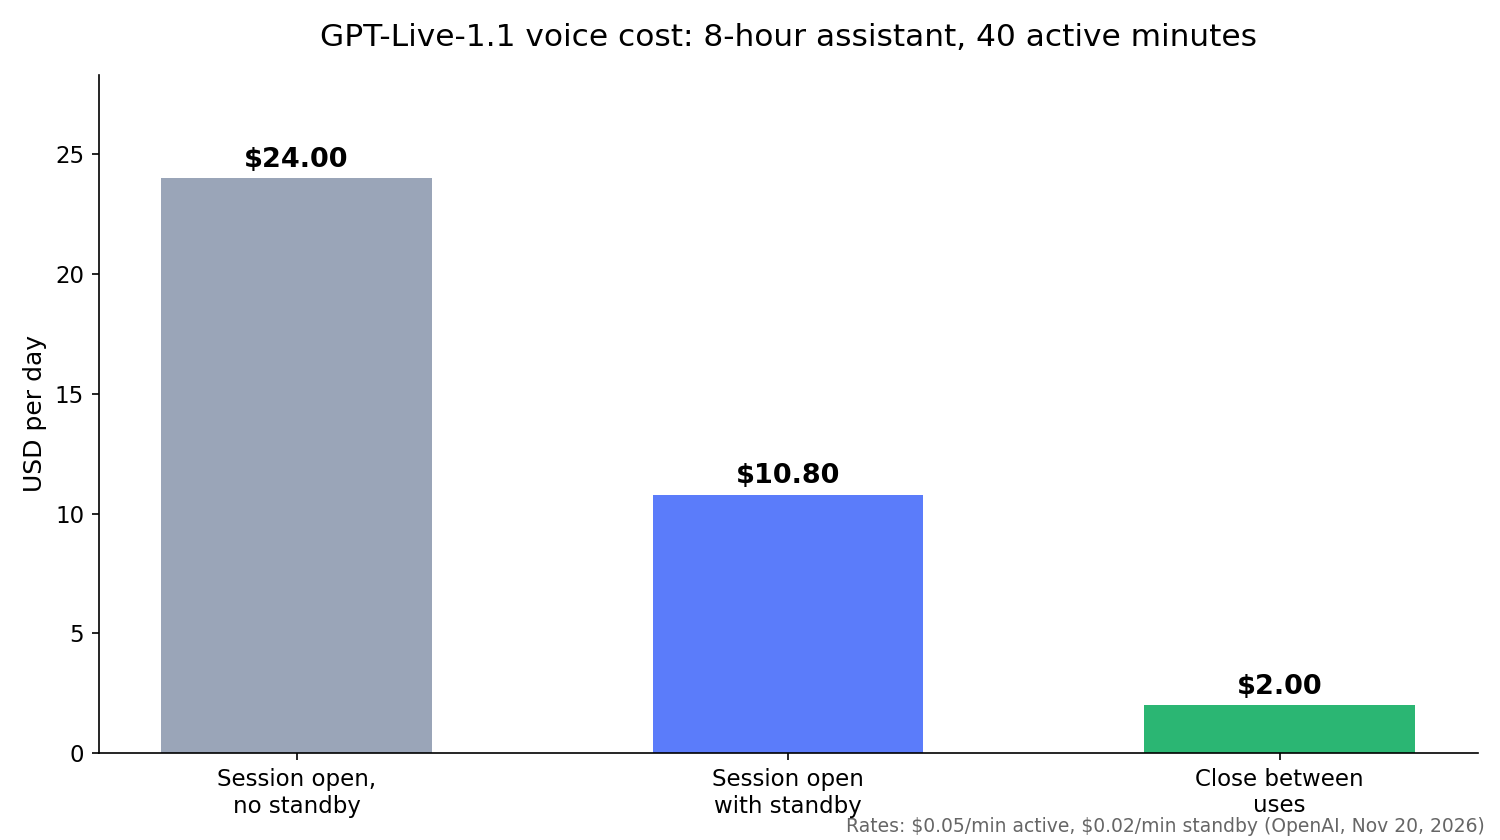
Một trợ lý được mở suốt ngày làm việc 8 giờ, nhưng người dùng chỉ nói chuyện với nó 40 phút theo từng đợt ngắn. Ở đây, chiến lược bạn chọn làm thay đổi hóa đơn hơn 10 lần:
| Chiến lược | Cách tính | Mỗi ngày | Mỗi tháng 22 ngày |
|---|---|---|---|
| Phiên mở, không chế độ chờ | 480 phút x $0,05 | $24,00 | $528,00 |
| Phiên mở, dùng chế độ chờ | 40 x $0,05 + 440 x $0,02 | $10,80 | $237,60 |
| Đóng phiên giữa các lần dùng | 40 phút x $0,05 | $2,00 | $44,00 |
Chế độ chờ vẫn tốn $1,20 mỗi giờ không hoạt động. Hướng dẫn của OpenAI khuyên nên đóng phiên trong các khoảng nghỉ dài và mở phiên mới, được khởi tạo từ lịch sử đã lưu, khi người dùng quay lại. Phí khởi tạo 15 giây được hoàn lại khi phiên mới chạy, nên chỉ tính riêng phí giọng nói thì việc đóng phiên luôn có lợi. Đổi lại, bạn mất khả năng kích hoạt tức thì: phiên đã đóng không nghe được người dùng, nên bạn cần push-to-talk hoặc cơ chế kích hoạt riêng của mình.
Idle timeout ảnh hưởng thế nào đến hóa đơn của bạn
Mỗi lần tạm dừng đều tính thời gian hoạt động cho đến khi idle timeout kích hoạt. Timeout ngắn hơn giúp đạt mức giá chờ rẻ hơn nhanh hơn, đổi lại là nhiều chu kỳ tạm dừng-tiếp tục hơn và phản hồi đầu tiên chậm hơn sau mỗi chu kỳ.
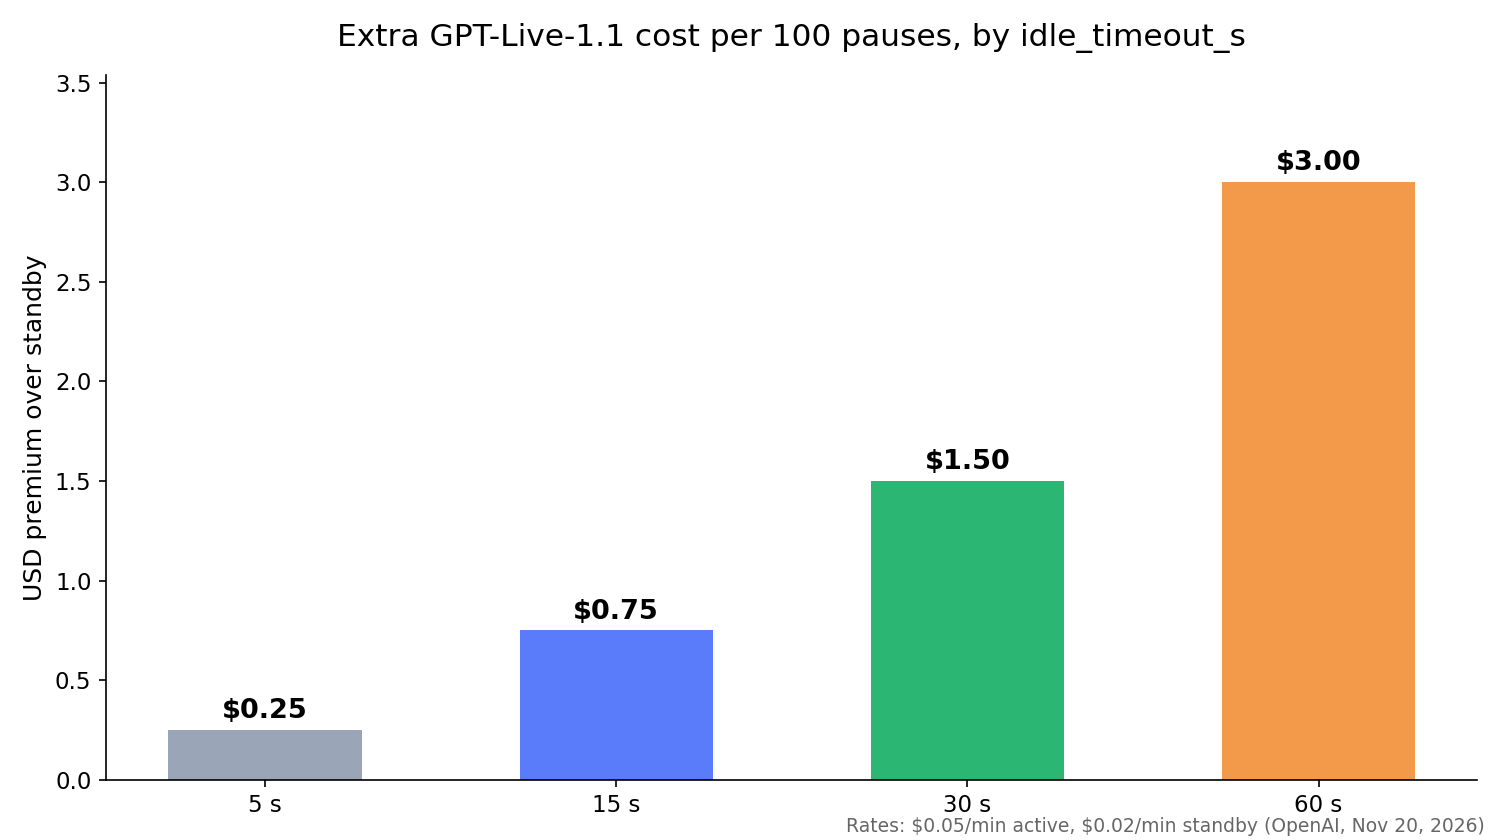
Phí phát sinh mỗi lần tạm dừng là độ dài timeout được tính theo khoảng chênh $0,03 giữa hai mức giá. Trên 100 lần tạm dừng trong một phiên hoặc một ngày:
idle_timeout_s |
Giây hoạt động mỗi lần tạm dừng | Chênh lệch so với chế độ chờ, mỗi 100 lần tạm dừng |
|---|---|---|
| 5 | 5 | $0,25 |
| 15 | 15 | $0,75 |
| 30 | 30 | $1,50 |
| 60 | 60 | $3,00 |
Số tiền nhỏ — và đó chính là ý: timeout chủ yếu là một cài đặt về trải nghiệm người dùng. Hãy chọn giá trị không làm cắt ngang người dùng giữa dòng suy nghĩ, rồi để chế độ chờ xử lý các khoảng nghỉ dài và việc đóng phiên xử lý các khoảng nghỉ rất dài.
So sánh giá GPT-Live-1.1 với GPT-Realtime
GPT-Live-1.1 tính phí theo phút; các model GPT-Realtime tính phí theo token. Trang giá của OpenAI liệt kê audio của gpt-realtime-2.1 với giá $32,00 mỗi 1M token đầu vào và $64,00 mỗi 1M token đầu ra, còn audio của gpt-realtime-2.1-mini là $10,00 và $20,00.
| GPT-Live-1.1 | GPT-Realtime-2.1 | |
|---|---|---|
| Đơn vị tính phí | Giây phiên | Token đầu vào và đầu ra |
| Mức giá giọng nói | $0,05/phút hoạt động, $0,02/phút chờ | $32 / $64 mỗi 1M audio token |
| Suy luận và công cụ | Model backend riêng | Bên trong cùng một model |
| Đường chi phí | Phẳng theo phút | Tăng theo lượt khi ngữ cảnh phình to |
Hướng dẫn chi phí của OpenAI lưu ý rằng một phiên Realtime gửi toàn bộ cuộc hội thoại cho model ở mỗi phản hồi, nên các lượt sau tốn kém hơn. Một phút GPT-Live tốn như nhau ở phút thứ 2 và phút thứ 40, giúp việc dự báo rất đơn giản. Hướng dẫn GPT-Realtime-2 API của chúng tôi đề cập đến cách thiết lập dựa trên token.
Theo dõi mức sử dụng và tránh hóa đơn bất ngờ
GPT-Live báo cáo tổng mức sử dụng giọng nói tính bằng giây thông qua các sự kiện session.usage.updated:
{
  "type": "session.usage.updated",
  "usage": { "seconds": 12 },
  "context_window": { "usage_ratio": 0.42 }
}
Mỗi bản cập nhật thay thế cho tổng trước đó, nên tuyệt đối không cộng dồn chúng. Hãy gửi session.close, chờ session.closed, và ghi nhận usage.seconds cuối cùng. Để tách thời gian hoạt động khỏi thời gian chờ, hãy đo các khoảng thời gian giữa các sự kiện session.paused và session.resumed.
Những thói quen giúp chi phí luôn ổn định:
- Đóng các phiên đã xong. Một phiên mở bị bỏ quên vẫn tiếp tục tính phí.
- Tăng tốc backend. Thời gian chờ một tác vụ ủy thác là thời gian hoạt động; hoàn thành sớm hơn một phút tiết kiệm $0,05.
- Đóng phiên trong các tác vụ dài. Đóng kết nối giọng nói khi backend đang xử lý và mở lại khi kết quả sẵn sàng.
- Lập kế hoạch cho tính đồng thời. Giới hạn tính theo số phiên đồng thời, và GPT-Live-1.1 có giới hạn riêng khác với GPT-Live-1, whose giới hạn công bố là 50 (Build), 300 (Launch) và 500 (Grow). Bậc Free không được hỗ trợ.
Dùng Codex kiểm tra sổ ghi chi phí của bạn với Apidog CLI
Sổ ghi mức sử dụng của bạn là mã nguồn bạn sở hữu, và một lỗi ở đó sẽ định giá sai mọi cuộc gọi. Hãy kiểm tra nó ở mỗi commit mà không cần mở phiên giọng nói, với chi phí giọng nói là $0, và để coding agent chạy các bài kiểm tra bằng Apidog CLI.
Cài CLI, đăng nhập, và thêm skill Apidog cho agent của bạn:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # chọn agent khi được hỏi
Sau đó đưa cho Codex một prompt duy nhất:
In Apidog project <projectId>, create a test case for POST /api/voice-usage.
Send {"session_id":"test-1","active_seconds":90,"standby_seconds":30} and assert
the response cost is 0.085 (90 s at $0.05/min plus 30 s at $0.02/min).
Add a second case with standby_seconds 0 that expects 0.075. Run both against
the local environment and summarize any failures.
Agent sẽ đọc schema, xác thực payload, tạo các test case và chạy chúng:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file ./case.json
apidog test-case create --project <projectId> --file ./case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Thay -r cli,json bằng -r junit thì cùng một lần chạy đó đưa thẳng vào CI; xem chạy Apidog CLI trong pipeline CI/CD. Hướng dẫn Apidog CLI với Codex trình bày chi tiết cách thiết lập agent. Gói Free của Apidog hỗ trợ nhóm tối đa 4 người dùng.
Câu hỏi thường gặp
GPT-Live-1.1 tốn bao nhiêu mỗi phút? $0,05 mỗi phút hoạt động và $0,02 mỗi phút chờ, tính theo giây. Mức sử dụng backend tính thêm.
GPT-Live-1.1 có đắt hơn GPT-Live-1 không? Không. OpenAI công bố cả hai với cùng mức giá hoạt động và chờ.
Chế độ chờ có hoạt động trên các cuộc gọi điện thoại không? Không. Mức giá chờ thấp hơn chỉ áp dụng cho các phiên WebRTC khi inference tạm dừng. Các phiên WebSocket và SIP tính thời gian kết nối theo mức giá hoạt động.
Các lệnh gọi model backend có được bao gồm trong giá theo phút không? Không. Các lệnh gọi Responses được ủy thác tính theo mức giá token của model được chọn, cộng thêm phí công cụ.
Câu hỏi về GPT-Live API từ tháng 7 thì sao? Thời điểm đó, GPT-Live chỉ là tính năng giọng nói của ChatGPT chưa có API, như bài giải thích GPT-Live API của chúng tôi đã nêu lúc bấy giờ. GPT-Live-1.1 chính là model API, được phục vụ trên v1/live/sessions.