
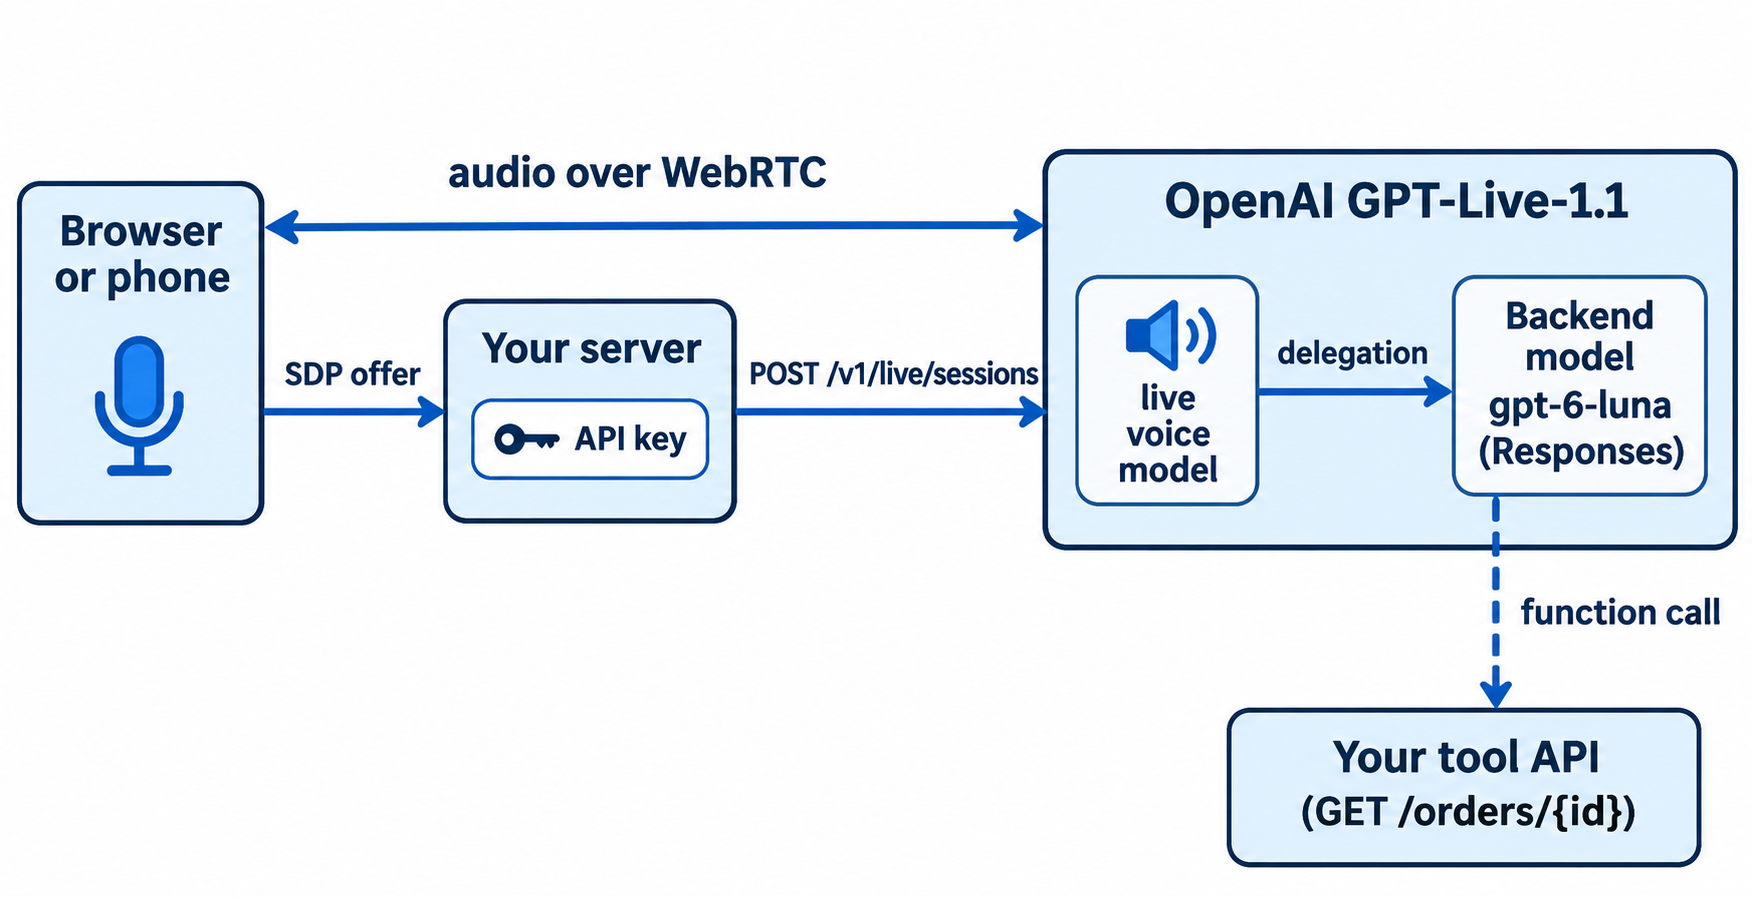
GPT-Live-1.1 API là mô hình thoại song công (full-duplex) của OpenAI, được phục vụ trên v1/live/sessions. Bạn mở một phiên qua WebRTC, WebSocket hoặc SIP, gửi cấu hình session chứa model, instructions và voice, rồi để nó giao việc suy luận và gọi công cụ cho một model Responses phía backend thông qua delegation. Giá là 0,05 USD mỗi phút hoạt động và 0,02 USD mỗi phút chờ.
OpenAI đã đưa GPT-Live-1.1 lên API vào ngày 20 tháng 11 năm 2026, theo thông báo của OpenAI Developers. Nếu bạn đọc bài của chúng tôi vào tháng 7, Is there a GPT-Live API? đã trả lời là "chưa có". Điều đó đã thay đổi. Bài hướng dẫn này sẽ đưa bạn đi qua một phiên hoạt động thực tế, một cấu hình delegation, một function tool, và một thiết lập kiểm thử cho backend mà voice agent của bạn gọi tới.
GPT-Live-1.1 API là gì?
GPT-Live-1.1 là mô hình nhận đầu vào là giọng nói và xuất ra giọng nói, có thể lắng nghe trong khi đang nói. Nó chạy trên endpoint v1/live/sessions, chứ không phải v1/realtime hay v1/responses. Nhiệm vụ riêng của nó là cuộc hội thoại. Các tác vụ suy luận nặng và sử dụng công cụ được giao cho một model backend mà bạn cấu hình, nhờ vậy phần thoại vẫn phản hồi nhanh trong khi công việc đang chạy.
Dưới đây là những gì trang model GPT-Live-1.1 liệt kê hiện nay:
| Hạng mục | GPT-Live-1.1 |
|---|---|
| Model ID | gpt-live-1.1 (một snapshot duy nhất) |
| Đầu vào / đầu ra | Nhận âm thanh và văn bản, xuất âm thanh và văn bản |
| Endpoint | Chỉ v1/live/sessions |
| Transport | WebRTC (khuyên dùng), WebSocket, SIP |
| Giá khi hoạt động | 0,05 USD mỗi phút |
| Giá khi chờ | 0,02 USD mỗi phút (WebRTC, suy luận tạm dừng) |
| Model backend và công cụ | Tính phí riêng theo giá thông thường |
| Đồng thời | Giới hạn riêng, khác với GPT-Live-1, tính theo tổ chức |
Để hiểu bối cảnh sản phẩm, xem bài GPT-Live là gì và nó khác với GPT Realtime ra sao.
GPT-Live-1.1 so với GPT-Live-1: những gì đã thay đổi
Trang model và hướng dẫn prompting liệt kê bốn điểm khác biệt thiết thực:
- Chép lời (transcription): bản 1.1 "chép lời chính xác hơn".
- Giọng nói: bản 1.1 giữ được "accent và giọng nói nhất quán hơn giữa các ngôn ngữ".
- Prompt delegation: bản 1.1 chấp nhận ngôn ngữ tự nhiên ("Delegate to the backend when:"). GPT-Live-1 yêu cầu marker
<|SpawnThinking|>trong policy. - Cách ghi chú tính phí: GPT-Live-1 được tính theo giây và không bao giờ làm tròn lên cả phút. Trang của 1.1 chỉ ghi "tính theo thời lượng".
Cả hai model dùng chung endpoint, giá và cấu trúc phiên, nên việc chuyển sang 1.1 chủ yếu là đổi chuỗi tên model cùng một prompt gọn gàng hơn.
Cách mở một phiên GPT-Live-1.1
Hướng dẫn bắt đầu với GPT-Live khuyên dùng WebRTC cho âm thanh trên trình duyệt, di động và server. WebSocket là lộ trình đơn giản hơn cho một prototype phía server, nên hãy bắt đầu từ đó:
- Mở kết nối tới
wss://api.openai.com/v1/live/sessionsvới headerAuthorization: Bearer $OPENAI_API_KEY, không có tham số query. - Gửi
session.startlàm tin nhắn đầu tiên, kèm cấu hìnhsessioncủa bạn. - Chờ
session.startedtrước khi gửi âm thanh. - Stream âm thanh theo định dạng bạn đã chọn. Mặc định là PCM 24 kHz.
import WebSocket from "ws";

const ws = new WebSocket("wss://api.openai.com/v1/live/sessions", {
  headers: { Authorization: `Bearer ${process.env.OPENAI_API_KEY}` },
});

ws.on("open", () => {
  ws.send(JSON.stringify({
    type: "session.start",
    event_id: "start_1",
    session: {
      model: "gpt-live-1.1",
      instructions: "You are the voice agent for Acme order support. Keep answers short.",
      audio: {
        format: { type: "audio/pcm", rate: 24000 },
        output: { voice: "marin" },
      },
    },
  }));
});

ws.on("message", (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type === "session.started") console.log("Session ready");
});
Một số quy tắc cấu hình từ hướng dẫn hội thoại:
instructionsnhận tối đa 16.384 token. Có thể bổ sung giữa phiên bằngsession.instructions.append(500 token mỗi lần).audio.output.voicemặc định làmarin. Các tên khác trên API gồmquartz,stone,meridianvàwillow.- Định dạng WebSocket là
audio/pcmở 24.000 hoặc 16.000 Hz, vàaudio/pcmuhoặcaudio/pcmaở 8.000 Hz cho điện thoại. storemặc định làfalse. Việc đổimodelcần một phiên mới.
Cho môi trường production trên trình duyệt, hãy chuyển sang WebRTC. Server của bạn giữ API key và chuyển tiếp SDP offer từ trình duyệt:
const res = await fetch("https://api.openai.com/v1/live/sessions", {
  method: "POST",
  headers: {
    Authorization: `Bearer ${process.env.OPENAI_API_KEY}`,
    "Content-Type": "application/json",
  },
  body: JSON.stringify({
    session: { model: "gpt-live-1.1", instructions: "..." },
    transport: { type: "webrtc", sdp: offerSdp },
  }),
});
const { session, transport } = await res.json(); // HTTP 201
// session.id looks like "live_123"; return transport.sdp to the browser
Đừng đưa audio.format vào các yêu cầu WebRTC, và đừng gửi session.start trên data channel. Lưu ý một chi tiết về tính phí: việc tạo phiên WebRTC sẽ tính phí 15 giây trong quá trình khởi tạo, số tiền này được hoàn lại khi phiên chạy.
Delegation của GPT-Live-1.1: để model backend đảm nhận phần suy luận
Delegation chính là lý do API này tồn tại. Model thoại tiếp tục nói chuyện trong khi một model backend suy luận, tìm kiếm hay gọi công cụ. Bạn chọn một trong hai chế độ ngay lúc tạo phiên, và không thể chuyển chế độ giữa phiên.
| Chế độ | delegation.type |
Ai vận hành backend | Phù hợp nhất cho |
|---|---|---|---|
| Responses | "responses" |
OpenAI, dùng model và công cụ bạn cấu hình | Đa số ứng dụng; hosted tools, function calling |
| Client | "client" (cũng là mặc định) |
Ứng dụng của bạn | Vòng lặp agent riêng của bạn hoặc backend không phải OpenAI |
Hướng dẫn delegation khuyên bắt đầu với gpt-6-luna và thử gpt-6-sol cho các tác vụ backend khó hơn. Nếu bạn chưa chọn được, bài tổng quan GPT-6 Luna của chúng tôi phân tích các đánh đổi.
"delegation": {
  "type": "responses",
  "responses": {
    "model": "gpt-6-luna",
    "instructions": "Look up orders with get_order. Answer in one sentence.",
    "tools": [{ "type": "web_search" }],
    "tool_choice": "auto",
    "parallel_tool_calls": false
  }
}
Khối responses cũng nhận max_output_tokens (16 trở lên), service_tier (auto, default, flex hoặc priority, trong đó priority là chế độ nhanh) cùng các thiết lập reasoning và text mà model backend của bạn hỗ trợ. Bạn có thể thay đổi các trường này giữa phiên bằng session.update. Việc kiểm tra tính hợp lệ diễn ra không đồng bộ: một cấu hình sai sẽ đến dưới dạng error với mã responses_validation_failed, và phiên vẫn giữ mở.
Sau đó, hãy nói cho model thoại biết khi nào cần delegate. Với bản 1.1, điều này là ngôn ngữ tự nhiên trong instructions:
Delegate to the backend when: the caller asks about an order, a refund or anything you must look up.
Do not delegate when: the caller greets you, asks you to repeat, or says goodbye.
While the backend works, briefly say what you are checking.
Hướng dẫn prompting cảnh báo rằng một câu nói "Tôi đang kiểm tra" bằng giọng nói không chứng minh backend đã bắt đầu làm việc. Thay vào đó, hãy theo dõi sự kiện session.delegation.created trong log của bạn.
Thêm function calling vào một phiên GPT-Live-1.1
Các hosted tool như tìm kiếm web chạy bên trong OpenAI. Các hàm của riêng bạn chạy trong ứng dụng của bạn. Đặt một function tool chuẩn của Responses vào delegation.responses.tools:
{
  "type": "function",
  "name": "get_order",
  "description": "Get the shipping status of an order by its ID.",
  "parameters": {
    "type": "object",
    "properties": { "order_id": { "type": "string" } },
    "required": ["order_id"],
    "additionalProperties": false
  },
  "strict": true
}
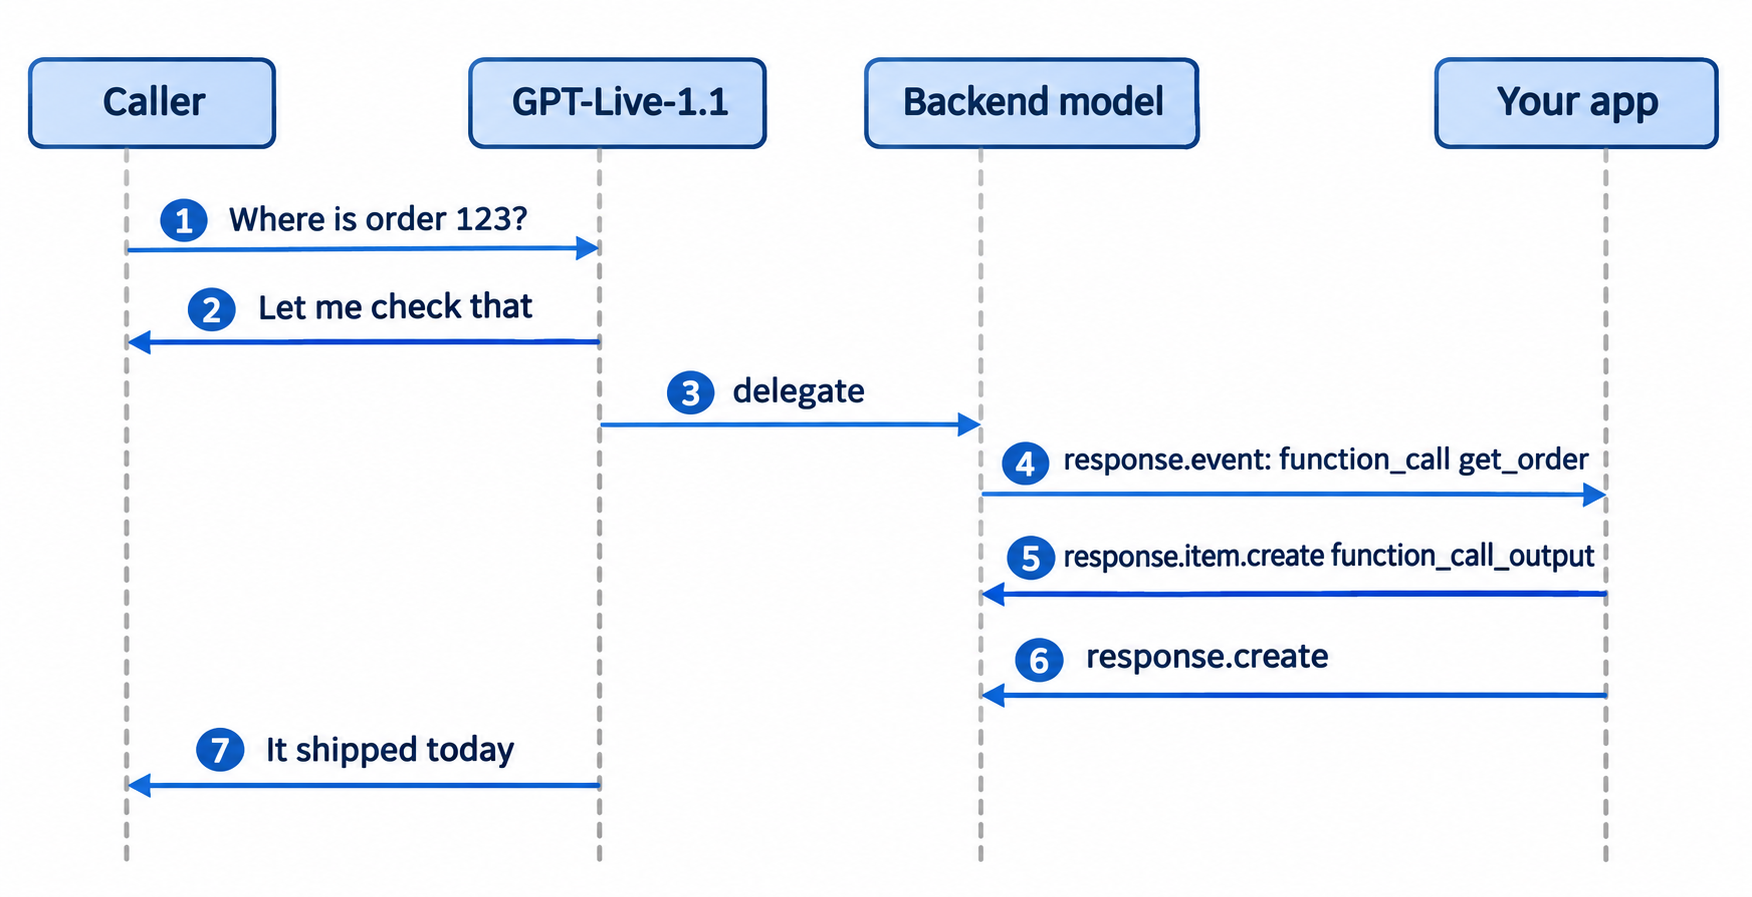
Các sự kiện từ backend đến với bạn trong một envelope response.event mang delegation_id và một event lồng bên trong. Một lời gọi hàm hoàn tất sẽ đến dưới dạng response.output_item.done lồng nhau, với item chứa call_id, name và arguments. Chạy hàm, gửi một response.item.create kèm kết quả, rồi gửi response.create:
ws.on("message", async (raw) => {
  const msg = JSON.parse(raw);
  if (msg.type !== "response.event") return;
  const ev = msg.event;
  if (ev.type !== "response.output_item.done" || ev.item?.type !== "function_call") return;

  const { order_id } = JSON.parse(ev.item.arguments);
  const order = await fetch(`${ORDERS_API}/orders/${order_id}`).then((r) => r.json());

  ws.send(JSON.stringify({
    type: "response.item.create",
    item: { type: "function_call_output", call_id: ev.item.call_id, output: JSON.stringify(order) },
  }));
  ws.send(JSON.stringify({ type: "response.create" }));
});
Ba chi tiết dễ khiến người dùng vấp:
- Chỉ thêm kết quả đầu ra thì không giúp backend tiếp tục. Bạn cần
response.create. - Bỏ sót một kết quả đang chờ và bạn sẽ nhận
function_call_outputs_required. Các giá trịcall_idtrùng lặp hoặc không khớp sẽ bị từ chối. - Sự kiện
response.completedđược chuyển tiếp córesponse.outputrỗng. Hãy đọc các sự kiện output-item riêng lẻ.
Giá và giới hạn của GPT-Live-1.1
Chi phí thời gian thoại rất dễ tính toán. Một cuộc gọi hỗ trợ 5 phút duy trì hoạt động suốt cả cuộc sẽ tốn 5 × 0,05 USD = 0,25 USD cho thời gian thoại. Một nghìn cuộc như vậy là 250 USD, chưa kể phần model backend và công cụ tính phí theo giá thông thường của chúng.
| Khoản chi phí | Mức giá |
|---|---|
| Thoại khi hoạt động | 0,05 USD mỗi phút |
| Thoại khi chờ (WebRTC, suy luận tạm dừng) | 0,02 USD mỗi phút |
| Khởi tạo WebRTC | 15 giây, được hoàn lại khi phiên chạy |
| Model backend và công cụ | Giá thông thường của model và công cụ đó |
Giới hạn tốc độ tính theo số phiên đồng thời, không phải theo token. GPT-Live-1.1 và GPT-Live-1 có các giới hạn riêng, áp dụng trên mọi vùng suy luận. Trang GPT-Live-1 liệt kê 50, 300 và 500 phiên đồng thời cho các gói Build, Launch và Grow, không có quyền truy cập cho gói Free. Trang của 1.1 không đưa ra con số nào, nên hãy kiểm tra trang giới hạn của tổ chức bạn trước khi ra mắt.
Dùng coding agent của bạn để kiểm thử backend công cụ với Apidog CLI
Voice agent của bạn chỉ đáng tin cậy bằng đúng mức độ của API đứng sau get_order. Một phản hồi chậm hoặc sai định dạng sẽ biến thành khoảng lặng im lặng hoặc một câu trả lời sai được đọc to. Vì vậy, hãy kiểm thử backend đó trước khi bất kỳ người gọi nào nghe thấy nó, và để coding agent của bạn làm việc đó với Apidog CLI.
Cài đặt một lần duy nhất:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
Sau đó đưa Claude Code, Codex hoặc Cursor một prompt duy nhất:
Import ./orders-openapi.yaml into Apidog project <projectId>. Create test cases for
GET /orders/{order_id}: a known ID returns 200 with a status field in under 800 ms,
and an unknown ID returns 404 with a JSON error. Run them against the staging
environment and tell me what failed.
Agent sẽ đọc schema, kiểm tra payload của nó, tạo các test case và chạy chúng:
apidog import --project <projectId> --format openapi --file ./orders-openapi.yaml
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Ngưỡng 800 ms rất quan trọng với giọng nói: người gọi sẽ cảm nhận từng mili giây mà công cụ của bạn tiêu tốn. Đặt cùng lệnh apidog run với -r junit vào CI để một lỗi hồi quy làm fail bản build, như trong hướng dẫn Apidog CLI CI/CD của chúng tôi. Mới làm quen với quy trình agent? Hãy bắt đầu với Apidog CLI trong Claude Code. Gói Free của Apidog hỗ trợ tới 4 người dùng.
Câu hỏi thường gặp
GPT-Live-1.1 đã có trên API chưa? Có. Từ ngày 20 tháng 11 năm 2026, bạn có thể gọi gpt-live-1.1 trên v1/live/sessions qua WebRTC, WebSocket hoặc SIP. Nó không được phục vụ trên v1/realtime, v1/responses hay Chat Completions.
GPT-Live-1.1 API giá bao nhiêu? 0,05 USD mỗi phút hoạt động và 0,02 USD mỗi phút chờ. Các lượt gọi model backend và công cụ được tính phí riêng theo giá của riêng chúng.
GPT-Live-1.1 khác GPT Realtime ở điểm nào? GPT-Live chạy trên endpoint riêng, tính phí theo thời lượng thoại, và giao việc suy luận cho một model backend thông qua delegation. GPT Realtime chạy trên v1/realtime. Xem bài so sánh GPT-Live vs GPT Realtime của chúng tôi.
Nên dùng model backend nào cho delegation? Hướng dẫn của OpenAI khuyên dùng gpt-6-luna để bắt đầu và gpt-6-sol cho các tác vụ backend phức tạp hơn. Đặt service_tier thành priority nếu độ trễ quan trọng hơn chi phí.
Có thể dùng agent riêng thay cho model Responses không? Có. Đặt delegation.type thành client. Ứng dụng của bạn tự chạy phần backend và gửi kết quả về bằng session.commentary.append. Bạn cũng phải tự quản lý transcript.
GPT-Live-1.1 có hỗ trợ function calling không? Có, thông qua delegation kiểu Responses. Định nghĩa các hàm trong delegation.responses.tools, đọc các lời gọi từ response.event, và trả kết quả bằng response.item.create cùng response.create.