
OpenAI đã phát hành ChatGPT Images 2.5 vào ngày 8 tháng 9 năm 2026, với hai mô hình API: gpt-image-2.5-flare và gpt-image-2.5-sunburst. Cả hai đều tính phí theo tỷ lệ trên mỗi token giống như gpt-image-2, và cả hai đều có một mục duy nhất trong công cụ tính giá của OpenAI. Do đó, bảng giá trên mỗi token sẽ không giúp bạn lựa chọn. Điều thay đổi là thang chất lượng bên dưới nó, và việc đổi nhãn đã làm giá của một hình ảnh quality: "high" tăng lên khoảng 4 lần.
Đây là trang quyết định: tỷ lệ trên mỗi token, ước tính trên mỗi hình ảnh cho tất cả năm cấp độ chất lượng 2.5 bên cạnh các con số của gpt-image-2, việc đổi nhãn, ngân sách 10.000 hình ảnh mỗi tháng, tin đồn “giá gấp đôi”, và danh sách kiểm tra di chuyển. Nếu bạn muốn cú pháp yêu cầu trước, hãy đọc cách sử dụng API gpt-image-2.5. Trang giá của OpenAI là nguồn cho mọi tỷ lệ dưới đây. Mỗi con số trên mỗi hình ảnh là ước tính từ công cụ tính, vì OpenAI cảnh báo rằng mức tiêu thụ token “có thể khác nhau tùy theo mô hình và cài đặt chất lượng”; hóa đơn của bạn đến từ usage.output_tokens trong phản hồi.
Tỷ lệ trên mỗi token: giống hệt nhau trên cả ba
Trang giá của OpenAI liệt kê các mức giá cấp Tiêu chuẩn giống nhau cho cả hai mô hình 2.5, và mỗi trang mô hình đều nêu rằng “Tỷ lệ token của nó khớp với GPT Image 2”. Dưới đây là bảng đầy đủ, bao gồm hàng Batch đã gây nhầm lẫn khi ra mắt.
| Mô hình | Đầu vào hình ảnh | Đầu vào hình ảnh được cache | Đầu ra hình ảnh | Đầu vào văn bản | Đầu vào văn bản được cache |
|---|---|---|---|---|---|
gpt-image-2.5-sunburst |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2.5-flare |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2 (Standard) |
$8.00 | $2.00 | $30.00 | $5.00 | $1.25 |
gpt-image-2 (Batch, 50% off) |
$4.00 | $1.00 | $15.00 | $2.50 | $0.625 |
Tất cả các số liệu đều trên 1 triệu token. Đầu ra chỉ là hình ảnh trên mỗi mô hình ở đây, vì vậy đầu ra văn bản không bao giờ xuất hiện trên hóa đơn.
Về tuyên bố “giá gấp đôi” trong một số thông tin ban đầu: nó xuất phát từ việc so sánh hàng Tiêu chuẩn 2.5 với hàng Batch của gpt-image-2, vốn là một khoản giảm giá 50%. So sánh Tiêu chuẩn với Tiêu chuẩn trên trang giá và mọi tỷ lệ đều không thay đổi.
Mỗi hình ảnh có giá bao nhiêu ở mỗi cấp độ chất lượng
Sự tương đồng về token trên mỗi token kết thúc ở đây. Công cụ tính của OpenAI (đọc ngày 09-09-2026) báo cáo số lượng token đầu ra hình ảnh này dưới một mục chung, “GPT Image 2.5 (Sunburst và Flare)”. Chi phí là số token nhân với $30 trên 1 triệu, chỉ tính token đầu ra.
| Chất lượng | Token 1024x1024 | Chi phí 1024x1024 | Token 1536x1024 | Chi phí 1536x1024 |
|---|---|---|---|---|
| low | 196 | $0.00588 | 158 | $0.00474 |
| medium | 439 | $0.01317 | 343 | $0.01029 |
| high | 1,756 | $0.05268 | 1,372 | $0.04116 |
| xhigh | 3,122 | $0.09366 | 2,459 | $0.07377 |
| max | 7,024 | $0.21072 | 5,488 | $0.16464 |
Dưới đây là bảng gpt-image-2 từ cùng trang tài liệu, cho cùng kích thước.
| Chất lượng | 1024x1024 | 1536x1024 (và 1024x1536) |
|---|---|---|
| low | $0.006 | $0.005 |
| medium | $0.053 | $0.041 |
| high | $0.211 | $0.165 |
Có hai điều nổi bật. Kích thước ngang rẻ hơn kích thước vuông ở mỗi hàng, một quy tắc được tài liệu của OpenAI đề cập. Và hàng 2.5 high không hề gần với hàng high của gpt-image-2. Đó chính là việc đổi nhãn.
Văn bản prompt và hình ảnh tham chiếu sẽ được tính thêm phí. Một hình ảnh tham chiếu được gửi đến images/edits sẽ tốn token đầu vào hình ảnh với giá $8 trên 1 triệu; OpenAI không công bố số lượng token đầu vào trên mỗi hình ảnh, vì vậy hãy đọc nó từ usage.input_tokens.
Thang chất lượng đã được đổi nhãn
So khớp ngân sách token và sự tương ứng sẽ rõ ràng. Trên 2.5, high là 1.756 token đầu ra, ngân sách mà gpt-image-2 đã chi cho medium. Trên 2.5, max là 7.024 token, ngân sách mà gpt-image-2 đã chi cho high. low không thay đổi ở mức 196 token.
| Nhãn 2.5 | Token (1024x1024) | Chi phí 2.5 | Cùng ngân sách trên gpt-image-2 | Chi phí gpt-image-2 |
|---|---|---|---|---|
| low | 196 | $0.00588 | low | $0.006 |
| medium | 439 | $0.01317 | không có (dưới mức medium cũ) | n/a |
| high | 1,756 | $0.05268 | medium | $0.053 |
| xhigh | 3,122 | $0.09366 | không có (giữa mức medium cũ và high cũ) | n/a |
| max | 7,024 | $0.21072 | high | $0.211 |
Vì vậy, một quá trình chuyển đổi giữ nguyên quality: "high" sẽ rẻ hơn khoảng 4 lần trên mỗi hình ảnh và hiển thị ở ngân sách medium cũ. Một quá trình muốn ngân sách high cũ phải chuyển sang max, với giá về cơ bản là bằng giá cũ. xhigh là một cấp độ trung gian mới không có tương đương trong gpt-image-2.
Tính toán hàng tháng, được suy ra từ ước tính của công cụ tính OpenAI ở 1024x1024:
- 10.000 hình ảnh ở 2.5
high: 10.000 x $0.05268 = $526.80 - 10.000 hình ảnh ở gpt-image-2
high: 10.000 x $0.211 = $2.110 - 10.000 hình ảnh ở 2.5
max: 10.000 x $0.21072 = $2.107.20, về cơ bản giống nhưhighcũ - Phát trực tuyến với
partial_images: 3thêm 300 token, hoặc $0.009 cho mỗi hình ảnh, vì mỗi phần tốn 100 token đầu ra hình ảnh
Flare so với Sunburst: sự cao cấp mang lại điều gì
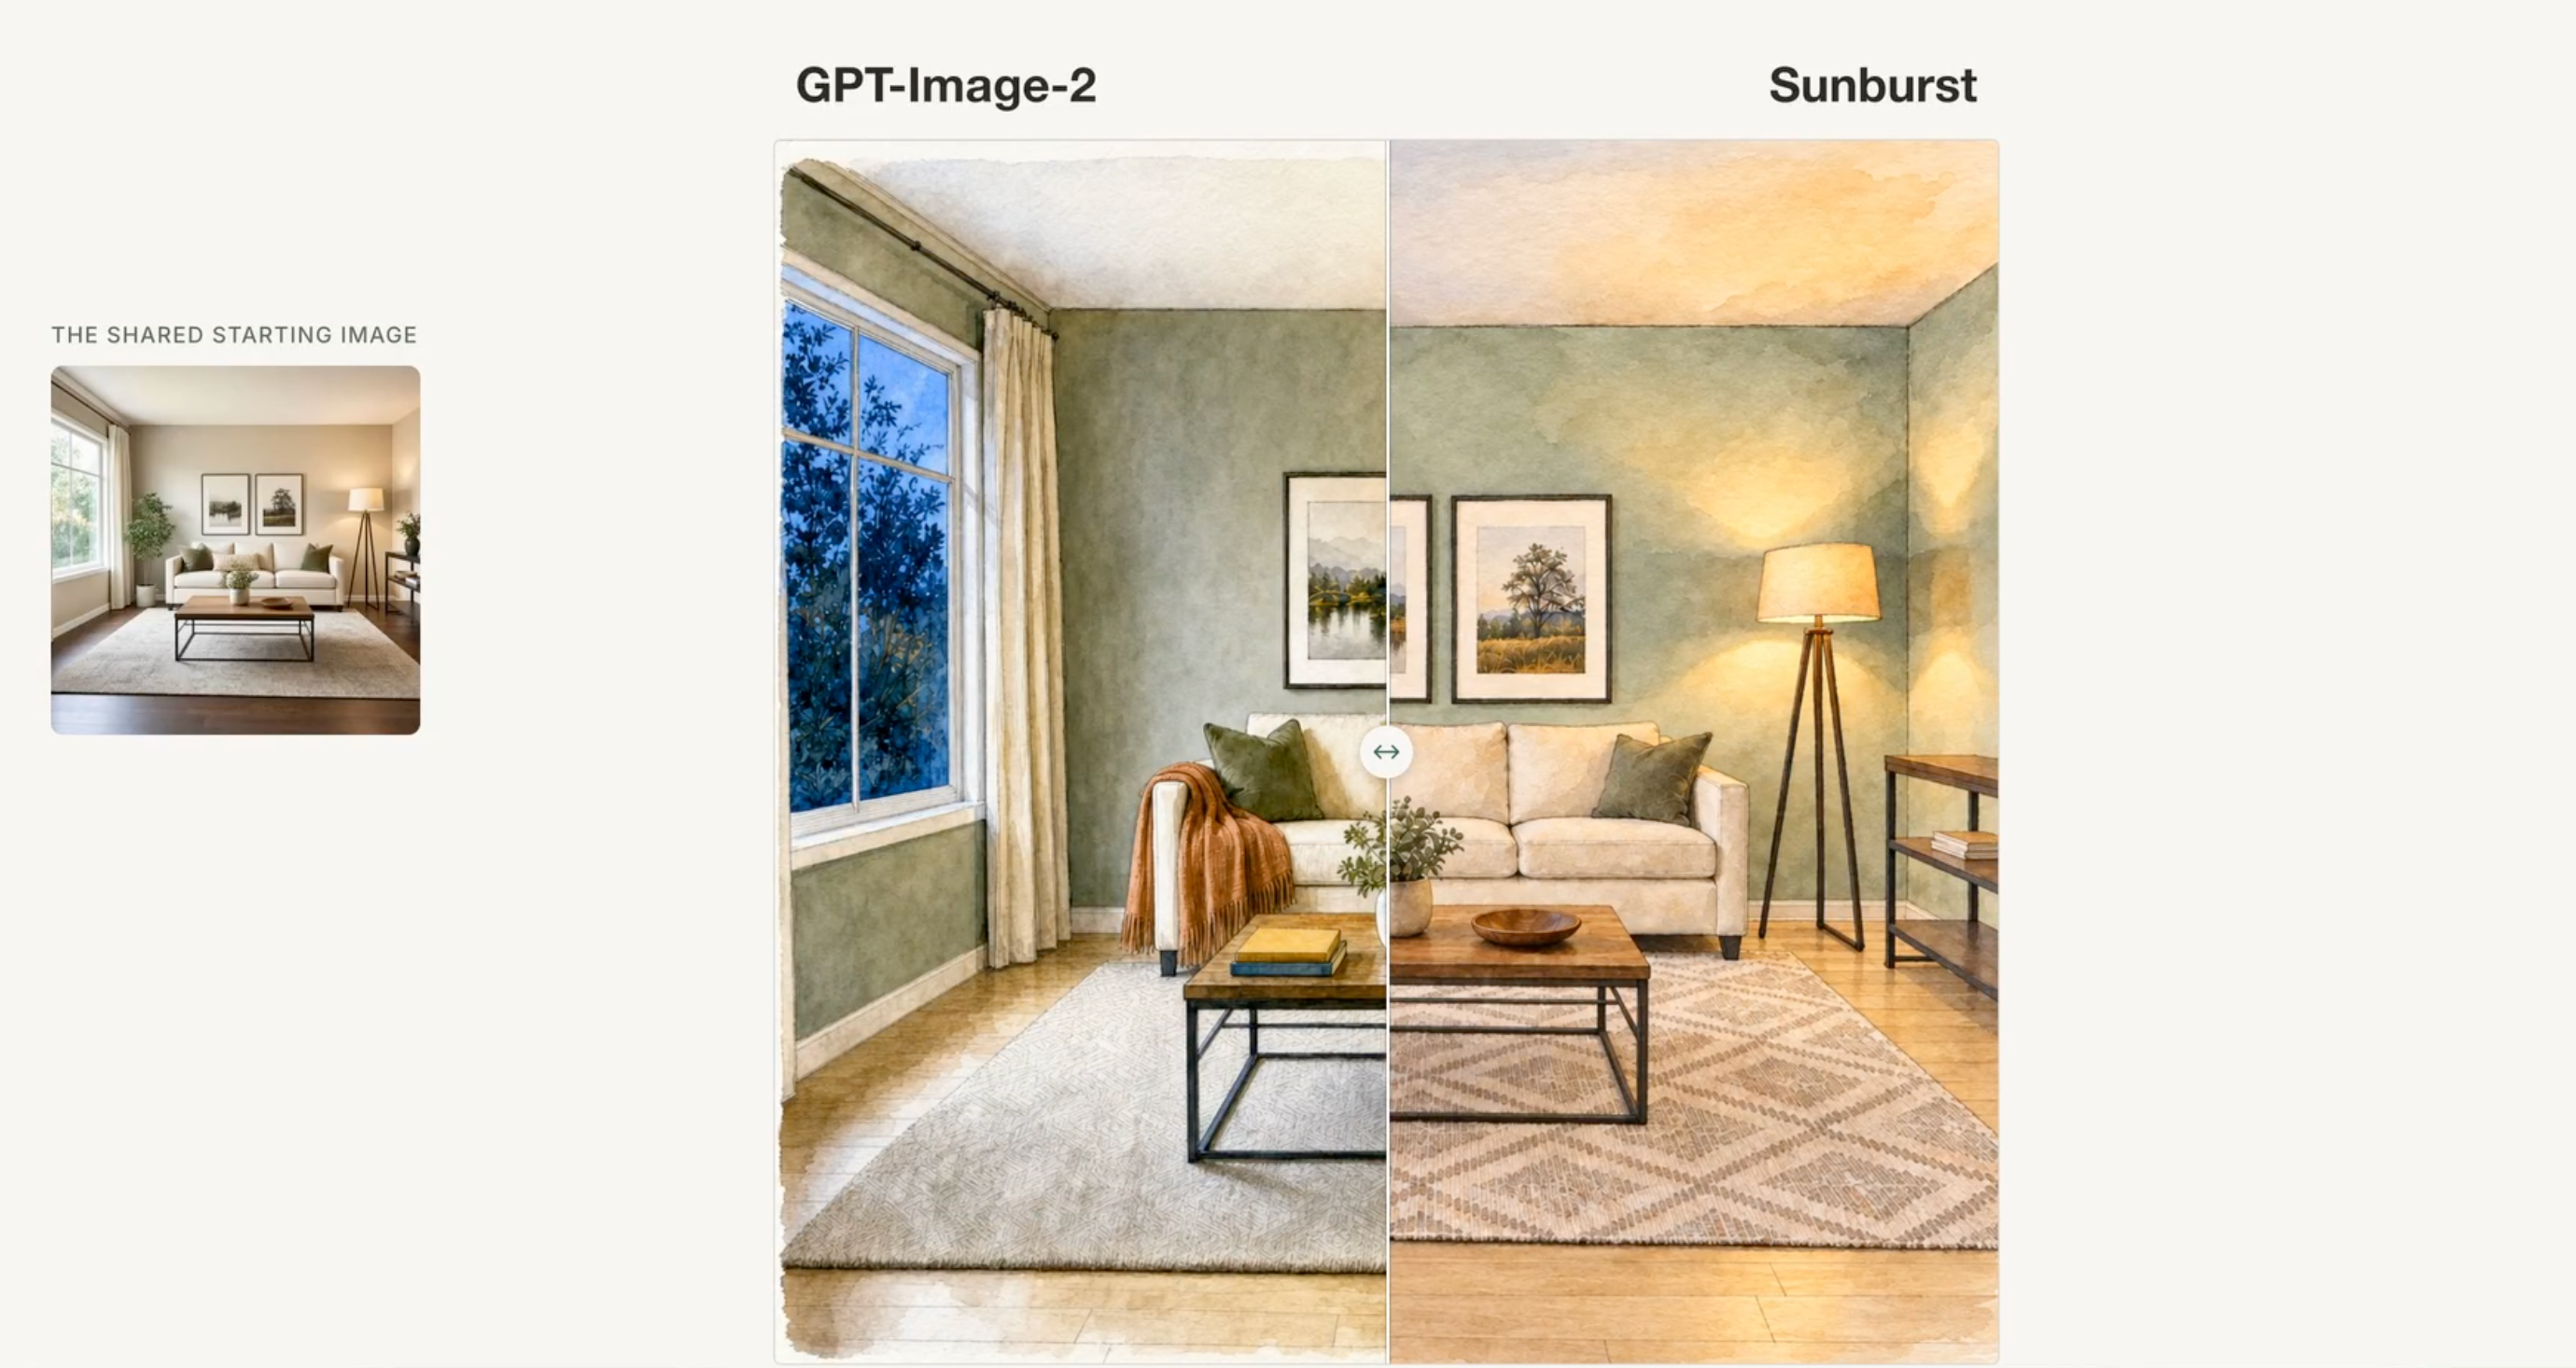
Cả hai mô hình đều có chung một mục trong công cụ tính toán, vì vậy số lượng token được ghi nhận là giống hệt nhau. Sunburst không tốn thêm chi phí cho mỗi hình ảnh; sự khác biệt là thời gian. Bài đăng ra mắt của OpenAI hướng Flare đến “tạo ảnh khối lượng lớn” và Sunburst đến “quy trình làm việc hình ảnh cao cấp được hưởng lợi từ việc kiểm soát chặt chẽ hơn trong các chỉnh sửa”. Tài liệu tóm gọn nó thành một dòng: “Chọn Sunburst cho các quy trình làm việc mà độ chính xác chỉnh sửa quan trọng nhất, và Flare để tạo ảnh hàng ngày nhanh chóng, chất lượng cao.”
Tín hiệu cộng đồng, được gắn nhãn như sau:
- Trong luồng HN, người dùng jjcm, người đã báo cáo khoảng 50.000 hình ảnh thông qua gpt-image-2 cho một công cụ thiết kế giao diện người dùng AI, cho biết độ trễ trung bình “duy trì ở khoảng 104s” trên gpt-image-2 và hình ảnh 2.5 “đến trong khoảng 35-40s”. Một điểm dữ liệu, một khối lượng công việc; tuyên bố riêng của OpenAI là độ trễ giảm “lên đến 50%”.
- Bảng xếp hạng text-to-image của Arena (phiếu bầu cộng đồng, cập nhật ngày 7 tháng 9 năm 2026) xếp Sunburst thứ nhất với 1421 điểm, Flare thứ hai với 1399 điểm, gpt-image-2 ở mức trung bình thứ ba với 1381 điểm, sau đó là mai-image-2.6 của Microsoft với 1331 điểm; Nano Banana 2 đứng ở 1261 điểm. Trên bảng xếp hạng chỉnh sửa hình ảnh, khoảng cách mở rộng: Sunburst 1520, Flare 1491, gpt-image-2 1461. Đây là điểm số ưu tiên của cộng đồng, không phải các tiêu chuẩn của OpenAI.
Quy tắc quyết định: mặc định dùng Flare. Chuyển sang Sunburst cho các quy trình làm việc chỉnh sửa nhiều lượt, nơi đối tượng tham chiếu phải tồn tại qua nhiều vòng hướng dẫn. Khoảng cách của Arena là 22 điểm trên text-to-image và 29 điểm trên chỉnh sửa, điều này ủng hộ quan điểm của OpenAI rằng chỉnh sửa là nơi Sunburst xứng đáng với thời gian chờ đợi. Nếu khoảng cách đó không xuất hiện trên các prompt của riêng bạn, bạn đang trả tiền cho độ trễ mà không thu được gì.
Khi nào gpt-image-2 vẫn có ý nghĩa
- Giảm giá theo lô (Batch). Tab Batch của trang giá chỉ liệt kê
gpt-image-2, với giá $15 cho mỗi 1 triệu token đầu ra; việc/v1/batchcó chấp nhận các ID 2.5 hay không vẫn chưa được ghi nhận vào thời điểm viết bài. Nếu khối lượng công việc của bạn chấp nhận được thời gian xử lý của Batch API, thì gpt-image-2 ở Batchmedium(một nửa của $0.053) sẽ rẻ hơn 2.5highvới giá Tiêu chuẩn cho cùng ngân sách token. - Các phiên bản cố định (Pinned snapshots).
gpt-image-2-2026-04-21đã được phát hành từ tháng 4 mà không có thông báo ngừng hỗ trợ tính đến ngày 09-09-2026. Nếu quy trình của bạn phụ thuộc vào đầu ra đã được ai đó xem xét trực quan, một phiên bản không thay đổi là một tính năng; hướng dẫn API gpt-image-2 của chúng tôi bao gồm các tham số của nó. Để có một điểm neo so sánh giữa các nhà cung cấp, hãy so sánh giá API Nano Banana 2 và API FLUX.2 ở cùng kích thước đầu ra; 2.5highvới giá khoảng năm xu cho mỗi hình vuông là con số cần vượt qua.
Danh sách kiểm tra di chuyển từ gpt-image-2 sang 2.5
- Hoán đổi ID mô hình.
gpt-image-2trở thànhgpt-image-2.5-flare(hoặc-sunburst); ghimgpt-image-2.5-flare-2026-09-08để có đầu ra ổn định. - Ánh xạ lại các nhãn chất lượng.
mediumcũ trở thànhhighmới,highcũ trở thànhmaxmới,lowvẫn làlow. Thực hiện điều này trong cấu hình, không phải tại mỗi điểm gọi. - Cân nhắc
xhighvàmax. Cả hai đều mới trong 2.5;xhighvới 3.122 token nằm giữa ngân sáchmediumcũ vàhighcũ. - Bỏ các giả định về
thinking. Tài liệu 2.5 không mô tả tham sốthinking; hãy xóa nó khỏi các mẫu thay vì giả định rằng nó được chấp nhận hoặc bỏ qua. - Đo lại
usage. Ghi lạiusage.output_tokensvàusage.input_tokenstrong một tuần với các prompt thực tế; các con số của công cụ tính chỉ là ước tính. - Kiểm tra khả năng đủ điều kiện Batch. Nếu bạn dựa vào chiết khấu 50% Batch, hãy xác nhận
/v1/batchchấp nhận các ID 2.5 trước khi bạn chuyển đổi.
So sánh cả ba mô hình trong Apidog với một yêu cầu đã lưu
Apidog là một công cụ kiểm thử và client API. Nó gửi yêu cầu images/generations và xác nhận phản hồi; nó không tạo hình ảnh hoặc chạy mô hình. Điều đó làm cho nó trở thành nơi để quyết định Flare so với Sunburst so với gpt-image-2 bằng các prompt của riêng bạn.
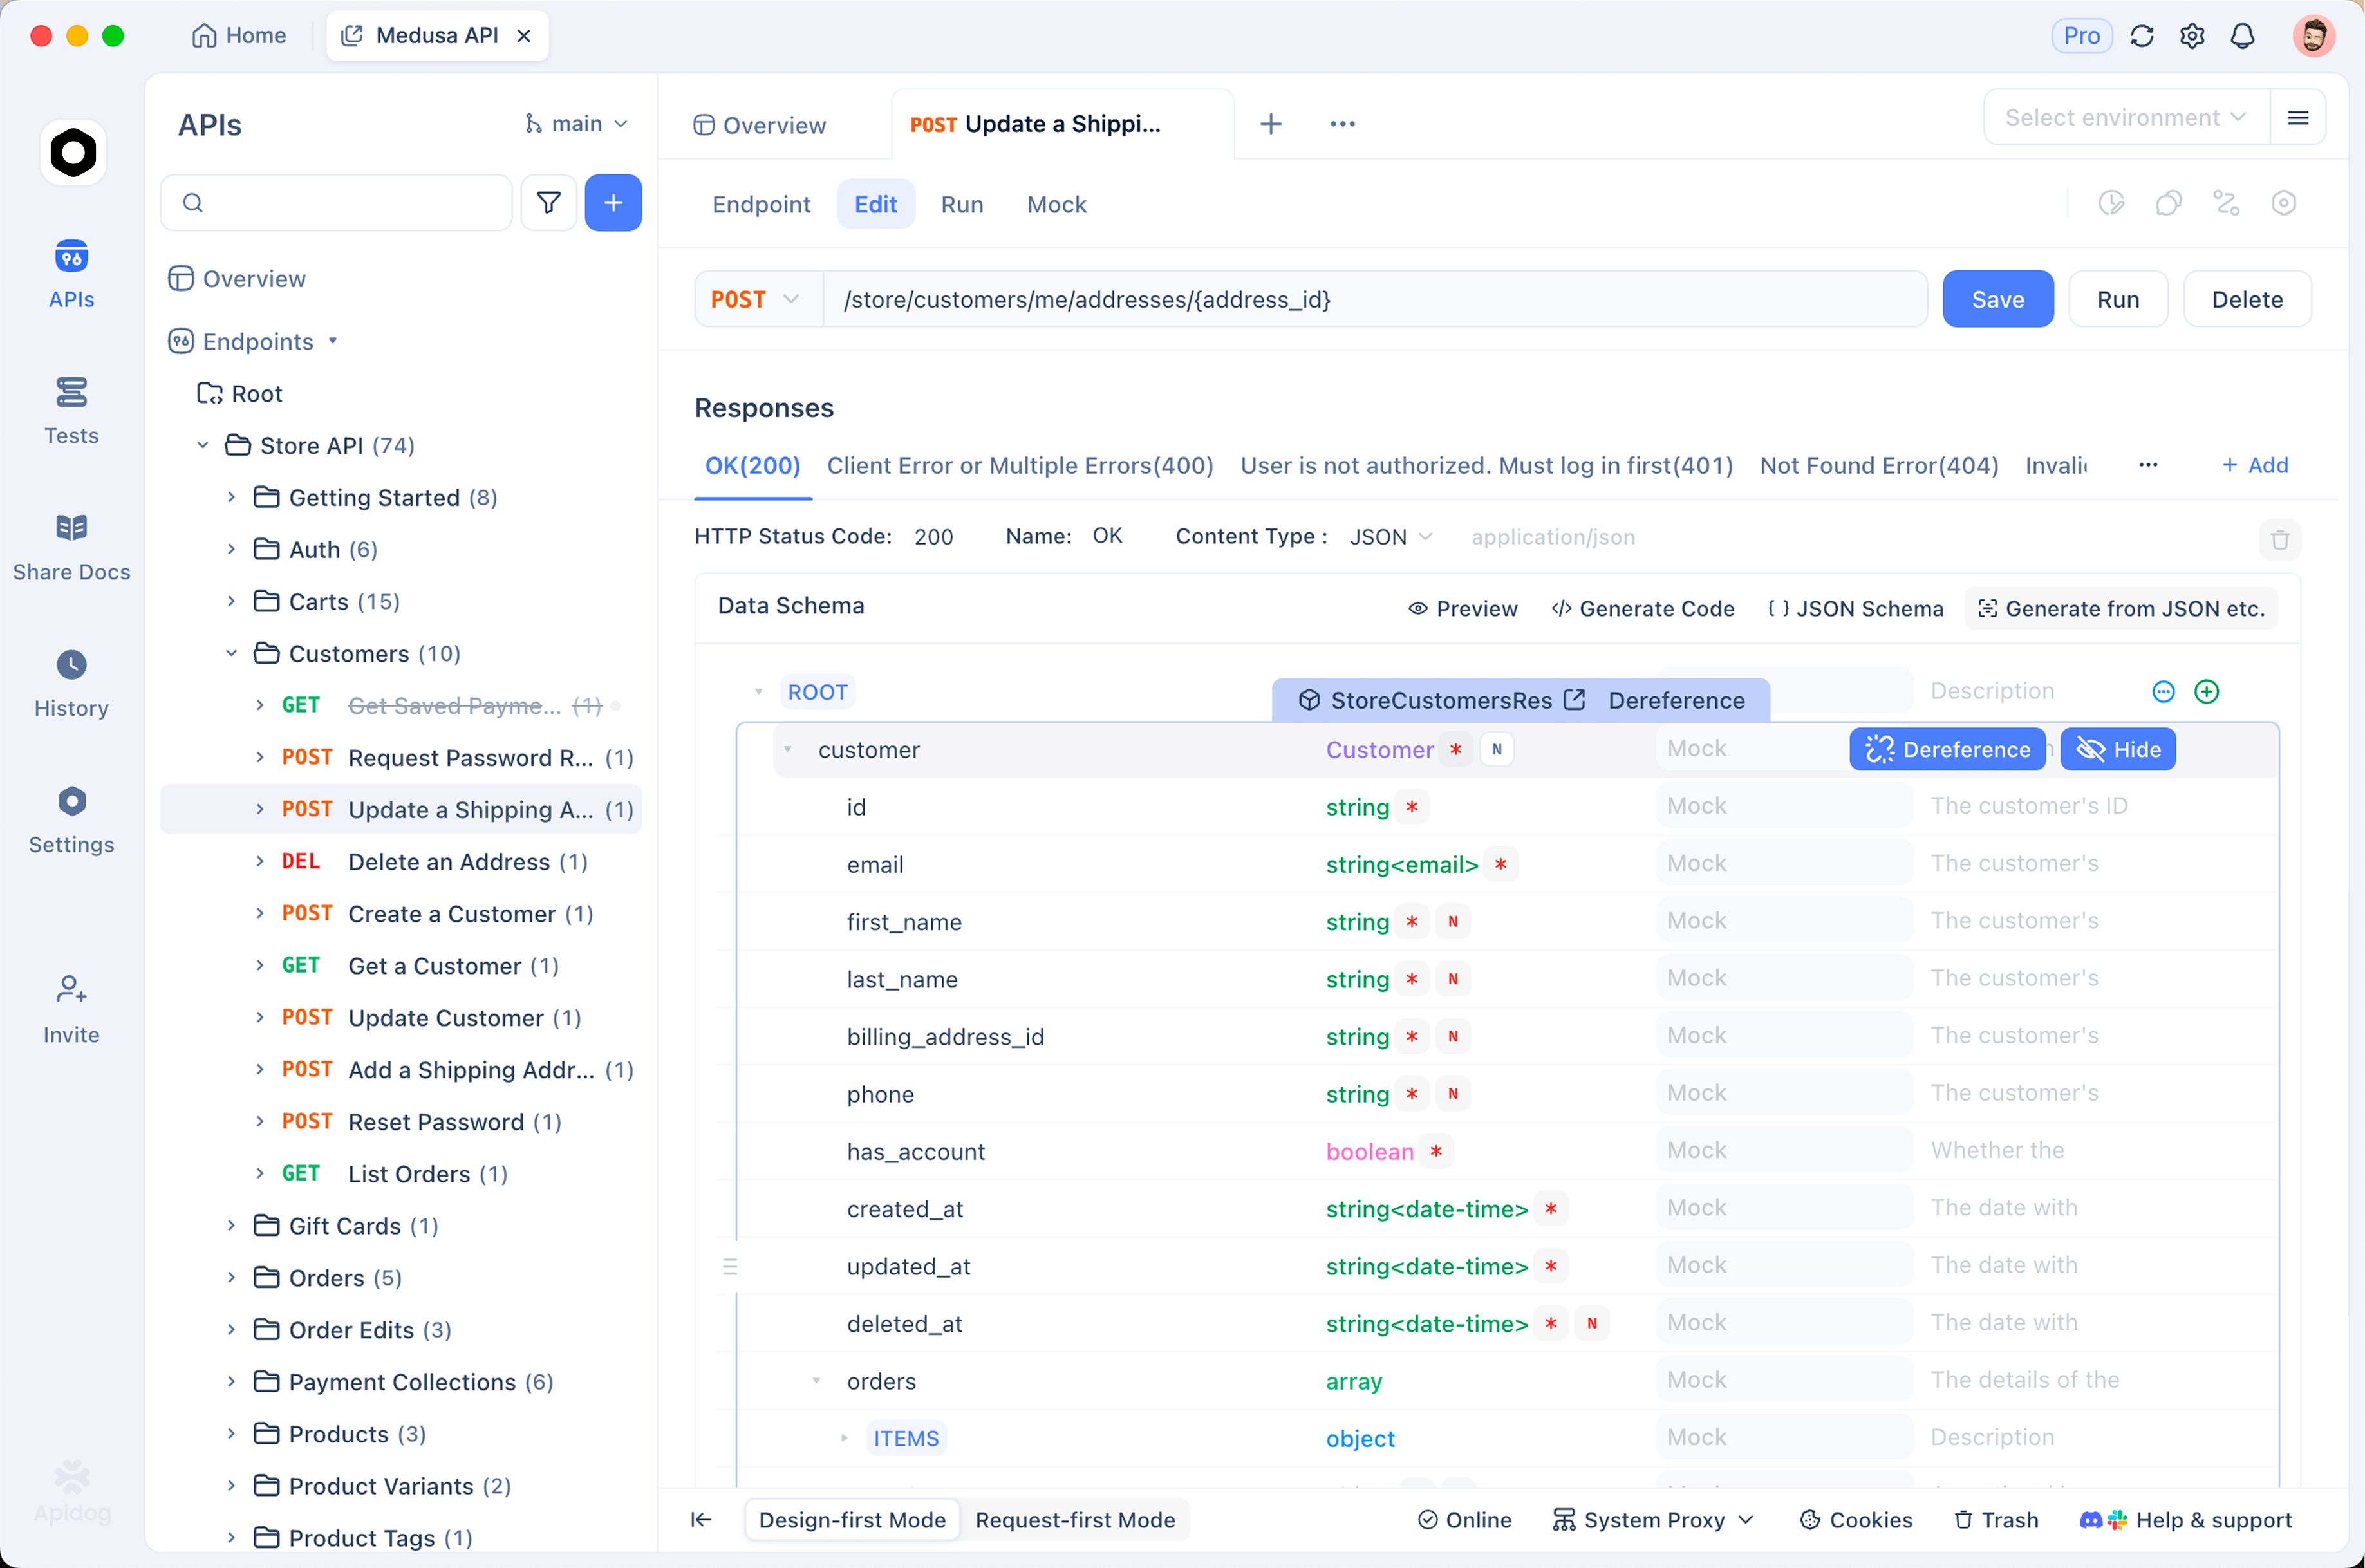
Xây dựng một yêu cầu đến POST https://api.openai.com/v1/images/generations với mô hình là một biến, sau đó tạo ba môi trường có tên flare, sunburst và gpt-image-2. Mỗi môi trường sẽ đặt {{model}} và lưu trữ OPENAI_API_KEY dưới dạng biến môi trường, để khóa không bao giờ nằm trong phần thân yêu cầu.
{
  "model": "{{model}}",
  "prompt": "Product photo of a matte black ceramic mug on a walnut desk, soft window light",
  "size": "1024x1024",
  "quality": "high",
  "output_format": "jpeg",
  "output_compression": 80
}
Thêm một script hậu xử lý ghi lại các con số và làm thất bại lần chạy nếu ngân sách token bị vượt quá:
const body = pd.response.json();
const tokens = body.usage.output_tokens;
pd.environment.set("last_output_tokens", tokens);
pd.environment.set("last_wall_clock_ms", pd.response.responseTime);
pd.test("output tokens within budget", () => {
  pd.expect(tokens).to.be.below(2000);
});
Chạy yêu cầu trong mỗi môi trường. Thời gian phản hồi của Apidog là con số đồng hồ thực tế của bạn, last_output_tokens là số lượng đo được để so sánh với 1.756 của công cụ tính, và khoảng cách giữa các lần chạy Flare và Sunburst là chi phí cao cấp của Sunburst cho prompt của bạn. Công tắc môi trường tương tự hoạt động cho lệnh gọi đa phần `images/edits`; xác nhận trên `usage.input_tokens` ở đó để biết một ảnh tham chiếu có giá bao nhiêu. Tải xuống Apidog để chạy so sánh trước khi bạn thay đổi mã sản phẩm.
Câu hỏi thường gặp
- GPT-image-2.5 có đắt hơn gpt-image-2 không? Theo mỗi token thì không. Cả hai mô hình 2.5 và gpt-image-2 Standard đều tính phí $30 cho mỗi 1 triệu token đầu ra hình ảnh, $8 cho mỗi 1 triệu đầu vào hình ảnh, và $5 cho mỗi 1 triệu đầu vào văn bản. Theo mỗi hình ảnh, một yêu cầu 2.5
hightốn khoảng $0.053 ở 1024x1024, so với $0.211 cho gpt-image-2high. - Sunburst có đắt hơn Flare không? Không. Cả hai mô hình đều có chung một mục trong công cụ tính, vì vậy số lượng token được ghi nhận là giống hệt nhau ở mọi cấp độ chất lượng và kích thước. Sự cao cấp của Sunburst là thời gian tạo lâu hơn, điều mà OpenAI gọi là “mức độ chính xác bổ sung” cho công việc chỉnh sửa nặng.
- Cài đặt chất lượng nào thay thế
highcủa gpt-image-2 cũ của tôi?max. Nó sử dụng 7.024 token ở 1024x1024, cùng ngân sách với gpt-image-2high, và có giá $0.21072 theo công cụ tính. Giữ nguyênhighvà bạn sẽ có ngân sách medium cũ với giá bằng khoảng một phần tư. Bài viết chính về ChatGPT Images 2.5 bao gồm những thay đổi khác. - Có cách nào miễn phí để thử Images 2.5 trước khi trả tiền cho API không? Có. Mô hình có trên mọi cấp độ ChatGPT với giới hạn tạo ảnh theo gói, được trình bày trong cách sử dụng ChatGPT Images 2.5 miễn phí. API không có cấp độ miễn phí cho các điểm cuối hình ảnh; chất lượng
lowvới khoảng $0.006 cho mỗi hình vuông là con đường thực tế rẻ nhất.
Nên chọn mô hình nào
Flare cho bất kỳ khối lượng công việc lớn hoặc nhạy cảm với độ trễ nào, ở high cho hầu hết công việc và max khi yêu cầu giao diện high cũ của gpt-image-2. Sunburst cho các chỉnh sửa nhiều lượt nơi đối tượng tham chiếu phải tồn tại, sau khi so sánh song song trên các prompt của bạn; gpt-image-2 cho các công việc Batch và các quy trình cố định mà bạn chưa sẵn sàng xem xét lại. Dù bạn chọn gì, hãy đọc usage.output_tokens từ các phản hồi thực tế; ba môi trường trong Apidog và một yêu cầu đã lưu sẽ cung cấp cho bạn con số đó chỉ trong một buổi chiều.