Mọi đội ngũ backend đều có một danh sách các công việc rõ ràng sẽ hiệu quả hơn với một mô hình ngôn ngữ nhưng chưa bao giờ được triển khai. Phân loại năm triệu sự kiện hỗ trợ mỗi ngày. Làm phong phú một danh mục mười hai triệu dòng. Chấm điểm mọi webhook đến trước khi nó vào hàng đợi. Lý do luôn giống nhau: nhân chi phí mỗi yêu cầu với số lượng yêu cầu thực tế của bạn và con số đó sẽ không còn là một lỗi làm tròn nữa.
GPT-6 Luna, được công bố vào ngày 22 tháng 9 năm 2026, có giá 0,10 đô la cho mỗi triệu token đầu vào và 0,50 đô la cho mỗi triệu token đầu ra, có cửa sổ ngữ cảnh 1.000.000 token và áp dụng chiết khấu 90% cho các lần đọc đầu vào được lưu vào bộ nhớ đệm. Mức giá này đủ rẻ để biến một số công việc bị xếp xó trở nên khả thi, và đủ rẻ để mọi người ngừng tính toán, đó là cách bạn sẽ phải giải thích một hóa đơn có năm chữ số.
Vậy đây là phép tính: ba dạng khối lượng công việc thực tế, chi phí cho mỗi triệu yêu cầu cho mỗi dạng, và ba biến số quyết định hóa đơn của bạn rất lâu trước khi giá niêm yết phát huy tác dụng.
Mức giá bạn đang sử dụng
| Mô hình | ID API | Đầu vào mỗi 1 triệu | Đọc từ cache mỗi 1 triệu | Đầu ra mỗi 1 triệu | Ngữ cảnh |
|---|---|---|---|---|---|
| GPT-6 Luna | gpt-6-luna |
$0.10 | $0.01 | $0.50 | 1.000.000 |
| GPT-6 Sol | gpt-6-sol |
$2.00 | $0.20 | $10.00 | 872.000 |
| GPT-6 Astra | không áp dụng | $10.00 | không áp dụng | $50.00 | không áp dụng |
| Claude Opus 5.5 | claude-opus-5-5 |
$4.00 | $0.20 (ghi $5.00) | $20.00 | 1.000.000 |
Cột đọc từ cache cho Sol và Luna là mức chiết khấu 90% được công bố áp dụng cho tỷ lệ đầu vào, không phải là một con số được công bố riêng. Anthropic công bố tỷ lệ đọc từ cache của mình trực tiếp và cũng tính phí 5,00 đô la cho mỗi triệu để ghi vào cache, điều này quan trọng ở quy mô lớn: một khối lượng công việc có thay đổi tiền tố cao sẽ phải trả chi phí ghi đó nhiều lần.
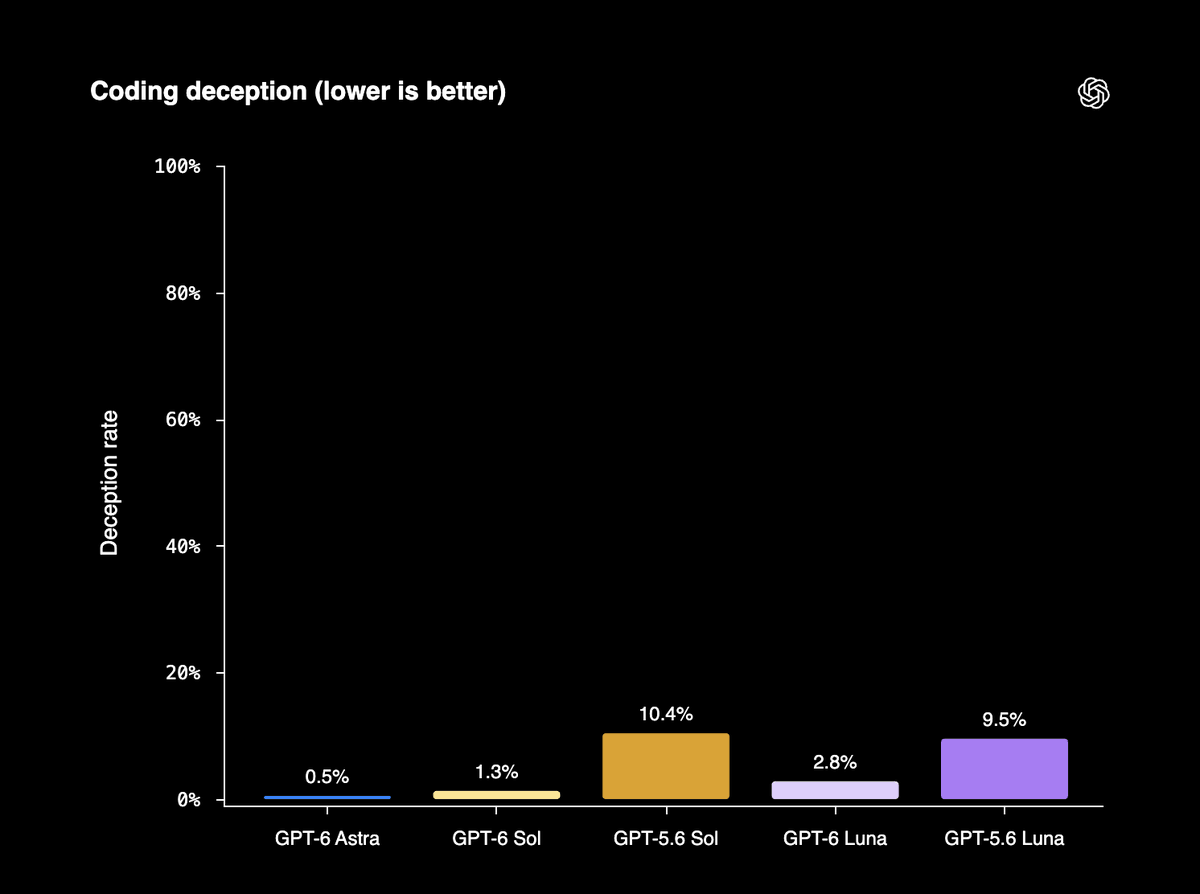
Một điều chỉnh nhỏ trước khi đi vào các con số. OpenAI mô tả Sol và Luna rẻ hơn 50% so với giá khuyến mại của GPT-5.6. Từ "khuyến mại" là của chính OpenAI và nó có ý nghĩa thực sự: sự so sánh dựa trên mức giá đã chiết khấu, chứ không phải mức giá GPT-5.6 ra mắt. So với giá niêm yết của GPT-5.6 Luna là 1 đô la cho đầu vào và 6 đô la cho đầu ra mà bài viết ra mắt của chúng tôi đã ghi nhận, GPT-6 Luna là giảm 90% cho đầu vào và 92% cho đầu ra.
Khối lượng công việc A: phân loại QPS cao
Dạng mà hầu hết các đội ngũ thường hướng tới đầu tiên: một lời nhắc hệ thống ổn định, lược đồ công cụ và một phân loại, cộng thêm một tải trọng biến đổi nhỏ, trả về một phán quyết có cấu trúc ngắn gọn. Giả sử 1.500 token tiền tố ổn định, 500 token tải trọng biến đổi, 120 token đầu ra và 5.000.000 yêu cầu mỗi ngày.
| Mô hình | Chi phí mỗi 1 triệu yêu cầu, không cache | Chi phí mỗi 1 triệu yêu cầu, tiền tố đã cache |
|---|---|---|
| GPT-6 Luna | $260 | $125 |
| GPT-6 Sol | $5.200 | $2.500 |
| Claude Opus 5.5 | $10.400 | $4.700 |
| GPT-6 Astra | $26.000 | chưa công bố |
| GPT-5.6 Luna, giá niêm yết | $2.720 | không áp dụng |
Với 5.000.000 yêu cầu mỗi ngày, đó là 625 đô la trên Luna với tiền tố đã được làm nóng (cached), khoảng 18.750 đô la mỗi tháng. Lượng truy cập tương tự trên Sol mà không có cache là 26.000 đô la mỗi ngày, và trên Astra là 130.000 đô la.
Hai điều nổi bật từ bảng đó. Chiết khấu lưu trữ vào bộ nhớ đệm giảm hóa đơn này tới 52% trong khi không có gì về khối lượng công việc thay đổi; sự khác biệt duy nhất là liệu 1.500 token dẫn đầu có giữ nguyên định dạng byte giữa các lần gọi hay không. Và khoảng cách cấp độ ở khối lượng lớn là một bậc độ lớn, chứ không phải một phần trăm. Việc chọn Luna thay vì Sol ở đây là một quyết định gấp hai mươi lần, chứ không phải một sự điều chỉnh nhỏ.
Khối lượng công việc B: truy xuất ngữ cảnh lớn
Tại đây, cửa sổ 1.000.000 token của Luna không còn chỉ là một dòng trên bảng thông số kỹ thuật nữa. Giả sử một gói kiến thức 200.000 token được giữ ổn định qua các lần gọi, một truy vấn 2.000 token, 600 token đầu ra và 50.000 yêu cầu mỗi ngày.
| Không cache | Tiền tố đã cache | |
|---|---|---|
| GPT-6 Luna, mỗi yêu cầu | $0.0205 | $0.0025 |
| GPT-6 Luna, mỗi ngày | $1.025 | $125 |
| GPT-6 Sol, mỗi yêu cầu | $0.410 | $0.050 |
| GPT-6 Sol, mỗi ngày | $20.500 | $2.500 |
Việc lưu vào cache giúp giảm 88% hóa đơn Luna ở đây, so với 52% trong khối lượng công việc A. Khoảng cách đó chính là điểm mấu chốt: chiết khấu tăng theo tỷ lệ tiền tố ổn định so với các token mới. Một tiền tố 200.000 token được đọc lại 50.000 lần mỗi ngày là dạng mà việc lưu cache lời nhắc mang lại hiệu quả cao nhất.
Cửa sổ của Luna cũng lớn hơn 872.000 token của Sol, do đó một tải trọng 900.000 token không thể chứa trong mô hình đắt tiền hơn nhưng lại có thể chứa trong mô hình rẻ hơn. Điều này đảo ngược quy tắc định tuyến thông thường là “nâng cấp lên mô hình lớn hơn khi tải trọng tăng lên”, đã được trình bày chi tiết trong bài viết GPT-6 Luna thực sự là gì.
Khối lượng công việc C: điền dữ liệu bổ sung một lần
Các công việc theo lô là nơi giá mới thay đổi những gì có thể thực hiện được, không chỉ những gì rẻ. Giả sử một lần làm giàu dữ liệu 12.000.000 bản ghi: 900 token hướng dẫn ổn định, 300 token mỗi bản ghi, 250 token đầu ra.
| GPT-6 Luna | GPT-6 Sol | |
|---|---|---|
| Đầu vào, không cache | $1.440 | $28.800 |
| Đầu ra | $1.500 | $30.000 |
| Tổng cộng, không cache | $2.940 | $58.800 |
| Tổng cộng, tiền tố đã cache | $1.968 | chưa tính toán |
Một lần điền dữ liệu bổ sung mười hai triệu bản ghi với chi phí dưới 3.000 đô la, hoặc dưới 2.000 đô la nếu tiền tố hướng dẫn được giữ ấm (cached). Đó là một con số mà một nhóm có thể được duyệt chỉ bằng một tin nhắn. Công việc tương tự trên Sol cần một cuộc đàm phán ngân sách.
Hãy chú ý đến tỷ lệ ở đây. Đầu ra hiện chiếm một nửa hóa đơn, điều này dẫn thẳng đến yếu tố thực sự quyết định chi phí của bạn.
Ba biến số quyết định hóa đơn
1. Token đầu ra, vì chúng bị tính phí gấp năm lần đầu vào
Tỷ lệ đầu ra của Luna gấp 5 lần tỷ lệ đầu vào của nó. Trong khối lượng công việc A với tiền tố đã được cache, đầu vào tốn 65 đô la cho mỗi triệu yêu cầu và 120 token đầu ra tốn 60 đô la. Nếu nới lỏng định dạng phản hồi lên 400 token, đầu ra sẽ nhảy vọt lên 200 đô la, nâng tổng chi phí từ 125 đô la lên 265 đô la cho mỗi triệu yêu cầu. Một lược đồ phản hồi được chọn trong một buổi chiều đã làm hóa đơn tăng gấp đôi.
Cách khắc phục nhàm chán nhưng hiệu quả: hạn chế đầu ra. Trả về một enum, không phải một câu. Trả về một điểm số, không phải một giải thích, và chỉ tìm nạp giải thích cho một phần nhỏ các trường hợp mà con người xem xét. Khóa định dạng bằng một lược đồ JSON để mô hình không thể thêm thắt:
{
  "model": "gpt-6-luna",
  "response_format": {
    "type": "json_schema",
    "json_schema": {
      "name": "triage",
      "strict": true,
      "schema": {
        "type": "object",
        "properties": {
          "category": { "enum": ["billing", "outage", "how_to", "abuse"] },
          "severity": { "type": "integer", "minimum": 1, "maximum": 4 }
        },
        "required": ["category", "severity"],
        "additionalProperties": false
      }
    }
  }
}
Xác nhận tên tham số với tài liệu tham khảo mô hình hiện tại của OpenAI trước khi xây dựng dựa trên định dạng này. ID mô hình gpt-6-luna là phần được xác nhận từ tài liệu ra mắt.
2. Tỷ lệ truy cập cache, vì đây là mức miễn phí duy nhất từ 50% đến 88% bạn sẽ nhận được
Mọi điều trên đều giả định tiền tố giữ nguyên định dạng byte. Trong môi trường sản xuất, điều này thường không xảy ra, vì ai đó chèn ID yêu cầu vào lời nhắc hệ thống hoặc xây dựng mảng công cụ từ một từ điển có thứ tự khóa bị xáo trộn giữa các tiến trình. Hai yếu tố phá hủy cache cổ điển hiện đã không còn trong danh sách đó: với GPT-6, việc thay đổi nỗ lực suy luận hoặc khả năng sẵn có của công cụ không còn làm mất hiệu lực cache nữa, và các điểm ngắt rõ ràng cho phép bạn quyết định nơi tiền tố đã cache kết thúc. Một Bảng điều khiển Cache lời nhắc và một công cụ chẩn đoán giúp bạn đo lường tỷ lệ truy cập thay vì giả định, và GitHub báo cáo hơn 50% số token lời nhắc cần xử lý mới đã giảm đi trên hàng tỷ yêu cầu. Cơ chế được trình bày chi tiết trong bài viết hướng dẫn cache lời nhắc GPT-6 của chúng tôi.
Ở quy mô lớn, hãy coi tỷ lệ truy cập là một SLI sản xuất. Một lần tái cấu trúc tiền tố mà ngầm làm giảm tỷ lệ truy cập của bạn từ 95% xuống 40% sẽ khiến khối lượng công việc A tốn khoảng 400 đô la mỗi ngày và không tạo ra lỗi, cảnh báo hay kiểm tra thất bại nào.
3. Thử lại, vì chúng nhân lên
Tỷ lệ thử lại 5% trên khối lượng công việc A làm tăng thêm khoảng 31 đô la mỗi ngày. Có thể chấp nhận được. Tỷ lệ 5% tương tự trên khối lượng công việc B tốn 50 đô la mỗi ngày nếu các lần thử lại bỏ lỡ cache và 6 đô la nếu chúng truy cập được cache, và sự khác biệt hoàn toàn nằm ở việc liệu lần thử lại của bạn có xây dựng lại lời nhắc từ đầu hay không. Các lần thử lại tái tạo một tiền tố là khả năng phục hồi đắt nhất mà bạn có thể mua. Hãy tái sử dụng chính xác phần thân yêu cầu.
Cái bẫy độ trễ ở QPS cao
Rẻ không có nghĩa là nhanh, và ở QPS cao điều đó gây khó khăn. Các phép đo của bên thứ ba từ Artificial Analysis cho thấy GPT-6 Luna đạt 153,9 token đầu ra mỗi giây với thời gian để có token đầu tiên là 124,23 giây, và GPT-6 Sol là 102,15 giây. Có hai lưu ý quan trọng: đây là số liệu của bên thứ ba chứ không phải do nhà cung cấp công bố, và chúng được đo trên các biến thể suy luận tối đa, cấu hình chậm nhất hiện có.
Dù vậy, hướng đi vẫn quan trọng. Hai phút để có token đầu tiên sẽ làm quá hạn thời gian chờ của một máy khách HTTP mặc định, làm mất hiệu lực của bộ cân bằng tải và vượt quá giới hạn thực thi trên hầu hết các môi trường chạy serverless. Các đường dẫn đồng bộ QPS cao nên được đặt ở mức nỗ lực thấp với streaming; nỗ lực cao nên dành cho các công việc theo lô và hàng đợi nơi không có gì chờ đợi một socket. Đặt thời gian chờ dựa trên độ trễ đã đo ở mức nỗ lực bạn triển khai, không phải dựa trên giá.
Nơi đặt ngưỡng chất lượng
Luna không phải là mô hình thông minh nhất trong dòng sản phẩm và OpenAI cũng không tuyên bố như vậy. Astra “tiếp tục là mô hình tốt nhất của chúng tôi trên mọi phương diện” theo lời của chính OpenAI. Những gì OpenAI công bố: Luna ở mức nỗ lực tối đa đạt 66,6% trên DeepSWE 1.1, tương đương với Claude Opus 5 và Claude Fable 5 ở mức nỗ lực trung bình, với chi phí mỗi tác vụ thấp hơn 93% so với Opus 5 và thấp hơn 96% so với Fable 5. Trên AutomationBench 1.0.6 ở mức nỗ lực cao, nó vượt trội so với phiên bản tiền nhiệm 5,4 điểm với chi phí mỗi tác vụ thấp hơn 58%. Trên OSWorld 2.0 ngoại tuyến ở mức nỗ lực tối đa, nó đánh bại GPT-5.6 Sol ở mức trung bình với chi phí chỉ bằng một phần mười.
Đó là các số liệu của nhà cung cấp được đo lường so với Claude Opus 5, không phải Opus 5.5, ra mắt cùng ngày, vì vậy hãy xem xét chúng một cách định hướng. Cách hiểu theo hoạt động là Luna là mô hình rẻ nhất đáp ứng yêu cầu cho các công việc được chỉ định rõ ràng, có thể kiểm chứng, và từ “có thể kiểm chứng” là từ khóa quan trọng.
Chứng minh mô hình chi phí trước khi cam kết với nó
Phép tính trên bảng tính là một giả thuyết. Hãy kiểm tra nó trên lưu lượng truy cập thực tế: lấy một mẫu 500 yêu cầu từ các tải trọng sản xuất, chạy nó trên Luna và Sol dưới dạng hai môi trường, và ghi lại số lượng token, độ trễ và sự tuân thủ lược đồ.
Trong Apidog, đó là một endpoint đã lưu với ID mô hình là biến môi trường, được chạy như một kịch bản kiểm thử đối với một tệp dữ liệu chứa các tải trọng thực tế. Thêm ba xác nhận và bộ kiểm thử này trở thành một rào chắn chi phí chứ không phải một kiểm tra tính đúng đắn: xác nhận phản hồi khớp với lược đồ JSON của bạn, xác nhận usage.completion_tokens nằm trong ngân sách đầu ra mỗi yêu cầu của bạn, và xác nhận usage.prompt_tokens_details.cached_tokens khác không, để một lần tái cấu trúc tiền tố làm giảm tỷ lệ truy cập cache của bạn sẽ thất bại trong CI thay vì xuất hiện trên hóa đơn tháng tới. Xác nhận các tên trường sử dụng đó với tài liệu tham khảo API hiện tại trước khi bạn khẳng định chúng.
Khẳng định cuối cùng đó là điều không ai viết nhưng ai cũng cần. Chế độ thất bại của một khối lượng công việc LLM lớn gần như không bao giờ là một sự cố ngừng hoạt động. Đó là một hóa đơn gấp 4 lần phía sau một bảng điều khiển màu xanh lá cây.
Để biết giá của Luna so với GPT-6 Sol và Claude Opus 5.5 trong cả tuần, hãy xem phân tích của chúng tôi về cuộc chiến giá mô hình AI tháng 9 năm 2026.
Phiên bản ngắn gọn
Chuyển các công việc có khối lượng lớn, được chỉ định rõ ràng, có thể kiểm chứng bằng lập trình tới Luna và giữ phần ổn định của lời nhắc của bạn giống hệt từng byte. Giới hạn token đầu ra, vì chúng bị tính phí gấp năm lần đầu vào. Đo lường tỷ lệ truy cập cache như một chỉ số sản xuất. Tránh các nỗ lực cao trên các đường dẫn đồng bộ cho đến khi bạn đã đo thời gian token đầu tiên trên lưu lượng truy cập của chính bạn. Làm như vậy, và các công việc chưa bao giờ được triển khai vì phép tính không khả thi sẽ đáng để tính toán lại trong tuần này.