
GPT-6 Astra đã nâng điểm MATH-500 của Qwen3.5-0.8B từ 7.9% lên 48.1% mà không cần huấn luyện gì cả. Nó đọc trọng số của mô hình, tìm ra một hướng khiến mô hình bị lặp trong quá trình suy nghĩ, rồi trừ hướng đó khỏi hai lớp MLP. Thao tác chỉnh sửa đó chạm tới 131,072 trọng số, tức 0.016% của mô hình. Những con số này đến từ một bài đăng ngày 2 tháng 11 của bốn nhà nghiên cứu tại MIT CSAIL, và mô hình đã chỉnh sửa được công khai, nên bạn có thể tự kiểm chứng tuyên bố này.
Dưới đây: lập trình không gian trọng số là gì, Astra đã thay đổi những gì, phương pháp này dừng lại ở đâu, và cách để coding agent của bạn so sánh hai mô hình bằng Apidog CLI.
Lập trình không gian trọng số là gì?
Lập trình không gian trọng số là việc một LLM đa dụng đọc và ghi trực tiếp vào trọng số của một mạng nơ-ron, được dẫn dắt bởi một mục tiêu diễn đạt bằng ngôn ngữ tự nhiên, không dùng gradient descent và không có vòng lặp huấn luyện. Mô hình lý luận xem mỗi phần của mạng tính toán những gì, rồi tự tay thay đổi các con số, giống như cách một lập trình viên sửa mã nguồn.
Thuật ngữ này xuất phát từ Sparks of Weight-Space Programming của Rikiya Takehi, Jayden Teoh, Alex Zhang và Omar Khattab, công bố ngày 2 tháng 11 năm 2026. Các tác giả gọi mọi kết quả là “rất sơ khai”, và một số trong đó chỉ đến từ một hoặc vài lần chạy. Để biết thêm bối cảnh về mô hình thực hiện việc chỉnh sửa, xem bài đánh giá thực tế GPT-6 Astra.
GPT-6 Astra đã sửa Qwen3.5-0.8B như thế nào
Kết quả nổi bật là Thí nghiệm 8. Các nhà nghiên cứu yêu cầu GPT-6 Astra làm cho Qwen3.5-0.8B giỏi toán hơn bằng cách chỉnh sửa trọng số của nó. Dưới đây là những gì đã diễn ra, từng bước một:
- Thiết lập. Astra được cấp một phiên Python (giống như notebook) với trọng số của mô hình đã được nạp, không có GPU, cùng 7,469 bài luyện tập GSM8K và 7,275 bài MATH từ các tập huấn luyện. Nó chưa bao giờ thấy các tập kiểm tra.
- Ngân sách. Thay vì huấn luyện, Astra chỉ được dùng 10, 25 hoặc 50 forward pass. Một forward pass cho phép mô hình trả lời tối đa 512 bài toán hoặc đọc tối đa 1,024 văn bản.
- Chẩn đoán. Astra nhận thấy mô hình gốc bị lặp: 85 trong số 96 câu trả lời luyện tập đầu tiên chạy tới giới hạn 32,768 token mà vẫn không đi tới đáp án. Các tác giả lưu ý rằng chính model card của Qwen cũng cảnh báo mô hình này dễ bị lặp trong suy nghĩ.
- Truy vết. Astra truy vết hiện tượng lặp về một hướng được ghi bởi các MLP ở lớp 15 và 19.
- Chỉnh sửa. Nó trừ hướng đó khỏi 64 cột đầu ra của
down_projtrong mỗi lớp trong hai lớp đó. Đó là 131,072 trọng số trong tổng số 0.8 tỷ.
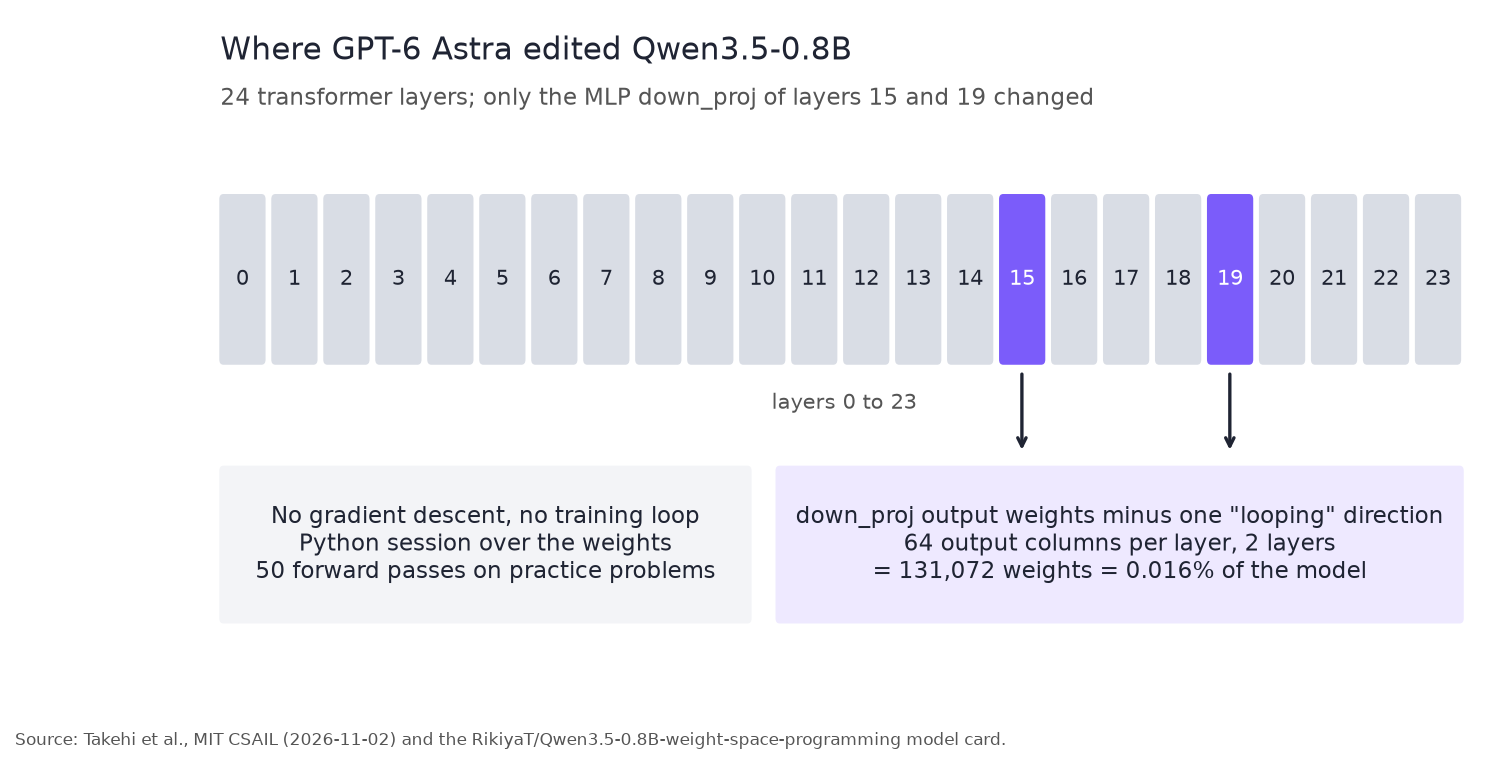
Theo model card trên Hugging Face, chỉ có hai tensor down_proj đó là khác so với checkpoint gốc Qwen/Qwen3.5-0.8B, và mỗi tensor được dựng lại đều được xác minh sha256 với tensor mà các tác giả đã đánh giá. Mô hình đã chỉnh sửa được phát hành theo giấy phép Apache 2.0.
Kết quả: Qwen3.5-0.8B gốc so với bản đã chỉnh sửa
Mọi con số ở đây đều lấy từ bài đăng của các tác giả (bật thinking, tối đa 32,768 token, nhiều mẫu cho mỗi bài toán). “Chạm giới hạn token” là tỷ lệ các câu trả lời MATH-500 bị hết token.
| Qwen3.5-0.8B | MATH-500 | GSM8K | IFEval | Chạm giới hạn token |
|---|---|---|---|---|
| Gốc | 7.9% | 13.8% | 21.0% | 93.0% |
| Đã chỉnh sửa, 10 forward pass | 12.3% | 25.7% | 49.0% | 87.2% |
| Đã chỉnh sửa, 25 forward pass | 14.1% | 25.1% | 39.9% | 86.4% |
| Đã chỉnh sửa, 50 forward pass | 48.1% | 67.1% | 62.3% | 33.1% |
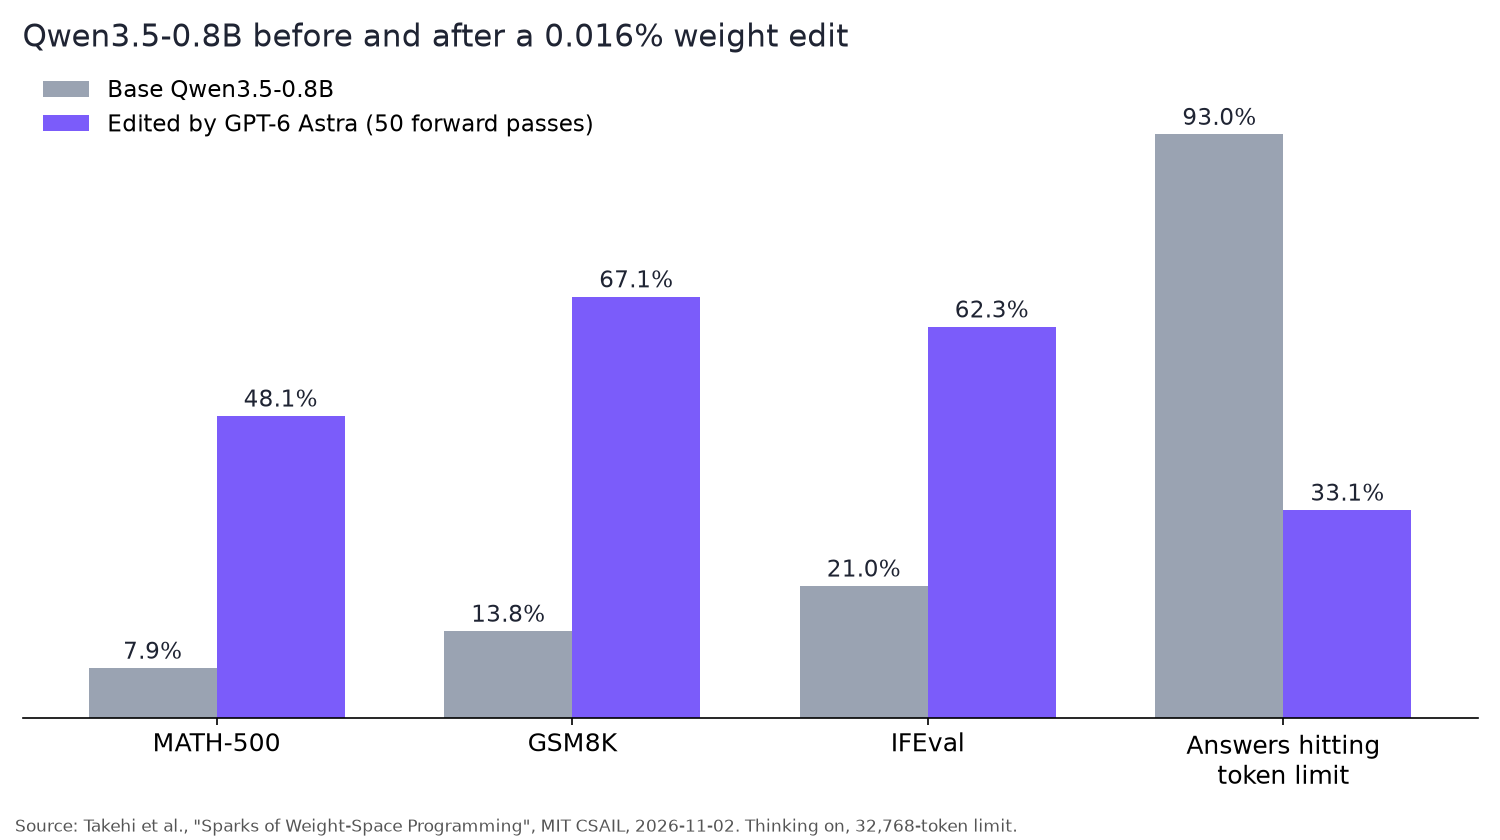
- Bản sửa có tính tổng quát. Hiện tượng lặp không chỉ riêng toán, nên IFEval cũng tăng gần gấp ba.
- Ngân sách có ảnh hưởng. Với 10 hoặc 25 forward pass, các vòng lặp gần như không biến mất.
- Người khác đã tái lập được. Ahsen Khaliq tại Hugging Face đã dựng lại checkpoint từ các log và chạy lại toàn bộ MATH-500 (500 bài toán, mỗi bài 4 mẫu). Mô hình đã chỉnh sửa đạt 51.0%, với 31.6% câu trả lời chạm giới hạn. Một smoke test 25 bài trên mô hình gốc cho kết quả 5.0%.
Space demo cho phép bạn nhập một bài toán và xem cả hai mô hình trả lời.
Những gì việc chỉnh sửa trọng số không thể làm
Các tác giả đã chạy một phép đối chứng còn quan trọng hơn cả kết quả nổi bật. Họ thử áp dụng cách làm tương tự lên Gemma 3 270M, một mô hình hiếm khi bị lặp (8.5% câu trả lời chạm giới hạn, so với 93% ở Qwen).
| Gemma 3 270M | MATH-500 |
|---|---|
| Gốc | 6.8% |
| Chỉnh sửa tốt nhất (25 forward pass) | 7.7% |
Lỗi của Gemma là những lỗi thông thường, chẳng hạn tính toán sai, không có một thành phần đơn lẻ nào để tắt đi. Kết luận của các tác giả: việc chỉnh sửa đã loại bỏ một rào cản che giấu một năng lực, nhưng nó không thể thêm vào một năng lực mà mô hình vốn không có. Qwen vốn đã có thể giải ra nhiều đáp án. Nó chỉ không bao giờ hoàn thành chúng.
Vậy nên đây không phải là “huấn luyện đã hết thời”. Đó là việc một mô hình tiên tiến tìm ra và loại bỏ một lỗi nằm ở một chỗ duy nhất.
Phần còn lại của bài báo về lập trình không gian trọng số
Thí nghiệm 8 là một trong tám thí nghiệm. Những thí nghiệm còn lại dùng các mạng nhỏ hơn nhiều:
- Đọc trọng số. Chỉ từ trọng số thô, Astra đã gọi đúng tên trò chơi cho 4/4 policy game được huấn luyện bằng PPO và ngôn ngữ huấn luyện cho 3/3 mô hình ngôn ngữ nhỏ cấp ký tự.
- Sửa một policy. Một policy lái xe Kinetix thất bại 256/256 episode đã thành công 1,024/1,024 sau khi Astra chỉnh sửa 3.5% trọng số của nó trong một câu trả lời.
- Viết trọng số từ con số không. Astra viết trọng số MinAtar Breakout đạt điểm 517.4, so với 25.3 của PPO được huấn luyện 500 triệu bước. Nó thua ở Seaquest, 53.1 so với 88.9.
- Cờ vây. Nó viết một mạng cờ vây 9x9 với 1.48 triệu trọng số từ số 0, và với 50 forward pass, mạng này đánh bại một mạng PPO có kích thước tương đương.
- Một thất bại. Chỉ từ trọng số, nó không thể phân biệt bản sao nào trong hai bản Gemma 3 270M được huấn luyện để nịnh bợ. Khi được truy cập vào các attention pattern, nó đã chọn đúng bản nịnh bợ trong cả ba cặp.
Nhật ký thí nghiệm đầy đủ bao gồm mọi prompt, các bản tóm tắt lý luận của Astra và từng đoạn mã nó đã chạy.
Tự kiểm chứng bản sửa lỗi lặp suy nghĩ của Qwen3.5-0.8B
Cách kiểm chứng gọn gàng nhất là phục vụ cả hai checkpoint sau cùng một API tương thích OpenAI rồi gửi cho chúng những prompt giống hệt nhau. vLLM làm được điều này với một lệnh cho mỗi mô hình:
vllm serve Qwen/Qwen3.5-0.8B --port 8001 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45

vllm serve RikiyaT/Qwen3.5-0.8B-weight-space-programming --port 8002 \
  --served-model-name qwen --max-model-len 34816 --gpu-memory-utilization 0.45
Cả hai server đều phản hồi dưới tên qwen, nên một request body dùng được cho cả hai cổng. --max-model-len 34816 khớp với ví dụ trong model card.
Mỗi request mô phỏng đúng thiết lập lấy mẫu của các tác giả và bật thinking:
{
  "model": "qwen",
  "messages": [{"role": "user", "content": "{{question}}\nPlease reason step by step, and put your final answer within \\boxed{}."}],
  "temperature": 0.6,
  "top_p": 0.95,
  "top_k": 20,
  "presence_penalty": 1.5,
  "max_tokens": 32768,
  "chat_template_kwargs": {"enable_thinking": true}
}
Giá trị \boxed{} cuối cùng là đáp án, và finish_reason cho biết mô hình đã dừng (stop) hay đã hết token (length). Kết thúc bằng length nghĩa là bị lặp.
Nếu bạn không muốn chạy GPU, bạn có thể kiểm thử API GPT-6 Astra theo cách tương tự, hoặc so sánh các mô hình Qwen nhỏ ngay trên máy với thiết lập Qwen3.5 Ollama miễn phí.
Để coding agent của bạn kiểm thử cả hai mô hình bằng Apidog CLI
Chấm điểm hai mươi câu trả lời dài bằng tay là công việc dành cho coding agent của bạn. Apidog CLI cung cấp cho agent các environment, test scenario, lượt chạy theo dữ liệu và báo cáo, và nó chạy trên máy của bạn, nên các endpoint localhost hoạt động được.
Cài đặt nó và cấp skill cho agent của bạn:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho Claude Code, Codex, Cursor hoặc OpenCode một prompt:
In Apidog project <id>, create two environments: qwen-base at http://localhost:8001
and qwen-edited at http://localhost:8002. Create a test scenario that POSTs to
/v1/chat/completions with the body in request.json, using {{question}} from the
first 10 GSM8K test questions in gsm8k-10.csv. Assert that the last \boxed{} value
equals {{answer}} and that choices[0].finish_reason is not "length". Run it against
both environments and give me a table: correct answers and length finishes per model.
Agent đọc schema của payload, xác thực JSON của nó rồi chạy các lệnh sau:
apidog environment create qwen-base --project <id> --base-url http://localhost:8001
apidog environment create qwen-edited --project <id> --base-url http://localhost:8002
apidog cli-schema get test-scenario-create
apidog cli-schema validate test-scenario-create --file scenario.json
apidog test-scenario create --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <baseEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-base
apidog run -t <scenarioId> --project <id> -e <editedEnvId> \
  -d gsm8k-10.csv --timeout-request 1800000 -r cli,json --out-file qwen-edited
-d đưa từng dòng CSV vào như một lượt lặp. --timeout-request tính bằng mili giây, và một câu trả lời bị lặp có thể mất hàng phút để đốt hết 32,768 token. -r cli,json in ra bản tóm tắt và ghi một báo cáo JSON để agent có thể so sánh (diff). 10 câu hỏi này lấy từ tập test GSM8K.
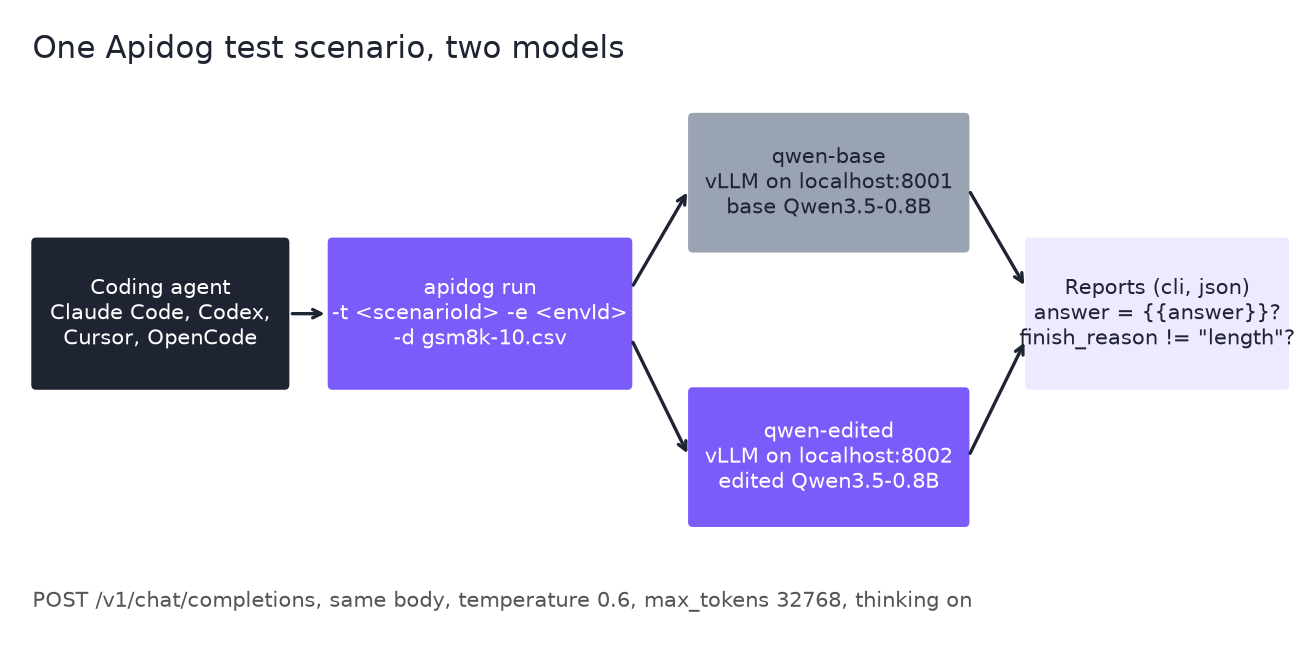
Nếu lượt chạy của bạn giống của các tác giả, phần lớn câu trả lời từ mô hình gốc sẽ trượt assertion finish_reason và phần lớn câu trả lời từ bản đã chỉnh sửa sẽ vượt qua. Mười câu hỏi chỉ là một smoke test, không phải một benchmark, nên hãy coi khoảng cách đó là tín hiệu, chứ không phải điểm số. Thêm --upload-report để xem lượt chạy trong ứng dụng, và xem tài liệu tham chiếu lệnh apidog run để biết mọi cờ.
Cùng kịch bản đó cũng dùng được như một regression test cho bất kỳ lần thay mô hình nào; hướng dẫn Apidog CLI CI/CD trình bày cách thiết lập -r junit.
Điều này có nghĩa gì nếu bạn triển khai các mô hình nhỏ
- Đo cả hiện tượng cắt ngắn, không chỉ độ chính xác. Con số 7.9% của Qwen đã che giấu một mô hình hầu như không bao giờ hoàn thành. Kiểm tra
finish_reasonsẽ phát hiện điều đó. - Tìm kiếm các lỗi có một nguyên nhân duy nhất. Vòng lặp và lặp lại có thể nằm trong một phần rất hẹp của mạng.
- Đừng quên phép đối chứng. Nếu mô hình của bạn sai thay vì bị kẹt, một chỉnh sửa như thế này sẽ không giúp ích gì.
Đang chọn một phiên bản GPT-6 cho công việc agent? Xem GPT-6 Luna vs Sol vs Astra.
Câu hỏi thường gặp
GPT-6 Astra có huấn luyện Qwen3.5-0.8B không? Không. Các tác giả không cho phép gradient descent và không có vòng lặp huấn luyện. Astra chỉnh sửa trọng số trong một phiên Python và chỉ quan sát mô hình qua 10, 25 hoặc 50 forward pass.
Chỉnh sửa đó đã thay đổi bao nhiêu trọng số? 131,072 trọng số, mà theo các tác giả là 0.016% của mô hình. Những thay đổi nằm trong các ma trận down_proj của MLP ở lớp 15 và 19, mỗi lớp 64 cột đầu ra.
Mô hình đã chỉnh sửa có được công khai không? Có, dưới tên RikiyaT/Qwen3.5-0.8B-weight-space-programming trên Hugging Face theo giấy phép Apache 2.0, kèm hash của hai tensor đã thay đổi và một lần chạy lại độc lập (51.0% trên MATH-500).
Vì sao điểm toán lại tăng mạnh đến vậy? Vì mô hình gốc bị lặp. Trên MATH-500, 93.0% câu trả lời của nó chạm giới hạn 32,768 token. Chỉnh sửa đã giảm con số đó xuống 33.1%, nên mô hình hoàn thành được những đáp án mà nó vốn đã có thể giải ra. Nó không học thêm toán mới.
Lập trình không gian trọng số có hiệu quả trên mọi mô hình không? Theo chính các tác giả thì chưa. Trên Gemma 3 270M, mô hình hiếm khi bị lặp, chỉnh sửa tốt nhất chỉ đưa MATH-500 từ 6.8% lên 7.7%. Các tác giả gọi tất cả kết quả của họ là rất sơ khai.
Tôi có thể kiểm thử mô hình đã chỉnh sửa mà không cần viết code không? Có. Space demo trên Hugging Face chạy cả hai mô hình với bài toán bạn nhập. Để có một phép kiểm tra lặp lại được, hãy dùng vLLM kết hợp Apidog CLI như trình bày ở trên.