
Sự so sánh giữa GPT-6.2 Astra và Claude Fable 5.2 có thể tóm gắt như sau: cả hai đều có giá 8 USD cho mỗi triệu token đầu vào và 40 USD cho mỗi triệu token đầu ra, cả hai đều cung cấp khoảng một triệu token ngữ cảnh và 128K token đầu ra, và cả hai đều nhắm đến các tác vụ lập trình agentic dài. Những điểm khác biệt quyết định lựa chọn của bạn nằm ở giá cache, cách tính phí ngữ cảnh dài, những " quirks " của API mà agent harness của bạn phải xử lý, và cách mỗi mô hình hoạt động trên chính các tác vụ của bạn.
OpenAI phát hành GPT-6.2 Astra vào ngày 17 tháng 11 năm 2026, tám ngày sau khi Anthropic ra mắt Claude Fable 5.2. Bài viết này sẽ đề cập đến thông số kỹ thuật, chi phí của một phiên agent thực tế, các lỗi request có thể làm hỏng một harness được xây dựng cho mô hình còn lại, và cách kiểm thử cả hai bằng Apidog CLI.
GPT-6.2 Astra vs Claude Fable 5.2: kết luận nhanh
Chọn Claude Fable 5.2 nếu agent của bạn gửi các prompt dài và đọc lại một lượng ngữ cảnh cache lớn, vì chi phí đọc cache của nó chỉ bằng một nửa và toàn bộ cửa sổ 1M token của nó được tính theo giá tiêu chuẩn. Chọn GPT-6.2 Astra nếu hệ thống của bạn đã dựa trên OpenAI Responses API và bạn muốn dùng các công cụ hosted của nó như apply_patch, hosted shell và các subagent đa agent. Với các trường hợp khác, hãy chạy thử cả hai trên tác vụ thực tế của bạn trước khi quyết định.
Các đánh giá ban đầu nghiêng về Fable về mặt năng lực thuần túy. Simon Willison đã viết vào ngày ra mắt rằng Astra "không đạt điểm cao bằng Fable 5.2 trên một số benchmark" và một số người kiểm thử thấy phong cách giao tiếp của nó gây khó hiểu. Hãy xem đó là tín hiệu để tự kiểm thử, chứ không phải một phán quyết.
GPT-6.2 Astra và Claude Fable 5.2 so sánh thế nào về thông số và giá?
Cả hai mô hình đều niêm yết cùng mức giá cơ bản, nên sự so sánh nằm ở các chi tiết. Mọi con số dưới đây được lấy từ trang mô hình GPT-6.2 Astra và tổng quan về Claude Fable 5.2, kiểm tra vào ngày 18 tháng 11 năm 2026.
| Thông số | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| ID mô hình API | gpt-6.2-astra |
claude-fable-5-2 |
| Ngày phát hành | 17/11/2026 | 9/11/2026 |
| Đầu vào / đầu ra trên 1M token | 8 USD / 40 USD | 8 USD / 40 USD |
| Đầu vào đã cache (đọc cache) | 0,40 USD | 0,20 USD |
| Ghi cache | 10 USD (30 phút), 20 USD (12 giờ) | 10 USD (5 phút), 16 USD (1 giờ) |
| Cửa sổ ngữ cảnh | 1.050.000 (tối đa 922.000 token đầu vào) | 1M |
| Đầu ra tối đa | 128.000 | 128K |
| Prompt dài | Trên 272K token đầu vào: đầu vào ×2, đầu ra ×1,5 | Toàn bộ 1M token theo giá tiêu chuẩn |
| Batch | Giảm 50% | Giảm 50% |
| Mốc kiến thức | 18/5/2026 | 6/2026 |
| Điều khiển reasoning | reasoning.effort (từ chối giá trị none) |
effort, mặc định high, thinking luôn bật |
Giá cả của cả hai đã giảm 20% so với thế hệ trước. GPT-6 Astra và Claude Fable 5 đều có giá 10 USD / 50 USD, như Willison đã ghi nhận. Nếu bạn vẫn đang dùng mô hình cũ, hướng dẫn GPT-6 Astra API và bảng phân tích giá Claude Fable 5.2 sẽ cho biết những gì đã thay đổi.
Một phiên coding agent thực tế tốn bao nhiêu tiền?
Một coding agent hiếm khi chỉ gửi một prompt ngắn. Nó tải lại ngữ cảnh repo, định nghĩa công cụ và lịch sử hội thoại ở mỗi lượt, vì vậy chi phí đọc cache và quy tắc tính phí prompt dài quan trọng hơn mức giá quảng cáo.
Dưới đây là hai khối công việc mẫu được tính theo bảng giá chính thức, ở mức xử lý Standard.
| Khối công việc | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|
| Phiên agent: 150K token ghi vào cache, 1,35M lượt đọc cache, 150K token đầu ra (mỗi request dưới 272K) | 1,50 USD + 0,54 USD + 6,00 USD = 8,04 USD | 1,50 USD + 0,27 USD + 6,00 USD = 7,77 USD |
| Một request dài: 400K token đầu vào, 8K đầu ra, không cache | 6,40 USD + 0,48 USD = 6,88 USD | 3,20 USD + 0,32 USD = 3,52 USD |
Chi phí phiên gần như nhau vì đầu ra chiếm phần lớn: 150K token đầu ra tốn 6,00 USD trên cả hai mô hình. Chênh lệch chi phí đọc cache ở đây tiết kiệm được 27 cent và sẽ tăng lên trong các phiên dài hơn.
Request dài đơn lẻ là nơi hóa đơn bắt đầu phân hóa. Khi một request Astra vượt quá 272K token đầu vào, OpenAI sẽ gấp đôi giá đầu lên 16 USD và nâng giá đầu ra lên 60 USD cho toàn bộ request. Fable 5.2 tính phí một prompt 400K theo cùng mức 8 USD như một prompt 4K.
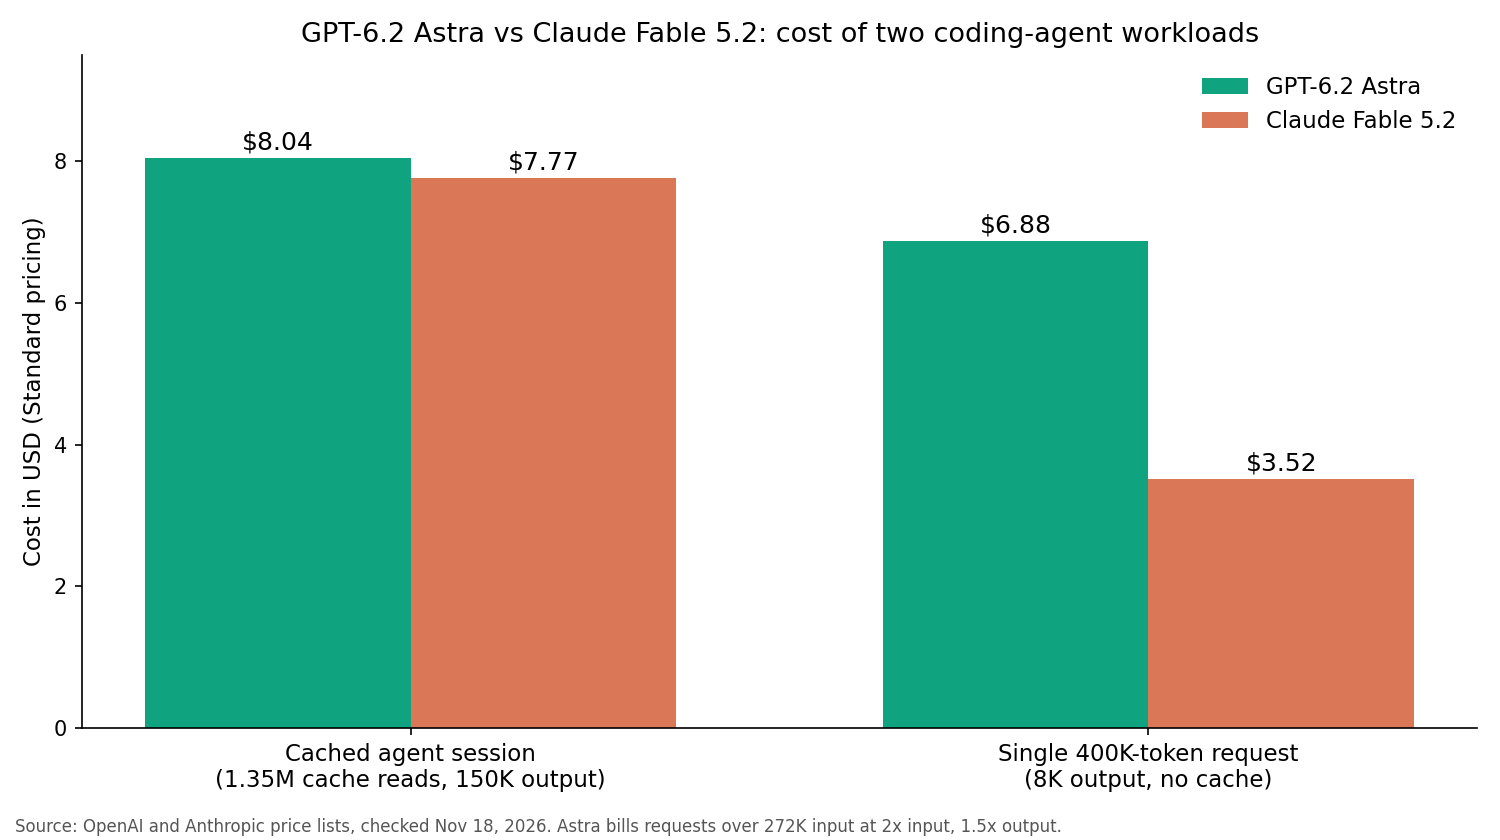
Nếu agent của bạn nhồi một monorepo lớn hoặc log dài vào một request, hãy giữ nó dưới 272K trên Astra, nếu không bạn sẽ phải trả gần gấp đôi.
Những "quirks" API nào sẽ làm hỏng một harness được xây dựng cho mô hình còn lại?
Chuyển đổi mô hình không chỉ đơn giản là đổi tên chuỗi mô hình. Mỗi API sẽ từ chối những thiết lập mà API kia chấp nhận, và cả hai lỗi đều trả về dưới dạng lỗi HTTP 400.
Claude Fable 5.2 từ chối:
- Bắt buộc sử dụng công cụ. Đặt
tool_choicethànhanyhoặctoolsẽ trả về lỗi 400, theo ghi chú về Fable 5.2 của Anthropic. - Các tham số sampling. Hãy bỏ qua
temperature,top_pvàtop_k; các giá trị mà Anthropic liệt kê sẽ trả về lỗi 400. - Tắt thinking. Adaptive thinking luôn được bật, nên tham số effort là công cụ duy nhất của bạn để điều chỉnh độ sâu, độ trễ và chi phí.
GPT-6.2 Astra từ chối:
reasoning.effortđặt thànhnone(Responses API) hoặcreasoning_effort: "none"(Chat Completions), theo hướng dẫn reasoning của OpenAI.- Các endpoint Realtime, Assistants và fine-tuning, mà trang mô hình liệt kê là không được hỗ trợ.
Nếu harness của bạn buộc một lượt gọi công cụ để lấy đầu ra có cấu trúc, điều đó hoạt động trên Astra nhưng thất bại trên Fable; hãy chuyển cấu trúc đó vào prompt hoặc schema của công cụ. Nếu nó đặt temperature: 0, hãy loại bỏ tham số đó khi dùng Fable.
Cách xử lý dữ liệu cũng khác nhau. Anthropic tuyên bố rằng Fable 5.2 yêu cầu lưu giữ dữ liệu trong 30 ngày và không khả dụng dưới chế độ zero data retention trừ khi Anthropic cho phép rõ ràng. Hãy đối chiếu điều này với chính sách bảo mật của bạn trước khi đưa mã nguồn sản xuất qua mô hình này.
GPT-6.2 Astra thắng ở đâu?
Điểm mạnh của Astra nằm ở bộ công cụ xung quanh nó. Trong Responses API, OpenAI liệt kê apply_patch, hosted_shell, computer_use, code_interpreter, mcp, skills và tool_search là các công cụ được hỗ trợ. Một beta đa agent cho phép Astra ủy thác công việc cho các subagent.
Điều này rất quan trọng nếu bạn không muốn tự xây dựng trình áp dụng patch và trình chạy shell của riêng mình.
Phản hồi trước khi ra mắt của Theo Browne, được Willison trích dẫn, cho biết Astra "có thể gọi rất nhiều subagent và quản lý chúng khá tốt" trên các tác vụ dài, nhưng đôi khi dừng lại để hỏi về các chi tiết nội bộ mà người dùng không thể trả lời. Hãy cung cấp cho nó các điều kiện dừng rõ ràng.
Astra cũng cung cấp nhiều tầng giá hơn: Batch giảm 50%, chế độ Fast gấp 2 lần Standard, và các cửa sổ nền rẻ hơn Standard 30% cho hoàn thành trong 2 giờ và rẻ hơn 40% cho hoàn thành trong 8 giờ. Việc sinh test qua đêm có thể chạy trên các tầng này với chi phí thấp hơn.
Claude Fable 5.2 thắng ở đâu?
Fable thắng ở ngữ cảnh dài, nhiều cache. Chi phí đọc cache của nó là 0,20 USD mỗi triệu token, chỉ bằng 2,5% giá đầu vào, và toàn bộ cửa sổ 1M token của nó được tính theo giá tiêu chuẩn mà không có hệ số nhân cho prompt dài.
Anthropic định vị Fable 5.2 cho các phiên agent chạy trong nhiều giờ. Điều khiển effort của nó chạy từ low đến max; Anthropic khuyến nghị bắt đầu ở mức high (mặc định) và chỉ tăng lên xhigh ở nơi bạn đã đo được lợi ích rõ ràng.
Nó cũng nhận được phản hồi ban đầu mạnh hơn về các tác vụ lập trình sáng tạo khó. Trong bài kiểm thử ra mắt của Willison, một prompt hoạt hình Three.js chạy trên cả hai mô hình OpenAI mới ở mức effort Ultra trong Codex CLI, không mô hình nào đạt được kết quả như anh ấy có được từ Fable 5.2.
Fable cũng chạy trên Amazon Bedrock, Google Cloud và Microsoft Foundry, và chế độ Fast của nó cho tốc độ đầu ra cao hơn tới 2,5 lần với giá 16 USD / 80 USD mỗi triệu token. Để xem các ví dụ request, xem hướng dẫn Claude Fable 5.2 API.
Làm thế nào để kiểm thử GPT-6.2 Astra và Claude Fable 5.2 trên khối công việc API của chính bạn?
Benchmark đo lường tác vụ của người khác. Thay vào đó, hãy chạy cùng các prompt qua cả hai API:
- Chọn 5 đến 10 prompt thực tế từ lịch sử agent của bạn, ví dụ một lỗi cần sửa, một bản refactor và một tác vụ viết test.
- Viết một request cho mỗi mô hình với nội dung giống hệt nhau, dùng đúng định dạng của từng API.
- Kiểm tra trạng thái 200, câu trả lời không rỗng và cấu trúc dữ liệu mà agent của bạn phân tích.
- Chạy mỗi request nhiều lần và so sánh số token, độ trễ và tỷ lệ thành công.
Cả hai lượt gọi đều là HTTP thuần. Đây là request Astra trên Responses API:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gpt-6.2-astra", "reasoning": {"effort": "high"},
       "input": "Review this diff and list the bugs."}'
Fable 5.2 đi qua Messages API của Anthropic với claude-fable-5-2 làm mô hình và không có trường temperature.
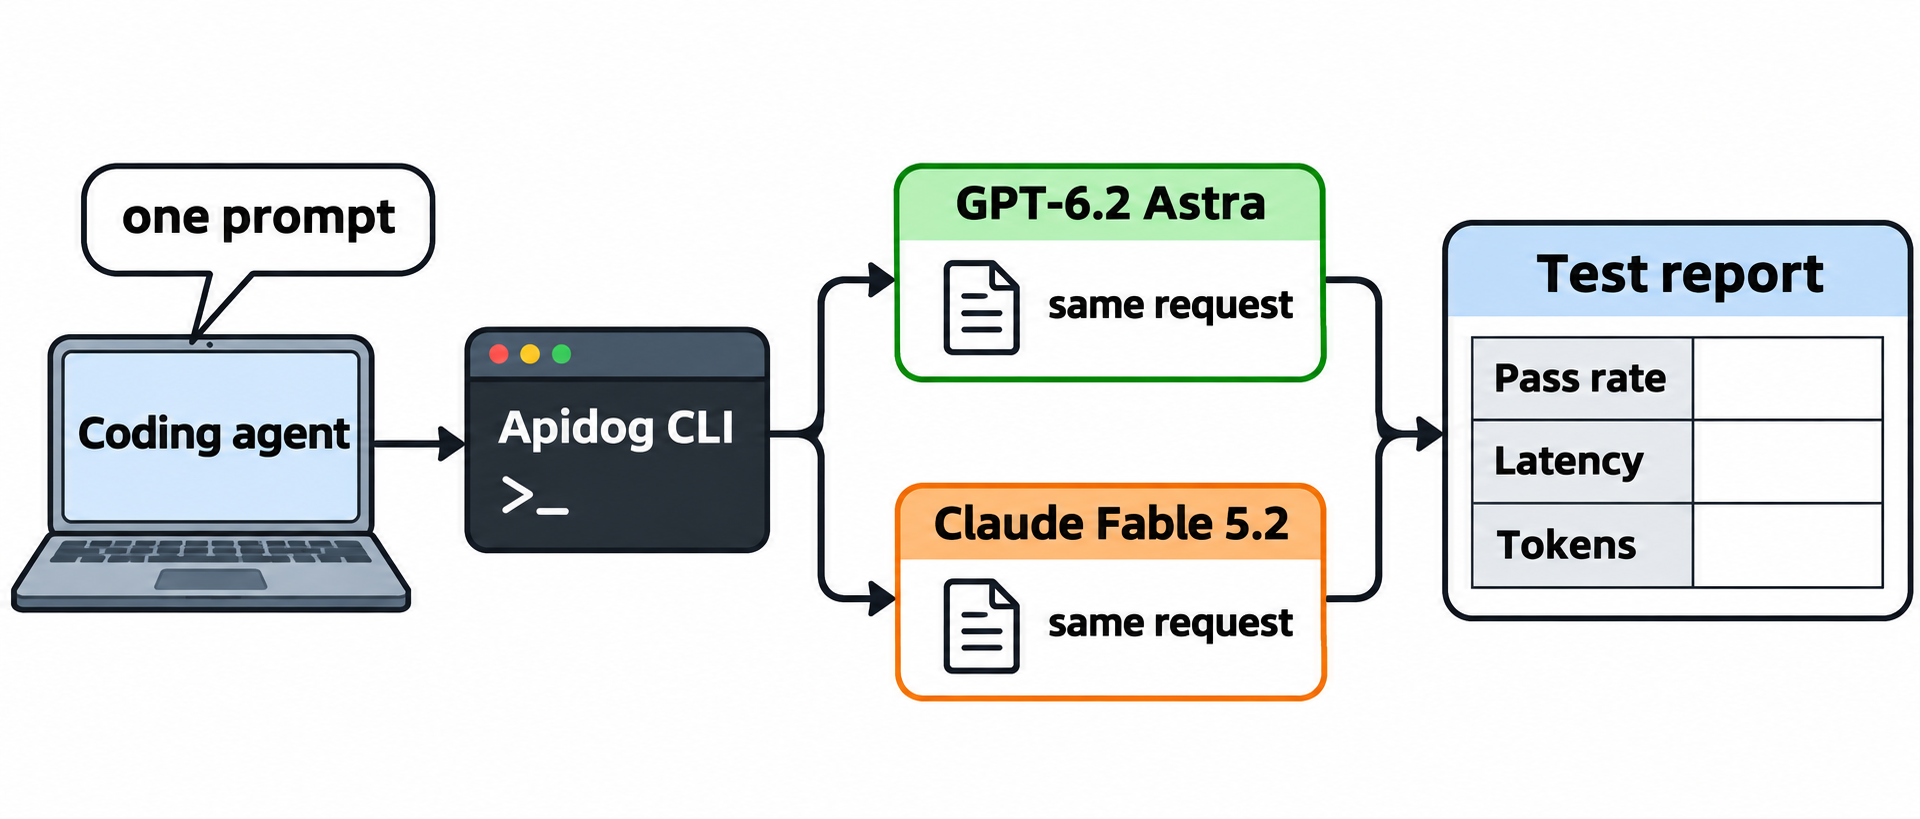
Để coding agent của bạn chạy thử A/B với Apidog CLI
Chạy các cặp request bằng tay sẽ nhanh chóng trở nên nhàm chán. Thay vào đó, hãy để Claude Code, Codex hoặc Cursor điều khiển Apidog CLI. Cài đặt chỉ cần ba lệnh:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # chọn agent của bạn khi được hỏi
Sau đó đưa cho agent của bạn một prompt:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gpt-6.2-astra through the OpenAI Responses
API, and one that sends the same prompt to claude-fable-5-2 through
the Claude Messages API with no temperature field. Keep both API keys
in private environment variables. Assert a 200 status and a non-empty
answer, record token usage and response time, run each case 5 times
and summarize cost per run. Validate every payload before you write it.
Agent sẽ kiểm tra schema payload, viết các test case và chạy chúng. Các cờ dưới đây lấy từ apidog run --help trên CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <ASTRA_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 lặp lại mỗi test case năm lần, nên một phản hồi chậm sẽ không quyết định kết quả. Thêm --upload-report để xem các lượt chạy trong ứng dụng Apidog. Đây là một mẫu quy trình; chúng tôi chưa chạy nó trên Astra từ máy này.
Bạn cũng có thể biến phần về các "quirks" thành các test. Yêu cầu agent tạo một trường hợp âm gửi tool_choice: any tới Fable và kỳ vọng lỗi 400, và một trường hợp gửi effort: none tới Astra và kỳ vọng lỗi 400. Nếu bất kỳ nhà cung cấp nào thay đổi quy tắc, bộ test của bạn sẽ báo cho bạn biết trước cả agent của bạn. Hướng dẫn Apidog CLI trong Claude Code và hướng dẫn Apidog CLI trong Codex sẽ đề cập đến việc thiết lập agent.
Gói Free của Apidog hỗ trợ tối đa 4 người dùng, đủ để chạy sự so sánh này.
Câu hỏi thường gặp
GPT-6.2 Astra có rẻ hơn Claude Fable 5.2 không? Giá cơ bản giống hệt nhau: 8 USD đầu vào và 40 USD đầu ra mỗi triệu token. Fable rẻ hơn ở chi phí đọc cache (0,20 USD so với 0,40 USD) và ở mọi request vượt quá 272K token đầu vào, nơi Astra gấp đôi giá đầu vào.
Mô hình nào có cửa sổ ngữ cảnh lớn hơn? Astra niêm yết 1.050.000 token ngữ cảnh với giới hạn đầu vào 922.000 token. Fable 5.2 niêm yết 1M token. Cả hai đều giới hạn đầu ra ở 128K token mỗi request.
Tôi có thể dùng forced tool calls với Claude Fable 5.2 không? Không. tool_choice đặt thành any hoặc tool sẽ trả về lỗi 400. Hãy để mô hình tự chọn công cụ, và mô tả cấu trúc mong muốn trong prompt hoặc schema của công cụ.
Tôi có thể tắt reasoning trên GPT-6.2 Astra không? Không. API từ chối reasoning.effort đặt thành none với lỗi 400. Thay vào đó, hãy chọn một mức effort thấp được hỗ trợ cho các lượt gọi nhanh, rẻ.
Tôi nên chạy coding agent trên mô hình nào? Hãy bắt đầu từ khối công việc của bạn. Các prompt dài, nhiều cache nghiêng về Fable 5.2, trong khi các hệ thống thuần OpenAI muốn các công cụ hosted như patch, shell và subagent sẽ nghiêng về Astra. Hãy chạy cả hai trên 5 đến 10 prompt thực tế trước khi chuyển đổi.