
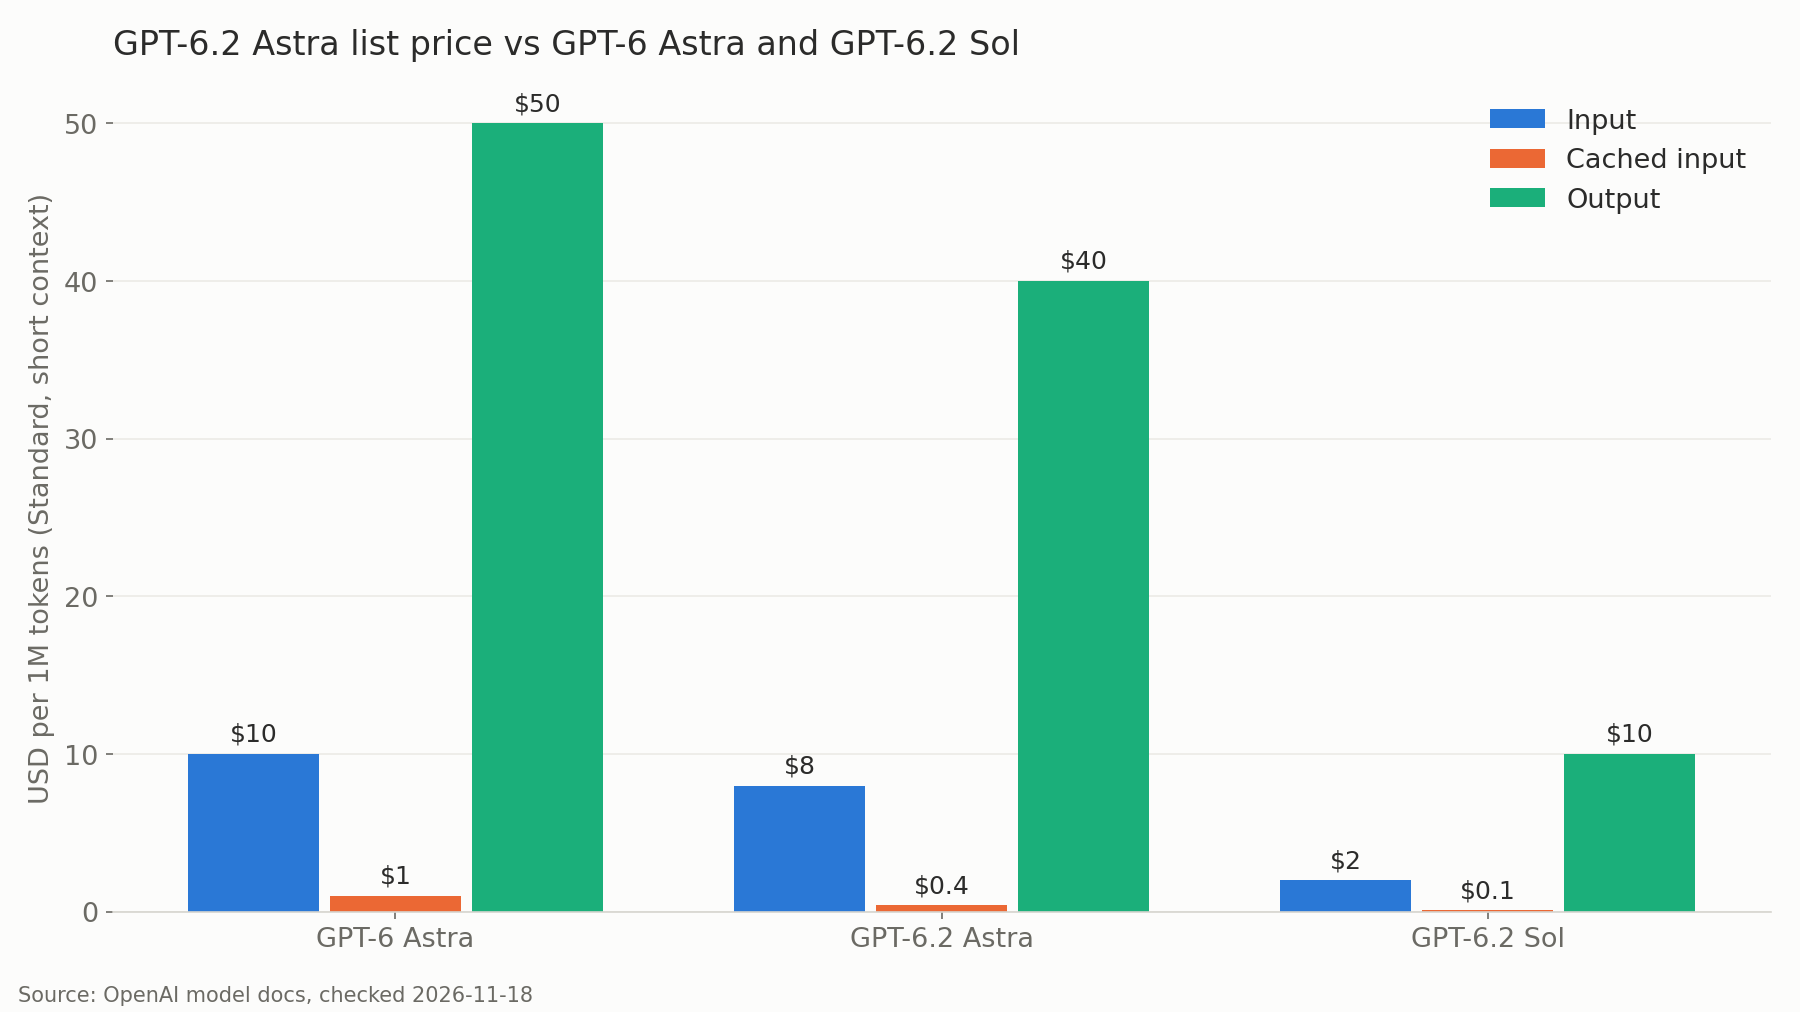
Giá GPT-6.2 Astra là 8 USD cho mỗi 1 triệu token đầu vào và 40 USD cho mỗi 1 triệu token đầu ra ở gói Standard của OpenAI, với đầu vào từ cache ở mức 0,40 USD mỗi 1 triệu. Mức này thấp hơn 20% so với GPT-6 Astra (10 USD/50 USD), và giá đọc cache giảm 60%. Model "em trai" của nó, GPT-6.2 Sol, có giá 2 USD cho đầu vào và 10 USD cho đầu ra mỗi 1 triệu token.
OpenAI phát hành cả hai model vào ngày 17 tháng 11 năm 2026 với tên gpt-6.2-astra và gpt-6.2-sol.
Tổng quan giá GPT-6.2 Astra
GPT-6.2 Astra là model tiên phong của OpenAI dành cho các dự án dài hơi và khó: lập trình, sử dụng máy tính và xử lý tài liệu, với cửa sổ ngữ cảnh 1.050.000 token và tối đa 128.000 token đầu ra. Ở gói Standard, giá là 8 USD mỗi 1 triệu token đầu vào, 0,40 USD mỗi 1 triệu token đầu vào từ cache và 40 USD mỗi 1 triệu token đầu ra, áp dụng cho prompt tối đa 272K token.
| Mức giá (mỗi 1 triệu token, Standard) | GPT-6.2 Astra | GPT-6.2 Sol | GPT-6 Astra |
|---|---|---|---|
| Đầu vào | 8,00 USD | 2,00 USD | 10,00 USD |
| Đầu vào từ cache | 0,40 USD | 0,10 USD | 1,00 USD |
| Ghi cache (30 phút) | 10,00 USD | 2,50 USD | 12,50 USD |
| Ghi cache (12 giờ) | 20,00 USD | 5,00 USD | 25,00 USD |
| Đầu ra | 40,00 USD | 10,00 USD | 50,00 USD |
Token suy luận (reasoning) được tính như token đầu ra. Điều này quan trọng với Astra, vì model từ chối các yêu cầu đặt mức suy luận là none, nên mọi lần gọi đều phát sinh chi phí suy luận nào đó ngoài phần câu trả lời hiển thị.
Chi phí API của GPT-6.2 Astra trên mỗi token
Một token đầu vào có giá 0,000008 USD và một token đầu ra có giá 0,00004 USD. Đầu ra đắt gấp 5 lần đầu vào, nên phần model viết ra — bao gồm cả phần suy luận ẩn — chiếm phần lớn hóa đơn của bạn.
Một yêu cầu chat điển hình với 3.000 token đầu vào và 800 token đầu ra có chi phí:
- GPT-6.2 Astra: 0,024 USD đầu vào + 0,032 USD đầu ra = 0,056 USD
- GPT-6.2 Sol: 0,006 + 0,008 = 0,014 USD
- GPT-6 Astra: 0,030 + 0,040 = 0,070 USD
Nhân rộng ra một ứng dụng phục vụ 20.000 yêu cầu như vậy mỗi ngày. Trong 30 ngày là 600.000 yêu cầu: khoảng 33.600 USD với GPT-6.2 Astra, 8.400 USD với GPT-6.2 Sol, và 42.000 USD với GPT-6 Astra. Sol giữ nguyên mức giá niêm yết 2 USD/10 USD như GPT-6 Sol và GPT-6.1 Sol, nên nếu bạn đã lập ngân sách cho Sol thì chẳng có gì thay đổi.
Giá cache của GPT-6.2 Astra: thay đổi lớn nhất
Mức giảm nổi bật là 20%, nhưng mức giảm giá cache còn lớn hơn. Đọc từ cache trên GPT-6.2 Astra có giá 0,40 USD mỗi 1 triệu, tương đương 0,05 lần giá đầu vào. GPT-6 Astra từng tính 1,00 USD, tức 0,1 lần. Hướng dẫn prompt caching của OpenAI xác nhận mức giá đọc 0,05x áp dụng cho GPT-6.2 Astra, GPT-6.2 Sol, GPT-6.1 Sol và GPT-6.1 Terra.
Ba quy tắc quyết định những gì bạn phải trả:
- Ghi cache thay thế đầu vào, không cộng dồn. Token được ghi vào cache được tính theo giá ghi thay vì giá đầu vào, không bao giờ tính cả hai. Ghi cache 30 phút có giá 1,25 lần đầu vào (10 USD trên Astra); ghi 12 giờ có giá 2,5 lần (20 USD).
- Độ dài prefix tối thiểu là 1.024 token. Prompt ngắn hơn không bao giờ được cache.
- Giá đọc như nhau cho cả hai thời hạn. Chỉ chọn ghi 12 giờ cho system prompt ổn định và tài liệu tham khảo được dùng lại sau những khoảng thời gian dài.
Với mức giá này, caching có lợi ngay từ lần tái sử dụng đầu tiên. Một lần ghi 30 phút cộng một lần đọc chỉ tốn 1,30 lần giá không cache của một prefix, trong khi gửi hai lần là 2 lần. Trên mười yêu cầu, tỷ lệ là 1,70 so với 10.
Simon Willison gọi mức giá cache này là "tin tốt cho các phiên agentic chạy lâu" trong bài viết ngày ra mắt của ông. Về chiến thuật, xem hướng dẫn GPT-6 prompt caching của chúng tôi.
Một phiên agent 50 lượt tốn bao nhiêu
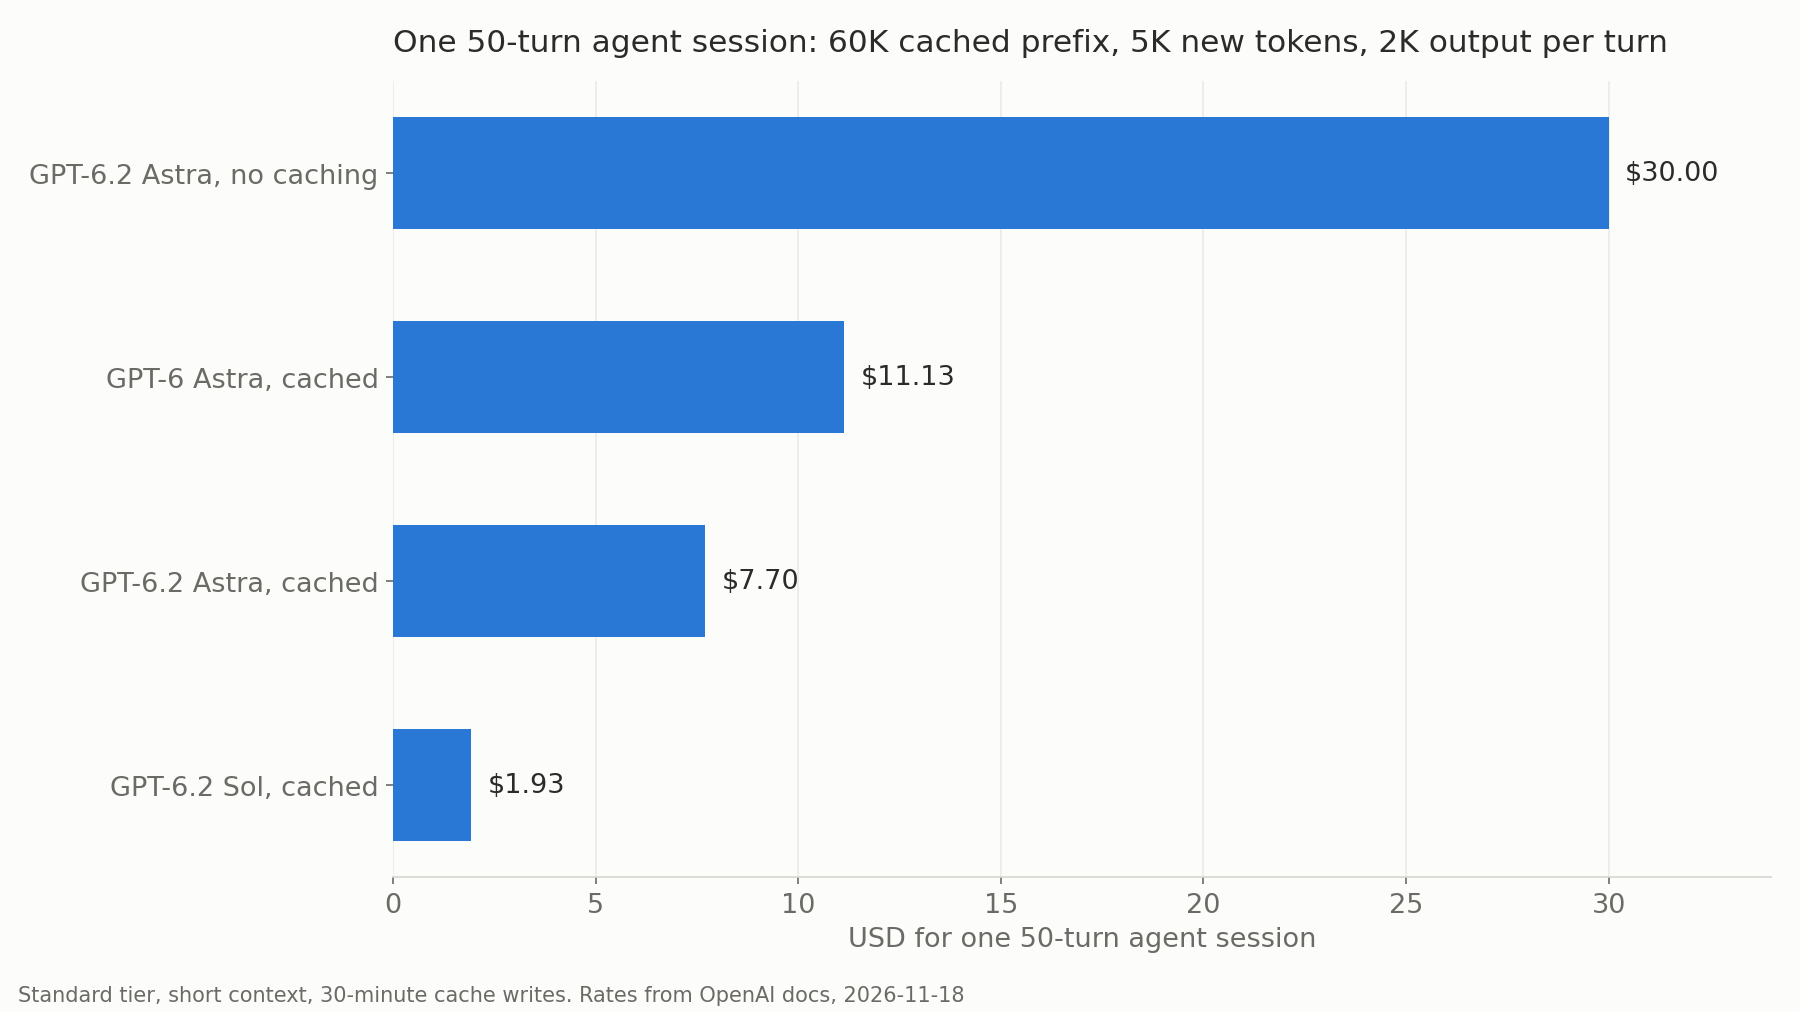
Hãy lấy một agent lập trình chạy 50 lượt. Mỗi lượt đọc lại một prefix 60K token từ cache, ghi 5K token mới vào cache 30 phút, và tạo ra 2K token đầu ra.
| Model và cấu hình | Chi phí mỗi lượt | Chi phí mỗi phiên |
|---|---|---|
| GPT-6.2 Astra, không cache | 0,600 USD | 30,00 USD |
| GPT-6 Astra, có cache | 0,223 USD | 11,13 USD |
| GPT-6.2 Astra, có cache | 0,154 USD | 7,70 USD |
| GPT-6.2 Sol, có cache | 0,039 USD | 1,93 USD |
Caching giúp giảm 74% chi phí phiên GPT-6.2 Astra. So với GPT-6 Astra với cùng cấu hình caching, model mới rẻ hơn 31% mỗi phiên — nhiều hơn mức giảm niêm yết 20%, vì prefix từ cache chiếm tỷ trọng lớn nhất trong đầu vào.
Giá ngữ cảnh dài trên 272K token
GPT-6.2 Astra chấp nhận tối đa 922.000 token đầu vào, nhưng giá thay đổi ở mốc 272K. Khi đầu vào của một yêu cầu vượt 272K token, giá đầu vào và cache tăng gấp đôi, còn đầu ra tăng lên 1,5 lần — áp dụng cho toàn bộ yêu cầu, không chỉ phần vượt quá.
| Mức giá (mỗi 1 triệu token) | Đầu vào đến 272K | Đầu vào trên 272K |
|---|---|---|
| Đầu vào | 8,00 USD | 16,00 USD |
| Đầu vào từ cache | 0,40 USD | 0,80 USD |
| Ghi cache (30 phút) | 10,00 USD | 20,00 USD |
| Đầu ra | 40,00 USD | 60,00 USD |
Một lần review codebase 400K token với 4K token đầu ra có chi phí 6,40 + 0,24 = 6,64 USD. Cắt cùng lần review đó xuống 250K token thì chi phí giảm còn 2,00 + 0,16 = 2,16 USD. Nếu bạn chạy lại lần review 400K nhiều lần với 380K token được phục vụ từ cache và 20K token mới được ghi, chi phí chỉ khoảng 0,94 USD mỗi lần chạy.
Khi prompt nằm ngay trên mốc 272K, truy xuất (retrieval) và cắt gọn prompt rất đáng giá.
Batch, cửa sổ nền (background), Fast và Ultrafast
Trang giá của OpenAI liệt kê GPT-6.2 Astra theo bốn tầng xử lý, cộng với các cửa sổ nền được giảm giá. GPT-6.2 không xuất hiện trong bảng Flex, nên các cửa sổ nền đảm nhận vai trò đó cho những công việc có thể chờ đợi.
| Tầng (ngữ cảnh ngắn) | Astra đầu vào / đầu ra | Sol đầu vào / đầu ra |
|---|---|---|
| Standard | 8 USD / 40 USD | 2 USD / 10 USD |
| Batch (giảm 50%) | 4 USD / 20 USD | 1 USD / 5 USD |
| Background, cửa sổ 8 giờ (giảm 40%) | 4,80 USD / 24 USD | 1,20 USD / 6 USD |
| Background, cửa sổ 2 giờ (giảm 30%) | 5,60 USD / 28 USD | 1,40 USD / 7 USD |
| Fast (gấp 2x) | 16 USD / 80 USD | 4 USD / 20 USD |
| Ultrafast, đến ngày 28/2/2027 (gấp 3x) | 24 USD / 120 USD | 6 USD / 30 USD |
| Ultrafast, từ ngày 1/3/2027 (gấp 6x) | 48 USD / 240 USD | 12 USD / 60 USD |
Các cửa sổ nền là bản beta công khai trên Responses API. Bạn đặt background thành true và background_options.completion_window thành 2h hoặc 8h, và tắt streaming. Hướng dẫn chế độ nền lưu ý hai điểm: các yêu cầu này dùng chung giới hạn tỷ lệ (rate limit) với Batch, và các yêu cầu Standard không thể tái sử dụng các mục cache mà yêu cầu 2h hoặc 8h đã tạo.
Dưới đây là một công việc chạy ban đêm tổng hợp 10.000 tài liệu, mỗi tài liệu 4K token đầu vào và 500 token đầu ra:
| Tầng | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|
| Standard | 520 USD | 130 USD |
| Background, 2 giờ | 364 USD | 91 USD |
| Background, 8 giờ | 312 USD | 78 USD |
| Batch | 260 USD | 65 USD |
Mức 3x của Ultrafast là một chương trình khuyến mãi; từ ngày 1/3/2027 nó tăng gấp đôi lên 6x, nên đừng xây dựng ngân sách dựa trên đó.
GPT-6.2 Astra so với GPT-6.2 Sol và các model flagship đối thủ
Astra đắt đúng 4 lần Sol trên mọi hạng mục. Trang model của Sol liệt kê cùng cửa sổ ngữ cảnh 1.050.000 token, cùng giới hạn đầu ra 128.000 token, cùng công cụ và cùng giới hạn tỷ lệ. Vậy nên lựa chọn phụ thuộc vào chất lượng theo từng tác vụ, chứ không phải tính năng.
| Model (mỗi 1 triệu token) | Đầu vào | Đọc cache | Đầu ra |
|---|---|---|---|
| GPT-6.2 Astra | 8,00 USD | 0,40 USD | 40,00 USD |
| Claude Fable 5.2 | 8,00 USD | 0,20 USD | 40,00 USD |
| Claude Opus 5.5 | 4,00 USD | 0,20 USD | 20,00 USD |
| GPT-6.2 Sol | 2,00 USD | 0,10 USD | 10,00 USD |
Giá Claude lấy từ trang giá của Anthropic, kiểm tra ngày 18/11/2026. GPT-6.2 Astra và Claude Fable 5.2 có cùng mức giá niêm yết 8 USD/40 USD; cache hit của Fable 5.2 có giá 0,20 USD và các mức giá ghi của nó theo thời hạn 5 phút và 1 giờ của Anthropic, không phải 30 phút và 12 giờ như OpenAI, nên hãy so sánh chi phí thực tế trên lưu lượng của riêng bạn.
Đánh giá ban đầu về chất lượng còn trái chiều. Willison ghi nhận rằng GPT-6.2 Astra "không đạt điểm cao bằng Fable 5.2 trên một số benchmark", nên hãy tự chạy đánh giá trước khi quyết định. Nếu bạn đang chuyển từ thế hệ trước, hướng dẫn GPT-6 Astra API của chúng tôi trình bày cấu trúc yêu cầu, còn việc chuyển từ GPT-6 Astra sang Sol giải thích khi nào model rẻ hơn là đủ dùng.
Cả hai model dùng chung giới hạn tỷ lệ Standard: 5.000 yêu cầu và 1M token mỗi phút ở tầng Build, và tối đa 15.000 yêu cầu cùng 40M token mỗi phút ở tầng Grow.
Dùng Codex kiểm tra chi phí GPT-6.2 Astra của bạn với Apidog CLI
Bảng giá chỉ hữu ích nếu các yêu cầu của bạn thực sự trúng cache và giữ dưới 272K. Agent lập trình của bạn có thể kiểm tra điều đó ở mỗi lần build với Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho agent của bạn một prompt duy nhất:
Create an Apidog test case in project <id> for POST /v1/responses with model
gpt-6.2-astra. Send the same 2,000-token system prompt twice. Assert both calls
return 200, usage.input_tokens stays under 272000, and the second call reports
usage.input_tokens_details.cached_tokens above 0. Run it against the openai
environment and summarize any failures.
Agent sẽ đọc schema, kiểm tra payload, tạo test case và chạy nó:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Nếu một thay đổi prompt làm hỏng caching hoặc đẩy một yêu cầu vượt 272K, lần chạy sẽ thất bại trước khi hóa đơn đến. Lệnh apidog run tương tự với -r junit có thể tích hợp vào CI; hướng dẫn Apidog CLI CI/CD pipeline của chúng tôi có cấu hình sẵn để copy-paste, còn Apidog CLI trong Codex trình bày phần tích hợp agent. Gói Free của Apidog hỗ trợ tối đa 4 người dùng.
FAQ
GPT-6.2 Astra có giá bao nhiêu mỗi 1 triệu token? 8 USD mỗi 1 triệu token đầu vào, 0,40 USD mỗi 1 triệu token đầu vào từ cache và 40 USD mỗi 1 triệu token đầu ra ở gói Standard, áp dụng cho các yêu cầu tối đa 272K token đầu vào.
GPT-6.2 Astra có rẻ hơn GPT-6 Astra không? Có. Đầu vào và đầu ra thấp hơn 20% (8/40 USD so với 10/50 USD) và giá đọc cache thấp hơn 60% (0,40 USD so với 1,00 USD). Phiên agent có cache của chúng tôi rẻ hơn 31%.
GPT-6.2 Sol có giá bao nhiêu? 2 USD mỗi 1 triệu token đầu vào, 0,10 USD cho cache và 10 USD cho đầu ra — cùng mức giá niêm yết với GPT-6.1 Sol và GPT-6 Sol. Chỉ bằng một phần tư giá của Astra trên mọi hạng mục.
GPT-6.2 Astra có tính phí cao hơn cho prompt dài không? Có. Trên 272K token đầu vào, giá đầu vào và cache tăng gấp đôi, đầu ra tăng lên 1,5 lần cho toàn bộ yêu cầu: 16 USD đầu vào, 0,80 USD cache và 60 USD đầu ra mỗi 1 triệu token.
Có được giảm giá khi dùng GPT-6.2 Astra không? Batch có giá bằng 50% của Standard. Các yêu cầu nền trên Responses API được giảm 30% với cửa sổ 2 giờ hoặc giảm 40% với cửa sổ 8 giờ (beta công khai). Caching giúp giảm giá các prefix lặp lại xuống 0,05 lần giá đầu vào.
Token suy luận có tính vào hóa đơn GPT-6.2 Astra không? Có. Token suy luận được tính theo giá đầu ra 40 USD mỗi 1 triệu, và model từ chối mức suy luận none, nên hãy dự trù chi phí suy luận cho mọi lần gọi.