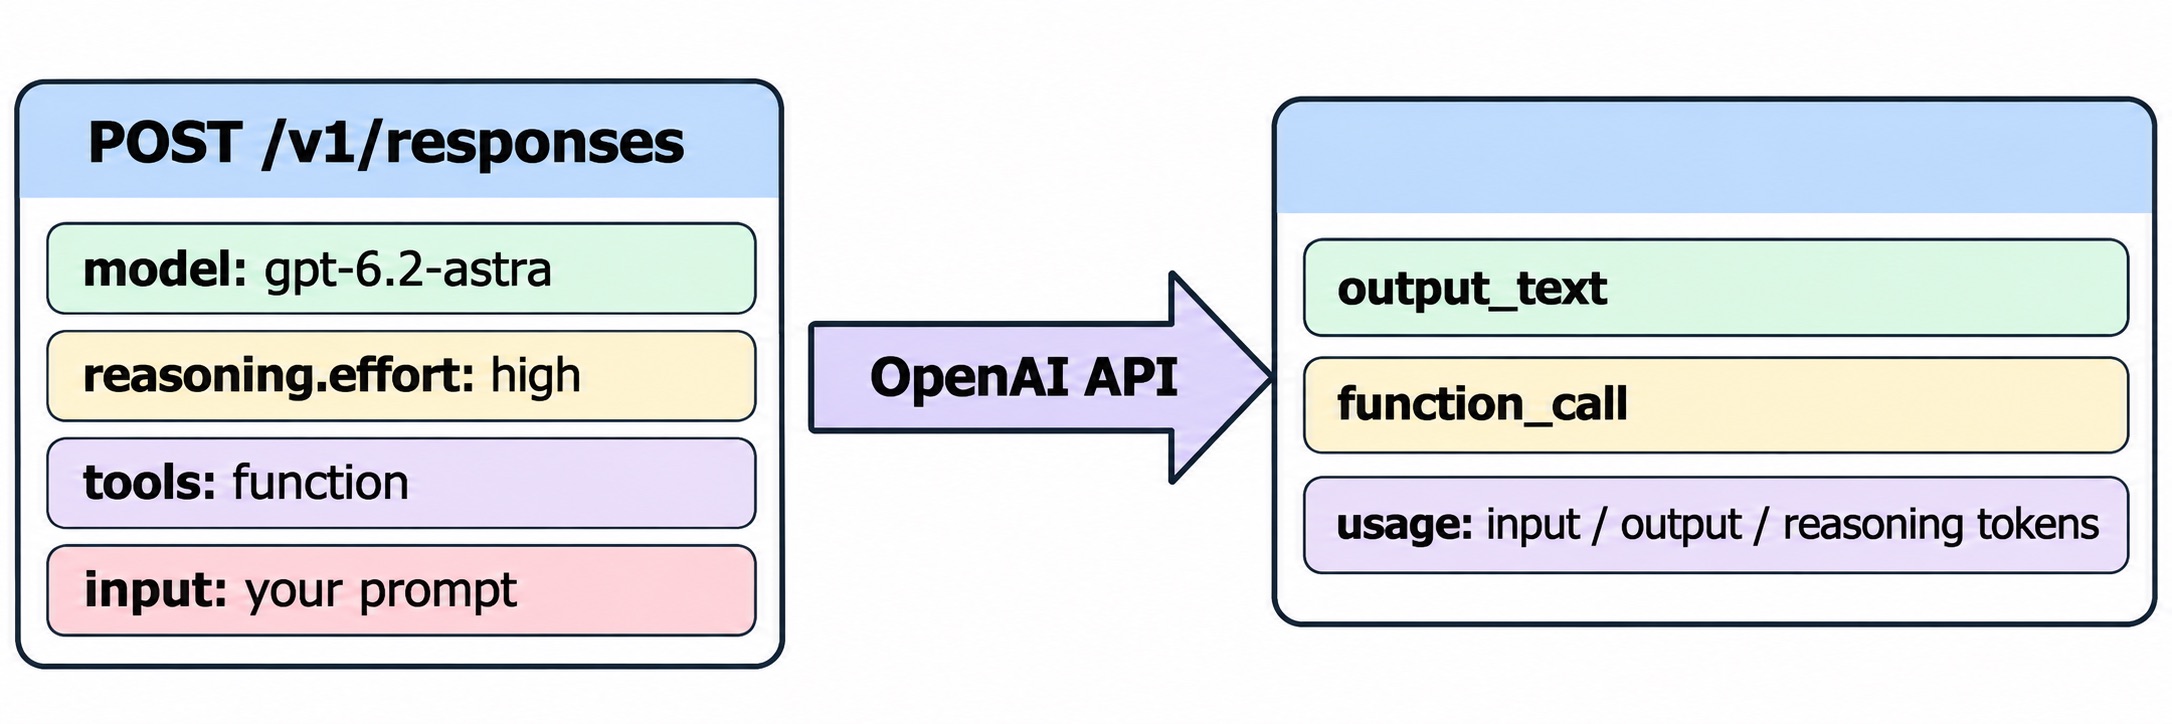
Câu trả lời nhanh: Để sử dụng GPT-6.2 Astra API, hãy gửi một yêu cầu tới endpoint Responses của OpenAI (POST /v1/responses) với "model": "gpt-6.2-astra", một mức effort cho reasoning như "high", cùng với đầu vào của bạn. Giá là 8 USD cho mỗi triệu token đầu vào và 40 USD cho mỗi triệu token đầu ra, nhận tối đa 922K token đầu vào và trả về tối đa 128K token. Đừng đặt effort là none: API sẽ từ chối giá trị này.
OpenAI đã phát hành GPT-6.2 Astra và GPT-6.2 Sol – phiên bản rẻ hơn – vào ngày 17 tháng 11 năm 2026. Nếu bạn đã từng gọi GPT-6 Astra trước đây, phần lớn mã nguồn của bạn có thể dùng lại được. Hướng dẫn này sẽ đi qua GPT-6.2 Astra API từ yêu cầu đầu tiên đến tool calls, tinh chỉnh effort, những bẫy về giá và một bài kiểm tra có thể lặp lại mà coding agent của bạn có thể chạy thay bạn.
Bạn cần chuẩn bị gì trước khi gọi GPT-6.2 Astra API lần đầu
Bạn cần bốn thứ, và có lẽ bạn đã có sẵn ba trong số đó:
- Khóa OpenAI API từ bảng điều khiển platform, được xuất dưới dạng biến
OPENAI_API_KEY. - Gói trả phí (paid usage tier). Trang mô hình của OpenAI liệt kê giới hạn tỷ lệ (rate limits) của Astra bắt đầu từ gói Build (5.000 yêu cầu và 1M token mỗi phút).
- Model ID
gpt-6.2-astra. Mô hình giá rẻ hơn làgpt-6.2-sol. - Một endpoint được hỗ trợ: Responses, Chat Completions hoặc Batch. Realtime, Assistants và fine-tuning không hỗ trợ cả hai mô hình này.
Các thông số này lấy từ trang mô hình GPT-6.2 Astra của OpenAI, kiểm tra vào ngày 18 tháng 11 năm 2026.
| Thông số | GPT-6.2 Astra |
|---|---|
| Model ID | gpt-6.2-astra |
| Cửa sổ ngữ cảnh (context window) | 1.050.000 token |
| Đầu vào tối đa | 922.000 token |
| Đầu ra tối đa | 128.000 token |
| Ngày cắt kiến thức | 18 tháng 5 năm 2026 |
| Endpoint | Responses, Chat Completions, Batch |
| Tính năng | Streaming, function calling, structured outputs, đầu vào hình ảnh, prompt caching |
Cách gửi yêu cầu GPT-6.2 Astra API đầu tiên
Responses API là endpoint mà OpenAI phát triển các tính năng mới, vì vậy hãy bắt đầu từ đây. Các bước như sau:
- Xuất khóa của bạn:
export OPENAI_API_KEY=sk-... - Gửi yêu cầu với model ID và một mức effort.
- Đọc
output_textđể lấy câu trả lời vàusageđể biết số token.
Với curl:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.2-astra",
    "reasoning": { "effort": "high" },
    "input": "Review this migration plan and list the three biggest risks."
  }'
Với Python SDK chính thức (pip install --upgrade openai):
from openai import OpenAI

client = OpenAI()  # reads OPENAI_API_KEY

response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    input="Review this migration plan and list the three biggest risks.",
)

print(response.output_text)
print(response.usage)
Với Node.js (npm install openai):
import OpenAI from "openai";

const client = new OpenAI();

const response = await client.responses.create({
  model: "gpt-6.2-astra",
  reasoning: { effort: "high" },
  input: "Review this migration plan and list the three biggest risks.",
});

console.log(response.output_text);
Hãy kiểm tra khối usage trong những lần gọi đầu tiên. Astra tiêu tốn token reasoning trước khi viết ra một từ nào đó, và những token này được tính phí như token đầu ra. Một câu trả lời ngắn vẫn có thể tốn nhiều hơn bạn nghĩ.
Chọn mức reasoning effort cho GPT-6.2 Astra
Reasoning effort là yếu tố ảnh hưởng lớn nhất đến cả chất lượng lẫn chi phí. Hướng dẫn reasoning của OpenAI liệt kê các giá trị none, minimal, low, medium, high, xhigh và max, đồng thời nói rằng mỗi mô hình chỉ hỗ trợ một tập con của các giá trị này. Với GPT-6.2 Astra và Sol, quy tắc được xác nhận duy nhất là none sẽ bị từ chối, vì vậy mọi cuộc gọi đều có một phần reasoning nhất định.
| Effort | Dùng cho |
|---|---|
low / medium |
Chỉnh sửa đơn giản, trích xuất dữ liệu, câu trả lời ngắn |
high |
Code review, lập kế hoạch, hầu hết các prompt khó. Mức mặc định hợp lý để bắt đầu thử nghiệm |
xhigh |
Các phiên agent dài và công việc chạy nền, chỉ dùng khi đánh giá (eval) cho thấy lợi ích rõ rệt |
max |
Những bài toán khó nhất của bạn, nơi một câu trả lời tốt hơn xứng đáng với chi phí gấp nhiều lần số token |
OpenAI không công bố mức effort mặc định của Astra, vì vậy hãy đặt rõ ràng trong mọi yêu cầu. Điều này giúp hóa đơn và kết quả kiểm tra của bạn luôn có thể tái lập.
Effort thay đổi chi phí bao nhiêu? Simon Willison đã chạy cùng một prompt hình ảnh qua từng mô hình ở ba mức effort trong ngày ra mắt và công bố chi phí. Astra tốn 11,55 cent ở mức high, 17,70 cent ở mức xhigh và 88,71 cent ở mức max. Chuyển từ high lên max làm chi phí tăng gần tám lần.
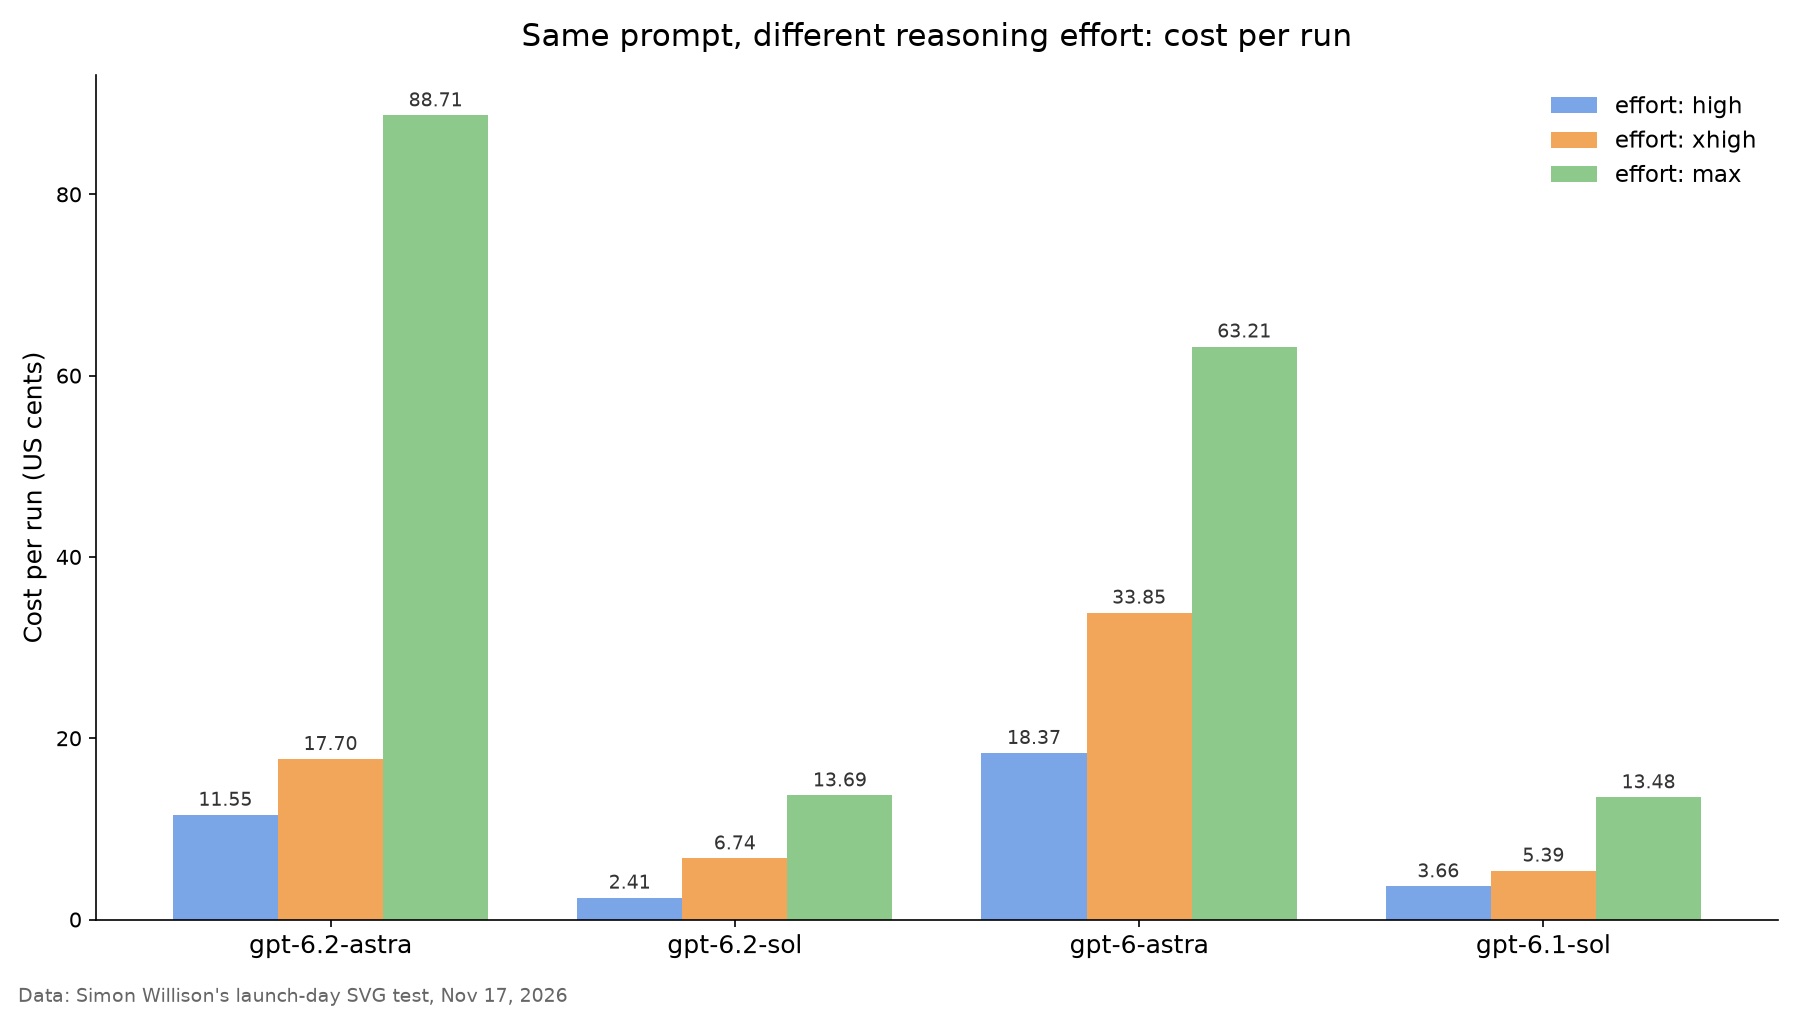
Lưu ý rằng GPT-6.2 Astra rẻ hơn GPT-6 Astra ở mức high và xhigh, nhưng lại đắt hơn ở mức max. Giá mỗi token giảm 20%, nhưng mức max lại suy nghĩ lâu hơn. Hãy đo chi phí cho mỗi tác vụ hoàn thành, chứ đừng chỉ đo chi phí cho mỗi triệu token.
Sử dụng tools và structured outputs với GPT-6.2 Astra API
Astra hỗ trợ function calling, structured outputs và danh sách dài các hosted tools trong Responses API: web search, file search, image generation, code interpreter, hosted shell, apply patch, skills, computer use, MCP và tool search.
Một function tool trông giống hệt như đối với GPT-6 Astra:
response = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "high"},
    tools=[{
        "type": "function",
        "name": "get_order_status",
        "description": "Look up an order by its ID.",
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"],
        },
    }],
    input="Where is order A-1042?",
)

for item in response.output:
    if item.type == "function_call":
        print(item.name, item.arguments)
Bạn tự chạy hàm đó, sau đó gửi kết quả trả về dưới dạng một mục function_call_output với call_id tương ứng. Astra sẽ viết câu trả lời cuối cùng dựa trên kết quả này.
Để nhận đầu ra mà máy có thể đọc được, hãy truyền một JSON schema vào text.format với "type": "json_schema" và "strict": true. Khi đó, mô hình sẽ trả về JSON khớp với schema của bạn, để bạn có thể parse mà không cần đoán.
Hai thói quen sau sẽ giúp bạn khi làm việc với một mô hình mạnh mẽ đến vậy. Thứ nhất, hãy mô tả mỗi tool thật ngắn gọn, chặt chẽ kèm schema nghiêm ngặt; các reviewer trong ngày ra mắt cho biết Astra có thể đi chệch hướng với các tác vụ dài, mở. Thứ hai, hãy đặt max_output_tokens trong các vòng lặp agent để một bước chạy mất kiểm soát không thể tiêu hết ngân sách của bạn. Để tìm hiểu thêm về endpoint này, hãy xem hướng dẫn OpenAI Responses API của chúng tôi.
Giá và giới hạn tỷ lệ của GPT-6.2 Astra API
Astra được định giá theo mỗi triệu token, kèm phụ phí cho các prompt rất dài. Các mức giá này lấy từ trang mô hình:
| Hạng mục | GPT-6.2 Astra | GPT-6 Astra (để tham chiếu) |
|---|---|---|
| Đầu vào | 8,00 USD | 10,00 USD |
| Đầu vào từ bộ nhớ đệm | 0,40 USD | 1,00 USD |
| Ghi cache (lưu giữ 30 phút) | 10,00 USD | không có |
| Đầu ra | 40,00 USD | 50,00 USD |
Bẫy nằm ở quy tắc ngữ cảnh dài. Khi một yêu cầu vượt quá 272K token đầu vào, giá đầu vào và cache sẽ tăng gấp đôi và giá đầu ra nhân 1,5 lần cho toàn bộ yêu cầu. Một prompt 300K token sẽ được tính phí 16 USD đầu vào và 60 USD đầu ra, chứ không chỉ những token vượt qua ngưỡng đó. Nếu bạn đang nạp cho Astra cả kho mã nguồn, hãy chia nhỏ hoặc dùng cache dưới 272K khi có thể.
Các tác vụ Batch phù hợp với việc đánh giá (eval) và backfill có thể chờ đợi; VentureBeat cho biết Batch chạy với giá bằng một nửa.
Giới hạn tỷ lệ tiêu chuẩn theo từng gói:
| Gói | Yêu cầu/phút | Token/phút |
|---|---|---|
| Build | 5.000 | 1.000.000 |
| Launch | 10.000 | 4.000.000 |
| Grow | 15.000 | 40.000.000 |
Hãy xử lý phản hồi 429 bằng exponential backoff. Một phiên agent dài ở mức xhigh có thể đốt nhanh ngân sách token của gói Build.
Chuyển đổi từ GPT-6 Astra sang GPT-6.2 Astra
Phần lớn mã nguồn chỉ cần thay đổi một thứ: chuỗi tên mô hình. Trước khi áp dụng vào môi trường sản xuất, hãy kiểm tra những điều sau:
- Model ID:
gpt-6-astrađổi thànhgpt-6.2-astra. - Effort
none: nếu bất kỳ luồng mã nào gửi giá trị này, nó sẽ thất bại. Hãy chuyển sang mức thấp nhất mà eval của bạn chấp nhận. - Prompt caching: giá đầu vào từ cache giảm từ 1,00 USD xuống 0,40 USD, vì vậy các system prompt và danh sách tool ổn định giờ đây rất đáng để cache.
- Prompt dài: hãy kiểm tra lại mọi yêu cầu gần ngưỡng 272K token theo quy tắc ngữ cảnh dài ở trên.
- An toàn: OpenAI cho biết cả hai mô hình GPT-6.2 đạt ngưỡng an ninh mạng "Critical" và được trang bị các biện pháp bảo vệ nghiêm ngặt hơn. Các prompt về công cụ bảo mật có thể gặp phản hồi từ chối mà trước đây không có.
Các đánh giá ban đầu khá trái chiều, vì vậy hãy kiểm thử trước khi chuyển đổi. Ethan Mollick nhận xét Astra "rất bất ổn & kỳ lạ", còn Dan Shipper cho biết nó thường dừng sớm với các dự án end-to-end, theo tổng hợp của VentureBeat. Người khác lại khen khả năng code review và computer use của nó. Chính prompt của bạn mới là thước đo duy nhất quan trọng. Hướng dẫn GPT-6 Astra API trình bày những gì có thể dùng lại từ thế hệ trước, và nếu phần lớn lưu lượng của bạn là công việc thông thường, hướng dẫn GPT-6.1 Sol API sẽ cho thấy cấu trúc yêu cầu của gói rẻ hơn này.
Để coding agent của bạn kiểm thử GPT-6.2 Astra với Apidog CLI
Việc dán prompt vào terminal chỉ cho bạn biết Astra hoạt động ra sao hôm nay. Nó không thể cho bạn biết khi nào một bản cập nhật làm hỏng schema của bạn vào tháng sau. Hãy để coding agent xây dựng bài kiểm tra và chạy nó bằng Apidog CLI; bạn chỉ cần viết một prompt duy nhất.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó, đưa cho Claude Code, Codex hoặc Cursor một prompt:
In Apidog project <projectId>, create a test case for POST https://api.openai.com/v1/responses
with model "gpt-6.2-astra", reasoning effort "high" and a get_order_status function tool.
Assert status 200, that the output contains a function_call named get_order_status,
that its arguments parse as JSON with an order_id, and that usage.output_tokens is under 4000.
Read the API key from the OPENAI_API_KEY variable in environment <envId>, then run it.
Agent sẽ đọc schema của payload, kiểm tra file của nó, tạo test case và chạy:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Hãy giữ khóa trong môi trường Apidog, không đưa vào prompt, để nó không bao giờ nằm trong ngữ cảnh của agent. Thêm --upload-report để xem lại lần chạy trong ứng dụng Apidog, hoặc -n 5 để lặp lại và xem các tool call của Astra có ổn định không. Đưa -r junit vào pipeline và bài kiểm tra sẽ tự chạy lại ở mỗi lần triển khai; hướng dẫn Apidog CLI trong CI/CD trình bày cách thiết lập, còn Apidog CLI trong Claude Code bao gồm phần tích hợp agent. Gói Free của Apidog hỗ trợ đội nhóm tới 4 người dùng.
Câu hỏi thường gặp
Model ID của GPT-6.2 Astra API là gì? gpt-6.2-astra. Phiên bản rẻ hơn là gpt-6.2-sol. Cả hai đều hoạt động trên các endpoint Responses, Chat Completions và Batch.
GPT-6.2 Astra API giá bao nhiêu? 8 USD cho mỗi triệu token đầu vào, 0,40 USD cho mỗi triệu token đầu vào từ cache và 40 USD cho mỗi triệu token đầu ra. Các yêu cầu vượt 272K token đầu vào sẽ bị tính gấp đôi đầu vào và nhân 1,5 lần đầu ra cho toàn bộ yêu cầu.
Tại sao yêu cầu GPT-6.2 Astra của tôi thất bại với reasoning effort none? Cả hai mô hình GPT-6.2 đều từ chối "effort": "none". Hãy đặt high, hoặc mức thấp nhất mà kiểm thử của bạn cho thấy phù hợp với tác vụ.
Cửa sổ ngữ cảnh của GPT-6.2 Astra là bao nhiêu? Tổng cộng 1.050.000 token, với tối đa 922.000 token đầu vào và 128.000 token đầu ra.
Có thể dùng GPT-6.2 Astra với Chat Completions API không? Có. Nó được hỗ trợ, nhưng các hosted tools như web search, computer use và apply patch chỉ được liệt kê cho Responses API, vì vậy hãy dùng Responses cho công việc agent.
GPT-6.2 Astra có miễn phí không? Không trên API; mọi cuộc gọi đều được tính phí. Trên ChatGPT Work và Codex, nó được bao gồm trong các gói Plus, Pro, Enterprise và Edu, theo thông báo ra mắt của OpenAI.