
Trong vòng vài tuần của mùa hè năm 2026, OpenAI và Google đều đã phát hành một mô hình chuyên biệt về bảo mật mà hầu hết các nhà phát triển không thể tiếp cận. GPT-5.6-Cyber của OpenAI ra mắt vào ngày 10 tháng 8. Gemini 3.5 Flash Cyber của Google xuất hiện vào ngày 21 tháng 7. Cả hai đều tìm thấy các lỗ hổng phần mềm. Cả hai đều bị giới hạn quyền truy cập và yêu cầu phê duyệt. Và cả hai đều từ chối cung cấp cho bạn một khóa API thông thường.
Tuy nhiên, chúng không phải là cùng một loại công cụ. Một cái nghiêng về phòng thủ, một cái nghiêng về tấn công, và chúng nằm ở các tầng mô hình rất khác nhau. Nếu bạn đang cố gắng hiểu hai loại này, đây là cách chúng thực sự so sánh, và tại sao một cuộc đối đầu trực tiếp về điểm chuẩn giữa chúng là không thể.
So sánh trực tiếp
| GPT-5.6-Cyber | Gemini 3.5 Flash Cyber | |
|---|---|---|
| Nhà cung cấp | OpenAI | |
| Ra mắt | 10 tháng 8, 2026 | 21 tháng 7, 2026 |
| Được xây dựng trên | GPT-5.6 Sol (tầng flagship) | Gemini Flash (tầng nhanh, rẻ) |
| Xu hướng | Tấn công: chuỗi khai thác, phát hiện lỗ hổng zero-day | Phòng thủ: tìm và khắc phục lỗ hổng |
| Truy cập | Daybreak Red (đội bảo mật được kiểm duyệt) | Thử nghiệm giới hạn (chính phủ, đối tác đáng tin cậy) |
| API công khai | Không | Không |
| Giá công khai | Không | Không |
| Chương trình | OpenAI Daybreak | Google CodeMender |
Tóm tắt ngắn gọn: GPT-5.6-Cyber là một mô hình nghiên cứu tấn công cấp tiên phong, và Gemini 3.5 Flash Cyber là một mô hình vá lỗi phòng thủ cấp nhẹ hơn. Sự khác biệt về định hướng đó giải thích gần như mọi thứ còn lại.
Các tầng mô hình khác nhau
Sự khác biệt kỹ thuật rõ ràng nhất nằm ở mô hình cơ sở. GPT-5.6-Cyber được xây dựng trên GPT-5.6 Sol, mô hình suy luận mạnh mẽ nhất của OpenAI. Nghiên cứu lỗ hổng trong thế giới thực cần khả năng suy luận bền vững trên các cơ sở mã lớn, không quen thuộc, và OpenAI đã đặt mô hình cấp cao nhất của mình dưới Cyber để đạt được điều đó.
Gemini 3.5 Flash Cyber được xây dựng trên tầng Flash, một công cụ nhanh chóng và không tốn kém của Google thay vì flagship Pro của họ. Đó là một sự phù hợp có chủ ý cho công việc của nó. CodeMender, chương trình của Google đứng sau nó, là về việc quét mã để tìm và sửa lỗi trên quy mô lớn, điều này đề cao tốc độ và hiệu quả chi phí hơn là độ sâu suy luận một lần tối đa. Cũng cần lưu ý sự khác biệt về phiên bản: mô hình Flash chung đã chuyển sang 3.6, nhưng Cyber vẫn ở 3.5, vì hai mô hình này có các lộ trình phát hành khác nhau.
Hướng định khác biệt: tấn công so với phòng thủ
Đây là điểm khác biệt thực sự. Đọc cách mỗi nhà cung cấp tự định hình và sự phân chia trở nên rõ ràng.
OpenAI đã huấn luyện GPT-5.6-Cyber để giảm từ chối đối với các tác vụ lưỡng dụng rủi ro cao hơn và để giỏi hơn trong việc tìm kiếm các lỗ hổng zero-day và xây dựng chuỗi khai thác, theo thông báo mở rộng Daybreak của họ. Nó được phân phối thông qua Daybreak Red, tầng dành riêng cho “nghiên cứu lỗ hổng được ủy quyền, xác thực khai thác và kiểm tra bảo mật”. Bằng chứng khi ra mắt là khả năng tấn công: hai lỗ hổng V8 liên tiếp trong Chrome, được gán CVE-2026-15903, cùng với các phát hiện được báo cáo trên một hệ điều hành di động, một cơ sở dữ liệu và một nhân hệ điều hành.
Google định hình Gemini 3.5 Flash Cyber xoay quanh việc tìm và sửa lỗi. Được công bố trong cập nhật mô hình Gemini của họ, nó là một phần của CodeMender, một nỗ lực nhằm phát hiện các lỗ hổng bảo mật trong mã và đề xuất các bản vá cho chúng. Trọng tâm là khắc phục, bịt các lỗ hổng, chứ không phải biến chúng thành vũ khí.
Điều đó không làm cho một bên “an toàn” và một bên “nguy hiểm”. Một công cụ tìm lỗ hổng mạnh mẽ là lưỡng dụng bất kể nó được định hình như thế nào, đó chính là lý do tại sao cả hai đều bị giới hạn quyền truy cập. Nhưng nếu bạn đang phác thảo lĩnh vực này, OpenAI đã đẩy mạnh hơn về nghiên cứu tấn công, và Google vẫn gần hơn với việc vá lỗi phòng thủ.
Mức độ minh bạch khác nhau
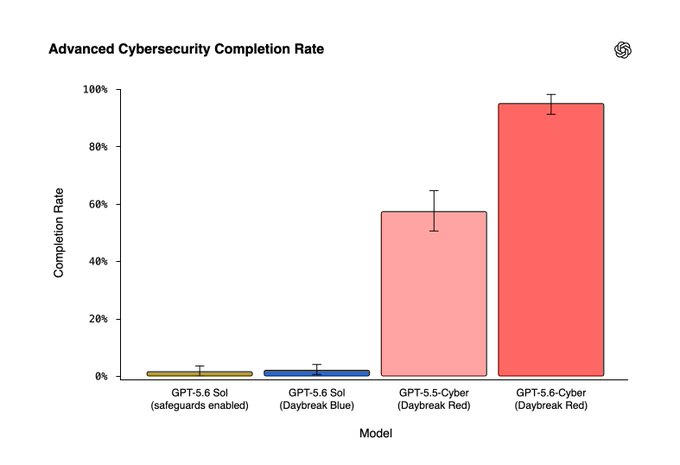
OpenAI đã công bố nhiều số liệu hơn. Họ tiết lộ một chỉ số tỷ lệ hoàn thành nội bộ (GPT-5.6-Cyber trả lời 95.0% các lời nhắc cyber nâng cao so với 1.5% đối với Sol cơ sở), các điểm chuẩn được đặt tên như ExploitGym, báo cáo một CVE thực tế được gán, và tuyên bố xếp hạng Khung Sẵn sàng là “Cao” nhưng dưới “Nghiêm trọng”. Để biết chi tiết đầy đủ về ai được cấp quyền truy cập vào cái gì, hãy xem Daybreak Blue vs Red.
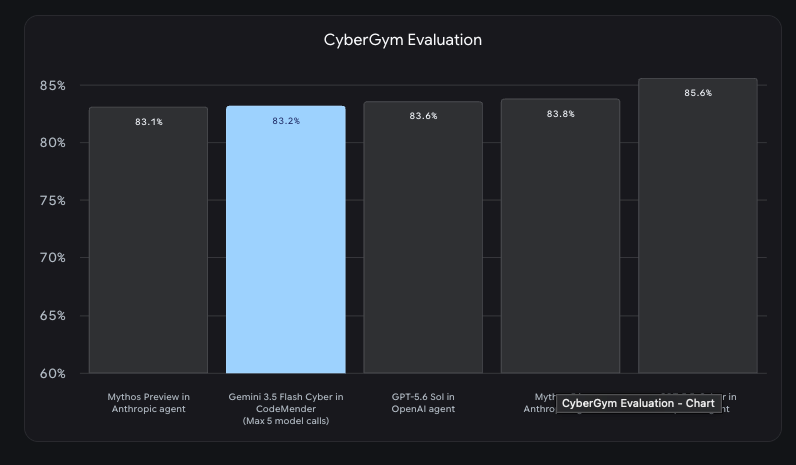
Google mơ hồ hơn khi ra mắt. Họ xác nhận mô hình tồn tại, mục đích phòng thủ của nó và trạng thái bị giới hạn quyền truy cập, mà không công bố tỷ lệ hoàn thành mỗi tác vụ hoặc bảng điểm chuẩn so sánh. Vì vậy, mặc dù bạn có thể mô tả cả hai mô hình, bạn không thể đặt chúng trên cùng một biểu đồ. Không có điểm chuẩn chung nào mà cả hai nhà cung cấp đã chạy đối đầu, và các nhiệm vụ mục tiêu của họ (phát triển khai thác so với tạo bản vá) hầu như không trùng lặp.
Điểm chung của chúng
Loại bỏ những khác biệt, hai mô hình này cùng kể một câu chuyện về hướng đi của các công cụ bảo mật AI:
- Truy cập bị giới hạn, không phải API mở. Cả hai đều không tự phục vụ. Cả hai đều yêu cầu phê duyệt, và quyền truy cập được giới hạn cho các tổ chức được kiểm duyệt.
- Không có giá công khai. Bởi vì không có quyền truy cập mở, nên không có mức giá công khai cho mỗi token nào được công bố cho cả hai. Bất kỳ bảng giá nào bạn tìm thấy đang lưu hành đều không được xác minh.
- Logic lưỡng dụng tương tự. Cả hai nhà cung cấp đều lập luận rằng một mô hình giỏi tìm lỗ hổng vốn dĩ sẽ giỏi tìm lỗ hổng, vì vậy họ đang bắt đầu giới hạn với các đối tác đáng tin cậy và theo dõi trước khi mở rộng quyền truy cập.
- Một câu chuyện phiên bản khó hiểu. Mô hình của OpenAI nằm dưới hệ thống đặt tên Sol/Terra/Luna; mô hình của Google vẫn ở 3.5 trong khi phiên bản anh em của nó đã lên 3.6.
Nếu bạn đến một trong hai để tìm kiếm khóa API, câu trả lời là như nhau: không phải hôm nay, và có thể không theo cách bạn mong đợi.
Cái nào quan trọng với bạn? Có lẽ không phải cái nào cả, ít nhất là bây giờ
Đây là cách hiểu thực tế. Trừ khi bạn làm việc cho một nhà cung cấp bảo mật được phê duyệt hoặc là đối tác của chính phủ, bạn không thể sử dụng một trong hai mô hình này ngay bây giờ. Việc theo dõi chúng rất hữu ích để hiểu hướng phát triển, nhưng không có mô hình nào thuộc về hệ thống của bạn trong quý này.
Điều thực sự thuộc về hệ thống của bạn là kiểm thử bảo mật của các API mà bạn thực sự sở hữu. Cả hai mô hình này đều tồn tại vì các lỗ hổng rất tốn kém; những lỗ hổng rẻ nhất để ngăn chặn là các lỗi biên giới nhàm chán trong các dịch vụ của riêng bạn. Bạn không cần một mô hình cyber tiên phong để phát hiện những lỗi đó.
Với một công cụ client API như Apidog, bạn có thể chạy các kiểm tra phát hiện được nhiều lỗi nhất với ít công sức nhất:
- Giới hạn xác thực (Auth boundaries). Gửi các yêu cầu với token bị thiếu, hết hạn và hợp lệ, sau đó xác nhận mỗi yêu cầu trả về trạng thái đúng. Nguyên tắc đặc quyền tối thiểu tương tự áp dụng cho các tác nhân của bạn; xem khóa API của tác nhân AI của bạn thực sự có thể làm gì.
- Bảo mật truyền tải (Transport security). Xác minh chứng chỉ client và mTLS hoạt động đúng, và các yêu cầu đơn giản bị từ chối.
Đó là công việc bạn có thể bắt đầu ngay hôm nay, với các công cụ mà bạn thực sự có thể truy cập. Tải xuống Apidog và bắt đầu với các trường hợp xác thực.
Các câu hỏi thường gặp
Cái nào tốt hơn, GPT-5.6-Cyber hay Gemini 3.5 Flash Cyber? Chúng được xây dựng cho các công việc khác nhau, vì vậy “tốt hơn” phụ thuộc vào nhiệm vụ. GPT-5.6-Cyber là một mô hình cấp tiên phong được tinh chỉnh cho nghiên cứu tấn công (phát triển khai thác, phát hiện zero-day). Gemini 3.5 Flash Cyber là một mô hình cấp nhẹ hơn được tinh chỉnh cho việc vá lỗi phòng thủ. Cả hai nhà cung cấp đều chưa công bố một điểm chuẩn đối đầu, vì vậy không có sự so sánh điểm trực tiếp nào.
Tôi có thể sử dụng một trong hai thông qua API không? Không. Cả hai đều bị giới hạn quyền truy cập. GPT-5.6-Cyber yêu cầu phê duyệt Daybreak Red; Gemini 3.5 Flash Cyber là một chương trình thử nghiệm giới hạn dành cho chính phủ và các đối tác đáng tin cậy. Cả hai đều không cung cấp ID mô hình API tự phục vụ.
Tại sao cả hai mô hình đều bị hạn chế? Lưỡng dụng. Một mô hình giỏi tìm lỗ hổng giúp các nhà phòng thủ vá lỗi và giúp kẻ tấn công khai thác. Cả hai nhà cung cấp đang giới hạn quyền truy cập cho các đối tác được kiểm duyệt trong khi họ giám sát việc sử dụng trong thế giới thực.
Sự khác biệt giữa các mô hình cơ sở là gì? GPT-5.6-Cyber được xây dựng trên GPT-5.6 Sol, tầng suy luận flagship của OpenAI. Gemini 3.5 Flash Cyber được xây dựng trên tầng Flash nhanh hơn, rẻ hơn của Google, phù hợp với mục đích quét và sửa lỗi của nó.
Tôi nên sử dụng cái gì thay thế? Để bảo mật các API của riêng bạn, hãy chạy các kiểm tra xác thực, truyền tải và hợp đồng với một client như Apidog. Không cần mô hình bị giới hạn quyền truy cập.