
Z.ai hiện đang bán hai mẫu với tên gần giống nhau, cùng một cửa sổ ngữ cảnh 1M-token và chênh lệch giá gấp chín lần. Cách đặt tên không giúp bạn chọn. “Flash” ngụ ý một biến thể nhỏ hơn, nhanh hơn, yếu hơn, và chỉ một trong ba từ đó là chính xác.
Đây là phiên bản ngắn gọn: GLM-5.3-Flash rẻ hơn, xử lý hình ảnh nguyên bản và cung cấp cho người dùng gói coding ba lần hạn mức. GLM-5.3 thông minh hơn một chút và tạo ra kết quả nhanh gần gấp đôi. Đối với hầu hết các khối lượng công việc, Flash là lựa chọn mặc định đúng đắn và bạn cần có lý do chính đáng để chọn phiên bản đắt tiền hơn.
Bài đăng này sẽ giải thích những trường hợp mà quy tắc đó không còn đúng.
Bảng so sánh
| GLM-5.3-Flash | GLM-5.3 | |
|---|---|---|
| Chỉ số thông minh (Phân tích nhân tạo) | 57 | 60 |
| Giá trung bình cho 1M token | $0.10 | $0.90 |
| Giá niêm yết đầu vào / đầu ra cho 1M | $0.15 / $0.50 | $1.40 / $4.40 |
| Tốc độ đầu ra | ~49 tokens/giây | ~86 tokens/giây |
| Thời gian đến token đầu tiên | 1.52 giây | 1.57 giây |
| Cửa sổ ngữ cảnh | 1.048.576 | 1.048.576 |
| Đầu vào hình ảnh nguyên bản | Có | Không, dựa trên bộ điều hợp |
| Tham số | Tổng 320B / 18B hoạt động | Lớn hơn, chưa được tiết lộ đầy đủ |
| Giấy phép | MIT, trọng số mở | Trọng số mở |
| Hạn mức gói Coding | Gấp 3 lần | Gấp 1 lần |
Số liệu tốc độ và thông minh là các phép đo của Artificial Analysis. Giá cả là giá niêm yết của Z.ai, trước khi có chiết khấu ra mắt được thảo luận bên dưới.
Khoảng cách giá gấp chín lần đến từ đâu
GLM-5.3-Flash là một mô hình chuyên gia hỗn hợp (mixture-of-experts) 320B kích hoạt 18B tham số trên mỗi token, được xây dựng trên một nền tảng mới với cơ chế chú ý lai tuyến tính và thưa thớt (hybrid linear and sparse attention). Z.ai báo cáo rằng Flash sử dụng ít tài nguyên tính toán cho cơ chế chú ý hơn GLM-5.3 khoảng ba lần và bộ nhớ KV cache nhỏ hơn khoảng 4,4 lần.
Kích thước KV cache là yếu tố khiến việc phục vụ ngữ cảnh dài trở nên đắt đỏ. Việc cắt giảm nó đi 4,4 lần là lý do chính khiến Z.ai có thể cung cấp cửa sổ 1M-token với giá chỉ bằng một phần mười. Bạn không phải trả ít hơn cho một ngữ cảnh ngắn hơn hoặc một mô hình yếu hơn. Bạn trả ít hơn vì dấu chân phục vụ (serving footprint) cho mỗi yêu cầu thực sự nhỏ hơn.
Đây là một kết quả kỹ thuật thực sự chứ không phải là một chương trình khuyến mãi, điều này quan trọng đối với việc liệu giá có giữ được hay không.
Ý nghĩa của khoảng cách thông minh ba điểm
57 so với 60 trên Chỉ số thông minh của Artificial Analysis là một khoảng cách hẹp về mặt tuyệt đối. Để hiệu chỉnh, mô hình trọng số mở trung bình có kích thước tương đương đạt 27 điểm, vì vậy cả hai mô hình này đều vượt xa so với mặt bằng chung.
Tuy nhiên, ba điểm không phải là không có gì. Khoảng cách chỉ số với quy mô đó thường xuất hiện dưới dạng: hiệu suất kém hơn một chút trong các chuỗi suy luận nhiều bước, trôi dạt nhiều hơn một chút trong các tác vụ đại diện rất dài và nhạy cảm hơn với các hướng dẫn mơ hồ. Chúng hiếm khi xuất hiện trong các tác vụ trích xuất, phân loại, tóm tắt hoặc chỉnh sửa mã một tệp đơn giản.
Thử nghiệm thực tế là liệu tác vụ của bạn có câu trả lời có thể kiểm chứng được hay không. Nếu bạn có thể kiểm tra đầu ra theo chương trình, lỗi đôi khi của Flash sẽ dễ dàng phát hiện và dễ dàng thử lại, và với giá chỉ bằng một phần chín, bạn có thể thử lại rất nhiều lần. Nếu tác vụ của bạn tạo ra văn xuôi mà con người phải đọc và đánh giá, sự khác biệt về chất lượng sẽ khó khắc phục hơn và khoảng cách giá cả ít quan trọng hơn kết quả.
Tốc độ là nơi duy nhất Flash thực sự thua kém
Đây là phần mà tên gọi trở nên ngược lại. GLM-5.3 tạo ra khoảng 86 token mỗi giây. GLM-5.3-Flash chỉ đạt khoảng 49. Mô hình lớn hơn, đắt tiền hơn nhanh gần gấp đôi trong việc tạo ra đầu ra.
Thời gian đến token đầu tiên gần như ngang nhau, ở mức 1.52 so với 1.57 giây, vì vậy cả hai đều có cảm giác phản hồi tương đương ở phần đầu của phản hồi.
Hậu quả hoàn toàn phụ thuộc vào độ dài đầu ra:
- Phản hồi ngắn. Không liên quan. Cả hai đều bắt đầu trong khoảng 1.5 giây và kết thúc trước khi ai đó nhận thấy sự khác biệt về thông lượng.
- Tạo nội dung dài. Một phản hồi 4.000 token mất khoảng 82 giây trên Flash và khoảng 47 giây trên GLM-5.3. Trong một công cụ tương tác, đó là một khoảng cách đáng kể.
- Các tác vụ theo lô với khả năng xử lý đồng thời. Cũng hầu như không liên quan, vì bạn mở rộng quy mô bằng các yêu cầu song song chứ không phải tốc độ trên mỗi luồng, và sự khác biệt về giá cho phép bạn có nhiều khả năng xử lý song song hơn.
Nếu bạn đang truyền tải đầu ra dạng dài cho người đang chờ, GLM-5.3 mang lại trải nghiệm tốt hơn. Đó là trường hợp rõ ràng nhất để trả tiền gấp chín lần.
Đa phương thức là ranh giới phân chia thực sự
GLM-5.3-Flash chấp nhận hình ảnh, video và tệp dưới dạng các khối nội dung trong cùng một yêu cầu hoàn tất cuộc trò chuyện giống như văn bản của bạn. GLM-5.3 không thực hiện điều này một cách nguyên bản; tầm nhìn thông qua các bộ điều hợp riêng biệt.
Nếu ứng dụng của bạn cần một mô hình để xem xét một thứ gì đó, đây không phải là một sự so sánh mà là một yêu cầu. Flash là một trong hai mô hình duy nhất thực hiện điều đó trong một cuộc gọi, trong một cửa sổ ngữ cảnh, trên một dòng thanh toán duy nhất.
Khả năng đó kết hợp với ngữ cảnh 1M theo một cách thực sự mới đối với dòng mô hình này: một tài liệu đặc tả dài và ảnh chụp màn hình của kết quả đã xây dựng có thể nằm trong cùng một lời nhắc. Định vị của chính Z.ai nói về việc quan sát giao diện và hiển thị kết quả, đây là một khung tác nhân viết mã (coding-agent framing) chứ không phải là một khung chú thích hình ảnh.
Hướng dẫn về thị giác của chúng tôi bao gồm tải trọng và quy trình làm việc. Các mô hình thị giác chuyên dụng cũ hơn được đề cập trong hướng dẫn API của GLM-5V-Turbo nếu bạn đang duy trì một thứ gì đó được xây dựng trên con đường đó.
Góc nhìn về gói Coding
Đối với những người đăng ký Gói Coding GLM, cách tính toán khác và đơn giản hơn. Flash được bao gồm trong gói và được báo cáo là có hạn mức sử dụng gấp ba lần so với GLM-5.3. Z.ai cũng lưu ý rằng các cuộc gọi ngoài giờ cao điểm tiêu thụ một nửa số điểm tiêu chuẩn.
Nếu bạn đang chạy Claude Code hoặc Cline so với hạn mức gói của mình, ba lần yêu cầu cho một sự sụt giảm chỉ số ba điểm là một sự đánh đổi dễ dàng cho công việc thường ngày. Giữ GLM-5.3 cho các vấn đề khó và để Flash xử lý khối lượng lớn. Thiết lập cho cả hai công cụ có trong hướng dẫn Claude Code và Cline của chúng tôi.
Xác minh hệ số nhân hạn mức trên z.ai trước khi lên kế hoạch dựa trên nó, vì các điều khoản gói thay đổi thường xuyên hơn các thông số kỹ thuật của mô hình.
Thời hạn áp dụng giá
Chương trình giảm giá 50% ra mắt cho GLM-5.3-Flash sẽ kéo dài đến hết ngày 09 tháng 9 năm 2026. Cho đến lúc đó, mức giá hiệu quả là 0,075 USD đầu vào và 0,25 USD đầu ra mỗi triệu, điều này mở rộng khoảng cách so với GLM-5.3 lên khoảng mười tám lần.
Sau khi chương trình kết thúc, giá niêm yết 0,15 USD và 0,50 USD sẽ được áp dụng và khoảng cách sẽ trở lại khoảng chín lần. Dù bằng cách nào, Flash cũng rẻ hơn đáng kể. Thời hạn quan trọng đối với việc chốt các dự báo chi phí, chứ không phải cho sự lựa chọn giữa hai mô hình. Phân tích giá của chúng tôi có các con số đã được tính toán.
Quy tắc đưa ra quyết định
Sử dụng GLM-5.3-Flash khi:
- Đầu vào của bạn bao gồm hình ảnh, video hoặc tệp.
- Chi phí mỗi token là yếu tố bạn đang tối ưu hóa.
- Bạn chạy các tác vụ trích xuất, phân loại hoặc định tuyến khối lượng lớn.
- Bạn đang sử dụng Gói Coding và muốn hạn mức của mình kéo dài hơn.
- Bạn muốn có trọng số mở được cấp phép MIT mà bạn có thể tự lưu trữ. Chạy cục bộ bao gồm phần cứng.
Sử dụng GLM-5.3 khi:
- Bạn truyền tải các phản hồi dài cho một người đang chờ và thông lượng là trải nghiệm cảm nhận được.
- Công việc của bạn là suy luận dài hạn, nơi ba điểm chỉ số tăng lên qua các bước.
- Chất lượng đầu ra được đánh giá bởi con người chứ không phải được kiểm tra bằng thử nghiệm.
Sử dụng cả hai khi: bạn có thể định tuyến. Gửi phần lớn lưu lượng truy cập đến Flash và leo thang lên GLM-5.3 khi gặp lỗi, độ tin cậy thấp hoặc loại tác vụ. Khoảng cách giá gấp chín lần khiến việc xây dựng một bộ định tuyến trở nên đáng giá, và vì cả hai mô hình đều nằm phía sau cùng một điểm cuối tương thích OpenAI, việc định tuyến chỉ là một thao tác hoán đổi ID mô hình chứ không phải một sự tích hợp.
Di chuyển giữa chúng
Nếu bạn đã sử dụng GLM-5.3 và đang đánh giá việc chuyển đổi, phần cơ học là không đáng kể và phần xác thực là nơi cần thực hiện công việc.
Những gì không thay đổi. URL cơ sở, lược đồ xác thực, hình dạng yêu cầu và phản hồi, ngữ nghĩa truyền phát và lược đồ gọi công cụ. Cả hai mô hình đều nằm phía sau cùng một bề mặt tương thích OpenAI. Việc hoán đổi chỉ là một chuỗi ID mô hình.
Những gì thay đổi. Chi phí cho mỗi cuộc gọi giảm khoảng chín lần. Tốc độ tạo nội dung chậm lại khoảng một nửa. Chất lượng suy luận thay đổi ba điểm chỉ số. Và bạn có được khả năng nhập hình ảnh mà trước đây không có.
Những gì cần kiểm tra trước khi cam kết. Chạy các lời nhắc thực tế của bạn qua cả hai mô hình và so sánh trên bốn khía cạnh: tính đúng đắn của đầu ra trong các trường hợp bạn có thể xác minh, độ trễ từ đầu đến cuối bao gồm thời gian tạo chứ không chỉ token đầu tiên, số lượng token từ đối tượng `usage` trên mỗi phản hồi và hành vi trên ngữ cảnh thực tế dài nhất của bạn.
Yếu tố thứ tư thường gây ra nhiều vấn đề nhất. Các mô hình trông tương đương trên các lời nhắc ngắn có thể khác biệt đáng kể khi ngữ cảnh đầy đủ, và một bảng điểm chuẩn sẽ không bao giờ cho bạn biết điều đó về dữ liệu của riêng bạn.
Nếu bạn bắt đầu với mô hình cơ sở, GLM-5.3 là gì bao gồm các điều khoản riêng của nó, và hướng dẫn API GLM-5.3 có thiết lập bạn đang di chuyển từ đó.
Hãy kiểm tra nó thay vì tin vào bảng
Mọi con số ở trên đều là tuyên bố của nhà cung cấp hoặc điểm chuẩn của bên thứ ba được chạy trên khối lượng công việc của người khác. Không điều nào cho bạn biết hai mô hình này hoạt động như thế nào với các lời nhắc của bạn.
Việc hoán đổi chỉ là một chuỗi. Trỏ một client tương thích OpenAI tới https://api.z.ai/api/paas/v4/, chạy các lời nhắc thực tế của bạn qua glm-5.3-flash và glm-5.3, sau đó so sánh đầu ra, độ trễ và số lượng token trên lưu lượng truy cập mà bạn quan tâm. Hướng dẫn API có phần thiết lập.
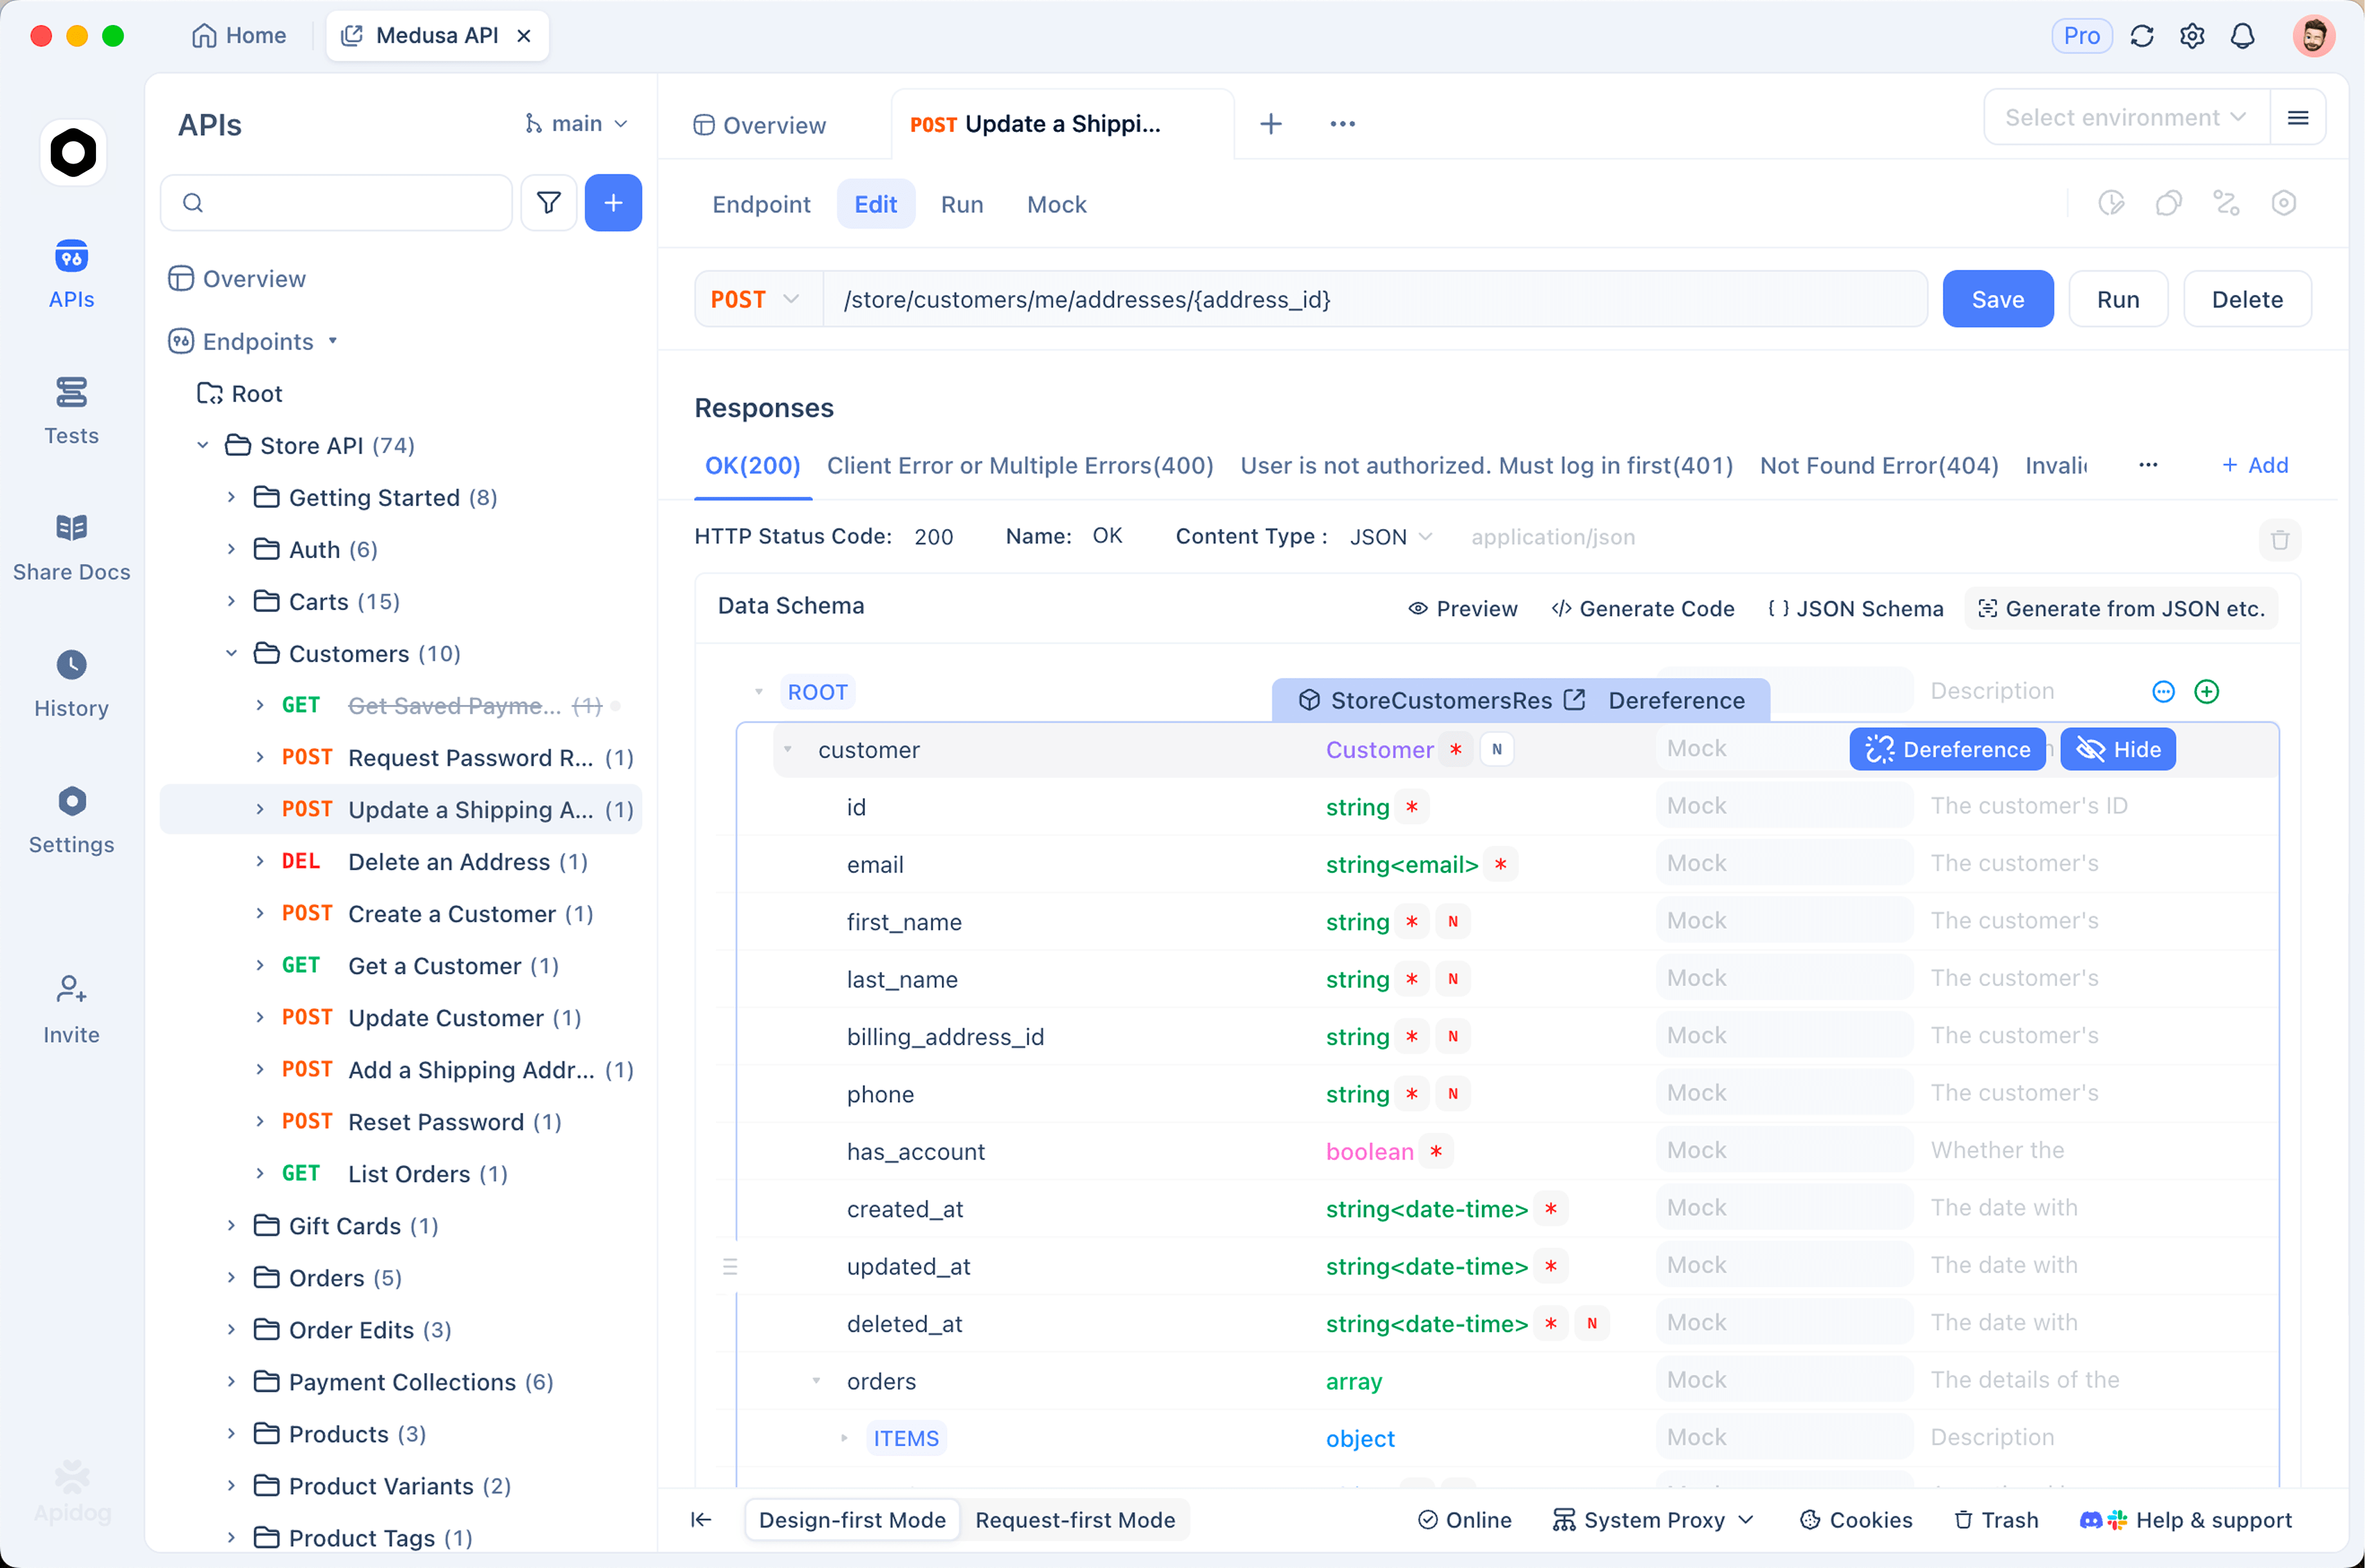
Đây là nơi việc lưu trữ so sánh dưới dạng một bộ thử nghiệm lặp lại sẽ phát huy tác dụng. Trong Apidog, bạn có thể giữ cả hai cuộc gọi trong một bộ sưu tập với ID mô hình là biến môi trường, đính kèm các xác nhận vào các trường mà ứng dụng của bạn đọc và chạy lại toàn bộ khi giảm giá hết hạn hoặc Z.ai phát hành phiên bản sửa đổi tiếp theo. Một lựa chọn mô hình mà bạn có thể kiểm tra lại trong ba mươi giây là một quyết định bạn có thể xem xét lại; một lựa chọn nằm trong lịch sử shell thì không.
FAQ
GLM-5.3-Flash có phải chỉ là một phiên bản GLM-5.3 nhỏ hơn không? Không. Đó là một mô hình cơ sở được huấn luyện riêng biệt với kiến trúc chú ý khác, không phải là một phiên bản tinh giản hay cắt bớt.
Chúng có cùng cửa sổ ngữ cảnh không? Có, 1.048.576 token cho cả hai.
Mô hình nào tốt hơn cho việc lập trình? Flash đạt 84.3 trên Terminal-Bench 2.1 và 63.4 trên DeepSWE theo Z.ai, đây là kết quả mạnh mẽ. GLM-5.3 thông minh hơn một chút về suy luận tổng quát. Đối với người dùng gói coding, hạn mức gấp 3 lần thường là yếu tố quyết định.
Tôi có thể chuyển đổi giữa chúng mà không cần thay đổi mã không? Có. Cùng một điểm cuối tương thích OpenAI, ID mô hình khác nhau. Chỉ có đầu vào hình ảnh là độc quyền của Flash.
Liệu phiên bản rẻ hơn có giữ được giá rẻ không? Giá phản ánh một KV cache nhỏ hơn và ít tài nguyên tính toán cho cơ chế chú ý hơn là một chương trình khuyến mãi, vì vậy lợi thế cấu trúc sẽ duy trì. Chương trình giảm giá 50% ra mắt bổ sung sẽ hết hạn vào ngày 9 tháng 9 năm 2026.