Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2, tóm gọn trong một câu: Fable 5.2 đạt điểm cao nhất, Neon có chi phí trên mỗi token thấp nhất, còn Astra hoàn thành một tác vụ benchmark độc lập với chi phí thấp nhất. Neon niêm yết ở mức $3 / $15 cho 1M token đầu vào/đầu ra, trong khi Astra và Fable đều niêm yết ở mức $8 / $40. Cả ba đều cung cấp ngữ cảnh khoảng 1M token.
Ba mô hình tiên phong ra mắt trong mười ngày: Claude Fable 5.2 vào ngày 9 tháng 11 năm 2026, GPT-6.2 Astra vào ngày 17 tháng 11 và Gemini 4 Neon vào ngày 18 tháng 11. Dưới đây là giá, thông số kỹ thuật, điểm số độc lập, chi phí mỗi tác vụ và cách kiểm thử cả ba bằng Apidog CLI.
Gemini 4 Neon vs GPT-6.2 Astra vs Claude Fable 5.2: kết luận nhanh
Hãy chọn theo khối lượng công việc, không phải theo thứ hạng trên bảng xếp hạng:
- Gemini 4 Neon cho các tác vụ lập trình và phân tích phức tạp mà bạn chạy cả ngày. Mô hình này rẻ hơn 62,5% trên mỗi token so với hai mô hình còn lại và đứng thứ hai trên Vals Index.
- GPT-6.2 Astra nếu stack của bạn gắn với OpenAI Responses API. Mô hình này sinh ra ít token hơn nhiều cho mỗi tác vụ, khiến nó trở thành lựa chọn rẻ nhất trong ba mô hình tính theo mỗi tác vụ Artificial Analysis bất chấp mức giá $8 / $40.
- Claude Fable 5.2 cho những công việc dài hơi khó nhất, nơi một lần chạy thất bại tốn kém hơn cả lượng token. Mô hình dẫn đầu cả hai chỉ số độc lập, với chi phí mỗi tác vụ cao nhất.
Nếu bạn đã theo dõi tiền lệ hồi tháng 10, bài so sánh Gemini 4 Argon vs GPT-6 Astra vs Claude Opus 5.5 của chúng tôi đề cập đến thế hệ trước.
Ba mô hình so sánh thế nào về giá và thông số kỹ thuật?
Neon là ngoại lệ về giá. Số liệu lấy từ bài ra mắt Gemini 4 Neon và trang giá của Google, trang mô hình GPT-6.2 Astra và tổng quan Claude Fable 5.2 của Anthropic.
| Thông số | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| ID mô hình API | gemini-4-neon |
gpt-6.2-astra |
claude-fable-5-2 |
| Ngày ra mắt | 18 tháng 11, 2026 | 17 tháng 11, 2026 | 9 tháng 11, 2026 |
| Đầu vào / đầu ra trên 1M | $3 / $15 | $8 / $40 | $8 / $40 |
| Đầu vào được lưu cache trên 1M | $0,15 (chỉ ngầm định) | $0,40 | $0,20 |
| Cửa sổ ngữ cảnh | 1.048.576 (dùng chung với đầu ra) | 1.050.000 (đầu vào tối đa 922.000) | 1M |
| Đầu ra tối đa mỗi yêu cầu | 65.536 | 128.000 | 128K |
| Prompt dài | Giá cố định trên toàn bộ 1M | Trên 272K đầu vào: đầu vào x2, đầu ra x1,5 | Giá cố định trên toàn bộ 1M |
| Giảm giá theo lô | 50% (Batch và Flex) | 50% | 50% |
| Điều khiển suy luận | thinking_level: từ low đến xhigh, mặc định high |
reasoning.effort, none bị từ chối |
effort, mặc định high |
| Gói API miễn phí | Không | Không | Không |
Hai chi tiết có thể thay đổi hóa đơn thực tế. Cơ chế cache của Neon là ngầm định: bạn chỉ nhận được mức $0,15 khi Google khớp được tiền tố prompt lặp lại. Và Neon trả về tối đa 65.536 token mỗi yêu cầu, nên những đầu ra rất dài cần tính năng long decode của Google hoặc một vòng lặp nối tiếp.
Để xem bảng giá đầy đủ, hãy xem các bài phân tích của chúng tôi về giá Gemini 4 Neon, giá GPT-6.2 Astra và giá Claude Fable 5.2.
Mô hình nào thắng trên các benchmark độc lập?
Các bảng benchmark của nhà cung cấp hiếm khi dùng chung bộ kiểm thử. Hai bảng xếp hạng độc lập xếp hạng cả ba mô hình trên cùng một bộ kiểm thử, và chúng không đồng nhất về vị trí thứ hai.
| Chỉ số | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Artificial Analysis Intelligence Index | 61 (xhigh) | 62 (max) | 65 (max) |
| Vals Index | 70,87%, #2 | 67,66%, #8 | 71,31%, #1 |
| Chi phí AA mỗi tác vụ của chỉ số | $6,44 | $4,00 | $26,54 |
| Thời gian AA mỗi tác vụ của chỉ số | 21,5 phút | 13,9 phút | 41,8 phút |
| Tốc độ đầu ra AA | 110 tok/s | 49 tok/s | 109 tok/s |
| Tổng token đầu ra trên toàn bộ chỉ số AA | 283M | 65,8M | 275M |
Nguồn: các trang mô hình Artificial Analysis cho từng mô hình, được kiểm tra ngày 19 tháng 11 năm 2026, và Vals Index tính đến ngày 18 tháng 11 năm 2026.
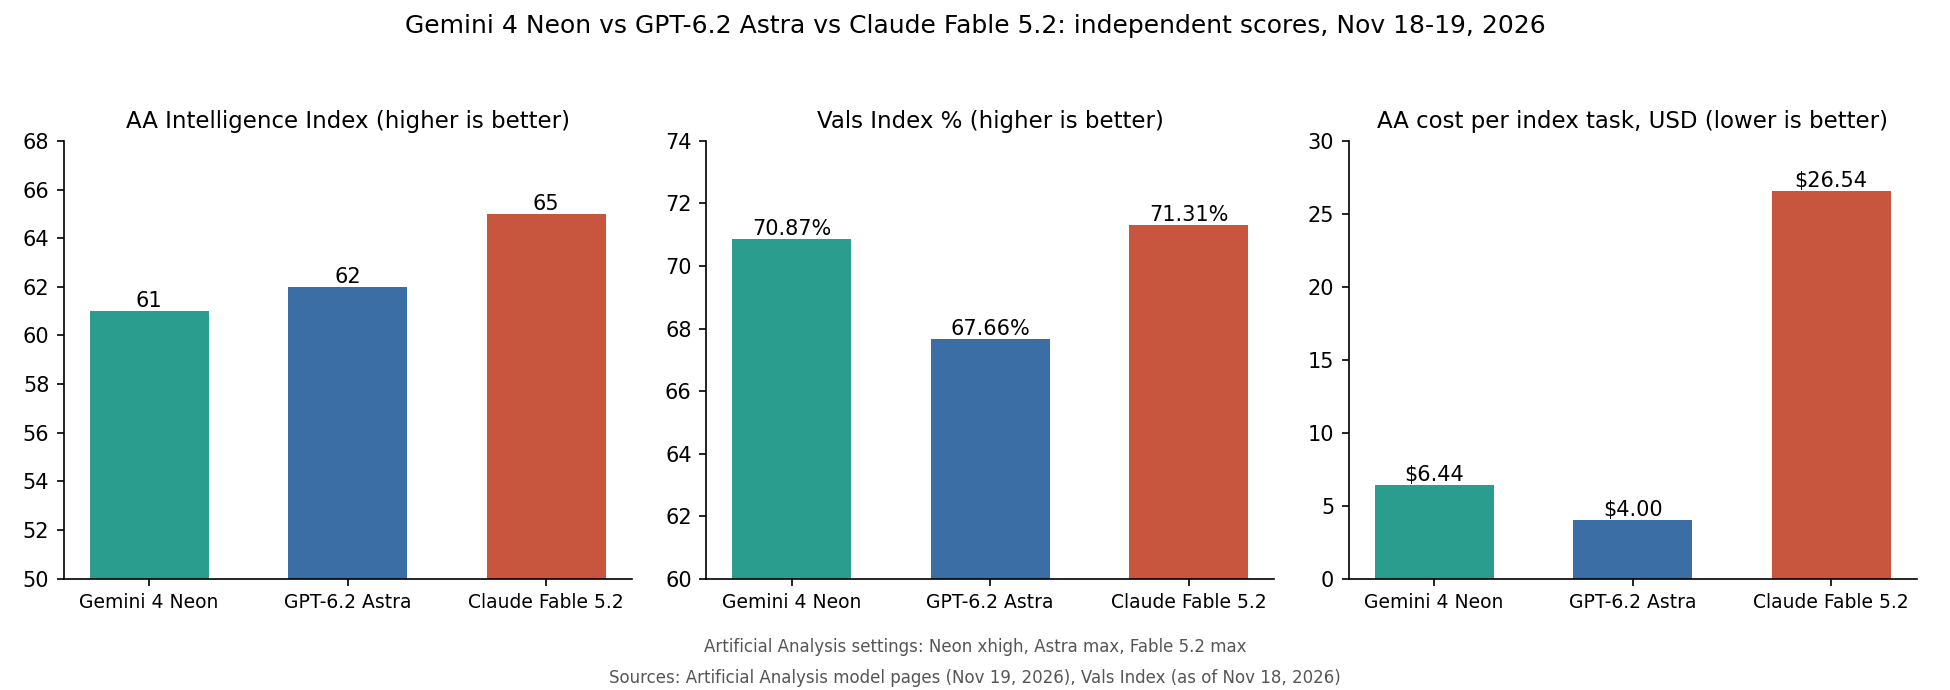
Fable 5.2 dẫn đầu cả hai bảng, và trên Vals, Neon chỉ kém nó 0,44 điểm. Artificial Analysis đặt Astra cao hơn Neon một điểm; Vals đặt Neon cao hơn Astra hơn 3 điểm.
Bài ra mắt của Google xếp Neon ở vị trí #3 trên Artificial Analysis; đến ngày 19 tháng 11, cùng trang đó liệt kê nó ở vị trí #6 trong số 96. Thứ hạng trong ngày ra mắt thay đổi rất nhanh, và khoảng cách một điểm chỉ là nhiễu. Các hàng chi phí và tốc độ cho bạn biết nhiều hơn về cảm giác của từng mô hình khi dùng trong agent của bạn.
Vì sao mô hình đắt nhất trên mỗi token lại rẻ nhất trên mỗi tác vụ?
Giá mỗi token chỉ là một nửa hóa đơn; nửa còn lại là số token mà mô hình sinh ra trước khi trả lời. Trên bộ kiểm thử Artificial Analysis, Astra sinh ra 65,8M token đầu ra. Neon sinh ra 283M và Fable 275M, nhiều hơn bốn lần. Mức giá đầu ra $40 của Astra áp dụng cho một khối lượng nhỏ hơn nhiều, nên chi phí mỗi tác vụ của nó rơi xuống $4,00, thấp hơn $6,44 của Neon, dù giá đầu ra của Neon thấp hơn 62,5%.
Cài đặt rất quan trọng. Artificial Analysis chạy Neon ở xhigh; ở high, mô hình đạt 60 điểm với 123M token đầu ra thay vì 283M, tức mất một điểm để dùng chưa bằng một nửa số token. Hướng dẫn về các mức suy luận của Gemini 4 Neon của chúng tôi trình bày toàn bộ đường cong.
Mức $26,54 của Fable kết hợp giá đầu ra cao với độ dài câu trả lời lớn: cái giá của điểm số cao nhất.
Một khối lượng công việc agent thực tế tốn bao nhiêu trên mỗi mô hình?
Hai khối lượng công việc tính theo giá niêm yết, giả định số token giống hệt nhau trên mỗi mô hình (thực tế sẽ không giống, nên hãy coi đây là so sánh giá, không phải dự báo).
| Khối lượng công việc | Gemini 4 Neon | GPT-6.2 Astra | Claude Fable 5.2 |
|---|---|---|---|
| Phiên agent: 150K đầu vào mới, 1,35M lượt đọc cache, 150K đầu ra | $0,45 + $0,20 + $2,25 = $2,90 | $1,50 + $0,54 + $6,00 = $8,04 | $1,50 + $0,27 + $6,00 = $7,77 |
| Một yêu cầu dài: 400K đầu vào, 8K đầu ra, không cache | $1,20 + $0,12 = $1,32 | $6,40 + $0,48 = $6,88 | $3,20 + $0,32 = $3,52 |
Astra và Fable tính 150K đầu tiên như một khoản ghi cache $10 mỗi 1M; Neon không có phí ghi. Yêu cầu dài cho thấy quy tắc 272K của Astra: vượt qua ngưỡng đó, OpenAI tính $16 đầu vào và $60 đầu ra mỗi 1M cho toàn bộ yêu cầu.
Nếu Neon sinh ra số token nhiều gấp 3 lần Astra trên prompt của bạn, phiên $2,90 của nó có thể tốn hơn phiên của Astra. Hãy đo số token đầu ra trước khi chọn theo giá.
Những khác biệt API nào sẽ làm hỏng harness agent của bạn?
Mỗi API từ chối những cài đặt mà các API khác chấp nhận:
- Gemini 4 Neon: tham số
thinking_budgetcũ trả về HTTP 400, tương tự vớifrequency_penaltyvàpresence_penalty. Các giá trịtemperature,top_kvàtop_ptùy chỉnh bị bỏ qua, theo hướng dẫn dành cho nhà phát triển Google Cloud. - GPT-6.2 Astra:
reasoning.effortđược đặt thànhnonesẽ trả về lỗi 400, và trang mô hình liệt kê Realtime, Assistants và fine-tuning là không được hỗ trợ. - Claude Fable 5.2: ép buộc dùng công cụ (
tool_choicelàanyhoặctool) và các tham số lấy mẫu nhưtemperaturetrả về lỗi 400, và không thể tắt tính năng suy luận.
Hướng dẫn GPT-6.2 Astra vs Claude Fable 5.2 của chúng tôi trình bày chi tiết những điểm khác thường của Astra và Fable, còn hướng dẫn API Gemini 4 Neon đề cập đến định dạng yêu cầu của Neon.
Mỗi mô hình phù hợp nhất ở đâu?
Gemini 4 Neon được xây dựng cho công việc phức tạp, diễn ra thường xuyên. Google cho biết mô hình này cắt giảm việc đọc tệp dư thừa và có thể lập kế hoạch trong khi các subagent Gemini 4 Hydrogen rẻ hơn thực hiện các bước; trong Google Antigravity, /swarm chạy các agent song song.
GPT-6.2 Astra mang đến bộ công cụ OpenAI: apply_patch, shell được host, computer use, MCP và bản beta multi-agent trong Responses API. Đây là mô hình nhanh nhất trong ba mô hình trên Artificial Analysis, với 13,9 phút mỗi tác vụ. Simon Willison đã lưu ý trong ngày ra mắt rằng mô hình này đạt điểm thấp hơn Fable 5.2 một chút trên một số benchmark.
Claude Fable 5.2 là lựa chọn khi chất lượng quan trọng hơn chi phí: các phiên agent dài, refactor khó, tác vụ nghiên cứu. Mức đọc cache $0,20 và giá 1M cố định của mô hình giúp giảm bớt tác động của mức giá đầu ra $40.
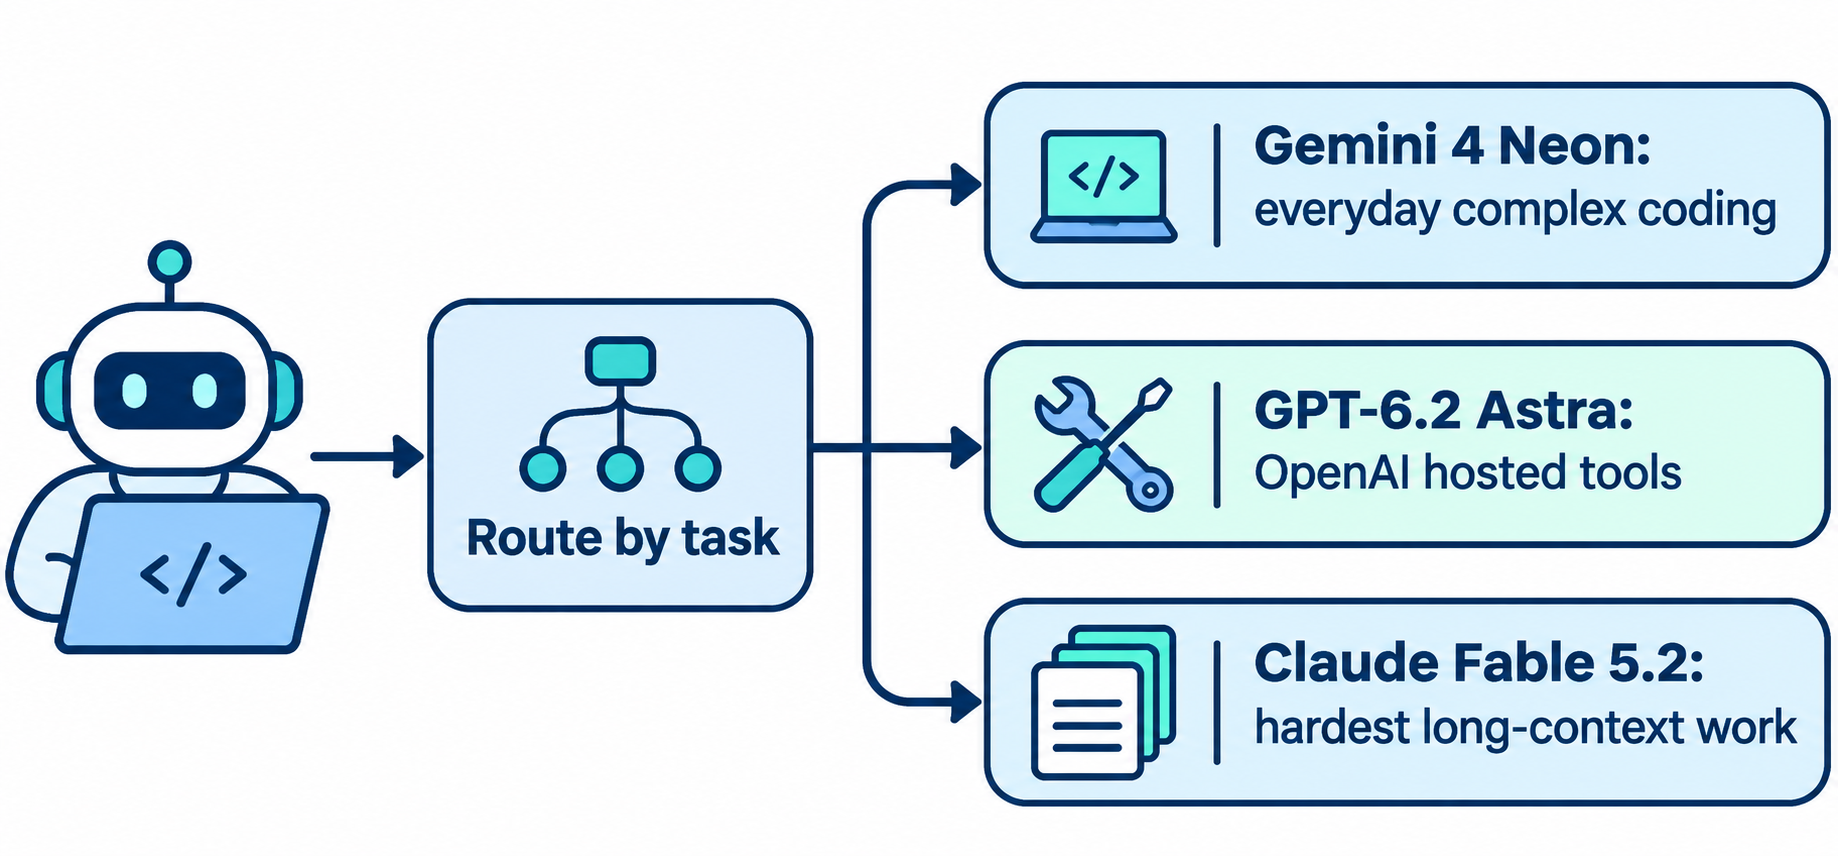
Bạn không nhất thiết phải chọn một mô hình. Hãy gửi phần lớn các bước của agent đến Neon và số ít tác vụ thất bại ở đó đến Fable hoặc Astra; chi phí trung bình của bạn sẽ vẫn gần với mức của Neon.
Làm thế nào để kiểm thử cả ba mô hình trên khối lượng công việc của riêng bạn?
Các bảng xếp hạng đo lường tác vụ của người khác. Hãy gửi 5 đến 10 prompt thực tế từ lịch sử agent của bạn đến cả ba API, rồi so sánh tỷ lệ vượt qua, số token và độ trễ. Việc chạy thủ công các yêu cầu đó sẽ nhanh chóng trở nên mệt mỏi, vậy hãy để Claude Code, Codex hoặc Cursor điều khiển Apidog CLI. Việc thiết lập gồm ba lệnh:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho agent của bạn một prompt:
In Apidog project <PROJECT_ID>, create three test cases that send the
same code-review prompt to gemini-4-neon (Gemini Interactions API,
thinking_level high), gpt-6.2-astra (OpenAI Responses API, effort high)
and claude-fable-5-2 (Claude Messages API, no temperature field).
Keep each API key in a private environment variable. Assert a 200
status and a non-empty answer, record token usage and response time,
run each case 5 times and summarize cost per run at list prices.
Validate every payload against its schema before you write it.
Agent kiểm tra schema của từng payload, viết các test case và chạy chúng. Các flag này đến từ apidog run --help trên CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file neon-case.json
apidog test-case create --project <PROJECT_ID> --file astra-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <NEON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir abc-results
Lặp lại lệnh cuối cùng với ID test case của Astra và Fable. -n 5 chạy mỗi test case năm lần, và --upload-report hiển thị các lần chạy trong ứng dụng Apidog. Đây là một mẫu quy trình làm việc; chúng tôi chưa chạy nó với cả ba API từ máy này.
Hãy thêm các test case âm cho các lỗi 400 ở trên, để nếu nhà cung cấp thay đổi quy tắc thì bộ kiểm thử của bạn sẽ phát hiện trước. Hướng dẫn dùng Apidog CLI trong Claude Code đề cập đến việc thiết lập agent, và gói Free của Apidog hỗ trợ tối đa 4 người dùng.
Câu hỏi thường gặp
Gemini 4 Neon có tốt hơn GPT-6.2 Astra không? Còn tùy vào bảng xếp hạng: Neon dẫn đầu trên Vals Index (70,87% so với 67,66%), Astra dẫn trước một điểm trên Artificial Analysis Intelligence Index (62 so với 61). Neon có giá $3 / $15 mỗi 1M token, so với $8 / $40 của Astra.
Mô hình nào trong ba mô hình rẻ nhất? Tính theo token, Gemini 4 Neon với $3 đầu vào và $15 đầu ra mỗi 1M. Tính theo mỗi tác vụ Artificial Analysis, GPT-6.2 Astra với $4,00, vì mô hình này sinh ra ít token hơn nhiều so với Neon ($6,44) hoặc Fable 5.2 ($26,54).
Mô hình nào đạt điểm cao nhất? Tính đến ngày 18-19 tháng 11 năm 2026, Claude Fable 5.2 dẫn đầu cả Artificial Analysis Intelligence Index (65) và Vals Index (71,31%).
Có mô hình nào có gói API miễn phí không? Không. Google không liệt kê gói miễn phí nào cho Neon, còn Astra và Fable 5.2 là các mô hình API trả phí. Người đăng ký Google AI Pro và Ultra có thể dùng Neon trong ứng dụng Gemini và Antigravity. Xem hướng dẫn dùng miễn phí Gemini 4 Neon của chúng tôi để biết các lựa chọn $0.
Tôi có thể dùng nhiều hơn một mô hình trong cùng một agent không? Có. Hãy định tuyến các bước thường lệ đến Neon và các tác vụ mà nó thất bại đến Fable 5.2 hoặc Astra. Hãy kiểm thử từng tuyến trước: số token mỗi tác vụ giữa các mô hình có thể khác nhau hơn 4 lần.