
Các mức thinking của Gemini 4 Neon cung cấp bốn thiết lập cho mức độ model suy luận trước khi trả lời: low, medium, high và xhigh. Neon mặc định ở mức high. Google khuyến nghị giữ high cho hầu hết công việc phức tạp và chỉ chuyển sang xhigh khi high không đáp ứng được với các bài toán khó, nhiều bước, vì xhigh tốn nhiều token hơn và mất nhiều thời gian hơn.
Các mức thinking của Gemini 4 Neon là gì?
Thinking level là các giá trị của tham số thinking_level, quy định lượng suy luận nội bộ mà gemini-4-neon thực hiện trước khi viết câu trả lời. Neon hỗ trợ bốn mức: low, medium, high (mặc định) và xhigh. Mức cao hơn dùng nhiều thought token hơn và tăng độ trễ; mức thấp hơn trả lời nhanh hơn và tốn ít chi phí hơn.
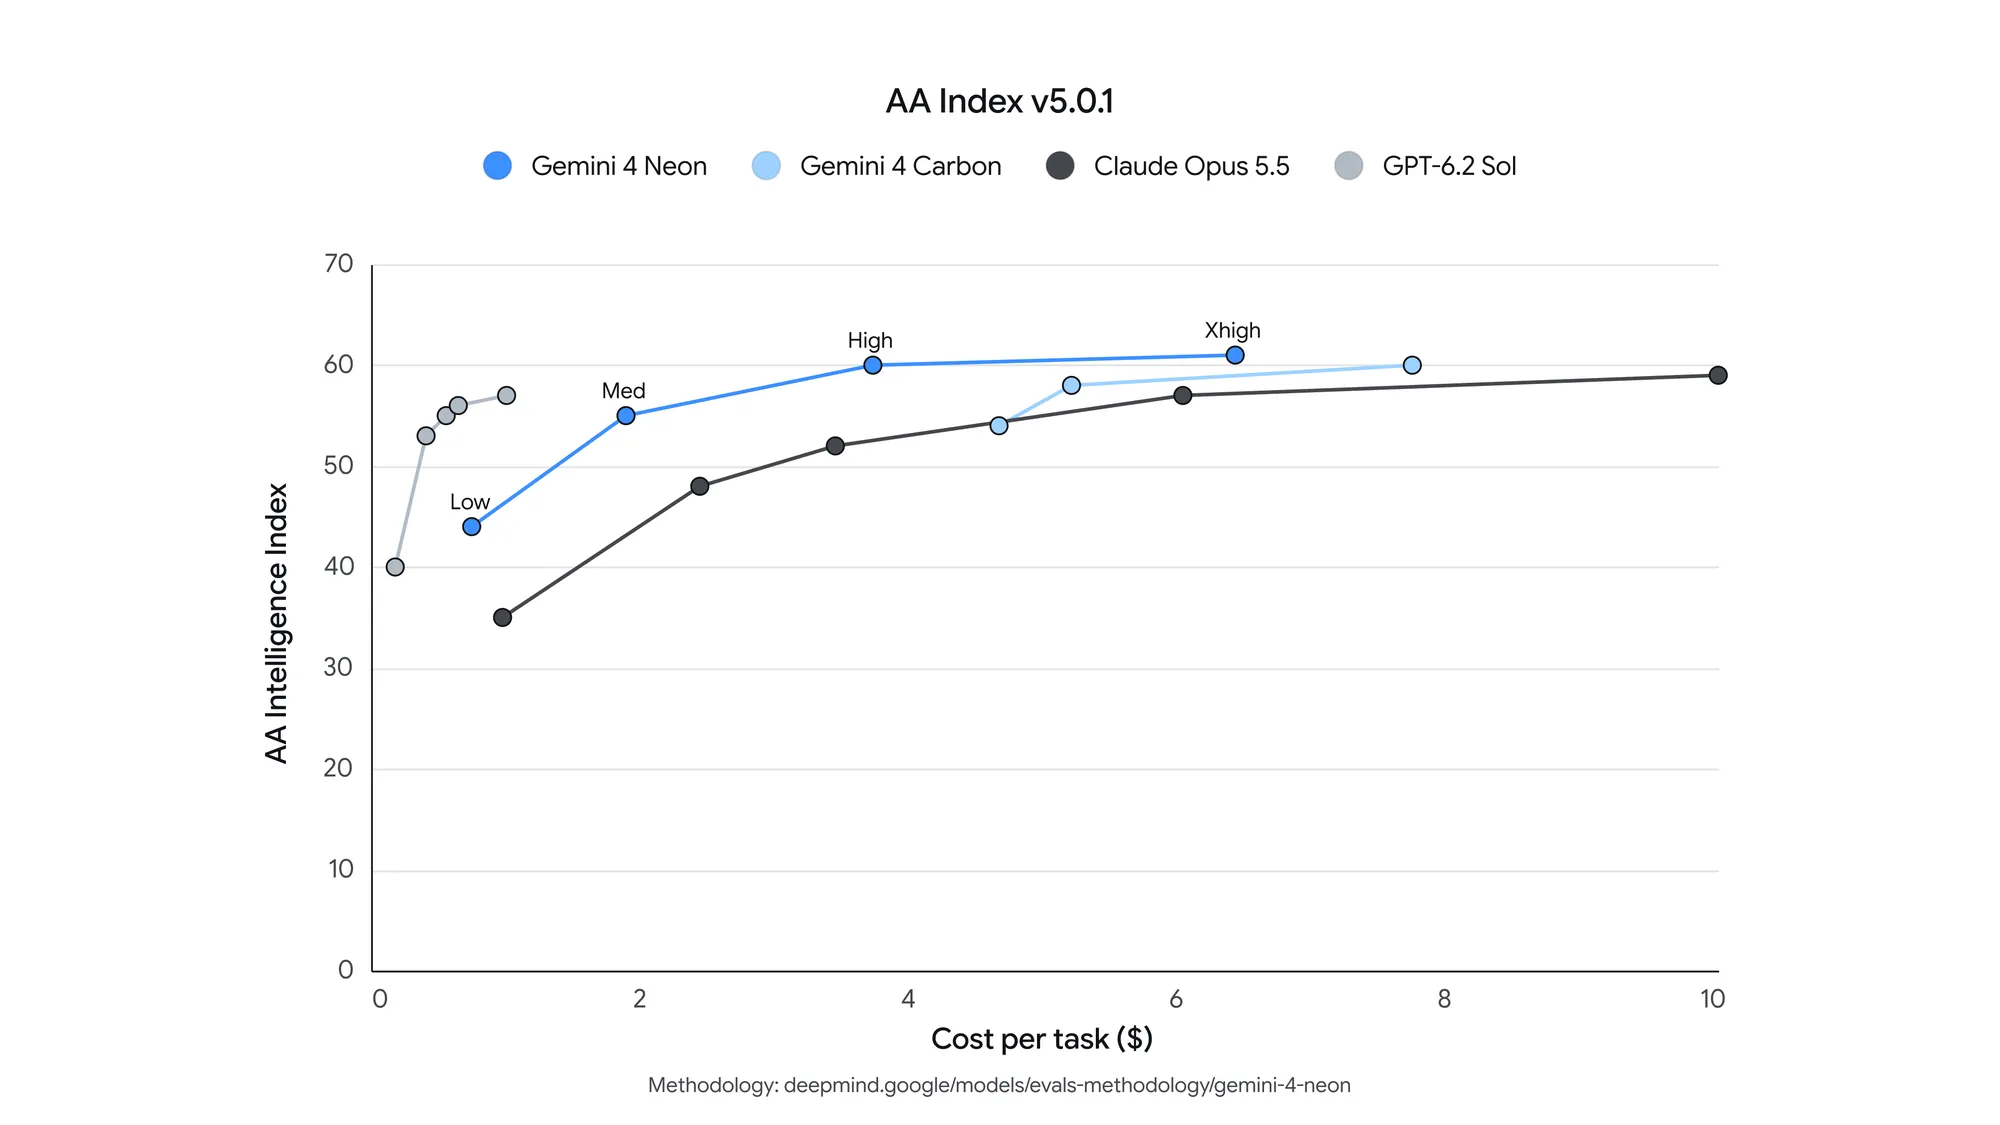
Dưới đây là cách hướng dẫn thinking của Google mô tả từng mức cho Neon:
thinking_level |
Mức sử dụng token | Trường hợp Google khuyến nghị |
|---|---|---|
low |
Ít token nhất, độ trễ thấp nhất | Chat nhanh, xử lý thông lượng cao; vẫn đủ khả năng cho các tác vụ agentic |
medium |
Dùng ít token hơn, phản hồi nhanh hơn | Lập trình tương tác, prototype UI trực tiếp, gọi tool nhạy cảm với độ trễ |
high (mặc định) |
Cân bằng giữa trí tuệ và tốc độ | Lập trình phức tạp, thực thi agentic, gọi tool, công việc tri thức đa phương thức |
xhigh |
Nhiều token nhất, suy luận sâu nhất | Các bài toán kỹ thuật nhiều bước khó, bài toán phân tích và khoa học mà high không đáp ứng được |
Có hai giá trị mà bạn có thể mong đợi nhưng lại không xuất hiện. Neon từ chối minimal và trả về lỗi, nên code sao chép từ ứng dụng Gemini 3 Flash sẽ hỏng nếu gửi giá trị đó. Còn số lượng token thinkingBudget cũ đã bị deprecated trên Gemini 4: nếu gửi riêng, nó được ánh xạ sang mức gần nhất kèm cảnh báo; nếu gửi cùng với thinkingLevel, nó trả về lỗi 400.
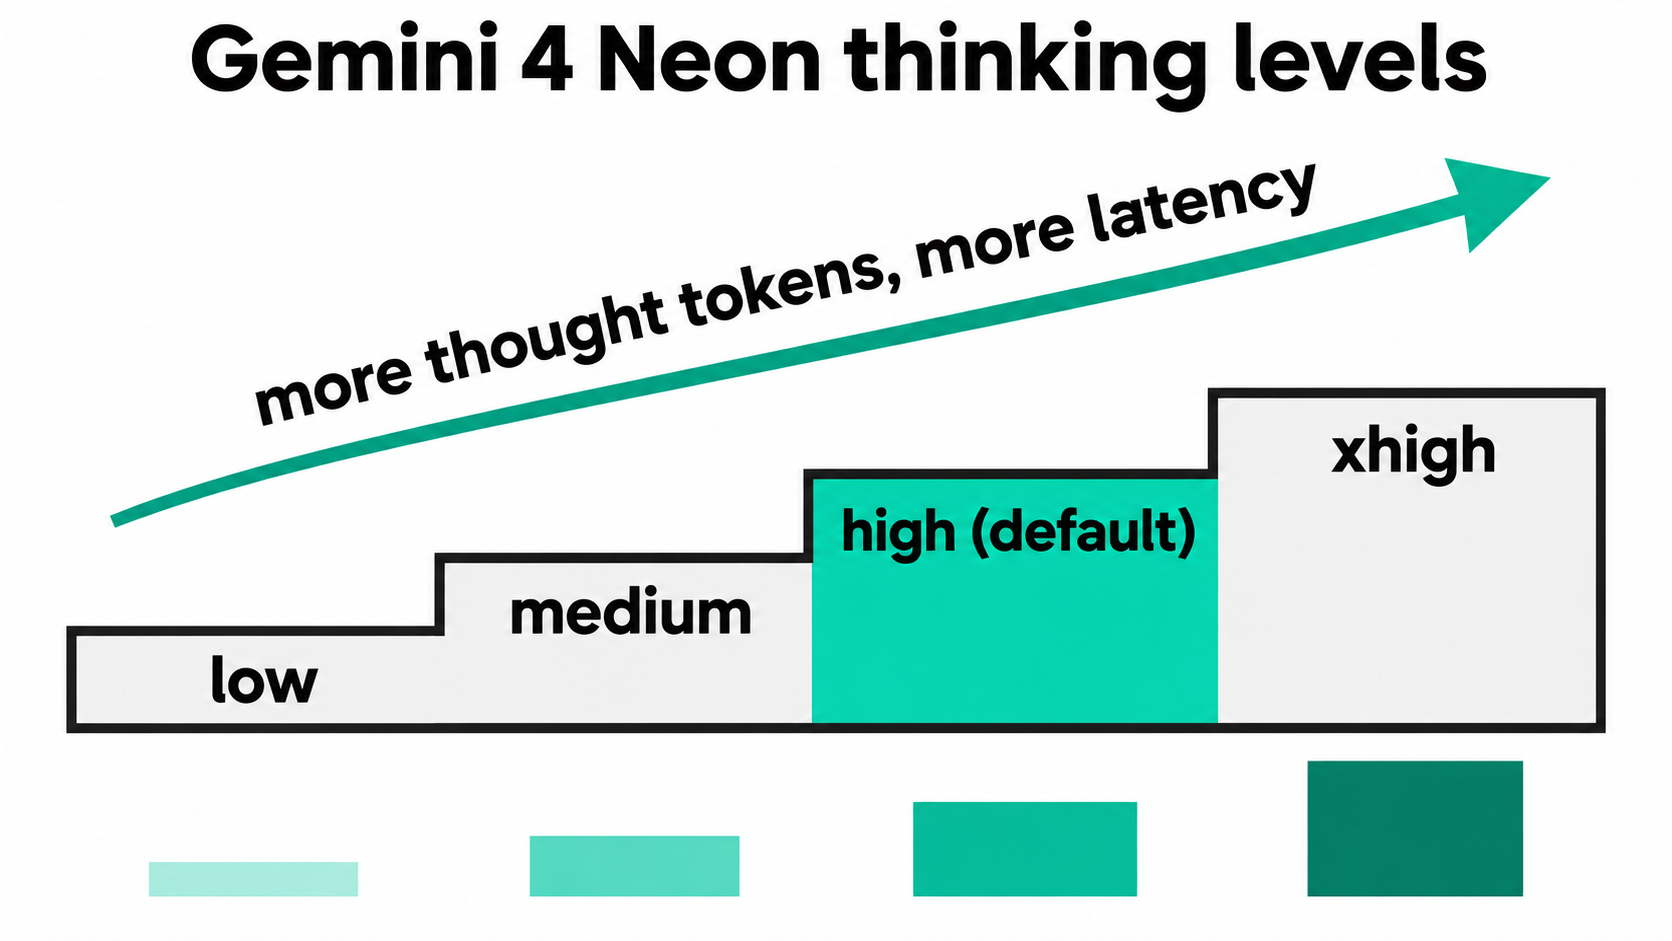
Mức mặc định của Neon so với các model Gemini 4 khác thế nào?
Neon khởi điểm cao hơn một bậc so với các model anh em lớn hơn. Theo ghi chú phát hành Gemini 4 Neon, Neon và Hydrogen mặc định ở high và hỗ trợ xhigh, trong khi Carbon và Argon mặc định ở medium và tối đa là high.
| Model | Mức mặc định | Các mức hỗ trợ |
|---|---|---|
gemini-4-neon |
high |
low, medium, high, xhigh |
gemini-4-hydrogen |
high |
low, medium, high, xhigh |
gemini-4-carbon |
medium |
low, medium, high |
gemini-4-argon |
medium |
low, medium, high |
Điều này quan trọng khi bạn chuyển đổi giữa các model. Chuyển một workload từ Carbon sang Neon mà không đặt thinking_level thì mọi request sẽ nhảy từ mức suy luận medium lên high, làm thay đổi số token của bạn. Nếu bạn đang cân nhắc các model lớn hơn, bài so sánh Gemini 4 Carbon vs Argon của chúng tôi có phân tích sự khác biệt đó.
Cách đặt thinking_level trong Gemini API?
Neon chạy trên gói trả phí của cả Interactions API và generateContent. Tên trường khác nhau giữa hai API này.
Interactions API: đặt thinking_level bên trong generation_config.
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "model": "gemini-4-neon",
    "input": "Audit this payment retry queue for race conditions.",
    "generation_config": {
      "thinking_level": "xhigh",
      "max_output_tokens": 65536
    }
  }'
generateContent: dùng thinkingLevel bên trong generationConfig.thinkingConfig.
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H 'Content-Type: application/json' \
  -X POST \
  -d '{
    "contents": [{"parts": [{"text": "Audit this payment retry queue for race conditions."}]}],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "medium"}
    }
  }'
Trong Python SDK, lệnh gọi Interactions nhận generation_config={"thinking_level": "high"}, còn lệnh gọi generateContent nhận thinking_config=types.ThinkingConfig(thinking_level="low"). Hãy bỏ qua temperature, top_p và top_k: Google cho biết Neon bỏ qua các giá trị nằm trong khoảng hợp lệ và từ chối các giá trị ngoài khoảng với lỗi 400. Để xem hướng dẫn đầy đủ cho request đầu tiên trên cùng thiết kế API, hãy đọc hướng dẫn Gemini 4 Hydrogen API của chúng tôi.
Khi nào nên dùng high và khi nào dùng xhigh?
Mặc định hãy dùng high và chỉ nâng một tác vụ lên xhigh sau khi high không đạt chuẩn chất lượng của bạn với tác vụ đó. Bài đăng ra mắt của Google mô tả xhigh là “suy luận sâu hơn, nhiều bước hơn cho những workload kỹ thuật, phân tích và khoa học khó nhất”.
Chọn xhigh khi:
- Tác vụ có nhiều bước phụ thuộc lẫn nhau và một sai sót sớm sẽ làm hỏng kết quả, chẳng hạn refactor nhiều file hoặc audit tính đồng thời.
highđưa ra câu trả lời tự tin nhưng sai trên bộ đánh giá của bạn, chứ không chỉ chậm hơn.- Độ trễ không quan trọng lắm, như với job chạy nền, review hàng đêm hoặc phân tích theo lô.
- Một câu trả lời sai tốn kém hơn token, như trong vá bảo mật hoặc tính toán tài chính.
Giữ ở high (hoặc hạ xuống thấp hơn) khi:
- Prompt chỉ là trích xuất hoặc định dạng. Google cảnh báo rằng
xhigh“có thể gây suy nghĩ quá mức hoặc làm cạnmax_output_tokensvới những prompt đơn giản như trích xuất văn bản hoặc JSON”. - Người dùng đang chờ. Chat, autocomplete và gọi tool trực tiếp phù hợp với
mediumhoặclow. - Bạn chạy khối lượng lớn. Mỗi thought token thêm vào đều bị tính phí, và mức chênh lệch nhân lên theo số request.
Các con số benchmark của Google củng cố cho sự phân chia này. Trong thông báo ra mắt, Neon ở mức xhigh đạt 61 điểm trên Artificial Analysis Intelligence Index, xếp thứ ba. Ở mức mặc định high, Google báo cáo chi phí mỗi tác vụ thấp hơn 32% so với Carbon. Đây là các con số của Google, không phải kết quả thử nghiệm của chúng tôi, nhưng chúng cho thấy sự đánh đổi: xhigh mang lại điểm số cao nhất của Neon, còn high mang lại hiệu quả.
Mỗi mức thinking tốn bao nhiêu chi phí?
Mỗi mức có cùng đơn giá trên mỗi token; điều thay đổi là số token bạn phải trả. Neon có giá 3,00 USD trên 1 triệu input token và 15,00 USD trên 1 triệu output token, và trang giá của Google nêu rõ đơn giá output đã bao gồm thinking token. Input được cache giảm còn 0,15 USD trên 1 triệu nhờ implicit caching (Neon không hỗ trợ explicit caching). Model này không có gói miễn phí.
Vậy chi phí của một mức chính là số thought token mà nó thêm vào, nhân với 15 USD mỗi triệu token. Dưới đây là phép tính cho một request với 2.000 input token và câu trả lời hiển thị 800 token. Số thought token là giả định, được chọn để minh họa phép tính, không phải số đo thực tế:
| Thought token (giả định) | Chi phí input | Chi phí output + thinking | Tổng mỗi request | Mỗi 10.000 request |
|---|---|---|---|---|
| 500 | $0.006 | $0.0195 | $0.0255 | $255 |
| 2.000 | $0.006 | $0.042 | $0.048 | $480 |
| 8.000 | $0.006 | $0.132 | $0.138 | $1.380 |
Thinking nhanh chóng chiếm phần lớn hóa đơn. Với 8.000 thought token, phần suy luận chiếm 87% chi phí của request. Đó là lý do chính Google khuyên bạn chạy đánh giá ở cả bốn mức và “chọn thinking_level thấp nhất đáp ứng chuẩn chất lượng của bạn”. Hướng dẫn thinking levels của Gemini 3.8 Flash của chúng tôi cũng phân tích sự đánh đổi tương tự trên một model rẻ hơn nếu bạn muốn so sánh.
Cách đo token và độ trễ ở từng mức?
Chạy cùng một prompt ở mỗi mức và đọc khối usage. Trong Interactions API, đối tượng usage của phản hồi báo cáo riêng total_input_tokens, total_output_tokens và total_thought_tokens. Trong generateContent, thought token xuất hiện dưới dạng usageMetadata.thoughtsTokenCount.
Vòng lặp sau gửi một prompt ở cả bốn mức và in ra thought token cùng thời gian thực tế:
for level in low medium high xhigh; do
  start=$(date +%s)
  usage=$(curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
    -H "x-goog-api-key: $GEMINI_API_KEY" \
    -H 'Content-Type: application/json' \
    -d "{\"model\":\"gemini-4-neon\",
         \"input\":\"Find the race condition in this retry loop: ...\",
         \"generation_config\":{\"thinking_level\":\"$level\",\"max_output_tokens\":65536}}" \
    | jq -c '{status, thought: .usage.total_thought_tokens, out: .usage.total_output_tokens}')
  echo "$level $(( $(date +%s) - start ))s $usage"
done
Hãy chạy nó trên 10 đến 20 prompt từ workflow thực tế của bạn. Một prompt không nói lên nhiều; cả một bộ mới cho thấy high và xhigh bắt đầu khác nhau về chất lượng ở đâu.
Hãy đặt timeout của HTTP client cao hơn trong lúc thử nghiệm. Ghi chú migration của Google cho biết các prompt khó có thể mất vài phút và đề xuất timeout ít nhất 15 phút, hoặc dùng chế độ chạy nền.
Tại sao xhigh đôi khi trả về câu trả lời rỗng?
max_output_tokens giới hạn chung cả thinking và output hiển thị. Nếu Neon dùng hết ngân sách cho việc suy luận, tương tác sẽ dừng với trạng thái incomplete và trả về câu trả lời bị cắt ngắn hoặc rỗng, mà bạn vẫn phải trả tiền cho các thought token đã sinh ra.
Ba quy tắc từ tài liệu Google giúp tránh điều này:
- Bỏ các giới hạn thấp cũ. Nếu ứng dụng của bạn hardcode một giá trị như 8.192, hãy nâng lên 65.536, mức giới hạn đồng bộ mặc định.
- Hạ mức, đừng hạ giới hạn. Để giảm chi phí hoặc độ trễ, hãy chuyển xuống
mediumhoặclowthay vì giảmmax_output_tokens. - Chuyển sang chạy nền với công việc dài. Với câu trả lời vượt 65.536 token, đặt
backgroundthànhtruevàmax_output_tokenslên tới 1.048.576 trừ đi input của bạn. Input, thinking và output dùng chung một cửa sổ 1 triệu token. Hướng dẫn long-output của Gemini 4 Argon của chúng tôi sẽ trình bày mẫu polling.
Để coding agent của bạn benchmark cả bốn mức với Apidog CLI
Chạy lại vòng lặp đó bằng tay sẽ rất mệt. Thay vào đó, hãy để coding agent của bạn (Claude Code, Codex, Cursor) xây dựng một bài test tái sử dụng với Apidog CLI và chạy lại ở từng mức mỗi khi bạn muốn có số liệu mới.
Thiết lập một lần:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho agent một prompt:
In Apidog project <projectId>, create an environment "gemini" with base URL
https://generativelanguage.googleapis.com and variables GEMINI_API_KEY and
THINKING. Add an endpoint for POST /v1beta/interactions that sends the
x-goog-api-key header from GEMINI_API_KEY. Create a test case that sends model
"gemini-4-neon", my audit prompt, generation_config.thinking_level {{THINKING}}
and max_output_tokens 65536, and asserts: HTTP 200, status is "completed",
and usage.total_thought_tokens exists. Run it once per level (low, medium,
high, xhigh) and give me a table of thought tokens and response time.
Agent sẽ đọc schema của từng payload, kiểm tra tính hợp lệ của JSON, tạo các resource và lặp vòng chạy:
apidog environment create gemini --project <projectId> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
for level in low medium high xhigh; do
  apidog run --test-case <caseId> --project <projectId> -e <envId> \
    --env-var "THINKING=$level" -r cli,json --out-file "neon-$level"
done
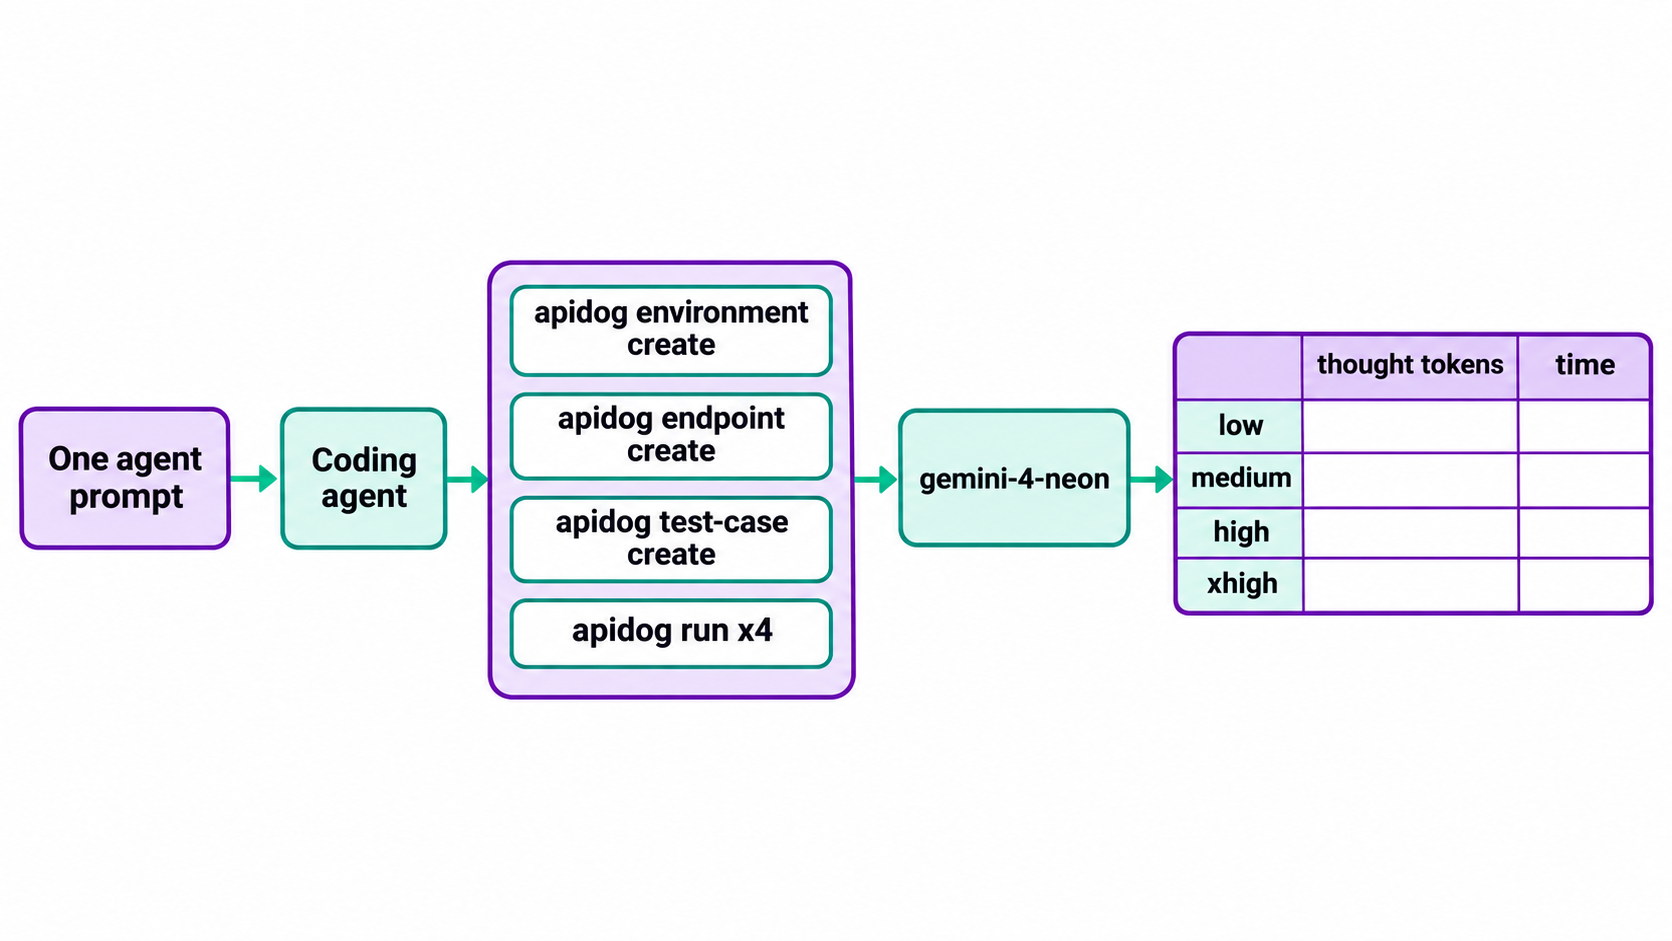
Assertion status is "completed" sẽ bắt được cái bẫy incomplete ở phần trước, nên một mức bị hết ngân sách sẽ báo lỗi rõ ràng thay vì trả về chuỗi rỗng. Đổi -r cli,json thành -r junit là cùng một lượt chạy có thể đưa vào CI; hướng dẫn Apidog CLI CI/CD trình bày pipeline, còn Apidog CLI trong Claude Code đề cập đến việc thiết lập agent. Gói Free của Apidog hỗ trợ tối đa 4 người dùng.
FAQ
Mức thinking mặc định của Gemini 4 Neon là gì? high. Bạn không cần gửi thinking_level để có được mức này. Carbon và Argon mặc định ở medium, nên hãy đặt mức một cách tường minh khi chuyển từ chúng sang.
Gemini 4 Neon có hỗ trợ minimal thinking không? Không. Neon hỗ trợ low, medium, high và xhigh, và từ chối minimal bằng một lỗi. Dùng low để có phản hồi nhanh nhất và rẻ nhất.
Thinking token có bị tính phí trên Gemini 4 Neon không? Có. Thought token được tính theo đơn giá output 15,00 USD trên 1 triệu token. Google tính mọi token mà model xử lý, bao gồm cả thinking token.
Tôi có thể vẫn dùng thinkingBudget với Gemini 4 Neon không? Nó đã bị deprecated trên các model Gemini 4. Nếu gửi riêng, nó được ánh xạ sang thinkingLevel gần nhất và trả về cảnh báo. Nếu gửi cùng thinkingLevel, request sẽ thất bại với lỗi 400.
xhigh có luôn chính xác hơn high không? Không phải lúc nào. Google cho biết xhigh có thể suy nghĩ quá mức với các prompt đơn giản như trích xuất văn bản hoặc JSON và có thể làm cạn max_output_tokens. Hãy thử cả hai trên prompt của riêng bạn và giữ mức thấp nhất vượt qua được.
Tôi có thể dùng các mức thinking của Gemini 4 Neon miễn phí không? Không. Gemini 4 Neon không có sẵn trên gói miễn phí của Gemini API. Trong Google AI Studio và Google Antigravity, nó gắn với các gói trả phí Google AI Pro và Ultra.