
Context caching của Gemini 4 Neon chỉ ở dạng ẩn (implicit). Bạn không cần tạo cache. Google tự động cache các phần đầu prompt lặp lại có độ dài tối thiểu 4.096 token và tính tiền các input token đã cache với giá $0,15 mỗi 1M thay vì $3 — giảm 95%. Bạn hưởng lợi ích này bằng cách giữ phần ổn định của mọi request ở đầu prompt và giống hệt từng byte, sau đó xác nhận các lần trúng cache qua usage.total_cached_tokens.
Nội dung bên dưới: cách bố trí prompt để trúng cache, quy tắc vòng lặp agent, cách đọc số token đã cache, và một bài test mà coding agent của bạn chạy giúp bạn.
Context caching của Gemini 4 Neon hoạt động thế nào?
Context caching của Gemini 4 Neon là prefix caching tự động. Khi một request mới bắt đầu bằng cùng các token như một request gần đây, và phần prefix chung đó có độ dài ít nhất 4.096 token, Google sẽ phục vụ phần lặp lại từ cache và tính tiền theo giá đã cache. Không cần bật gì cả, và không có đối tượng cache, TTL hay phí lưu trữ nào phải quản lý.
Google phát hành Neon vào ngày 18/11/2026 (model ID gemini-4-neon, xem bài ra mắt). Các thông tin về caching gói gọn trong một bảng:
| Hạng mục | Gemini 4 Neon |
|---|---|
| Chế độ caching | Chỉ ẩn (implicit), bật sẵn theo mặc định |
Caching tường minh (cachedContents, caches.create) |
Không được hỗ trợ |
| Prefix tối thiểu để trúng cache | 4.096 token |
| Input tiêu chuẩn | $3,00 mỗi 1M token |
| Input đã cache (Standard) | $0,15 mỗi 1M token |
| Input đã cache (Batch và Flex) | $0,075 mỗi 1M token |
| Input đã cache (Priority) | $0,27 mỗi 1M token |
| Nơi xem các lần trúng cache | usage.total_cached_tokens |
| Gói miễn phí | Không, chỉ gói trả phí |
Mức giảm giá là 95% trên mọi cấp bậc: $0,15 bằng 5% của $3, $0,075 bằng 5% của $1,50, và $0,27 bằng 5% của $5,40. Output token, bao gồm cả thinking token, vẫn giữ giá $15 mỗi 1M trên gói Standard. Caching chỉ ảnh hưởng đến input.
Caching ẩn và caching tường minh trên Gemini 4 Neon
Nếu bạn từng dùng caching tường minh trên Gemini 2.5 hoặc 3, đây chính là thay đổi làm hỏng code của bạn. Ghi chú di chuyển sang Neon của Google nói rõ: Gemini 4 Neon "không hỗ trợ caching tường minh (cachedContents và caches.create)", và bạn nên "xóa các trường cached_content khỏi request."
Tài liệu về caching bổ sung rằng Interactions API chỉ hỗ trợ caching ẩn, và caching tường minh không khả dụng cho bất kỳ model Gemini 4 nào. Cache tường minh vẫn hoạt động trên các model Gemini 3 và 2.5 được hỗ trợ thông qua generateContent.
Điều này có ý nghĩa gì khi di chuyển:
- Xóa code gọi
caches.createvà lưu tên cache. - Xóa
cached_contentkhỏi mọi request body. - Ngừng trả tiền cho phần lưu trữ cache không còn dùng.
- Tái cấu trúc prompt để nội dung bạn từng cache tường minh nằm ngay đầu mỗi request.
Bạn không thể ghim một tài liệu hay chọn TTL, và việc trúng cache không được đảm bảo. Nhưng bạn có thể tăng khả năng trúng lên đáng kể.
Cách bố trí prompt để trúng cache của Gemini 4 Neon?
Để trúng cache cần một prefix dài, giống hệt nhau và được gửi lại trong thời gian ngắn. Tài liệu của Google đưa ra hai mẹo: đặt nội dung lớn và dùng chung ở đầu prompt, và gửi các request có prefix tương tự trong khoảng thời gian ngắn.
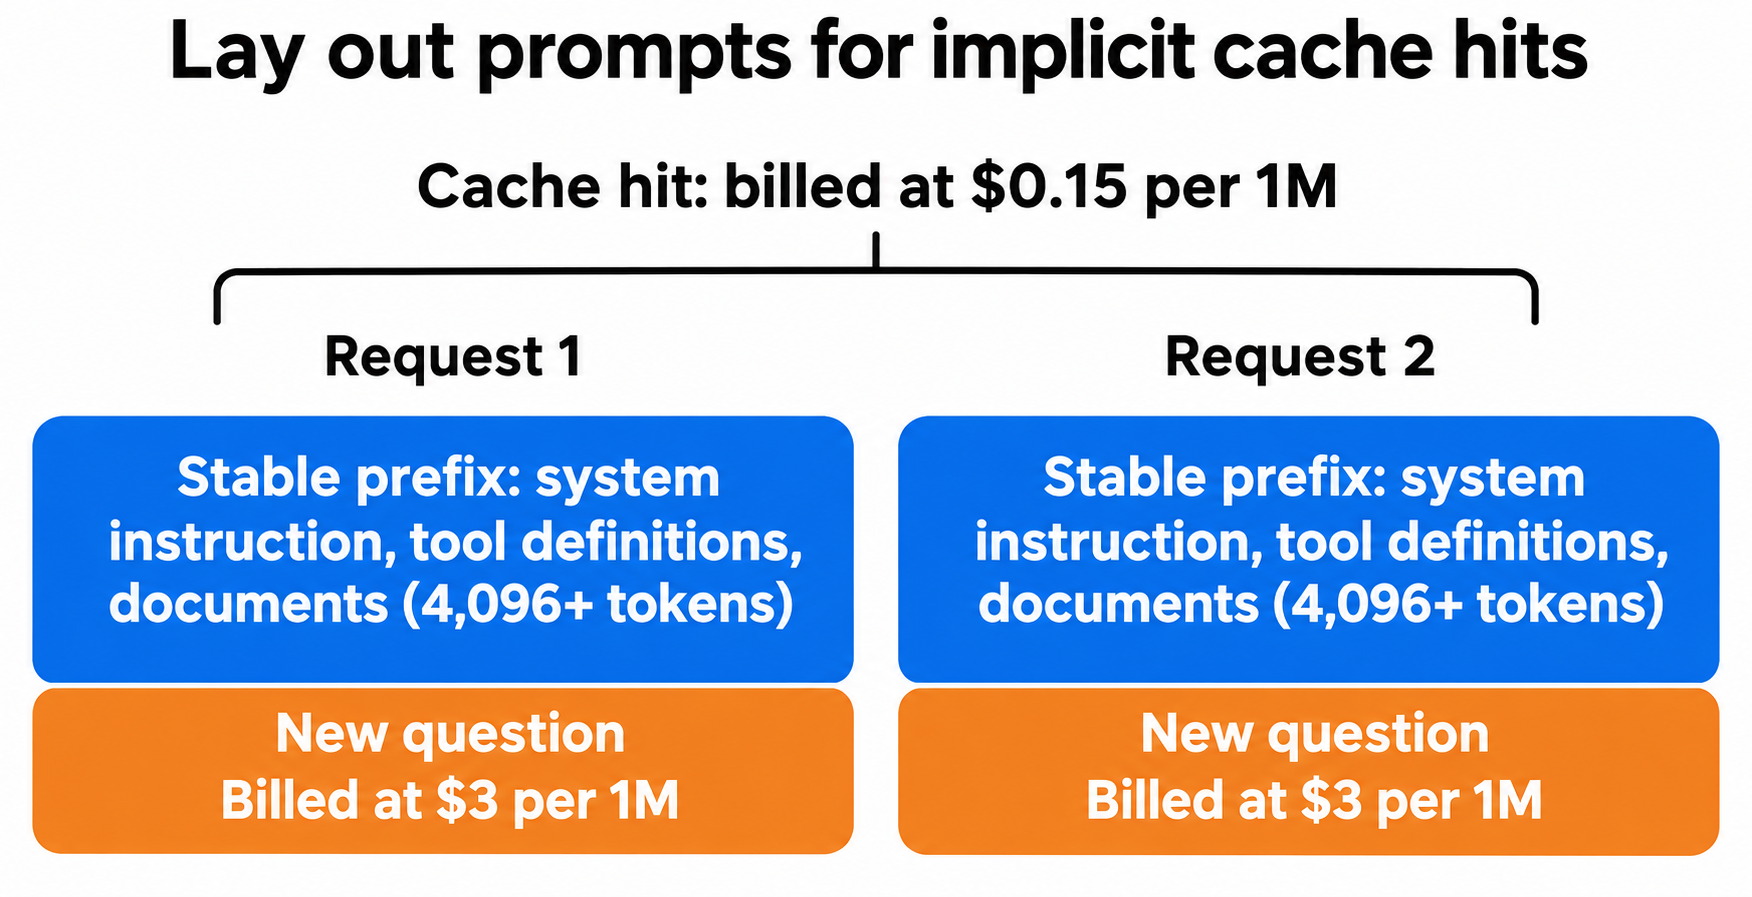
Sắp xếp mọi request theo thứ tự sau:
- System instruction. Văn bản cố định, không timestamp, không tên người dùng, không request ID.
- Khai báo tool và function. Cùng danh sách, cùng thứ tự, cùng mô tả mỗi lần.
- Tài liệu dùng chung. Codebase, hợp đồng, đặc tả API, tệp chính sách dài.
- Phần thay đổi. Câu hỏi của người dùng, kết quả tool mới nhất, ngày hôm nay.
Cách phổ biến nhất khiến trượt cache là một giá trị động nhỏ nằm gần đầu. Một dòng như Current time: 2026-11-19T09:14:02Z trong system instruction sẽ thay đổi prefix ở mỗi lần gọi, khiến mọi thứ sau nó không thể khớp. Hãy chuyển nó xuống cuối, sau các tài liệu.
Các nguyên nhân khác làm vỡ prefix: danh sách tool được xây theo thứ tự ngẫu nhiên, tài liệu được serialize lại với khoảng trắng khác nhau, và các chunk được truy xuất trả về theo thứ tự khác.
Giữ prefix trên 4.096 token. Một system prompt 2.000 token riêng lẻ sẽ không đủ điều kiện. Nếu bạn gửi kèm một tài liệu dùng chung dài, prefix kết hợp sẽ đạt yêu cầu.
Với Interactions API, hãy truyền instruction cố định qua system_instruction và đặt các tài liệu lên đầu trong input:
from google import genai

client = genai.Client()  # reads GEMINI_API_KEY

SYSTEM = open("review_rules.md").read()      # fixed text
CODEBASE = open("repo_snapshot.txt").read()  # ~200K tokens, unchanged

def ask(question: str):
    interaction = client.interactions.create(
        model="gemini-4-neon",
        system_instruction=SYSTEM,
        input=CODEBASE + "\n\nQuestion: " + question,
    )
    print("cached tokens:", interaction.usage.total_cached_tokens)
    return interaction

ask("Where do we validate JWT expiry?")
ask("Which handlers skip input validation?")
Lần gọi đầu tiên sẽ làm đầy cache. Nếu lần thứ hai in ra 0 token đã cache, nghĩa là có gì đó trong prefix đã thay đổi.
Caching ẩn hoạt động ở cả hai chế độ hội thoại. Các gọi không lưu trạng thái (stateless) như ví dụ trên đủ điều kiện, và các phiên có trạng thái (stateful) nối tiếp qua previous_interaction_id cũng vậy. Xem hướng dẫn Gemini 4 Neon API của chúng tôi để biết đầy đủ cấu trúc request.
Caching hoạt động thế nào trong vòng lặp agent: quy tắc 2.050 token
Vòng lặp agent là nơi caching mang lại lợi ích lớn nhất, vì mỗi lượt đều gửi lại toàn bộ lịch sử. Các model Gemini 4 có thêm một quy tắc bạn cần biết. Theo tài liệu caching của Google: "Gemini chỉ cache toàn bộ request trước đó nếu request mới bổ sung ít nhất 2.050 token." Output của model, các thought và kết quả function đều được tính vào tổng này.
Nếu một lượt bổ sung ít hơn 2.050 token, Gemini sẽ xử lý lại 2.050 token cuối của request trước đó theo giá input tiêu chuẩn. Phần đầu của prefix vẫn có thể trúng cache, nhưng phần đuôi đó sẽ tính giá $3 mỗi 1M.
Google lưu ý rằng hầu hết các lượt agent đều vượt ngưỡng này. Vấn đề chỉ phát sinh ở các vòng lặp nhiều bước nhỏ li ti, ví dụ một lượt kiểm tra trạng thái trả về {"ok": true}. Chi phí mỗi lượt là nhỏ (2.050 token với giá $3 mỗi 1M chỉ khoảng $0,006), nhưng cộng dồn qua hàng nghìn lượt ngắn thì đáng kể. Nếu vòng lặp của bạn tạo ra nhiều lượt gọi bé nhỏ, hãy gom các kết quả tool nhỏ vào một lượt khi logic cho phép.
Context caching của Gemini 4 Neon tiết kiệm được bao nhiêu?
Hãy lấy ví dụ một trợ lý review code trả lời 20 câu hỏi về một codebase 200.000 token. Mỗi câu hỏi bổ sung 3.000 token và nhận câu trả lời 1.000 token, trên gói Standard.
Không có lần trúng cache, mỗi lượt gọi tốn:
- Input: 203.000 × $3 / 1M = $0,609
- Output: 1.000 × $15 / 1M = $0,015
- Mỗi lượt gọi: $0,624, tức $12,48 cho 20 lượt gọi
Có trúng cache từ lượt gọi thứ hai, các lượt từ 2 đến 20 tốn:
- Prefix đã cache: 200.000 × $0,15 / 1M = $0,030
- Input mới: 3.000 × $3 / 1M = $0,009
- Output: $0,015
- Mỗi lượt gọi: $0,054
Cộng thêm lượt đầu tiên không có cache với giá $0,624, cả phiên chỉ tốn $1,65, giảm khoảng 87%.
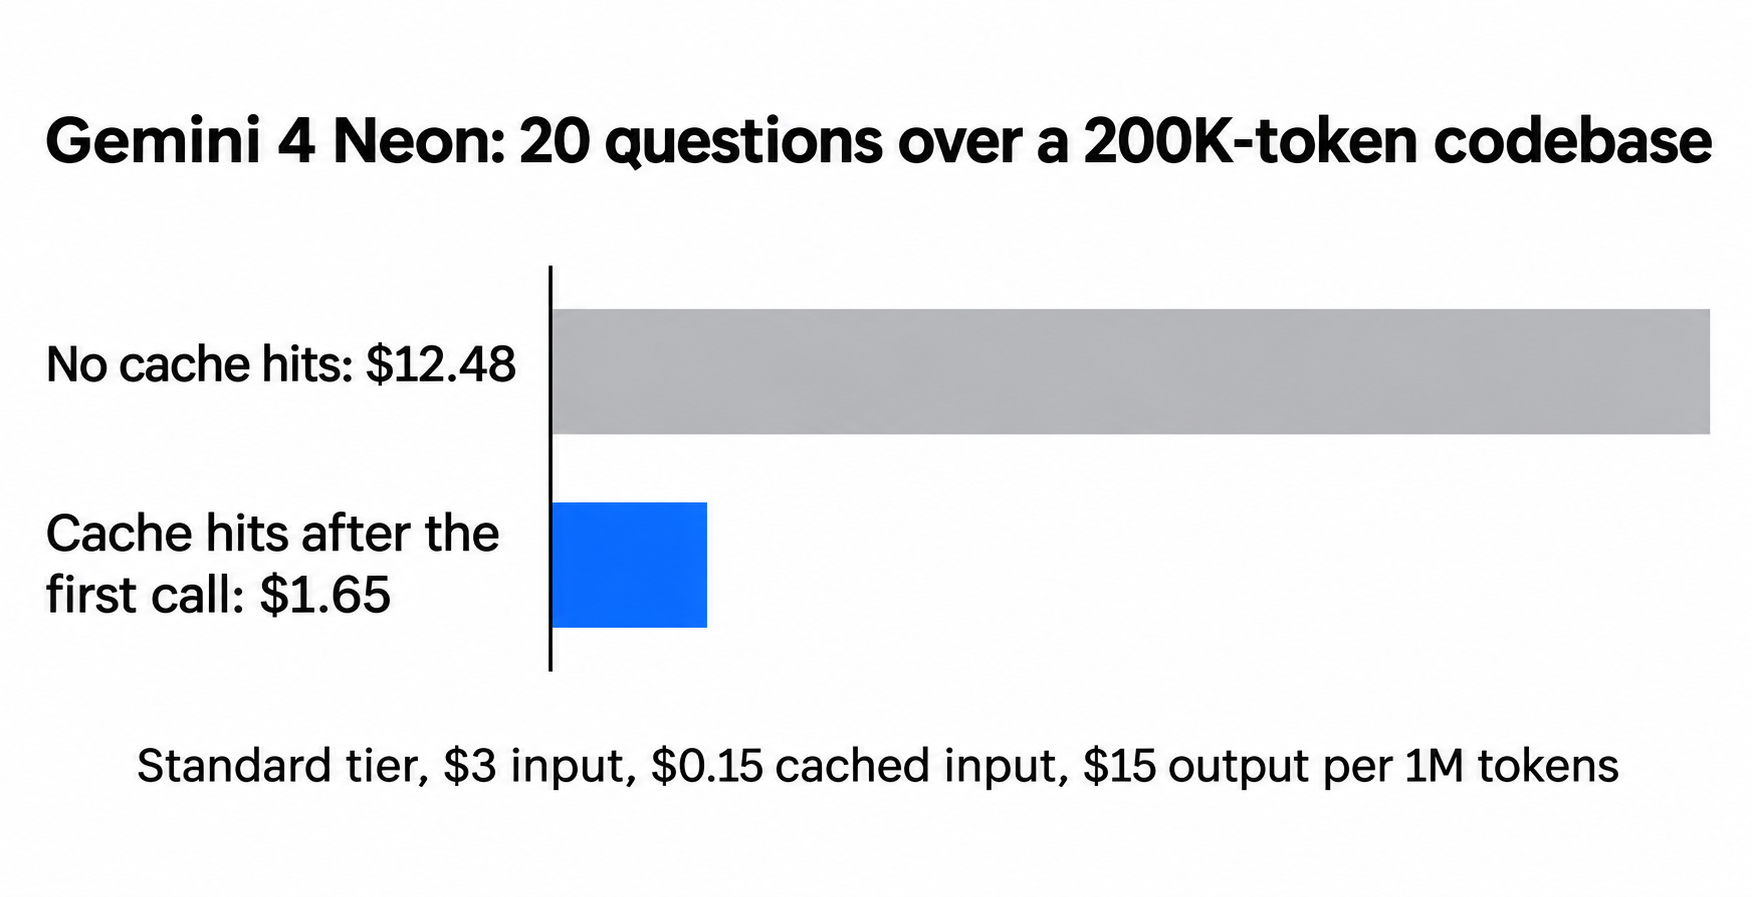
Mức tiết kiệm dưới 95% vì output và input mới không bao giờ được giảm giá. Phần prefix dùng chung càng lớn so với phần còn lại, bạn càng tiến gần mức 95% cho input. Chạy cùng công việc đó qua Batch thì giá đã cache giảm thêm một nửa xuống $0,075. Xem bảng giá Gemini 4 Neon để biết đầy đủ mức giá và chi phí theo cấp thinking.
Làm thế nào để kiểm tra số token đã cache của Gemini 4 Neon trong response?
Hãy đọc usage.total_cached_tokens trên mọi response. Google tài liệu hóa đây là trường hiển thị số token đã trúng cache, trong cả SDK Python và JavaScript.
Với curl và jq:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d @request.json | jq '.usage'
Để tính giá một lượt gọi, hãy tính các token đã cache với giá $0,15 mỗi 1M, phần còn lại của input với giá $3, và output cùng thinking với giá $15. Ghi lại số token đã cache cạnh request ID của bạn. Một đột surprising giảm về 0 trên toàn bộ lưu lượng thường có nghĩa là một lần deploy đã thay đổi prefix: một tool mới, một quy tắc được viết lại, hoặc một timestamp lọt vào system instruction.
Để coding agent của bạn kiểm tra lần trúng cache với Apidog CLI
Prefix hay bị vỡ trong những lần refactor bình thường, và chẳng ai nhận ra cho đến khi hóa đơn đến. Hãy biến việc kiểm tra cache thành một bài test API mà coding agent của bạn duy trì và CI chạy.
Apidog CLI cho phép Claude Code, Codex, Cursor hay OpenCode tạo và chạy các bài test API từ terminal. Cài đặt một lần:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho agent của bạn một prompt:
In Apidog project <id>, create an environment for the Gemini API with a
GEMINI_API_KEY variable. Build a test scenario called "Neon cache hit" with two
steps that POST to /v1beta/interactions with model gemini-4-neon, using our
production system_instruction and the docs/context.md file as the start of
input, then two different questions. Assert HTTP 200 on both, and assert that
usage.total_cached_tokens on step 2 is greater than 4096. Run it and tell me
the cached token count.
Agent sẽ tạo environment và scenario, kiểm tra payload của nó theo schema của CLI, rồi chạy:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog test-scenario create --project <id> --name "Neon cache hit"
apidog cli-schema get test-scenario-update
apidog cli-schema validate test-scenario-update --file scenario.json
apidog test-scenario update <scenarioId> --project <id> --file scenario.json
apidog run -t <scenarioId> --project <id> -e <envId> -r cli,json
Nếu tháng sau ai đó thêm timestamp vào system prompt, assertion của bước 2 sẽ fail trước khi thay đổi được triển khai. Đặt apidog run -t <scenarioId> --project <id> -e <envId> -r junit vào pipeline của bạn theo hướng dẫn CI/CD với Apidog CLI, hoặc bắt đầu từ Apidog CLI trong Claude Code. Mỗi lần chạy tạo hai lượt gọi Neon thực, nên tốn vài cent mỗi lần theo mức giá trên. Gói Free của Apidog hỗ trợ tới 4 người dùng.
Để hiểu prefix caching hoạt động thế nào trên các nhà cung cấp khác nhau, xem prompt caching là gì.
FAQ
Gemini 4 Neon có hỗ trợ context caching tường minh không? Không. Hướng dẫn Neon của Google nói rằng nó không hỗ trợ cachedContents hay caches.create, và bạn nên xóa cached_content khỏi các request. Neon chỉ dùng caching ẩn, vốn được bật sẵn theo mặc định.
Kích thước prompt tối thiểu để trúng cache trên Gemini 4 Neon là bao nhiêu? 4.096 token prefix dùng chung. Đây là mức tối thiểu giống với Gemini 4 Hydrogen, Argon và Carbon. Gemini 2.5 Flash và Pro cần 2.048.
Mức giảm giá caching của Gemini 4 Neon là bao nhiêu? 95% cho input đã cache. Standard giảm từ $3 xuống $0,15 mỗi 1M token, Batch và Flex từ $1,50 xuống $0,075, và Priority từ $5,40 xuống $0,27. Output và thinking token không được giảm giá.
Có thể ép Gemini 4 Neon cache một prompt không? Không. Caching ẩn không có tùy chọn để bật, không có TTL để chọn và không đảm bảo trúng cache. Bạn có thể tăng khả năng trúng bằng cách giữ một prefix dài, giống hệt nhau ở đầu mỗi request và gửi các request tương tự gần nhau về thời gian.
Làm sao biết request của tôi đã trúng cache? Kiểm tra usage.total_cached_tokens trong response. Giá trị lớn hơn 0 nghĩa là có bấy nhiêu input token được tính theo giá đã cache.
Caching có hoạt động với previous_interaction_id không? Có. Tài liệu của Google cho biết caching ẩn hoạt động cả ở các hội thoại có trạng thái nối tiếp qua previous_interaction_id lẫn các hội thoại không trạng thái, nơi bạn tự gửi toàn bộ lịch sử.