
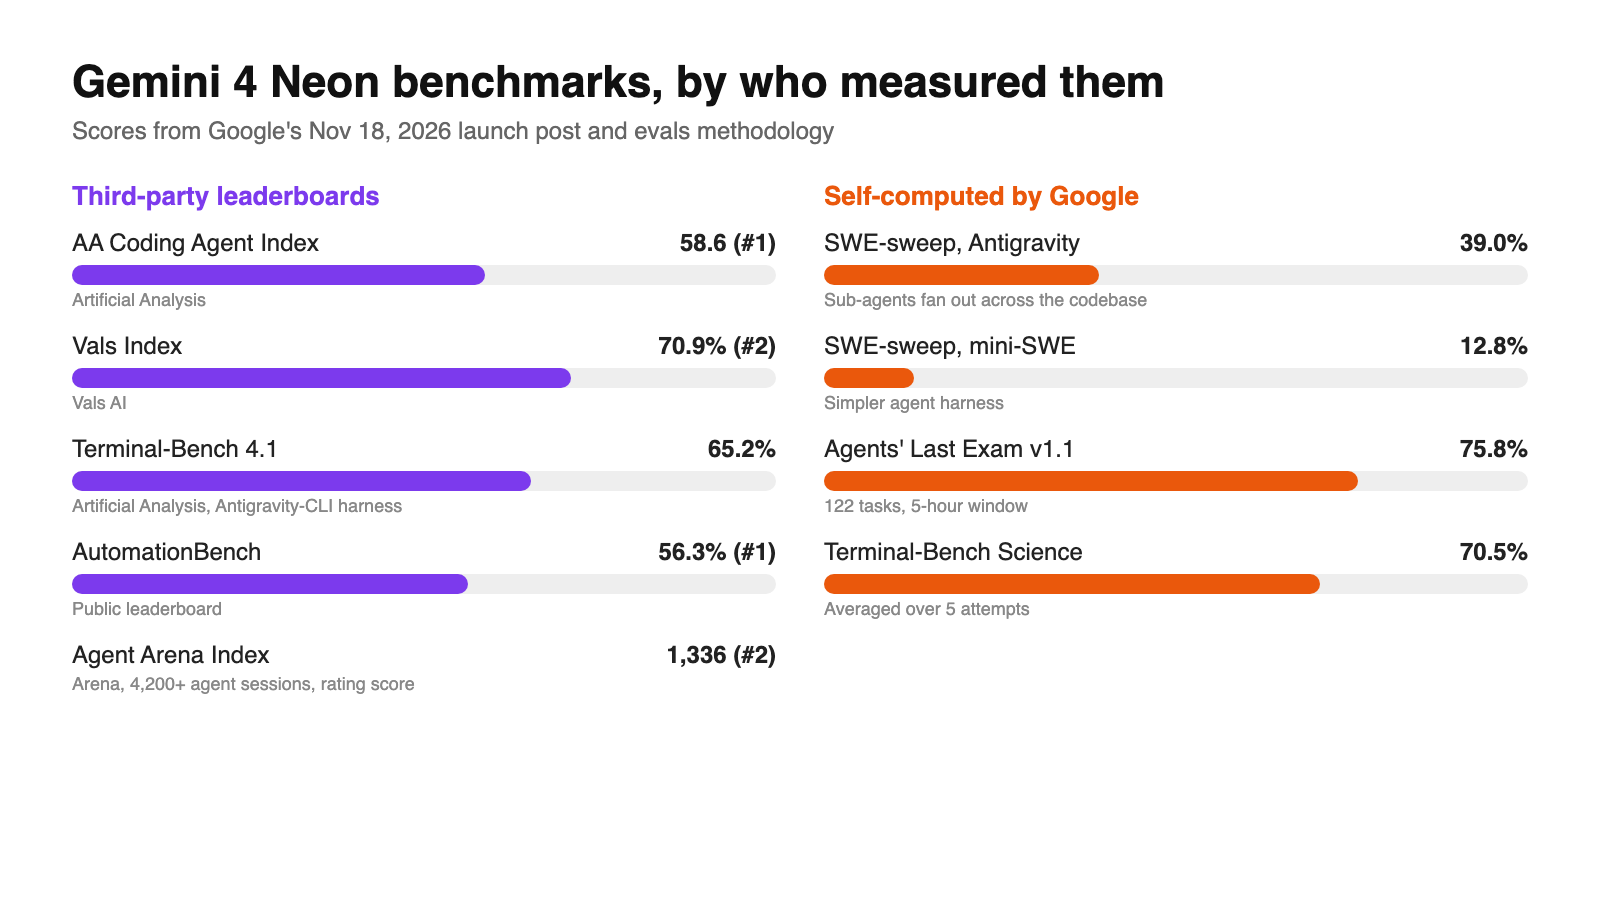
Các bài benchmark của Gemini 4 Neon đưa nó lên vị trí #1 trên Artificial Analysis Coding Agent Index (58.6), đạt 65.2% trên Terminal-Bench 4.1 và #2 trên Vals Index (70.9%). Google cũng cho biết nó có chi phí thấp hơn 32% cho mỗi tác vụ so với Gemini 4 Carbon ở mức suy luận high mặc định. Tuy nhiên, hầu hết các dòng kết quả đều được chạy ở mức xhigh, và một số chạy trên harness riêng của Google.
Chi tiết cuối cùng đó chính là trọng tâm của bài viết này. Tổng quan về Gemini 4 Neon của chúng tôi đã đề cập đến thông số kỹ thuật và giá cả. Ở đây, bạn sẽ có mọi điểm số đã công bố, ai đo lường chúng, ở mức suy luận nào, và cách biến "chi phí mỗi tác vụ" thành một con số bạn có thể đối chiếu với hóa đơn thực tế của mình.
Tổng quan các benchmark của Gemini 4 Neon
Gemini 4 Neon là mô hình Gemini 4 tầm trung của Google, ra mắt ngày 18 tháng 11 năm 2026, với giá 3 đô la cho mỗi triệu token đầu vào và 15 đô la cho mỗi triệu token đầu ra. Những kết quả được công bố mạnh nhất của nó nằm ở lĩnh vực lập trình tác tử và công việc tri thức, nơi nó xếp hạng #1 hoặc #2 trên bốn bảng xếp hạng độc lập.
Dưới đây là những dòng tiêu đề từ bài đăng ra mắt của Google:
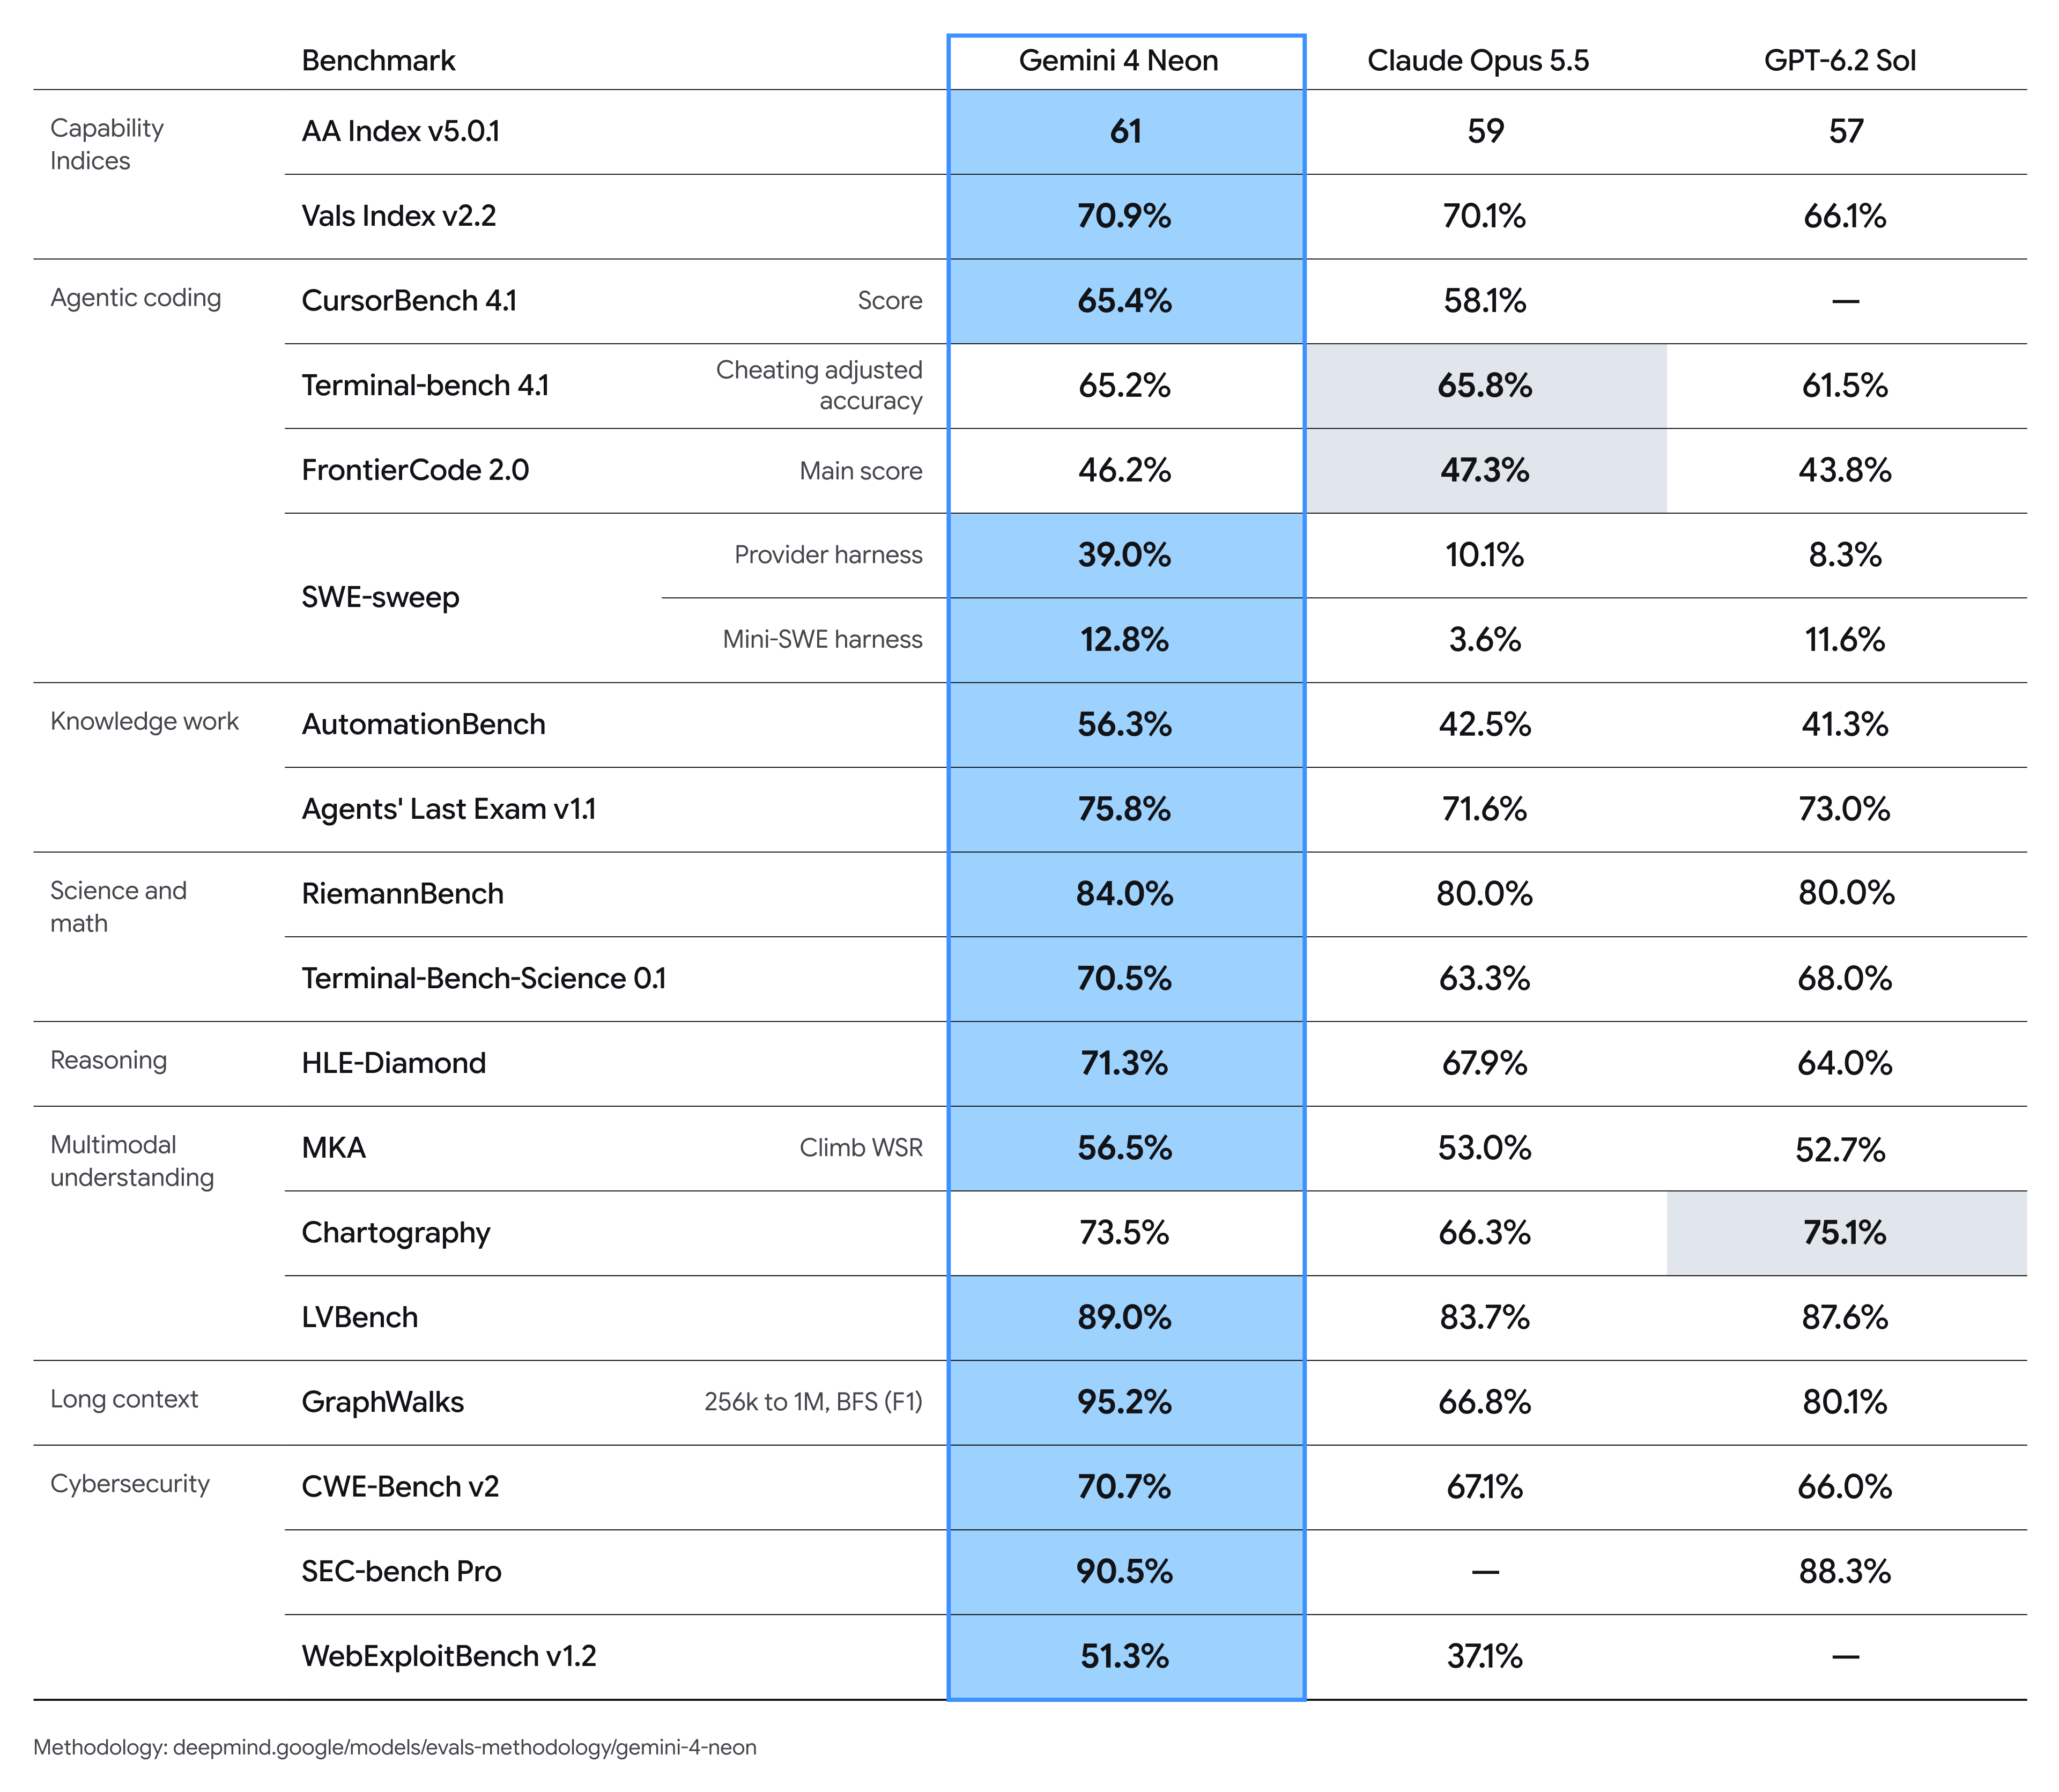
Google cũng báo cáo vị trí #1 trên Legal Research Bench và Tax Agent Bench của Vals AI.
Các benchmark lập trình của Gemini 4 Neon
Lập trình là lĩnh vực mà Neon có lợi thế mạnh nhất, đồng thời cũng là nơi harness đóng vai trò quan trọng nhất. Tài liệu PDF về phương pháp đánh giá của Google giải thích cách từng dòng kết quả lập trình được tạo ra.
Artificial Analysis Coding Agent Index: 58.6, #1. Đây là một chỉ số tổng hợp độc lập, nên đây là dòng ít bị ảnh hưởng bởi thiết lập của Google nhất. Bạn có thể xem bảng xếp hạng hiện tại trên Artificial Analysis.
Terminal-Bench 4.1: 65.2%. Artificial Analysis đã chạy Neon bằng harness Antigravity-CLI công khai, phiên bản 1.5.9. Điểm của các mô hình khác lấy từ bảng xếp hạng chính thức, và mọi kết quả đều dùng độ chính xác đã điều chỉnh gian lận. Công bằng, nhưng Neon được chạy bên trong chính công cụ tác tử của Google.
FrontierCode 2.0: 46.2%. Điểm này lấy từ bảng xếp hạng công khai và được chạy ở mức high, mức mặc định bạn nhận được trong môi trường production. Nếu bạn chỉ tin một con số lập trình cho lưu lượng hàng ngày, hãy tin con số này.
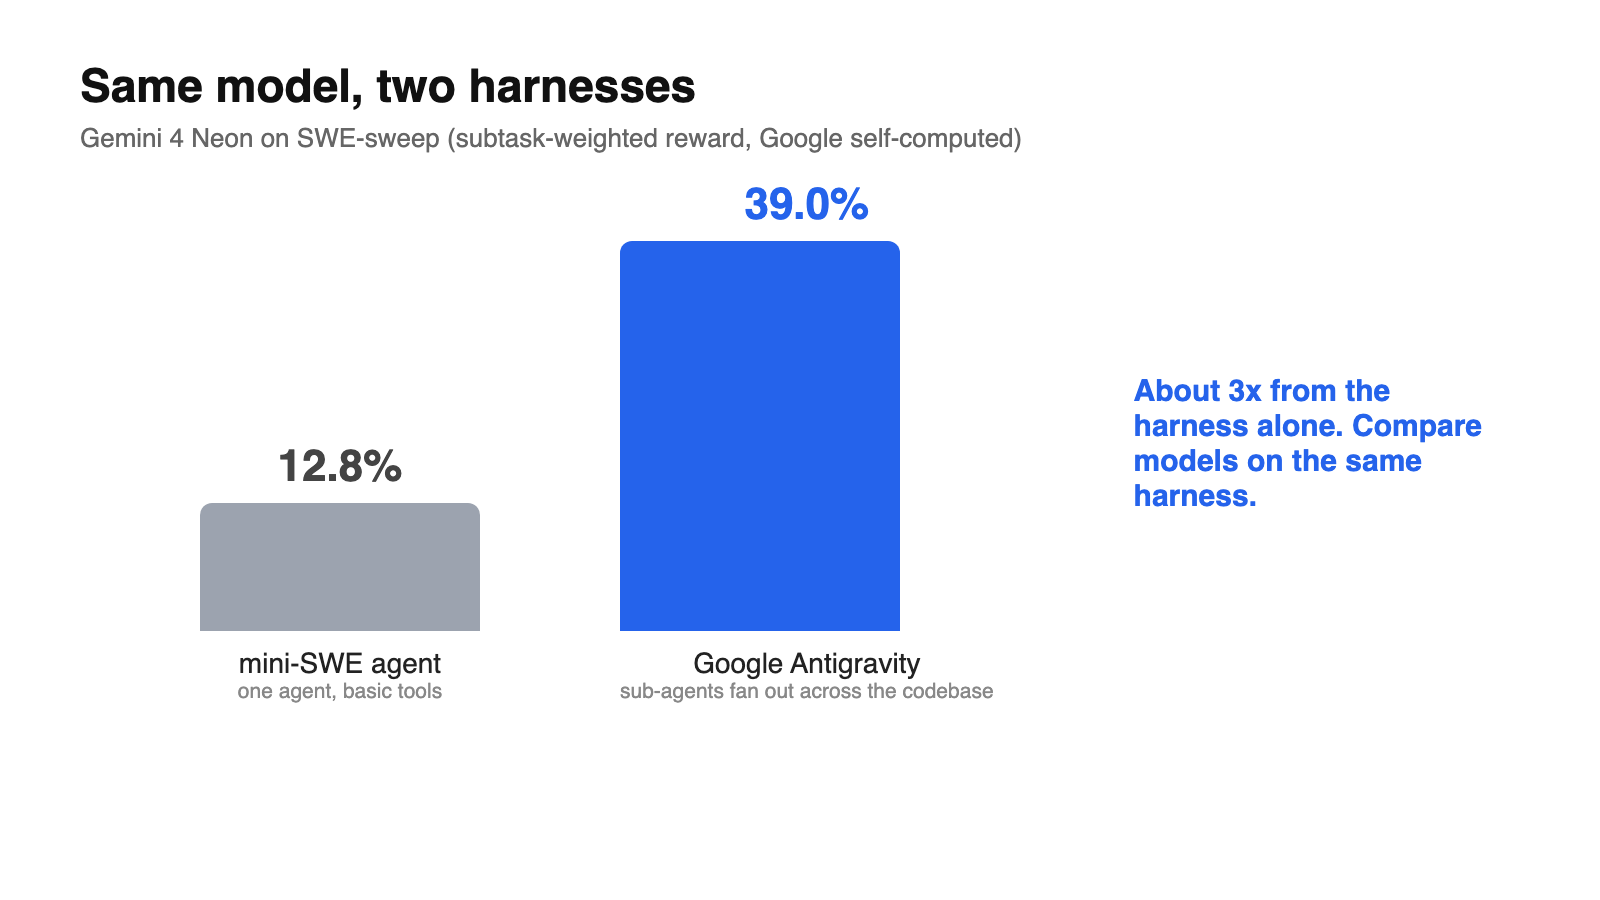
SWE-sweep: 39.0% trong Antigravity, 12.8% trên mini-SWE. Cả hai đều do Google tự tính. Cú nhảy gấp 3 lần đến từ harness: Google lưu ý rằng Antigravity-CLI bao gồm một công cụ mặc định phân tán các tác tử con trên toàn bộ codebase, phù hợp với các tác vụ tìm lỗi. Opus 5.5 chạy trong Claude Code và GPT-6.2 Sol chạy trong Codex cho cùng phép so sánh. Hãy hiểu 12.8% là con số của mô hình và 39.0% là con số của mô hình cộng với công cụ tốt nhất của nó.
Các benchmark về tác tử và công việc tri thức
Những dòng này quan trọng nếu bạn dự định chạy Neon không giám sát qua nhiều bước.
- Agent Arena Index: 1,336, #2. Được xây dựng từ hơn 4.200 phiên tác tử thực tế. Google cũng cho biết Neon xếp hạng #2 ở hạng mục khả năng điều khiển, nghĩa là nó thích ứng gọn gàng khi người dùng sửa nó giữa chừng tác vụ.
- AutomationBench: 56.3%, #1. Benchmark của Zapier cho tự động hóa doanh nghiệp, lấy từ bảng xếp hạng công khai.
- Vending-Bench 2: $16,843, #1. Mô phỏng tầm xa của Andon Labs về việc điều hành một doanh nghiệp. Điểm số là số tiền kiếm được, không phải phần trăm.
- Agents' Last Exam v1.1: 75.8%. Do Google tự tính trên bộ 122 tác vụ bên trong Antigravity-CLI 1.4.8 với khung thời gian 5 giờ mỗi lần chạy. Điểm của Opus 5.5 lấy từ bảng xếp hạng công khai và của GPT-6.2 Sol lấy từ system card của nó, nên các thiết lập có khác nhau.
- Chartography: 73.5%. Đọc các biểu đồ chuyên nghiệp dày đặc, do Google tự tính không dùng công cụ.
Về khoa học và toán học, Neon đạt 70.5% trên Terminal-Bench Science (tự tính, lấy trung bình trên 5 lần thử), 84.0% trên RiemannBench và 71.3% trên HLE-Diamond (từ bảng xếp hạng Artificial Analysis).
Google đã chạy các con số như thế nào
Bốn quy tắc từ phương pháp luận sẽ thay đổi cách bạn đọc bảng kết quả:
- Mặc định dùng mức suy luận cao nhất. "Tất cả kết quả đều được chạy với Gemini API ở mức suy luận cao nhất trừ khi có ghi chú khác." Đó là
xhigh. Chỉ FrontierCode 2.0 được đánh dấu rõ ràng làhigh. Các lệnh gọi production mặc định dùnghigh, nên hãy kỳ vọng ít token suy luận hơn và có thể điểm số thấp hơn bảng hiển thị. - Pass@1, thử một lần. Không bỏ phiếu đa số hay tính toán song song tại thời điểm kiểm thử, trừ khi có ghi chú (Terminal-Bench Science lấy trung bình 5 lần thử).
- Số liệu đối thủ do chính họ báo cáo. Điểm của các mô hình không phải Gemini đến từ từng nhà cung cấp trừ khi có ghi chú. Opus 5.5 và GPT-6.2 Sol dùng thiết lập suy luận tối đa khi có sẵn.
- Bộ lọc an toàn bật, trừ an ninh mạng. Các dòng về an ninh mạng được chạy với bộ lọc tắt.
Hướng dẫn về các mức suy luận của chúng tôi đề cập khi nào xhigh đáng để tiêu thêm token.
Chi phí mỗi tác vụ: tuyên bố 32% có nghĩa là gì
Chi phí mỗi tác vụ là tổng chi phí để hoàn thành một tác vụ benchmark, không phải giá mỗi token. Một mô hình có giá token cao hơn vẫn có thể tốn ít chi phí hơn cho mỗi tác vụ nếu nó đi đến câu trả lời với ít bước hơn và ít token suy luận hơn.
Google đưa ra ba tuyên bố về chi phí:
| Tuyên bố | Mức suy luận | So sánh với |
|---|---|---|
| Chi phí mỗi tác vụ thấp hơn 32%, với điểm AA Intelligence Index cao | high |
Gemini 4 Carbon |
| Chi phí mỗi tác vụ thấp hơn khoảng 50% đến 80% trên Vals Index và Agent Arena | high |
Các mô hình tiên phong đối thủ hàng đầu |
| Chi phí mỗi tác vụ thấp hơn 36%+ | xhigh |
Các mô hình đối thủ ở thiết lập cao nhất của chúng |
Hãy để ý sự chênh lệch: các dòng về độ chính xác chủ yếu dùng xhigh, trong khi mức tiết kiệm 32% hàng đầu là ở high. Cả hai đều đúng, nhưng không cùng lúc. Bạn sẽ có được mức tiết kiệm chi phí hoặc điểm số cao nhất, và khoảng cách giữa hai điều đó là để bạn tự đo lường.
Đây là cách ước tính chi phí mỗi tác vụ của riêng bạn. Token suy luận được tính là token đầu ra.
$$\text{cost} = \frac{\text{input} \times 3 + \text{cached input} \times 0.15 + \text{output} \times 15}{1{,}000{,}000}$$
Một tác vụ lập trình với 20.000 token đầu vào và 4.000 token đầu ra tốn $0.06 + $0.06 = $0.12. Nếu 15.000 trong số các token đầu vào đó khớp với bộ nhớ đệm, chi phí giảm xuống $0.015 + $0.00225 + $0.06 = khoảng $0.077. Chạy cùng tác vụ đó ở mức xhigh thì số lượng token đầu ra là yếu tố thay đổi, vì vậy hãy ghi log token theo từng mức, chứ không chỉ ghi đạt hay không đạt. Phân tích giá của Gemini 4 Neon của chúng tôi đề cập đến các mức giá Batch, Flex và Priority.
Các dòng về an ninh mạng và an toàn
Điểm số an ninh mạng đến từ "Gemini 4 Neon for cyber", được cung cấp cho các chuyên gia phòng thủ đáng tin cậy thông qua Fairwind Program thay vì API công khai.
| Benchmark | Điểm | Ghi chú |
|---|---|---|
| SEC-bench Pro | 90.5% | Tiên tiến nhất, chi phí mỗi thử thách chỉ khoảng một nửa |
| WebExploitBench v1.2 | 51.26% | Tiên tiến nhất, chi phí bằng một nửa so với các mô hình lớn |
| AutoBaxBench (hạng khó) | 76% | Tiên tiến nhất, mã an toàn hơn Carbon ở mọi hạng |
| CWE-bench v2 | 70.7% | Cải thiện 3.4% so với Carbon |
| ExploitGym | Không công bố | Đạt mức tiên phong chỉ với một nửa số token của Carbon |
Số liệu an toàn từ cùng bài đăng: Neon từ chối 1.98% các tác vụ Terminal-Bench 4.0, đạt 0.0% gian lận trên Terminal-Bench 4.0, thực hiện các lối tắt trên 2.45% bài đánh giá gian lận lập trình của Google, và vượt qua 99.2% bài đánh giá tính trung thực của tác tử. Với các biện pháp bảo vệ thời gian thực ở mức suy luận cao nhất, nó chống lại được mọi cuộc tấn công trong benchmark tấn công nhắc nhở gián tiếp của Gray Swan.
Nơi Neon không dẫn đầu
Neon không đứng đầu ở mọi lĩnh vực, và Google cũng thừa nhận điều đó:
- Artificial Analysis Intelligence Index: #3 tổng thể, "kém một chút so với các mô hình lớn hơn, chậm hơn."
- Vals Index: #2, không phải #1.
- Agent Arena Index: #2.
Google cũng vẫn khuyên bạn dùng Carbon cho những dự án tầm xa khó nhất. Nếu bạn đang cân nhắc giữa ba mô hình Gemini 4, bài so sánh Neon vs Carbon vs Hydrogen của chúng tôi sẽ phác thảo các đánh đổi, và bài về benchmark của Gemini 4 Argon cho thấy cách đọc bảng kết quả của mô hình trước đó.
Tự benchmark Gemini 4 Neon với Apidog CLI
Các bảng xếp hạng mô tả harness của Google, không phải sản phẩm của bạn. Cách nhanh nhất để biết liệu Neon có xứng đáng với giá của nó là để tác tử lập trình của bạn chạy cùng các câu lệnh ở cả high và xhigh, rồi ghi log token và độ trễ cho từng mức.
Không có bậc API miễn phí cho Neon, nên bạn cần một khóa Gemini API trả phí. Yêu cầu này tuân theo định dạng Interactions API đã được Google ghi tài liệu; chúng tôi chưa chạy thử trực tiếp cho bài viết này:
curl -s "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "gemini-4-neon", "input": "Find the race condition in this retry queue.", "generation_config": {"thinking_level": "high"}}'
Apidog CLI cho phép Claude Code, Codex, Cursor hoặc OpenCode tạo và chạy các bài kiểm thử API từ terminal. Thiết lập một lần:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho tác tử của bạn một câu lệnh:
In Apidog project <id>, create a Gemini API environment with GEMINI_API_KEY
and THINKING variables. Add a test case for POST /v1beta/interactions on
gemini-4-neon that sends my 10 eval prompts from prompts.csv, asserts HTTP 200
and a non-empty output, and records token usage and response time. Run it at
THINKING=high and THINKING=xhigh and compare cost per task at $3/$15 per 1M.
Tác tử sẽ tạo môi trường, kiểm tra payload của test case so với schema, rồi chạy nó một lần cho mỗi mức suy luận:
apidog environment create gemini-api --project <id> --base-url https://generativelanguage.googleapis.com
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=high" -r cli,json
apidog run --test-case <caseId> --project <id> -e <envId> -d prompts.csv --env-var "THINKING=xhigh" -r cli,json
Thêm --timeout-request 900000 nếu câu lệnh của bạn dài, vì các lần chạy xhigh khó có thể mất vài phút. Để chạy lại phép so sánh mỗi khi câu lệnh thay đổi, hãy đưa cùng lệnh apidog run ... -r junit vào CI với hướng dẫn Apidog CLI CI/CD, hoặc bắt đầu từ Apidog CLI trong Claude Code. Gói Miễn phí của Apidog hỗ trợ tối đa 4 người dùng.
Câu hỏi thường gặp
Kết quả benchmark tốt nhất của Gemini 4 Neon là gì? #1 trên Artificial Analysis Coding Agent Index với 58.6, cùng với #1 trên AutomationBench (56.3%) và Vending-Bench 2 ($16,843).
Các benchmark được chạy ở mức suy luận nào? Chủ yếu là xhigh, mức cao nhất. Phương pháp của Google cho biết kết quả dùng thiết lập suy luận cao nhất trừ khi có ghi chú; FrontierCode 2.0 (46.2%) được đánh dấu là mức high mặc định.
Gemini 4 Neon có rẻ hơn Carbon tính theo tác vụ không? Google cho biết chi phí mỗi tác vụ thấp hơn 32% ở mức high. Đó là con số mỗi tác vụ từ các lần chạy benchmark, nên hãy xác nhận trên câu lệnh của bạn trước khi chuyển lưu lượng.
Tại sao Neon đạt 39.0% và 12.8% trên SWE-sweep? Do các harness khác nhau. 39.0% là trong Google Antigravity, nơi phân tán các tác tử con trên toàn bộ codebase; 12.8% là của tác tử mini-SWE đơn giản hơn.
Các benchmark của Gemini 4 Neon có độc lập không? Một phần. Các dòng Artificial Analysis, Vals, Arena, AutomationBench và FrontierCode đến từ bên thứ ba. SWE-sweep, Agents' Last Exam và Terminal-Bench Science do Google tự tính.