
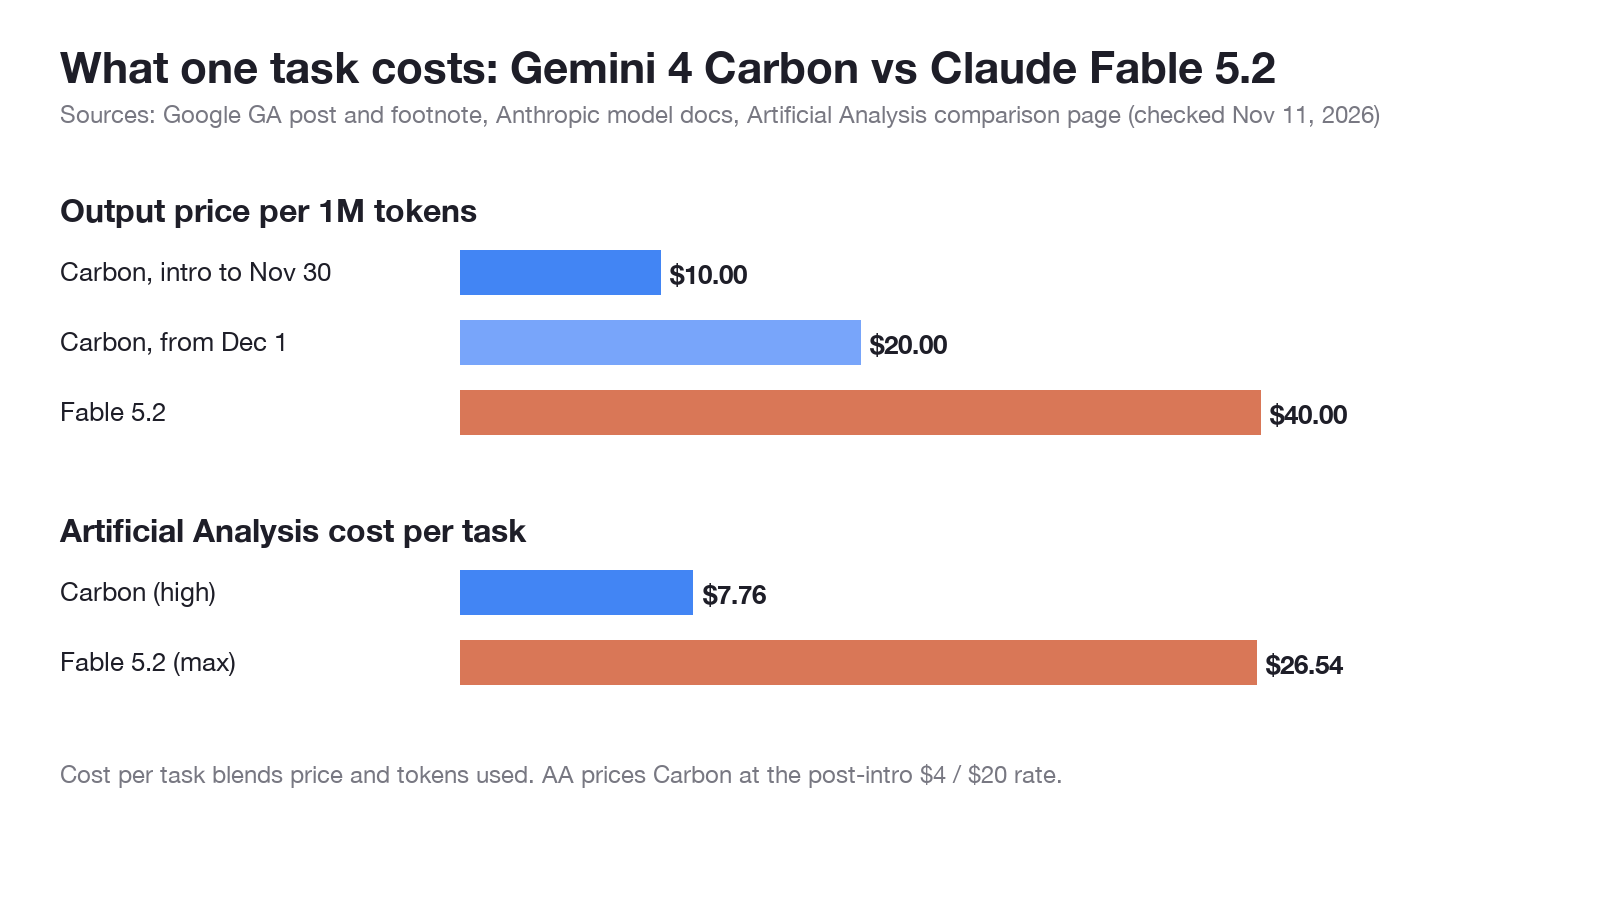
Tính đến ngày 11 tháng 11 năm 2026, Gemini 4 Carbon của Google là mô hình rẻ hơn còn Claude Fable 5.2 là mô hình mạnh hơn trên phần lớn các benchmark lập trình và agent đã được công bố. Carbon có giá niêm yết $2 / $10 cho mỗi 1M token đầu vào/đầu ra cho đến ngày 30 tháng 11 (sau đó là $4 / $20), Fable 5.2 có giá $8 / $40, và Artificial Analysis tính chi phí cho một tác vụ là $7.76 so với $26.54.
Hai mô hình ra mắt cách nhau đúng một ngày (Fable 5.2 vào ngày 9 tháng 11, Carbon GA vào ngày 10 tháng 11), và bảng số liệu của mỗi nhà cung cấp đều thiên vị mô hình của chính họ. Bài hướng dẫn này sẽ tách riêng từng con số theo bên đã đo lường, sau đó hướng dẫn cách chạy A/B cả hai mô hình trên chính các yêu cầu của bạn.
Gemini 4 Carbon vs Claude Fable 5.2: kết luận nhanh
Chọn Gemini 4 Carbon khi chi phí cho mỗi tác vụ là yếu tố quan trọng nhất, cho các luồng tự động hóa doanh nghiệp, hoặc cho công việc an ninh bảo mật. Chọn Claude Fable 5.2 khi bạn cần điểm số cao nhất trên các tác vụ lập trình khó, tác vụ terminal và sử dụng máy tính, và sẵn sàng trả khoảng gấp 3.4 lần chi phí cho mỗi tác vụ. Đối với công việc kỹ thuật hằng ngày, cả hai nhà cung cấp đều khuyên bạn nên bắt đầu với một lựa chọn mặc định rẻ hơn.
Bài đăng GA của Google nói rằng "Argon vẫn là lựa chọn lý tưởng cho phần lớn công việc kỹ thuật phần mềm và tri thức", và định vị Carbon cho các tác vụ khó hơn, nơi mô hình này tiêu tốn nhiều token hơn để khám phá và xác minh. Tài liệu mô hình của Anthropic cũng nói điều tương tự bằng cách riêng của họ: bắt đầu với Claude Opus 5.5 cho phần lớn khối lượng công việc và chuyển sang Fable 5.2 cho các tác vụ suy luận đòi hỏi cao và công việc agentic kéo dài.
Vì vậy, bạn chỉ nên dùng một trong hai khi lựa chọn mặc định của mình không đáp ứng được. Vẫn đang băn khoăn chọn mô hình mặc định? Hãy đọc trước bài Gemini 4 Carbon vs Argon.
Gemini 4 Carbon và Claude Fable 5.2 so sánh thế nào về giá và thông số kỹ thuật?
Dưới đây là các dữ kiện mà mỗi nhà cung cấp công bố, kèm nguồn cho từng dòng.
| Thông số | Gemini 4 Carbon | Claude Fable 5.2 | Nguồn |
|---|---|---|---|
| Model ID | gemini-4-carbon |
claude-fable-5-2 |
Google, Anthropic |
| Ngày phát hành | GA ngày 10/11/2026 | 09/11/2026 | Google, Anthropic |
| Giá đầu vào cho 1M token | $2 đến ngày 30/11, sau đó $4 | $8 ($16 ở chế độ fast) | Chú thích của Google, Anthropic |
| Giá đầu ra cho 1M token | $10 đến ngày 30/11, sau đó $20 | $40 ($80 ở chế độ fast) | Chú thích của Google, Anthropic |
| Cửa sổ ngữ cảnh | 1M token | 1M token | Model card AI Studio, tài liệu Anthropic |
| Đầu ra tối đa | 65K / 1M được ghi nhận [CẦN XÁC MINH] | 128K token | Model card AI Studio, tài liệu Anthropic |
| Thinking | Mức thinking có thể cấu hình | Thích ứng, luôn bật, mức effort mặc định high |
Quickstart của Google, tài liệu Anthropic |
| Truy cập qua đâu | Gemini API gói trả phí, AI Studio, Android Studio, Gemini for business, Antigravity, CodeMender, Google AI Ultra | Claude Platform, Amazon Web Services, Google Cloud, Microsoft Azure | Google, Anthropic |
| Gói API miễn phí | Không có thông báo | Không có thông báo | Google, Anthropic |
Bài đăng GA của Google không nhắc đến Vertex AI, Gemini CLI hay GitHub Copilot, nên đừng lên kế hoạch dựa trên các nền tảng đó vội. Giá giới thiệu của Carbon bằng với giá của Argon, khiến tháng 11 trở thành thời điểm rẻ nhất để chạy đánh giá của bạn.
Để xem bảng giá đầy đủ, xem giá Claude Fable 5.2 và thông báo Gemini 4 Carbon của Google.
Mô hình nào thắng trên các benchmark?
Điều đó phụ thuộc vào việc bạn đọc bảng của bên nào, nên đây là ba bảng được tách riêng.
Bảng của Anthropic (công bố cùng với Fable 5.2)
Bài đăng ra mắt Fable 5.2 của Anthropic bao gồm cả cột cho Gemini 4 Carbon. Trang này không nói ai đã chạy số liệu cho Carbon, vì vậy hãy xem chúng là số liệu do nhà cung cấp báo cáo.
| Benchmark (bảng của Anthropic) | Fable 5.2 | Gemini 4 Carbon |
|---|---|---|
| FrontierSWE v2 | 69.9% | 61.2% |
| FrontierCode 2.0 | 49.1% (effort xhigh) | 41.1% (effort medium) |
| Terminal-Bench-Science 0.1 | 74.6% | 64.8% |
| OSWorld 2.1 (bộ offline, một phần) | 89.3% | 81.5% |
| AA-Briefcase v1.1 (rubric) | 66.1% | 61.8% |
| Chartography (không dùng công cụ) | 73.4% | 72.5% |
| AutomationBench | 51.4% | 53.9% |
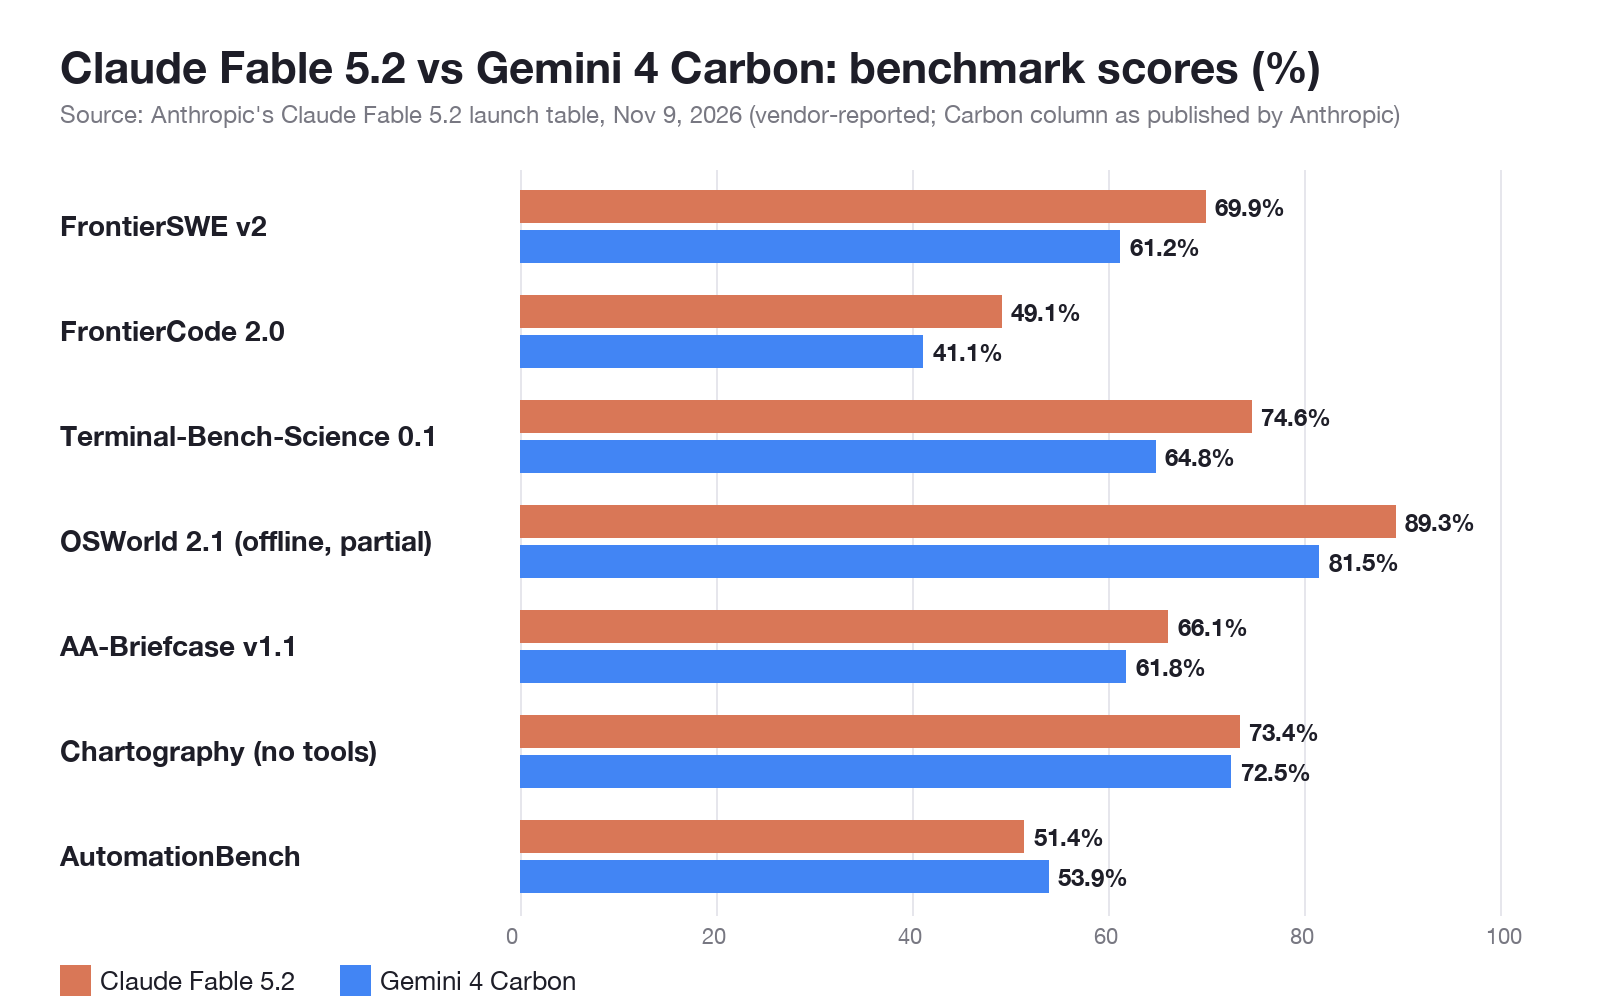
Chú ý dòng FrontierCode: Fable chạy ở mức effort xhigh còn Carbon ở mức medium. Khoảng cách về cấu hình này quan trọng không kém khoảng cách về điểm số.
Bảng của Google (công bố cùng với Carbon GA)
Google không công bố so sánh đối đầu trực tiếp với Fable 5.2. Thay vào đó, họ báo cáo các bảng xếp hạng từ đối tác: Carbon xếp thứ nhất trên CursorBench 4.0, WANDR của Perplexity và AutomationBench của Zapier "với chi phí cho mỗi tác vụ thấp hơn hơn 2 lần so với mô hình bên ngoài tốt nhất tiếp theo". Carbon xếp thứ hai trên benchmark Multimodal Knowledge Agent với chi phí trung bình cho mỗi tác vụ thấp hơn hơn 6 lần so với mô hình đứng đầu. Google không nêu tên các mô hình đối thủ trong những tuyên bố này.
Artificial Analysis (độc lập)
Trang so sánh của Artificial Analysis chạy cả hai mô hình qua cùng một Intelligence Index v5.0.1:
| Chỉ số (Artificial Analysis) | Fable 5.2 (max) | Gemini 4 Carbon (high) |
|---|---|---|
| Intelligence Index | 65 | 60 |
| Chi phí mỗi tác vụ | $26.54 | $7.76 |
| Chi phí chạy toàn bộ chỉ số | $22,191 | $8,240 |
| Tốc độ đầu ra | 103 token/s | 82 token/s |
Fable 5.2 (max) hiện đang giữ vị trí cao nhất trên chỉ số này. Carbon thấp hơn 5 điểm với chi phí mỗi tác vụ chỉ khoảng 29%. Artificial Analysis tính giá Carbon theo $4 / $20 — mức giá sau tháng 11 — nên số liệu chi phí của họ đã phản ánh giá tháng 12.
Claude Fable 5.2 thắng ở đâu?
Fable 5.2 thắng trên các tác vụ lập trình và sử dụng máy tính khó nhất, theo số liệu của Anthropic:
- Lập trình quy mô repository: 69.9% so với 61.2% trên FrontierSWE v2.
- Công việc terminal và nghiên cứu: 74.6% so với 64.8% trên Terminal-Bench-Science 0.1.
- Sử dụng máy tính: 89.3% so với 81.5% trên OSWorld 2.1.
- Chỉ số độc lập: 65 so với 60 trên Artificial Analysis — số điểm duy nhất mà không bên nào trong hai nhà cung cấp tự chạy.
- Độ dài đầu ra: đầu ra tối đa 128K token mỗi yêu cầu, được ghi nhận chính thức.
Nếu một tác vụ thất bại khiến kỹ sư mất cả buổi chiều, mức tăng 8 điểm trên FrontierSWE có thể đáng giá hơn cả hóa đơn token. Để thiết lập, xem hướng dẫn Claude Fable 5.2 API.
Gemini 4 Carbon thắng ở đâu?
Carbon thắng về chi phí mỗi tác vụ và trên các khối lượng công việc mà Google thiết kế nó để phục vụ:
- Chi phí mỗi tác vụ: $7.76 so với $26.54 trên Artificial Analysis, rẻ hơn khoảng 3.4 lần.
- Tự động hóa doanh nghiệp: 53.9% so với 51.4% trên AutomationBench — theo chính bảng của Anthropic.
- An ninh bảo mật: dẫn đầu trên SEC-bench Pro, ExploitGym và CWE-bench v1 theo Google, cùng một mô hình Carbon for cyber được giới hạn truy cập dành cho các nhà bảo vệ thông qua Fairwind Program.
- Giá trong tháng 11: $2 / $10 đến ngày 30 tháng 11, chỉ bằng một phần tư mức giá của Fable trên cả đầu vào lẫn đầu ra.
- Nhóm agent: bản xem trước /swarm trong Google Antigravity biến một prompt thành một nhóm phối hợp, với Carbon đảm nhận việc lập kế hoạch và kiểm tra trong khi các mô hình nhẹ hơn làm việc song song.
Mới làm quen với mô hình này? Bắt đầu với bài Gemini 4 Carbon là gì.
Một tác vụ thực tế tốn bao nhiêu tiền?
Giá niêm yết cho bạn biết đơn giá, không cho biết hóa đơn. Chi phí của một tác vụ bằng đơn giá nhân với số token mà mô hình chọn sử dụng, và Google cho biết Carbon tiêu tốn nhiều token hơn để khám phá và xác minh.
Ví dụ với một yêu cầu gồm 50,000 token đầu vào và 10,000 token đầu ra:
- Carbon, giá giới thiệu: (0.05 x $2) + (0.01 x $10) = $0.20
- Carbon, từ ngày 1 tháng 12: (0.05 x $4) + (0.01 x $20) = $0.40
- Fable 5.2: (0.05 x $8) + (0.01 x $40) = $0.80
Cách tính này giả định cả hai cùng phát sinh 10,000 token. Thực tế thì không. Nếu Carbon viết 30,000 token suy luận trong khi Fable chỉ viết 10,000, chi phí tháng 12 của Carbon tăng lên $0.80 và khoảng cách bị thu hẹp. Artificial Analysis đã đo đạc thực tế trên toàn bộ bộ test của họ và vẫn cho thấy Carbon rẻ hơn khoảng 3.4 lần mỗi tác vụ — đây là tín hiệu đáng tin cậy nhất cho đến khi bạn tự đo lường trên hệ thống của mình.
Làm thế nào để A/B Gemini 4 Carbon và Claude Fable 5.2 trên các yêu cầu của riêng bạn?
Benchmark là các tác vụ của người khác. Phép thử công bằng là gửi cùng một prompt đến cả hai API và ghi nhận token cùng độ trễ song song.
Cả hai lời gọi đều là HTTP thuần. Dưới đây là yêu cầu của Carbon, được xây dựng từ quickstart của Google cho Interactions API, với tên mô hình đặt trong biến:
MODEL="gemini-4-carbon"
curl "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -H "Api-Revision: 2026-05-20" \
  -d "{\"model\": \"$MODEL\", \"input\": \"Review this diff and list the bugs.\"}"
Fable 5.2 đi qua Messages API của Anthropic với claude-fable-5-2 là tên mô hình.
Để coding agent của bạn chạy phép thử A/B bằng Apidog CLI
Chạy từng cặp yêu cầu bằng tay sẽ nhanh chóng trở nên nhàm chán. Thay vào đó, hãy để Claude Code, Codex hoặc Cursor điều khiển Apidog CLI. Việc thiết lập chỉ cần ba lệnh:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
npx -y skills add https://apidog.com   # chọn agent của bạn khi được hỏi
Sau đó đưa cho agent của bạn một prompt duy nhất:
In Apidog project <PROJECT_ID>, create two test cases: one that sends
our code-review prompt to gemini-4-carbon through the Gemini API, and
one that sends the same prompt to claude-fable-5-2 through the Claude
Messages API. Keep both API keys in private environment variables.
Assert a 200 status and a non-empty answer, record token usage and
response time, run each case 5 times and summarize cost per run.
Validate every payload before you write it.
Agent sẽ kiểm tra schema, viết các test case và chạy chúng. Các cờ dưới đây lấy từ apidog run --help trên CLI 2.2.12:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file carbon-case.json
apidog test-case create --project <PROJECT_ID> --file fable-case.json
apidog run --test-case <CARBON_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
apidog run --test-case <FABLE_CASE_ID> --project <PROJECT_ID> \
  -e <ENV_ID> -n 5 -r cli,json --out-dir ab-results
-n 5 lặp lại mỗi test case năm lần, để một phản hồi chậm không quyết định kết quả. Thêm --upload-report để xem các lần chạy trong ứng dụng Apidog. Đây là một mẫu quy trình làm việc; chúng tôi chưa chạy nó với Carbon từ máy này. Hướng dẫn Apidog CLI trong Claude Code trình bày chi tiết phần thiết lập agent, còn hướng dẫn Gemini 4 Argon API bao gồm phần yêu cầu của Gemini.
Gói Free của Apidog hỗ trợ tối đa 4 người dùng — đủ để chạy phép so sánh này.
FAQ
Gemini 4 Carbon có tốt hơn Claude Fable 5.2 không?
Không hoàn toàn. Fable 5.2 đạt điểm cao hơn trên phần lớn benchmark của Anthropic và trên chỉ số của Artificial Analysis (65 so với 60). Carbon thắng về chi phí mỗi tác vụ ($7.76 so với $26.54) và trên AutomationBench.
Gemini 4 Carbon rẻ hơn Claude Fable 5.2 bao nhiêu?
Theo giá niêm yết, Carbon rẻ hơn 4 lần đến ngày 30 tháng 11 năm 2026 ($2 / $10 so với $8 / $40 cho mỗi 1M token) và rẻ hơn 2 lần từ ngày 1 tháng 12 ($4 / $20). Tính theo từng tác vụ như Artificial Analysis đã đo, nó rẻ hơn khoảng 3.4 lần.
Cả hai mô hình đều có cửa sổ ngữ cảnh 1M token không?
Có. Model card AI Studio của Google ghi nhận 1M token cho Carbon và tài liệu của Anthropic ghi nhận 1M token cho Fable 5.2. Đầu ra tối đa của Fable là 128K token; hãy kiểm tra hướng dẫn dành cho nhà phát triển của Google để biết giới hạn đầu ra chính xác của Carbon.
Có gói miễn phí cho Gemini 4 Carbon hoặc Claude Fable 5.2 trên API không?
Cả hai nhà cung cấp đều không công bố gói miễn phí. Carbon nằm trên gói trả phí của Gemini API và trong các ứng dụng Google AI Ultra; Fable 5.2 được tính phí theo token.
Tôi có nên chuyển mô hình mặc định sang một trong hai không?
Có lẽ là không. Google cho biết Argon vẫn là lựa chọn phù hợp cho phần lớn công việc kỹ thuật phần mềm và tri thức, và Anthropic khuyên dùng Opus 5.5 cho phần lớn khối lượng công việc. Chỉ nên định tuyến những tác vụ mà mô hình mặc định của bạn xử lý không tốt sang Carbon hoặc Fable, sau đó tự so sánh kết quả trên các yêu cầu của riêng bạn.