
Chưa có API Gemini 4 Argon công khai nào và Google cũng chưa công bố ID mô hình. Google đã công bố Argon vào ngày 30 tháng 9 năm 2026 và hiện tại nó chỉ dành cho những người tham gia Chương trình Fairwind: một nhóm đối tác Fairwind sử dụng nó như một mô hình được quản lý trên Gemini Enterprise. Artificial Analysis liệt kê Google AI Studio là nhà cung cấp API duy nhất của Argon, nhưng không có dữ liệu về tốc độ hoặc độ trễ, điều này phù hợp với việc truy cập trước phát hành được cấp phép hơn là một điểm cuối mà bạn có thể đăng ký. Khi đợt triển khai rộng rãi hơn bắt đầu, Google cho biết nó sẽ bắt đầu “với các khách hàng API trả phí và người đăng ký Google AI Ultra,” vì vậy khóa API Gemini trả phí sẽ giúp bạn được ưu tiên.
Khoảng cách giữa thông báo và quyền truy cập đó là thời gian bạn có thể tận dụng. Hướng dẫn này tách biệt những gì Google đã xác nhận về API Argon khỏi những gì chưa được xác nhận, sau đó hướng dẫn bạn qua mã bạn có thể chạy hôm nay trên Gemini 3.8 Flash để việc chuyển đổi sang Argon trở thành thay đổi một biến số. Bạn sẽ xây dựng yêu cầu, thiết lập cảnh báo sẵn sàng hoạt động, mô phỏng phản hồi trong Apidog, và thêm giới hạn chi phí theo giá của Argon. Đối với bản thân mô hình, hãy bắt đầu với Gemini 4 Argon là gì; để biết các giai đoạn triển khai, hãy xem hướng dẫn ngày phát hành Gemini 4 Argon.
Những gì đã được xác nhận về API Gemini 4 Argon và những gì chưa
Bài đăng ra mắt của Google cung cấp giá cả và giới hạn đầu ra. Hầu hết mọi thứ khác mà một tích hợp cần vẫn chưa được công bố.
| Mục | Trạng thái | Chi tiết |
|---|---|---|
| Giá đầu vào | Đã xác nhận | $2 cho 1 triệu token (giới thiệu), $4 sau thời gian giới thiệu |
| Giá đầu ra | Đã xác nhận | $10 cho 1 triệu token (giới thiệu), $20 sau đó |
| Đầu vào đã lưu vào bộ nhớ cache | Đã xác nhận | Giảm 95% giá đầu vào: $0.10 giới thiệu, $0.20 tiêu chuẩn |
| Giới hạn đầu ra | Đã xác nhận | 1 triệu token, tăng từ 64K |
| Bề mặt API | Đã báo hiệu | Tài liệu của Google cho biết tất cả các mô hình mới sẽ ra mắt trên Interactions API |
| ID mô hình | Chưa công bố | Không có trên trang mô hình, trang giá và nhật ký thay đổi |
| Cửa sổ ngữ cảnh đầu vào | Chưa công bố | Đánh giá ngữ cảnh dài của Google đã sử dụng lời nhắc lên tới 1 triệu token, nhưng đó không phải là một đặc tả |
| Mức độ tư duy | Chưa công bố | Đánh giá chạy ở "cài đặt tư duy cao nhất"; tên và mặc định chưa rõ |
| Giới hạn tốc độ | Chưa công bố | Chưa có cấp độ nào được công bố |
| Hỗ trợ hàng loạt | Chưa công bố | Không có giá hàng loạt hoặc Flex |
| Cấp độ lời nhắc dài | Chưa công bố | 3.1 Pro tính phí cao hơn khi trên 200K; quy tắc của Argon chưa được nêu rõ |
| Thời gian giới thiệu | Chưa công bố | Không có ngày kết thúc cho $2/$10 |
Hai hàng cần được xem xét kỹ hơn. Hàng "Bề mặt API" đến từ tài liệu API Interactions, trong đó nói rằng các mô hình mới "sẽ ra mắt trên Interactions API." Argon là một mô hình mới, vì vậy hãy kỳ vọng nó sẽ xuất hiện ở đó trước; Google chưa cho biết liệu generateContent có hỗ trợ nó hay không. Hàng "Giới hạn đầu ra" là giới hạn đã công bố của Google cho mô hình, nhưng Vals AI liệt kê đầu ra tối đa là 262K cho cấu hình mà họ đã thử nghiệm, vì vậy đừng cho rằng mọi điểm cuối sẽ cung cấp đầy đủ một triệu ngay từ ngày đầu tiên. Hướng dẫn 1 triệu token đầu ra của chúng tôi bao gồm những gì giới hạn đó ảnh hưởng đến việc truyền phát, thời gian chờ và lưu trữ.
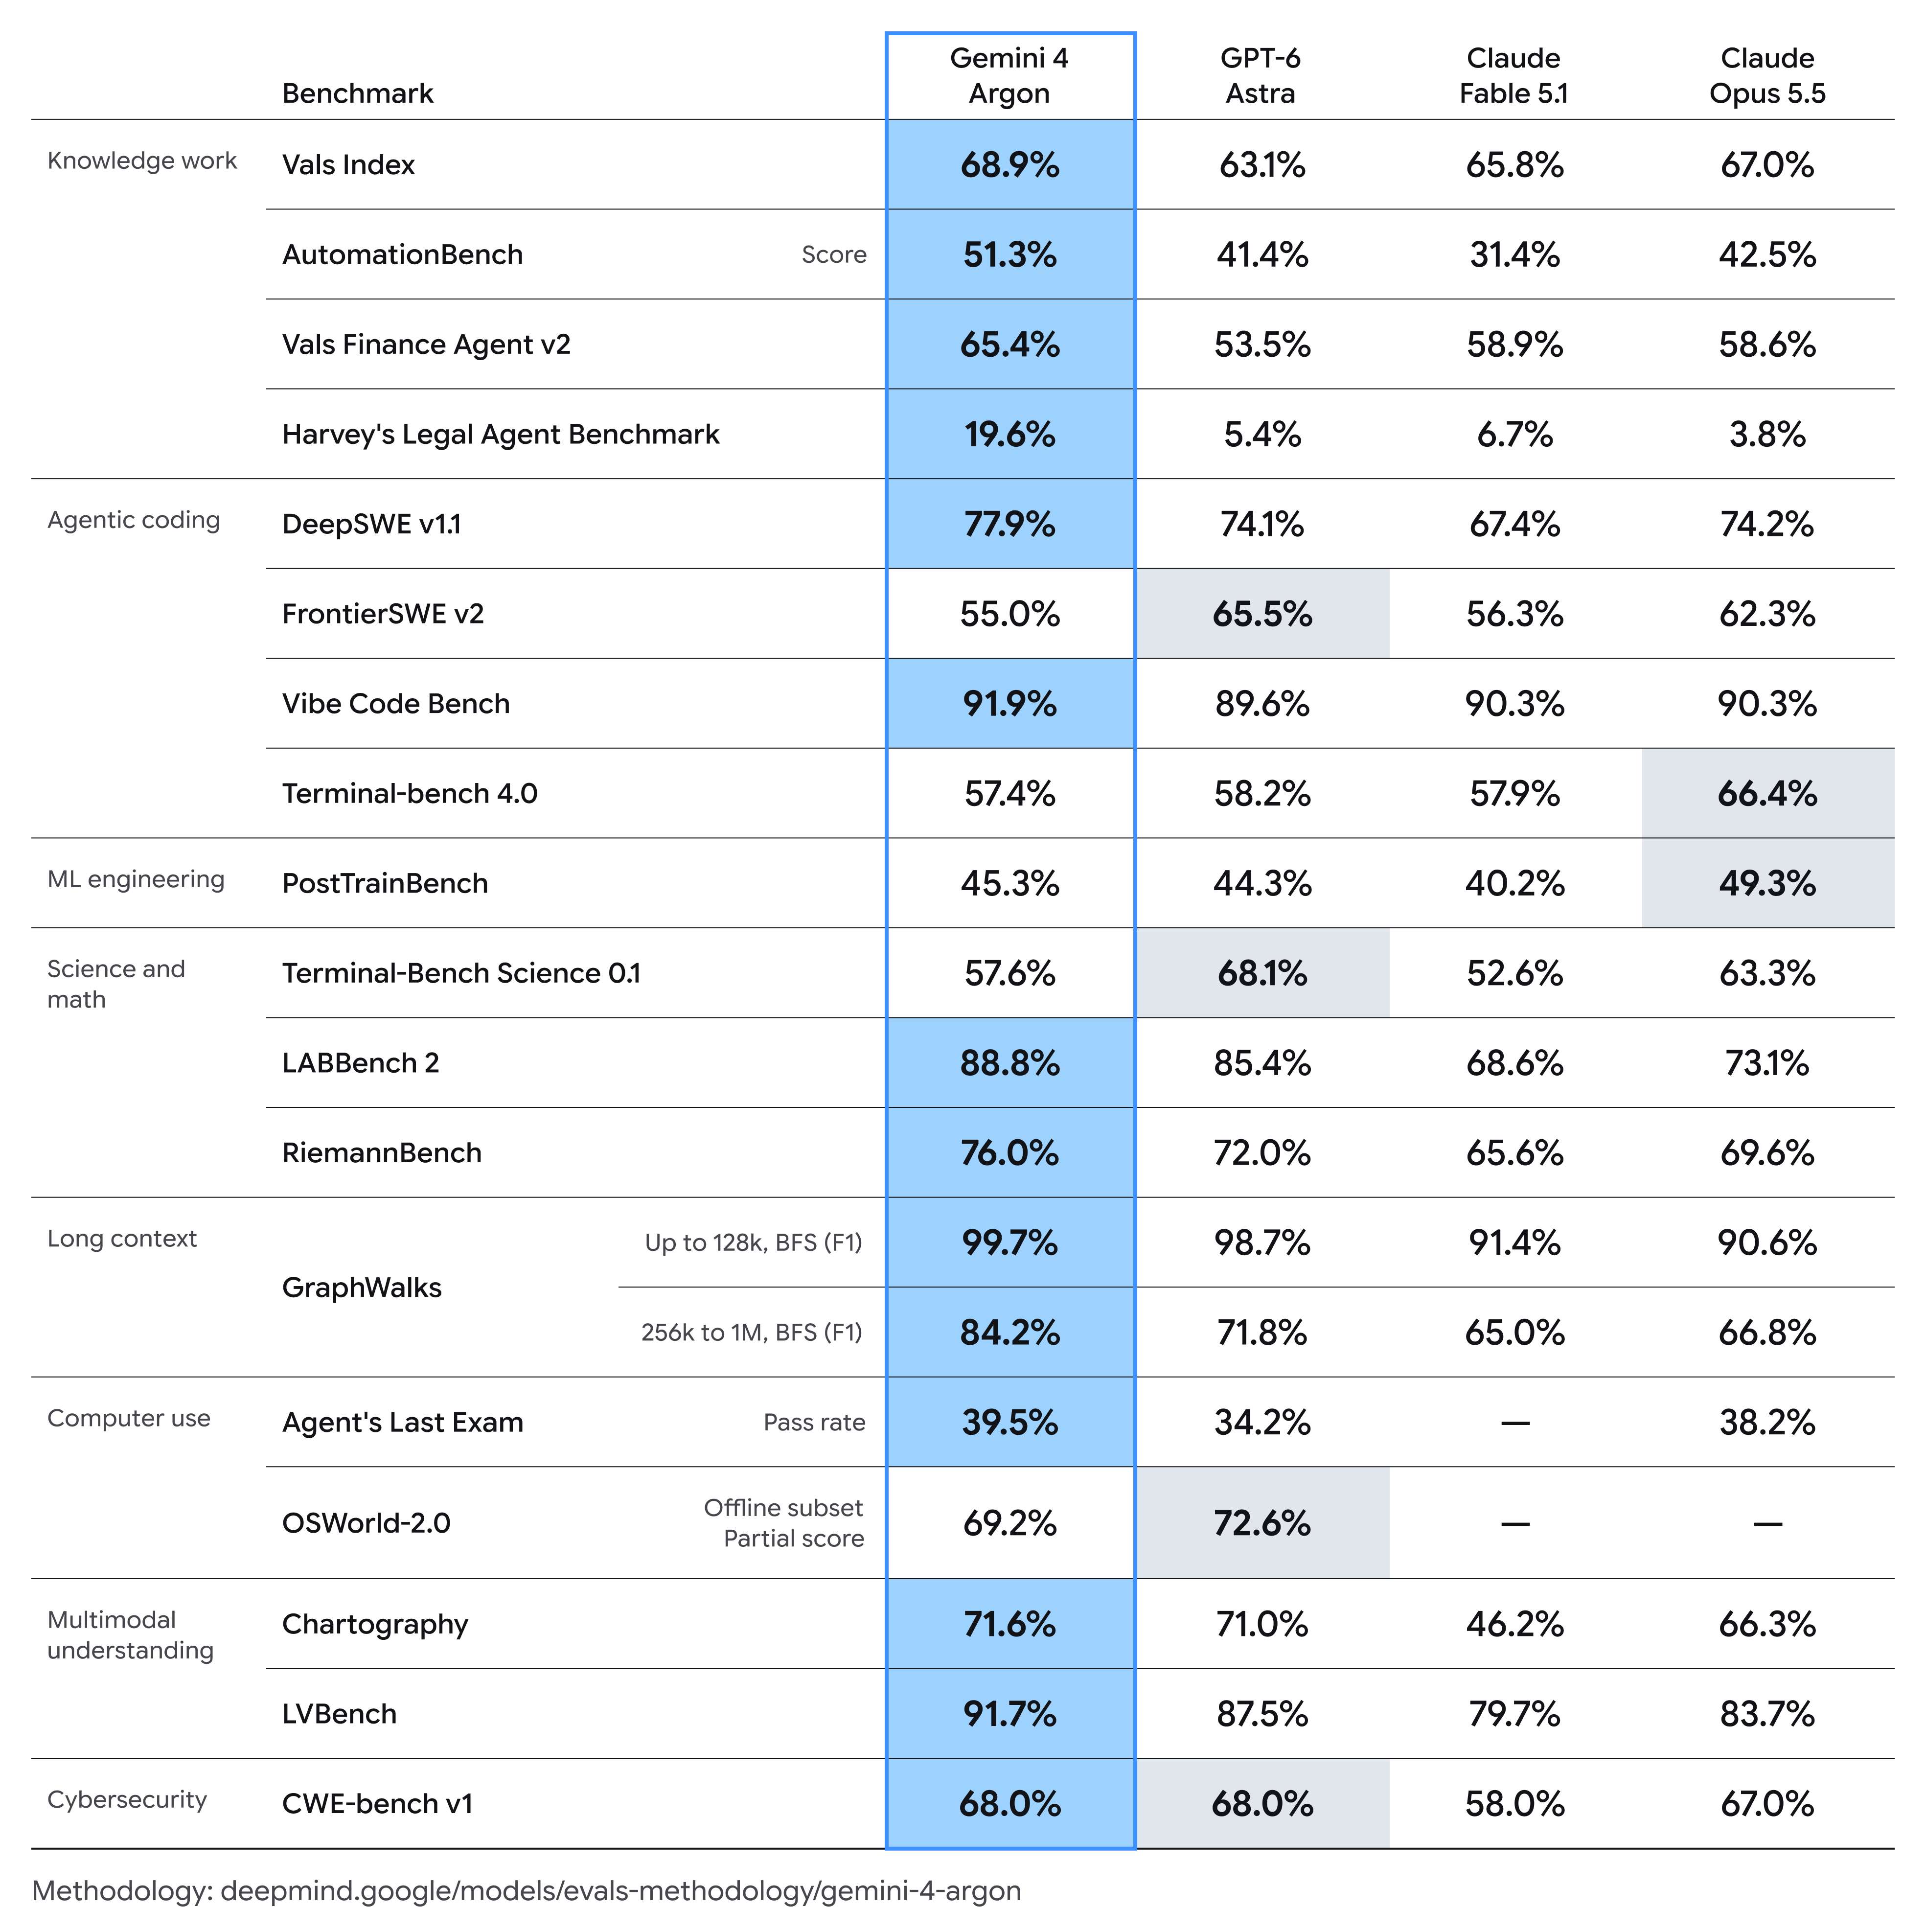
Về giá cả, một đoạn văn là đủ ở đây. Một yêu cầu với 20.000 token đầu vào và 5.000 token đầu ra có giá 20.000 x $2/1M + 5.000 x $10/1M = $0.04 + $0.05 = $0.09 theo giá giới thiệu, và $0.18 theo giá tiêu chuẩn $4/$20. Giá đầu ra giới thiệu của Argon ($10) thấp hơn $12 của Gemini 3.1 Pro Preview, và giá tiêu chuẩn của nó khớp chính xác với Claude Opus 5.5. Phân tích chi tiết giá Gemini 4 Argon chạy đầy đủ các kịch bản, bao gồm đầu vào đã lưu vào bộ nhớ cache và phản hồi tối đa 1 triệu token.
Không nên mã hóa cứng ID mô hình bạn tìm thấy trực tuyến
Tìm kiếm ID mô hình Argon và bạn sẽ tìm thấy các chuỗi trên các trang web benchmark, trình tổng hợp và yêu cầu kéo mã nguồn mở. Chúng chỉ là chỗ dành sẵn. Vals AI sử dụng slug riêng cho trang mô hình của mình, một yêu cầu kéo trên GitHub thêm ID “tạm thời,” và đường dẫn kiểu OpenRouter dẫn đến trang không tìm thấy. Google chưa xác nhận bất kỳ ID nào trong số đó, và một số kênh truyền thông đã cảnh báo rõ ràng về việc mã hóa cứng một giá trị phỏng đoán.
Một ID phỏng đoán sẽ thất bại theo cách ít hữu ích nhất: một lỗi 404 trong sản xuất vào ngày triển khai, hoặc một dự phòng im lặng nếu trình bao bọc của bạn bắt lỗi quá rộng. Thay vào đó, hãy giữ tên mô hình trong cấu hình. Trong mỗi ví dụ dưới đây, mô hình đến từ một biến môi trường GEMINI_MODEL mặc định là gemini-3.8-flash, một mô hình ổn định mà bạn có thể gọi hôm nay. Khi Google công bố ID của Argon, bạn chỉ cần thay đổi một giá trị.
Chuẩn bị mã của bạn trên Gemini 3.8 Flash
Gemini 3.8 Flash (gemini-3.8-flash) chạy trên cùng các điểm cuối, tiêu đề và cấu trúc phản hồi mà Argon dự kiến sẽ sử dụng, với giá $0.75/$3.75 cho mỗi 1 triệu token đến hết ngày 31 tháng 12 năm 2026. Khóa của bạn nằm trong GEMINI_API_KEY; tuyệt đối không dán nó vào mã nguồn. Thiết lập đầy đủ có trong hướng dẫn API Gemini 3.8 Flash của chúng tôi.
Bước 1: Gửi yêu cầu API Interactions
Interactions API là API chính của Google, đã có sẵn rộng rãi từ tháng 6 năm 2026. Hãy giữ cả mô hình và cấp độ tư duy trong các biến, vì tên cấp độ của Argon chưa được công bố.
MODEL="${GEMINI_MODEL:-gemini-3.8-flash}"
THINKING="${GEMINI_THINKING:-medium}"

curl -s -X POST "https://generativelanguage.googleapis.com/v1beta/interactions" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"model\": \"${MODEL}\",
    \"input\": \"List the retry rules a REST client should follow for HTTP 429.\",
    \"generation_config\": {\"thinking_level\": \"${THINKING}\"}
  }"
Python SDK cần google-genai 2.3.0 trở lên cho Interactions API:
# pip install "google-genai>=2.3.0"
import os
from google import genai

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
THINKING = os.environ.get("GEMINI_THINKING", "medium")

client = genai.Client()  # đọc GEMINI_API_KEY từ biến môi trường
interaction = client.interactions.create(
    model=MODEL,
    input="List the retry rules a REST client should follow for HTTP 429.",
    generation_config={"thinking_level": THINKING},
)
print(interaction.output_text)
Trên 3.8 Flash, các cấp độ hợp lệ là low, medium (mặc định) và high; minimal sẽ trả về HTTP 400. Hướng dẫn cấp độ tư duy của chúng tôi giải thích các đánh đổi. Đối với công việc nhiều lượt, hãy truyền ID của phản hồi trước đó làm previous_interaction_id và gửi store: false để từ chối lưu trữ phía máy chủ.
Bước 2: Duy trì hoạt động của đường dẫn generateContent
Hầu hết mã hiện có gọi điểm cuối generateContent cũ, mà Google cho biết vẫn được hỗ trợ đầy đủ. Đây là yêu cầu tương tự:
curl -s "https://generativelanguage.googleapis.com/v1beta/models/${MODEL}:generateContent" \
  -H "x-goog-api-key: $GEMINI_API_KEY" \
  -H "Content-Type: application/json" \
  -d "{
    \"contents\": [{\"parts\": [{\"text\": \"List the retry rules a REST client should follow for HTTP 429.\"}]}],
    \"generationConfig\": {\"thinkingConfig\": {\"thinkingLevel\": \"${THINKING}\"}}
  }"
Lưu ý vị trí của cấp độ tư duy: generation_config.thinking_level trên Interactions, generationConfig.thinkingConfig.thinkingLevel ở đây. Nếu client của bạn bao bọc cả hai, hãy định tuyến các mô hình mới thông qua Interactions theo mặc định. Định nghĩa công cụ cũng cần được quan tâm tương tự; xem Gemini 3.8 Flash function calling.
Bước 3: Lên lịch kiểm tra sẵn sàng hoạt động với models.list
Đừng làm mới nhật ký thay đổi. Hãy hỏi API. Điểm cuối models trả về các mô hình có sẵn cùng với giới hạn token và các phương thức được hỗ trợ:
import os, sys, requests

resp = requests.get(
    "https://generativelanguage.googleapis.com/v1beta/models",
    params={"pageSize": 1000},
    headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]},
    timeout=30,
)
resp.raise_for_status()
hits = [m for m in resp.json().get("models", []) if "argon" in m["name"].lower()]
for m in hits:
    print(m["name"], "in:", m.get("inputTokenLimit"),
          "out:", m.get("outputTokenLimit"), m.get("supportedGenerationMethods"))
sys.exit(1 if hits else 0)  # một lần chạy thất bại là cảnh báo
Chạy nó hàng giờ từ cron hoặc lịch trình CI, sử dụng khóa mà ứng dụng sản xuất của bạn đang dùng. Khi chúng tôi chạy lệnh gọi này vào ngày 1 tháng 10 năm 2026, với khóa dự án trả phí, nó đã trả về 61 mô hình, không có nextPageToken, và không có tên nào chứa "argon". Ngày nào nó khớp, mục nhập sẽ cho bạn biết ba điều cùng lúc: tên mô hình thực, liệu outputTokenLimit có phải là đầy đủ 1 triệu không, và những phương thức nào được liệt kê.
Bước 4: Mô phỏng phản hồi để client được xây dựng trước khi truy cập
Bạn không cần Argon để xây dựng mã tiêu thụ Argon. Lưu yêu cầu Bước 2 trong Apidog với GEMINI_API_KEY và GEMINI_MODEL làm biến môi trường, gửi nó một lần đến 3.8 Flash, và trích xuất phản hồi thực vào điểm cuối làm ví dụ phản hồi. Smart Mock mặc định của Apidog tạo dữ liệu từ lược đồ, vì vậy hãy đặt phương thức mock mặc định của dự án thành "Response example first" (Cài đặt dự án, Cài đặt tính năng, Cài đặt Mock). URL mock sau đó sẽ trả về phản hồi đã lưu của bạn, để giao diện người dùng, trình xử lý hàng đợi và trình phân tích cú pháp của bạn có thể chạy đối với nó mà không tốn token.
Hãy rõ ràng về mock này là gì: lược đồ phản hồi Gemini hiện tại, không phải lược đồ dành riêng cho Argon, vì Google chưa công bố. Đây vẫn là lựa chọn đúng đắn, vì Argon dự kiến sẽ sử dụng cùng API. Để diễn tập một phản hồi Argon nặng, hãy chỉnh sửa usageMetadata của ví dụ thành số lượng lớn và xác nhận mã thanh toán và cảnh báo của bạn phản ứng.
Bước 5: Xác nhận usageMetadata và giới hạn chi phí
Mỗi phản hồi generateContent đều bao gồm usageMetadata. Thêm một tập lệnh hậu xử lý trong Apidog để định giá mỗi phản hồi theo tỷ lệ tiêu chuẩn của Argon, để một thử nghiệm thất bại trước khi hóa đơn xuất hiện:
// Trình xử lý hậu kỳ của Apidog: định giá phản hồi này theo tỷ lệ tiêu chuẩn của Gemini 4 Argon
const u = pm.response.json().usageMetadata;
const IN = 4 / 1e6;   // USD cho mỗi token đầu vào sau thời gian giới thiệu
const OUT = 20 / 1e6; // USD cho mỗi token đầu ra; các token "suy nghĩ" được tính là đầu ra trên các mô hình Gemini hiện tại
const out = (u.candidatesTokenCount || 0) + (u.thoughtsTokenCount || 0);
const cost = u.promptTokenCount * IN + out * OUT;
pm.test("usageMetadata có mặt", () => pm.expect(u).to.be.an("object"));
pm.test("chi phí dưới $0.10 theo tỷ giá Argon", () => pm.expect(cost).to.be.below(0.10));
Chọn giới hạn cho mỗi yêu cầu; $0.10 phù hợp với một lời nhắc ngắn như thế này. Google chưa nêu rõ Argon sẽ tính phí token tư duy như thế nào, vì vậy tập lệnh giả định quy tắc Gemini hiện tại. Giữ nguyên yêu cầu đã lưu và chạy nó với 3.8 Flash bây giờ và Argon sau này: sự khác biệt về số lượng token và chi phí là so sánh hồi quy của bạn.
Câu hỏi thường gặp
API Gemini 4 Argon đã có sẵn chưa? Chưa công khai. Argon chỉ đang được triển khai cho một nhóm các đối tác Chương trình Fairwind, những người sử dụng nó thông qua Gemini Enterprise. Khách hàng API trả phí và người đăng ký Google AI Ultra sẽ là những người tiếp theo, nhưng chưa có ngày cụ thể.
ID mô hình Gemini 4 Argon là gì? Google chưa công bố. Các chuỗi trên các trang web của bên thứ ba chỉ là chỗ dành sẵn, vì vậy hãy giữ mô hình trong một biến môi trường và theo dõi models.list.
API Gemini 4 Argon sẽ có giá bao nhiêu? $2 đầu vào và $10 đầu ra cho mỗi 1 triệu token trong thời gian giới thiệu chưa được xác định, sau đó là $4 và $20. Đầu vào đã lưu vào bộ nhớ cache được giảm giá 95%. Xem giá Gemini 4 Argon.
Argon sẽ hoạt động với generateContent chứ? Google chưa nói. Tài liệu của họ cho biết tất cả các mô hình mới sẽ ra mắt trên Interactions API, vì vậy hãy xây dựng trên Interactions và coi generateContent là phương án dự phòng.
Google AI Ultra có cung cấp cho tôi quyền truy cập API không? Không. AI Ultra là một gói đăng ký dành cho người tiêu dùng, không phải khóa API. Google cho biết quyền truy cập API bắt đầu với các khách hàng API trả phí.
Bước tiếp theo của bạn
Đặt GEMINI_MODEL trong mọi môi trường, lên lịch kiểm tra models.list, và lưu các yêu cầu Interactions và generateContent kèm theo xác nhận chi phí. Tải Apidog để giữ các yêu cầu, mock và thử nghiệm đó trong một không gian làm việc, sau đó thay đổi một biến khi Google công bố ID.