
Con số nổi bật của Gemini 4 Argon, 1 triệu token, là giới hạn đầu ra của nó, không phải cửa sổ ngữ cảnh. Google cho biết một phản hồi duy nhất của Argon có thể đạt tới 1 triệu token, lớn gấp khoảng 16 lần giới hạn 64K trước đó, và họ chưa công bố cửa sổ đầu vào của Argon. Hiện tại cũng chưa có gì để gọi: Argon hiện chỉ dành cho những người tham gia chương trình Fairwind, và sau đó là khách hàng API trả phí khi Google mở quyền truy cập (xem hướng dẫn ngày phát hành và quyền truy cập).
Một phản hồi dài như vậy phá vỡ ba giả định mà hầu hết các ngăn xếp API dựa vào: một cuộc gọi hoàn thành trong vài giây, phần thân nằm gọn trong bộ nhớ và một yêu cầu có chi phí nhỏ, dễ dự đoán. Hướng dẫn này bao gồm chi phí của một phản hồi tối đa, phát trực tuyến, thời gian chờ, giới hạn đầu ra, lưu trữ và cách kiểm tra tất cả những điều đó trong Apidog trước khi có quyền truy cập. Để biết tổng quan về mô hình, xem Gemini 4 Argon là gì; để biết các hình dạng yêu cầu, xem hướng dẫn API Gemini 4 Argon.
1M token đầu ra không phải là cửa sổ ngữ cảnh 1M
Một số trang xếp hạng về Argon mô tả con số 1 triệu là cửa sổ ngữ cảnh, và một tiêu đề gọi đó là “cửa sổ ngữ cảnh lớn hơn 16 lần”. Điều đó hoàn toàn sai. Bài đăng ra mắt của Google cho biết họ đã mở rộng “giới hạn token đầu ra của mô hình lên 1 triệu token dẫn đầu ngành.” Con số 64K đó khớp với giới hạn đầu ra 65.536 token trên Gemini 3.1 Pro Preview, mô hình Pro hàng đầu trước đây của Google.
Đầu vào là một con số riêng mà Google chưa cung cấp. Đánh giá ngữ cảnh dài của họ, được mô tả trong phương pháp đánh giá, đã sử dụng các lời nhắc từ 256K đến 1M token. Đó là một tập hợp con chuẩn, không phải là một thông số kỹ thuật. Cũng có một lưu ý về phía đầu ra: Vals AI liệt kê đầu ra tối đa 262K cho cấu hình Argon mà họ đã thử nghiệm. Google nói giới hạn của mô hình là 1M; ít nhất một nhà đánh giá bên thứ ba đã thấy giới hạn thấp hơn trên điểm cuối mà họ sử dụng.
| Mô hình | Đầu ra tối đa mỗi phản hồi | Cửa sổ đầu vào hoặc ngữ cảnh |
|---|---|---|
| Gemini 4 Argon | 1M (giới hạn được Google công bố) | Chưa công bố |
| Gemini 3.1 Pro Preview | 65,536 | 1,048,576 |
| Gemini 3.8 Flash | 65,536 | 1,048,576 |
| GPT-6 Astra | 128,000 | 1,050,000 (922K đầu vào tối đa) |
| Claude Opus 5.5 | 128K (300K trên Batch với tiêu đề beta) | 1M |
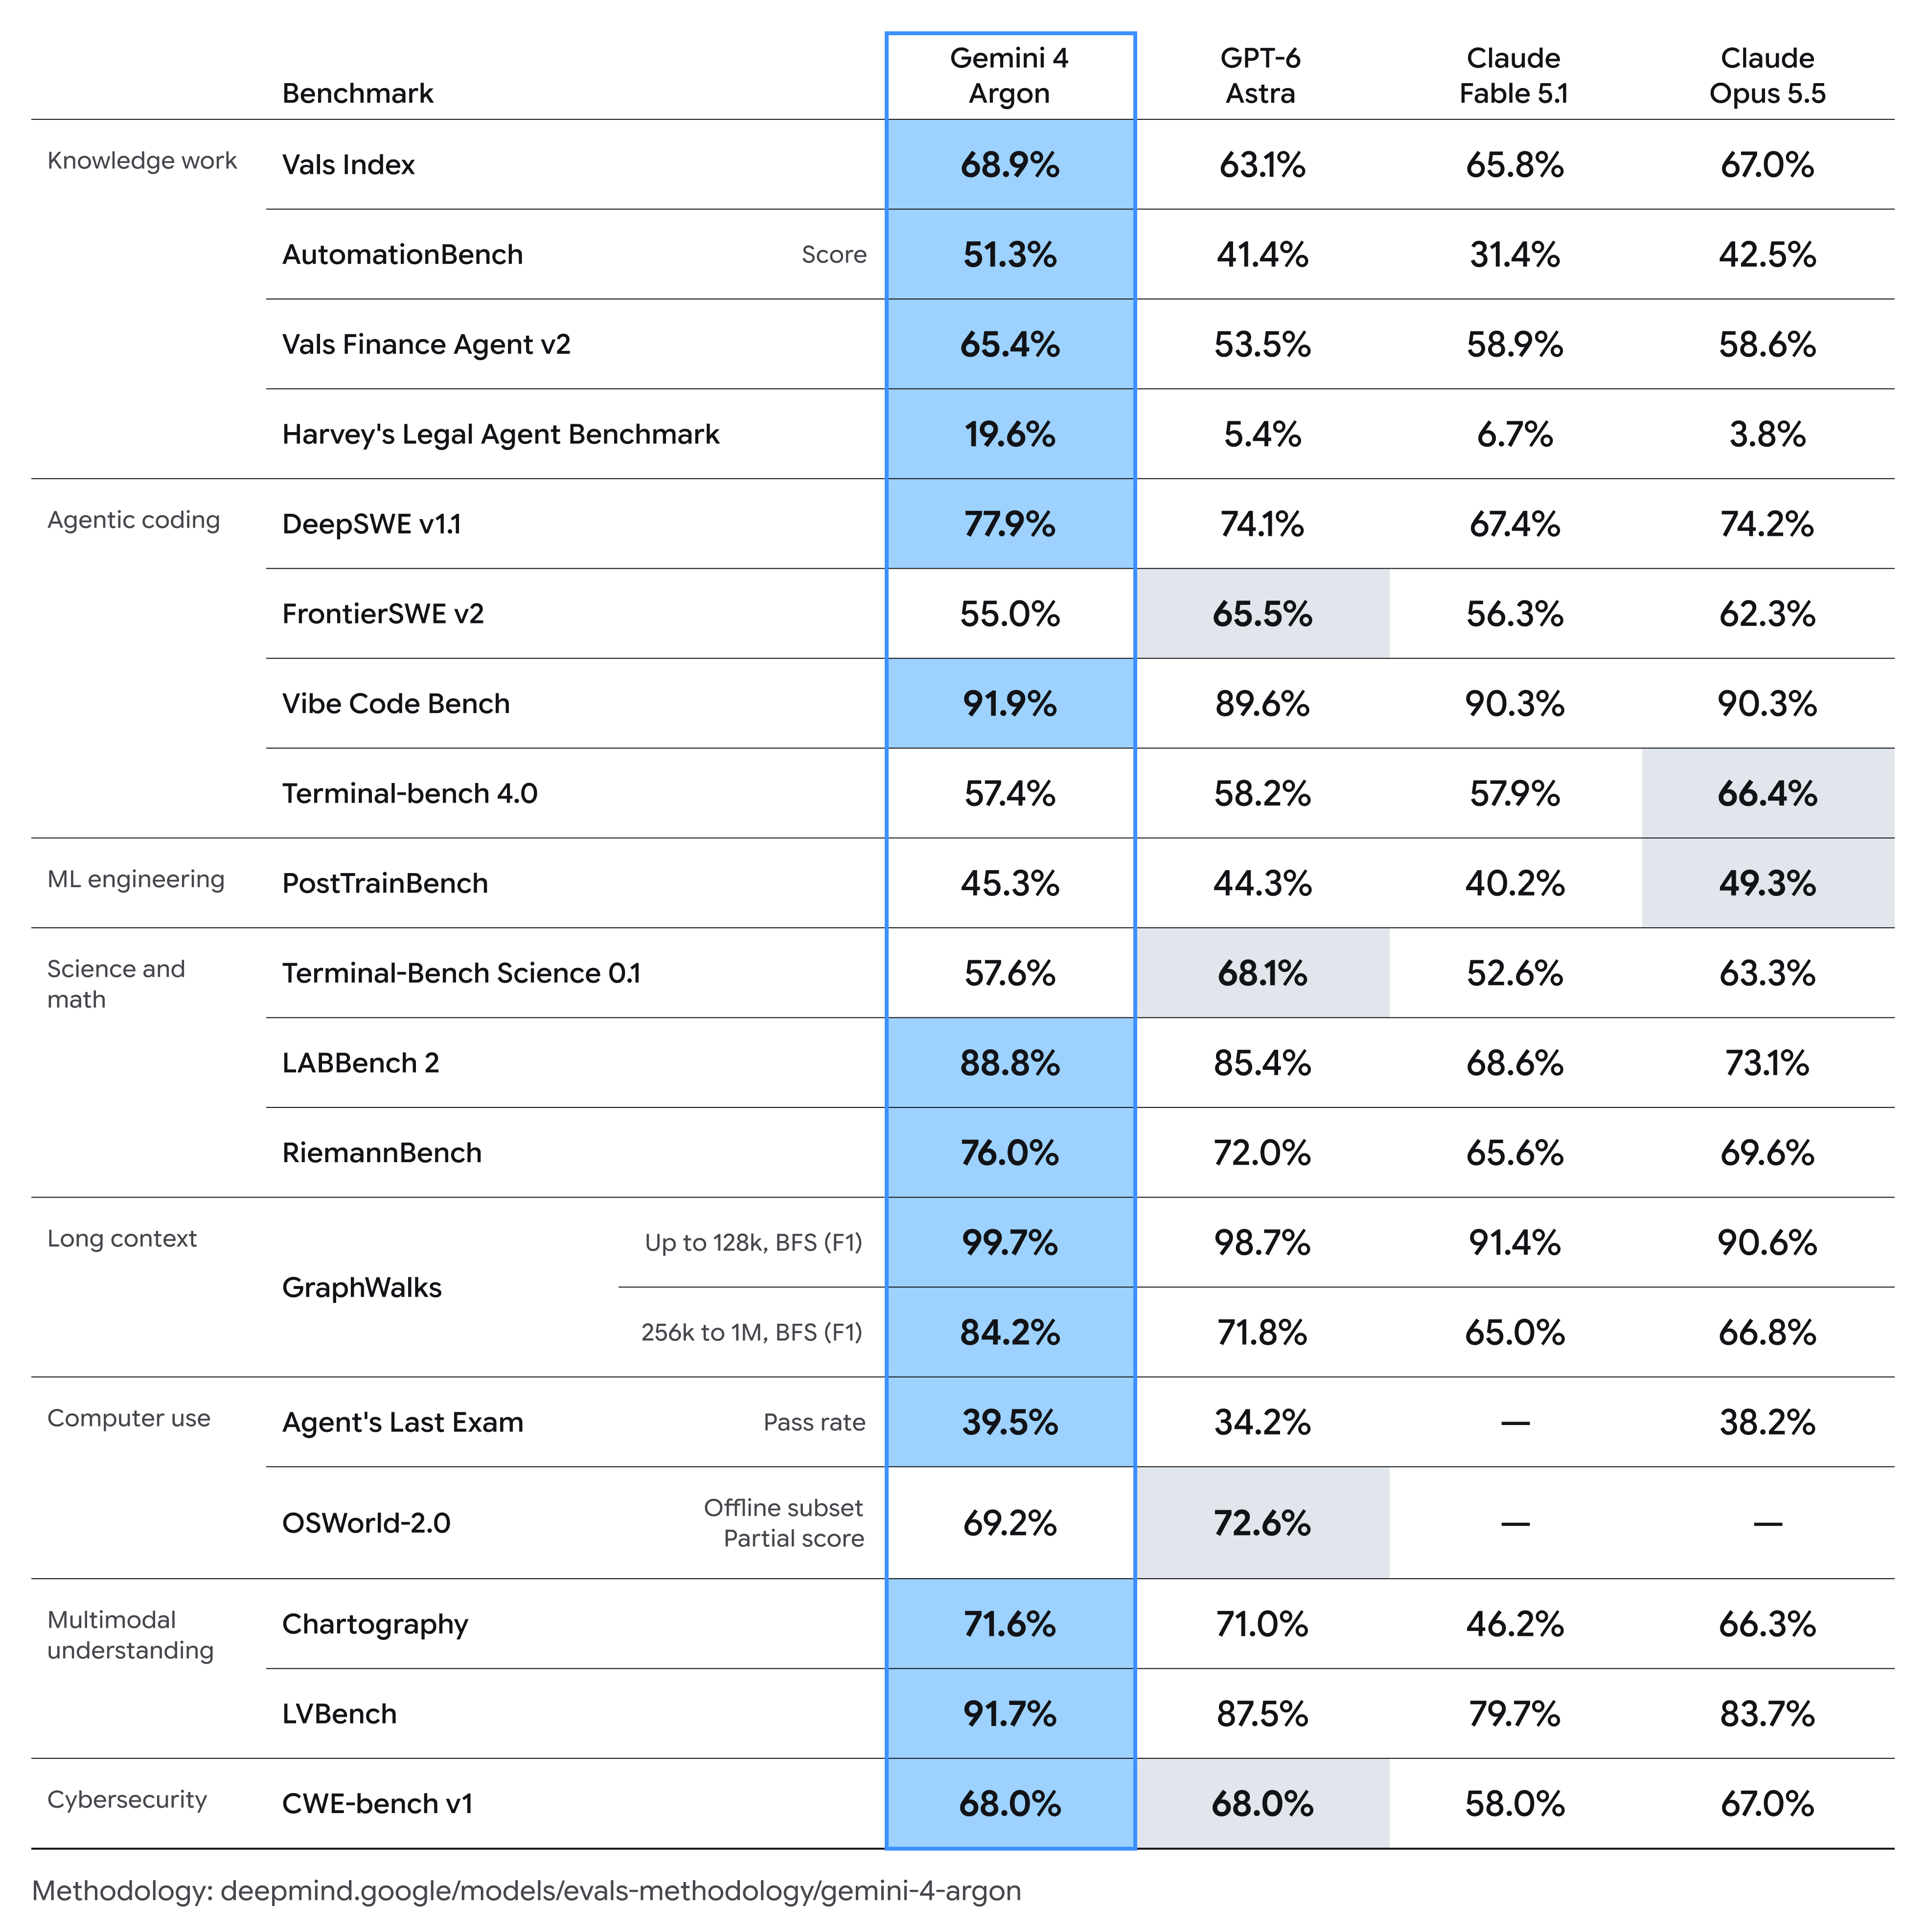
Mọi đối thủ đều giới hạn đầu ra đồng bộ ở 128K, vì vậy giới hạn được công bố của Argon lớn gấp khoảng 8 lần so với họ. Lý do của Google là chiều sâu của suy luận: với khoảng trống, mô hình có thể “tạo ra hàng trăm nghìn token trong một quỹ đạo duy nhất” và giải quyết các vấn đề khó trong một lần. Để biết cách các nhà cung cấp khác xử lý các lần chạy dài, xem các tác vụ 18 giờ của Claude Opus 5.5 và hướng dẫn API GPT-6 Astra.
Chi phí của một phản hồi tối đa
Hãy định giá mức trần trước. Đầu ra được tính phí 10 đô la cho mỗi 1 triệu token trong thời gian giới thiệu của Argon và 20 đô la sau đó, vì vậy một phản hồi đầy đủ có giá:
- Giới thiệu: 1.000.000 x $10/1M = $10,00 đầu ra
- Tiêu chuẩn: 1.000.000 x $20/1M = $20,00 đầu ra
Đầu vào được tính thêm. Một lời nhắc 200.000 token thêm 200.000 x $2/1M = $0,40 theo tỷ lệ giới thiệu hoặc $0,80 theo tỷ lệ tiêu chuẩn, vì vậy một cuộc gọi tối đa duy nhất có giá $10,40 hoặc $20,80. Một công việc hàng đêm chạy 100 cuộc gọi như vậy có giá $1.040 theo tỷ lệ giới thiệu.
Suy nghĩ làm cho điều này khó thấy hơn. Trên các mô hình Gemini hiện tại, token suy nghĩ được tính phí là đầu ra; Google chưa nói liệu Argon có tuân theo quy tắc đó hay không hay liệu suy nghĩ có tính vào giới hạn 1M hay không. Dù bằng cách nào, một câu trả lời ngắn gọn vẫn có thể mang một hóa đơn đầu ra lớn. Hướng dẫn giá Gemini 4 Argon chạy nhiều tình huống hơn, bao gồm đầu vào được lưu vào bộ nhớ cache giảm giá 95%.
Tại sao phát trực tuyến là bắt buộc
Một cuộc gọi không phát trực tuyến sẽ không trả về gì cho đến khi toàn bộ phản hồi hoàn tất. Với hàng trăm nghìn token, đó là một kết nối im lặng dài, và thời gian chờ không hoạt động trong toàn bộ ngăn xếp của bạn có thể đóng nó trước khi byte đầu tiên đến.
Thay vào đó, hãy phát trực tuyến. Trên generateContent, hãy hoán đổi phương thức cho :streamGenerateContent?alt=sse và Google sẽ gửi các sự kiện Server-Sent Events, mỗi khối ứng viên một phần cho mỗi sự kiện. Đọc từng sự kiện khi nó đến và ghi nó ra; đừng thu thập toàn bộ phần thân trước. Điều này chạy trên Gemini 3.8 Flash ngày nay, với mô hình trong một biến vì Google chưa công bố ID mô hình của Argon (thiết lập có trong hướng dẫn API Gemini 3.8 Flash của chúng tôi):
import json, os, requests

MODEL = os.environ.get("GEMINI_MODEL", "gemini-3.8-flash")
URL = ("https://generativelanguage.googleapis.com/v1beta/models/"
       f"{MODEL}:streamGenerateContent?alt=sse")
body = {
    "contents": [{"parts": [{"text": "Write a test plan for every endpoint in a payments API."}]}],
    "generationConfig": {"maxOutputTokens": 60000},
}
usage = None
with requests.post(URL, json=body, stream=True, timeout=(10, 120),
                   headers={"x-goog-api-key": os.environ["GEMINI_API_KEY"]}) as r, \
        open("response.txt", "a", encoding="utf-8") as out:
    r.raise_for_status()
    for line in r.iter_lines(decode_unicode=True):
        if not line or not line.startswith("data:"):
            continue
        event = json.loads(line[5:])
        for cand in event.get("candidates", []):
            for part in cand.get("content", {}).get("parts", []):
                out.write(part.get("text", ""))
        out.flush()
        usage = event.get("usageMetadata", usage)
print(usage)
timeout=(10, 120) đặt thời gian chờ kết nối 10 giây và thời gian chờ đọc 120 giây. Trong requests, thời gian chờ đọc là khoảng cách dài nhất giữa các byte, không phải tổng thời lượng, vì vậy một luồng tiếp tục gửi có thể chạy bao lâu tùy thích. Mỗi khối được ghi vào đĩa khi nó đến. Trên 3.8 Flash, mỗi sự kiện mang theo một usageMetadata đang chạy, vì vậy sự kiện cuối cùng cung cấp cho bạn số lượng token cuối cùng để ghi nhật ký và tính phí.
Thời gian chờ ở mọi điểm dừng
Client của bạn là một điểm dừng. Một luồng dài cũng đi qua một reverse proxy, một API gateway, một bộ cân bằng tải và có thể là một runtime serverless, và bất kỳ trong số chúng đều có thể kết thúc phản hồi sớm:
| Điểm dừng | Điều cần kiểm tra | Triệu chứng khi bị lỗi |
|---|---|---|
| Client HTTP | Thời gian chờ đọc hoặc không hoạt động, cộng với bất kỳ thời gian chờ yêu cầu tổng thể nào | Ngoại lệ giữa luồng chỉ trên các câu trả lời dài |
| Reverse proxy | Thời gian chờ đọc và bộ đệm phản hồi cho text/event-stream |
Các sự kiện đến theo đợt, hoặc luồng bị cắt |
| API gateway | Thời lượng yêu cầu tối đa | Các yêu cầu thất bại ở cùng một thời gian trôi qua mỗi lần chạy |
| Bộ cân bằng tải | Thời gian chờ không hoạt động | Bị ngắt trong các khoảng dừng dài trước sự kiện đầu tiên |
| Hàm Serverless | Thời gian thực thi tối đa | Hàm kết thúc trong khi mô hình vẫn đang ghi |
Hãy tìm một điểm cắt cố định. Nếu các phản hồi dài luôn thất bại ở cùng một thời gian trôi qua, một điểm dừng nào đó có giới hạn thời gian cố định mà phát trực tuyến không thể khắc phục, và công việc đó cần được chuyển ra khỏi đường dẫn yêu cầu.
Chạy các công việc dài trong nền
Đối với các công việc dài nhất, hãy đưa công việc ra khỏi kết nối trực tiếp. API Interactions hỗ trợ thực thi nền cho các tác vụ chạy dài bằng cách sử dụng background=true. Các lần chạy nền phụ thuộc vào các tương tác được lưu trữ: tài liệu nói store=false không tương thích với thực thi nền, vì vậy hãy giữ lưu trữ bật cho các yêu cầu này. Để truy xuất một tương tác nền đã hoàn thành, hãy làm theo tài liệu của Google; đừng đoán các điểm cuối thăm dò. Vì Google nói các mô hình mới ra mắt trên API Interactions, hãy lên kế hoạch cho các công việc dài của Argon chạy ở đó.
Cố ý giới hạn đầu ra
Giới hạn 1M là mức trần, không phải mục tiêu. Trên generateContent, generationConfig.maxOutputTokens giới hạn mỗi phản hồi; ví dụ phát trực tuyến đặt là 60.000. Trên 3.8 Flash, suy nghĩ được tính vào giới hạn đó: lần chạy thử nghiệm của chúng tôi giới hạn ở 2.000 đã trả về 1.340 token suy nghĩ và 656 token hiển thị. Đối với API Interactions, hãy xác nhận trường giới hạn đầu ra trong tài liệu của Google trước khi bạn dựa vào nó. Sau đó, chọn giới hạn từ chi phí bạn sẽ chấp nhận cho mỗi cuộc gọi:
| Giới hạn đầu ra | Chi phí đầu ra trường hợp xấu nhất, tiêu chuẩn ($20/1M) | Giới thiệu ($10/1M) |
|---|---|---|
| 64,000 | 64.000 x $20/1M = $1,28 | $0,64 |
| 128,000 | $2,56 | $1,28 |
| 500,000 | $10,00 | $5,00 |
| 1,000,000 | $20,00 | $10,00 |
Một phản hồi đạt giới hạn sẽ dừng sớm, vì vậy hãy coi đó là chưa hoàn chỉnh. Kiểm tra finishReason của sự kiện cuối cùng: MAX_TOKENS có nghĩa là giới hạn đã cắt nó. Sau đó, tiếp tục trong một lượt theo dõi hoặc tăng giới hạn cho công việc đó.
Lưu trữ và phân tích các đầu ra lớn mà không cần đệm
Một triệu token là hàng megabyte văn bản cho mỗi phản hồi. Một vài quy tắc giúp ngăn chặn điều đó làm sập một worker:
- Ghi các khối khi chúng đến, vào một tệp hoặc tải lên đối tượng multipart, thay vì xây dựng một chuỗi trong bộ nhớ.
- Giữ tệp một phần nếu kết nối bị ngắt. Một lần thử lại mù quáng từ đầu sẽ tạo ra và tính phí lại đầu ra.
- Yêu cầu JSON Lines khi bạn cần cấu trúc, để mỗi dòng được phân tích cú pháp riêng thay vì chờ một tài liệu khổng lồ đóng lại.
- Ghi nhật ký
usageMetadatavà số byte, không phải toàn bộ phần thân. - Kiểm tra giới hạn cột và kích thước thông báo trong cơ sở dữ liệu và hàng đợi của bạn trước khi một câu trả lời 800K token đạt đến chúng.
Kiểm tra trong Apidog trước khi có quyền truy cập
Bạn có thể diễn tập tất cả những điều này với một bản thay thế. Tải xuống Apidog và thực hiện ba lần kiểm tra.
Xem luồng. Gửi yêu cầu phát trực tuyến tới 3.8 Flash với GEMINI_API_KEY và GEMINI_MODEL làm biến môi trường. Apidog phân tích cú pháp các phản hồi text/event-stream và hiển thị từng sự kiện trong chế độ xem Dòng thời gian khi nó đến, để bạn có thể xem kích thước khối, khoảng trống và usageMetadata cuối cùng.
Phát trực tuyến một phản hồi giả dài hơn nhiều. Đầu ra thực của 3.8 Flash đạt tối đa 65.536 token, vì vậy hãy chạy một mô phỏng cục bộ phát trực tuyến nhiều hơn đáng kể với cùng một hình dạng sự kiện:
# long_stream_mock.py: SSE hình dạng Gemini cho các bài kiểm tra phân tích cú pháp và thời gian chờ (dữ liệu giả)
import json, time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

EVENTS, DELAY, CHUNK = 20000, 0.005, "lorem ipsum " * 40

class Handler(BaseHTTPRequestHandler):
    def do_POST(self):
        self.rfile.read(int(self.headers.get("Content-Length", 0)))
        self.send_response(200)
        self.send_header("Content-Type", "text/event-stream")
        self.end_headers()
        for i in range(EVENTS):
            event = {"candidates": [{"content": {"parts": [{"text": CHUNK}]}}]}
            if i == EVENTS - 1:  # fake counts sized like a near-max reply
                event["usageMetadata"] = {"promptTokenCount": 1200,
                    "candidatesTokenCount": 950000, "thoughtsTokenCount": 40000,
                    "totalTokenCount": 991200}
            self.wfile.write(f"data: {json.dumps(event)}\n\n".encode())
            self.wfile.flush()
            time.sleep(DELAY)

ThreadingHTTPServer(("127.0.0.1", 8787), Handler).serve_forever()
Trỏ URL cơ sở của môi trường "mock" đến http://127.0.0.1:8787 và gửi cùng một yêu cầu phát trực tuyến qua đó. Luồng chạy trong khoảng hai phút (128 giây trong thử nghiệm của chúng tôi) và mang theo 9,6 triệu ký tự văn bản, đủ để phát hiện một bộ phân tích cú pháp có bộ đệm, một proxy giữ các sự kiện hoặc thời gian chờ được đặt quá ngắn.
Xác nhận số lượng token. Trên một yêu cầu generateContent không phát trực tuyến, hãy xác nhận rằng candidatesTokenCount cộng với thoughtsTokenCount trong usageMetadata nằm dưới hoặc bằng giới hạn của bạn và rằng chi phí được tính toán nằm dưới mức trần của bạn theo giá Argon. Hướng dẫn API Argon có một tập lệnh tính toán chi phí sẵn có.
Câu hỏi thường gặp
1M có phải là cửa sổ ngữ cảnh của Gemini 4 Argon không? Không. 1M là giới hạn đầu ra cho mỗi phản hồi, tăng từ 64K. Google chưa công bố cửa sổ đầu vào của Argon.
Một phản hồi Argon 1 triệu token có giá bao nhiêu? 10 đô la đầu ra theo giá giới thiệu và 20 đô la theo giá tiêu chuẩn, cộng với đầu vào. Xem giá Gemini 4 Argon để biết thêm các tình huống.
Tôi có thể tạo phản hồi 1 triệu token ngay hôm nay không? Không, trừ khi tổ chức của bạn thuộc nhóm Fairwind có quyền truy cập Argon. Gemini 3.8 Flash và 3.1 Pro Preview giới hạn đầu ra ở 65.536 token, và Vals AI liệt kê đầu ra tối đa 262K cho cấu hình Argon mà họ đã thử nghiệm.
Tôi có phải phát trực tuyến các phản hồi Argon dài không? Google chưa công bố hướng dẫn phát trực tuyến cho Argon, nhưng một cuộc gọi không phát trực tuyến chạy trong nhiều phút sẽ bị ảnh hưởng bởi mọi thời gian chờ không hoạt động trong ngăn xếp của bạn. Hãy phát trực tuyến nó, hoặc sử dụng thực thi nền trên API Interactions.
Giới hạn đầu ra của Argon so với GPT-6 Astra và Claude Opus 5.5 như thế nào? Cả hai đều giới hạn đầu ra đồng bộ ở 128K; Anthropic cho phép 300K trên Batch với tiêu đề beta. Giới hạn 1M được công bố của Argon lớn gấp khoảng 8 lần.
Bước tiếp theo của bạn
Thêm tính năng phát trực tuyến và giới hạn đầu ra vào client Gemini của bạn ngay bây giờ, trên 3.8 Flash, và chạy nó với luồng mô phỏng dài cho đến khi không có gì trong ngăn xếp của bạn cắt nó. Khi ID của Argon được xuất xưởng, hãy thay đổi GEMINI_MODEL và chạy lại các thử nghiệm tương tự trong Apidog.