
Google đã phát hành hai mô hình chuyển đổi giọng nói thành giọng nói mới vào ngày 15 tháng 9 năm 2026, và chủ đề trên Hacker News đã vượt qua 337 điểm trong vòng một ngày. Đó là một phản ứng lớn đối với việc ra mắt API giọng nói, và phần lớn cuộc thảo luận không phải về video demo. Đó là các nhà phát triển hỏi cùng một câu hỏi: chi phí để xây dựng với cái này là bao nhiêu, và làm thế nào để thực sự kết nối với nó?
Đây là hướng dẫn đó. gemini-3.8-live và gemini-3.8-live-extended-thinking hiện đang được triển khai trong Gemini API và Google AI Studio, với quyền truy cập Gemini Enterprise và Search Live trong bản xem trước riêng tư. Cả hai mô hình đều chấp nhận token đầu vào và đầu ra miễn phí bên cạnh một gói trả phí với mức giá theo token và theo phút, điều này khá bất thường đối với một mô hình âm thanh trực tiếp đến mức đáng để xem xét phiên WebSocket, chứ không chỉ trang giá cả. Chúng tôi đã so sánh các trợ lý giọng nói dành cho người tiêu dùng trong GPT-Live vs Gemini Live; bài viết này là con đường dành cho nhà phát triển để tiếp cận API đằng sau một phía của so sánh đó.
Những gì thực sự ra mắt vào ngày 15 tháng 9
Thông báo của Google bao gồm hai mô hình. gemini-3.8-live là mô hình chuyển đổi giọng nói thành giọng nói tiêu chuẩn. gemini-3.8-live-extended-thinking bổ sung một lớp suy luận chạy trong khi mô hình nói, được mô tả dưới đây. Cả hai đều hỗ trợ 97 ngôn ngữ với khả năng chuyển đổi tự động giữa cuộc trò chuyện, nghĩa là người gọi có thể bắt đầu một câu bằng tiếng Anh và kết thúc bằng tiếng Tây Ban Nha mà không cần gắn cờ ngôn ngữ thủ công.
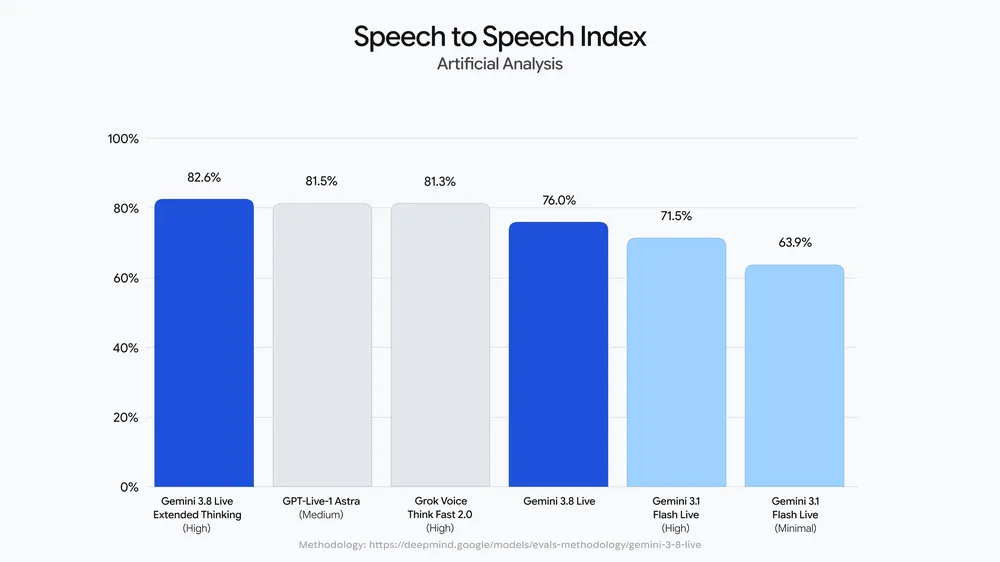
Khả dụng khi ra mắt: Gemini API và Google AI Studio (truy cập chung), cộng với Gemini Enterprise và Search Live (xem trước riêng tư, vì vậy hầu hết các nhà phát triển đọc bài này sẽ bắt đầu với API hoặc AI Studio). Token miễn phí áp dụng cho cả hai mô hình ở cả đầu vào và đầu ra, điều này giúp việc tạo một bản thử nghiệm thực tế trở nên khả thi trước khi bạn cần dùng đến thẻ tín dụng.
Một chi tiết Google chưa công bố: giới hạn tốc độ của gói miễn phí cho hai mô hình Live. Trang giới hạn tốc độ là nguồn thông tin đáng tin cậy khi nó được liệt kê; hãy coi bất kỳ con số nào bạn thấy ở nơi khác là chưa được xác nhận cho đến khi bạn tự kiểm tra ở đó.
Việc truy cập Search Live và Gemini Enterprise chỉ là bản xem trước riêng tư, chứ không phải mở như API, là một tín hiệu đáng đọc: Google cảm thấy thoải mái khi cho phép các nhà phát triển xây dựng dựa trên điều này theo những cách gần với sản xuất trước khi họ cam kết cùng một mô hình cho tìm kiếm người tiêu dùng hoặc các gói doanh nghiệp trả phí. Điều này là bình thường đối với việc triển khai mô hình giọng nói, và điều đó có nghĩa là bề mặt API hiện là điểm khởi đầu ổn định, chứ không phải là bản xem trước rút gọn của một trải nghiệm người dùng tốt hơn sẽ đến sau.
Lấy khóa API miễn phí và mở một phiên
Khóa API Gemini đến từ Google AI Studio, được liên kết với một tài khoản Google, và nó hoạt động với các mô hình Live ngay trong ngày chúng ra mắt vì không có bước phê duyệt riêng cho gói miễn phí. Khi bạn có khóa, điểm kết nối là WebSocket, không phải điểm cuối REST, đây là điều chỉnh đầu tiên nếu bạn đã quen với các lệnh gọi generateContent:
wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent
URL đó đến từ bài viết thực hành của Simon Willison từ ngày ra mắt, được xuất bản cùng với bài đọc kỹ lưỡng về API mới của ông. Ông cũng đã chỉ ra một điều đáng biết trước khi bạn xây dựng giao diện người dùng xung quanh điều này: bạn có thể ngắt lời mô hình giữa chừng phản hồi giống như cách bạn ngắt lời một người đang nói, và bản ghi âm trả về có thể bao gồm những gì mô hình đã bắt đầu tạo nhưng chưa bao giờ hoàn thành việc phát, vì việc phát đã bị cắt bởi sự ngắt lời của bạn. Xử lý điều đó như một trạng thái riêng biệt trong client của bạn thay vì giả định rằng mọi dòng bản ghi âm đều được nghe đầy đủ.
Một phiên hai chiều qua socket đó tuân theo hình dạng mà mọi API streaming dựa trên WebSocket sử dụng: trước tiên là một thông báo thiết lập, xác định mô hình và cấu hình tạo của nó, sau đó là một luồng thông báo nội dung mang các đoạn âm thanh hoặc văn bản theo cả hai hướng, với máy chủ đẩy lại các phân đoạn phản hồi một phần và cuối cùng khi chúng sẵn sàng. Lược đồ thông báo chính xác là do Google tài liệu hóa một cách chính xác, và nó có thể thay đổi giữa bản xem trước và tính khả dụng chung, vì vậy hãy xác minh tên trường với tài liệu Gemini API trực tiếp và tài liệu tham khảo cho SDK của bạn trước khi bạn cam kết với một client sản xuất. Điều ổn định là mẫu: kết nối, gửi thiết lập, truyền nội dung, đọc phản hồi được truyền, và mong đợi việc ngắt lời là một sự kiện bình thường chứ không phải là một trường hợp lỗi.
Thực tế, điều đó có nghĩa là phiên làm việc đầu tiên của bạn nên hướng tới vòng lặp nhỏ nhất có thể: mở socket, gửi một thông báo thiết lập duy nhất đặt tên mô hình bạn muốn (gemini-3.8-live hoặc gemini-3.8-live-extended-thinking), gửi một lượt âm thanh hoặc văn bản ngắn duy nhất, và xác nhận rằng bạn nhận được phản hồi được truyền về trước khi thêm logic thử lại, xử lý kết nối lại hoặc giao diện người dùng. Xây dựng đường dẫn ngắt lời sau, khi đường dẫn chính đã hoạt động, vì việc kiểm tra nó tốt có nghĩa là cố ý nói đè lên mô hình giữa chừng phản hồi và kiểm tra xem client của bạn có đánh dấu chính xác bản ghi âm bị cắt hay không thay vì coi đó là một lượt hoàn chỉnh.
Suy nghĩ mở rộng: khi quá trình suy luận diễn ra thành lời
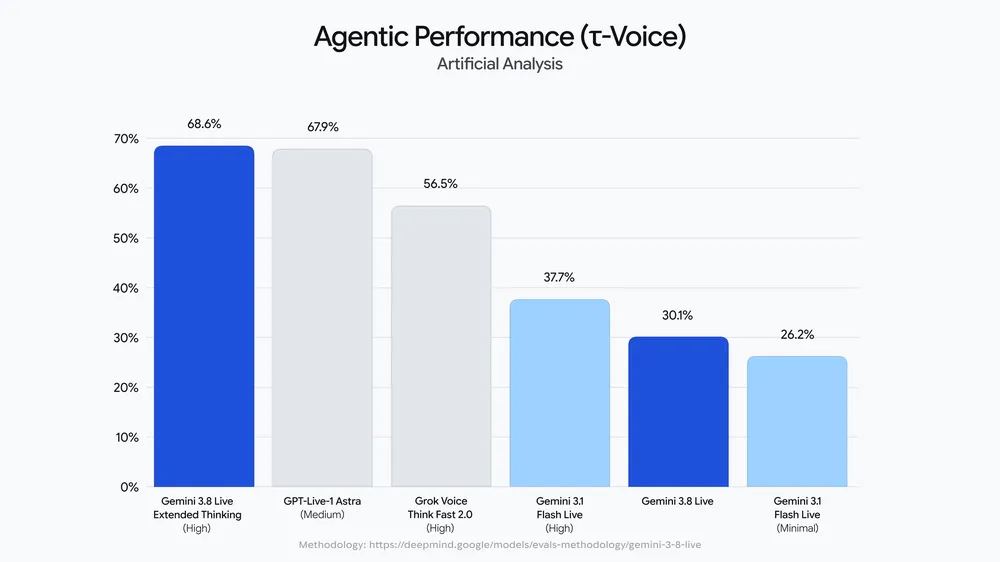
Mô hình gemini-3.8-live thông thường sẽ trả lời trực tiếp. gemini-3.8-live-extended-thinking làm điều gì đó khác biệt: Google nói rằng nó "suy luận và nói đồng thời", duy trì cái mà họ gọi là "luồng hội thoại không bị gián đoạn" bằng cách lấp đầy thời gian suy luận bằng các tín hiệu lời nói, các cụm từ như "Để tôi kiểm tra" thay vì im lặng trong khi mô hình làm việc.
Điều đó quan trọng đối với một loại ứng dụng cụ thể: các tác nhân giọng nói gọi công cụ hoặc truy cập API bên ngoài giữa cuộc trò chuyện. Mô hình suy nghĩ mở rộng "thực thi các công cụ và lệnh gọi API trong nền trong khi tiếp tục cuộc trò chuyện," và chức năng gọi hàm được hỗ trợ trên cả hai mô hình. Hãy hình dung một nhân viên đặt vé cần kiểm tra tình trạng còn chỗ so với API lịch: thay vì im lặng trong hai giây trong khi quá trình tìm kiếm diễn ra, mô hình có thể xác nhận yêu cầu bằng lời và tiếp tục cuộc trao đổi trong khi lệnh gọi hoàn tất phía sau.
Chọn suy nghĩ mở rộng khi phiên của bạn bao gồm các lệnh gọi công cụ, tra cứu nhiều bước hoặc các câu trả lời nặng về suy luận mà một khoảng lặng sẽ tạo cảm giác bị ngắt quãng. Chọn mô hình thông thường cho các cuộc trao đổi ngắn hơn, độ trễ thấp mà không cần đến chi phí suy luận. Cả hai đều có giá như nhau trên mỗi token, vì vậy lựa chọn là về hành vi, không phải ngân sách. Nếu tác nhân của bạn đặc biệt dựa vào việc gọi hàm, hướng dẫn gọi hàm cho Gemini 3.8 Flash của chúng tôi bao gồm cấu trúc yêu cầu mà Google sử dụng trên dòng Gemini 3.8 hiện tại, mặc dù hãy xác nhận tải trọng gọi hàm cụ thể cho Live với tài liệu API Live trước khi triển khai, vì các API văn bản và giọng nói không được đảm bảo sẽ chia sẻ cùng một lược đồ.
Chi phí, tính toán
Cả hai mô hình Live đều có chung mức giá tiêu chuẩn:
| Loại | Mức giá |
|---|---|
| Đầu vào văn bản | $0.75 trên 1 triệu token |
| Đầu vào âm thanh | $3.00 trên 1 triệu token, hoặc $0.005 mỗi phút |
| Đầu vào hình ảnh/video | $1.00 trên 1 triệu token, hoặc $0.002 mỗi phút |
| Đầu ra văn bản | $4.50 trên 1 triệu token |
| Đầu ra âm thanh | $12.00 trên 1 triệu token, hoặc $0.018 mỗi phút |
Các token suy nghĩ được tính phí như đầu ra, giống như mọi mô hình Gemini 3.x khác, vì vậy quá trình suy luận nền của "suy nghĩ mở rộng" (extended thinking) sẽ xuất hiện trên dòng đầu ra chứ không phải là một khoản phí riêng biệt.
Ví dụ minh họa: một cuộc gọi thoại dài 10 phút, âm thanh vào và âm thanh ra liên tục, trên gói trả phí tiêu chuẩn. Đầu vào âm thanh: 10 phút x $0.005 = $0.05. Đầu ra âm thanh: 10 phút x $0.018 = $0.18. Tổng cộng: $0.23 cho một cuộc trò chuyện đầy đủ 10 phút qua lại, trước khi có bất kỳ token văn bản hoặc gọi công cụ nào được thêm vào. Chạy cùng cuộc gọi đó trên gói miễn phí trong quá trình tạo mẫu thì chi phí token là không, tùy thuộc vào giới hạn tốc độ mà Google cuối cùng sẽ công bố cho nó.
Mô hình gemini-3.1-flash-live-preview trên cùng trang giá có mức giá giống hệt với cả hai mô hình Live mới, điều này đáng để kiểm tra nếu bạn đã có tích hợp Live trên mô hình cũ hơn đó; quyết định về giá không phải là lý do để trì hoãn việc di chuyển.
Những gì các nhà phát triển đang nói, cho đến nay
Thảo luận trên Hacker News không hoàn toàn tích cực. Một lời phàn nàn thường xuyên: người đăng ký Google Workspace trả phí và Google AI Plus vẫn chưa có quyền truy cập người dùng vào trải nghiệm Live mới, mặc dù họ là khách hàng trả tiền, trong khi quyền truy cập API và AI Studio lại mở. Một báo cáo từ chủ đề đã mô tả một vòng lặp tác nhân nơi mô hình đã tự tạo ra các yêu cầu bổ sung không thuộc nhiệm vụ ban đầu, một chế độ lỗi đáng để kiểm tra cụ thể nếu bạn đang kết nối Live vào một tác nhân tự động thay vì một trợ lý giọng nói có sự can thiệp của con người. Nếu bạn đang xây dựng bất cứ thứ gì gần với một vòng lặp tự động hơn là một trợ lý được giám sát, hãy thêm một kiểm tra rõ ràng so sánh những gì mô hình tuyên bố nó cần với định nghĩa nhiệm vụ bạn đã cung cấp cho nó, thay vì tin tưởng vào các yêu cầu được nêu của mô hình một cách mù quáng. Hãy coi cả hai điểm này là tín hiệu ngày đầu từ một chủ đề duy nhất, không phải là báo cáo lỗi đã được xác minh, và kiểm tra lại với trường hợp sử dụng của riêng bạn trước khi bạn khái quát hóa từ chúng.
Xem giao thức thô trước khi bạn viết mã client
Trước khi cam kết với một thư viện client, việc xem các khung thực tế truyền qua đường truyền sẽ rất hữu ích. Apidog có thể mở kết nối WebSocket đến điểm cuối BidiGenerateContent, gửi thông báo thiết lập JSON và các thông báo nội dung tiếp theo bằng tay, và hiển thị cho bạn các khung được truyền về theo thời gian thực, đây là cách nhanh nhất để hiểu mẫu thiết lập-rồi-truyền trước khi bạn viết một dòng mã SDK nào xung quanh nó. Apidog không ghi lại âm thanh micro cho bạn; bạn tự cung cấp các payload âm thanh hoặc văn bản và sử dụng kết nối để kiểm tra những gì máy chủ gửi lại, xác nhận thông báo thiết lập của bạn được chấp nhận, và xem cách ngắt lời hoạt động trước khi bạn xây dựng cơ chế xử lý lỗi cho nó trong sản xuất. Tài liệu tham khảo giao thức đầy đủ để xây dựng và kiểm thử các API WebSocket theo cách này có tại docs.apidog.com. Tải Apidog để tự mình thử kết nối trước khi xây dựng client đầu tiên của bạn.
Để so sánh, bài phân tích WebSocket vs WebRTC của chúng tôi đề cập đến lý do Google chọn WebSocket cho luồng hai chiều này thay vì đường dẫn WebRTC mà một số API giọng nói cạnh tranh sử dụng, và ý nghĩa của sự đánh đổi đó đối với các client trình duyệt nói riêng.
FAQ
API Gemini 3.8 Live có miễn phí không? Có, đối với cả hai mô hình, token đầu vào và đầu ra đều miễn phí ở gói miễn phí. Mức giá tiêu chuẩn trả phí sẽ áp dụng khi bạn vượt quá giới hạn tốc độ mà Google đặt ra, và giới hạn gói miễn phí đó chưa được công bố, vì vậy hãy kiểm tra trực tiếp trang giới hạn tốc độ.
Sự khác biệt giữa hai mô hình mới là gì? gemini-3.8-live trả lời trực tiếp. gemini-3.8-live-extended-thinking suy luận trong khi nói, sử dụng các từ đệm để che giấu các lệnh gọi công cụ nền và tra cứu nhiều bước, với cùng mức giá token.
Tôi có cần WebRTC để sử dụng cái này không? Không. API dựa trên WebSocket, kết nối đến một điểm cuối BidiGenerateContent thay vì kết nối ngang hàng WebRTC.
Tôi có thể kiểm tra cái này mà không cần viết client không? Có. Mở WebSocket trong Apidog, gửi các thông báo thiết lập và nội dung thủ công, và đọc phản hồi được truyền trước khi xây dựng một client thực tế xung quanh nó.