
Đây là quyết định ngay từ đầu. Hãy chọn Gemini 3.5 Flash-Lite khi bạn đang chạy các tác vụ đơn giản với khối lượng lớn và bạn quan tâm nhất đến chi phí và tốc độ: phân loại, trích xuất, trả lời chat ngắn, trả lời RAG, tự động hoàn thành. Hãy chọn Gemini 3.6 Flash khi chất lượng quan trọng hơn hóa đơn: các tác nhân đa bước, sử dụng công cụ, lập trình, sử dụng máy tính và các câu trả lời mà một kết quả sai sẽ rất tốn kém.
Cả hai model đều được phát hành trong đợt làm mới Flash-tier của Google vào ngày 21 tháng 7 năm 2026. Cả hai đều chấp nhận tối đa 1M token đầu vào. Chúng nằm ở các điểm khác nhau trên cùng một đường cong, vì vậy câu hỏi thực sự không phải là model nào "tốt hơn". Mà là sự đánh đổi nào phù hợp với công việc bạn đang thực hiện.
Một điểm đặc biệt về tên gọi cần làm rõ trước: model chủ lực đã nhảy lên 3.6, nhưng tier Lite vẫn giữ ở 3.5. Vì vậy, bạn đang so sánh một model 3.5 với một model 3.6, và điều đó là đúng như mong đợi, không phải lỗi đánh máy. Chi tiết hơn về vấn đề này có trong mục Câu hỏi thường gặp (FAQ).
Câu trả lời ngắn gọn
Mặc định sử dụng Flash-Lite cho bất kỳ tác vụ đơn giản nào bạn chạy hàng triệu lần, và chuyển sang 3.6 Flash ngay khi tác vụ đó cần suy luận, công cụ hoặc mã. Nếu bạn không thể quyết định, hãy bắt đầu với Flash-Lite, quan sát những chỗ câu trả lời còn thiếu sót, và chỉ chuyển những yêu cầu đó lên 3.6 Flash. Bạn hiếm khi cần một model duy nhất cho toàn bộ ứng dụng.
Giá cả và tốc độ song song
| Thuộc tính | Gemini 3.5 Flash-Lite | Gemini 3.6 Flash |
|---|---|---|
| ID Model | gemini-3.5-flash-lite |
gemini-3.6-flash |
| Giá đầu vào | $0.30 / 1M token | $1.50 / 1M token |
| Giá đầu ra | $2.50 / 1M token | $7.50 / 1M token |
| Thông lượng | ~350 token đầu ra/giây | Không công bố riêng |
| Cửa sổ ngữ cảnh | 1M token | 1M token |
| Gói miễn phí | Có (giới hạn tốc độ) | Có (giới hạn tốc độ) |
Flash-Lite rẻ hơn trên mỗi token. Đầu vào rẻ hơn 5 lần; đầu ra rẻ hơn 3 lần. Google công bố thông lượng khoảng 350 token đầu ra mỗi giây cho Flash-Lite, điều này giúp nó mang lại cảm giác tức thì trong hộp chat hoặc trường tự động hoàn thành. Google không công bố con số token mỗi giây riêng cho 3.6 Flash, nhưng 3.6 Flash tạo ra ít hơn khoảng 17% token đầu ra so với 3.5 Flash mà nó thay thế, vì vậy nó hoàn thành công việc đa bước nhanh hơn so với giá niêm yết. Bạn có thể xác nhận mức giá hiện tại trên trang giá API Gemini và trong phân tích giá Gemini 3.6 Flash của chúng tôi.
Chất lượng và các tiêu chuẩn đánh giá
Khoảng cách về giá mang lại cho bạn không gian rộng rãi hơn với các tác vụ khó. Trên Terminal-Bench 2.1, một tiêu chuẩn đo lường công việc tác nhân trên terminal, Flash-Lite đạt 54 điểm và 3.6 Flash đạt 78.0 điểm. Chênh lệch 24 điểm đó chính là toàn bộ câu chuyện: đối với các công việc đa bước thực sự, được điều khiển bằng công cụ, 3.6 Flash là model mạnh hơn một cách rõ rệt.
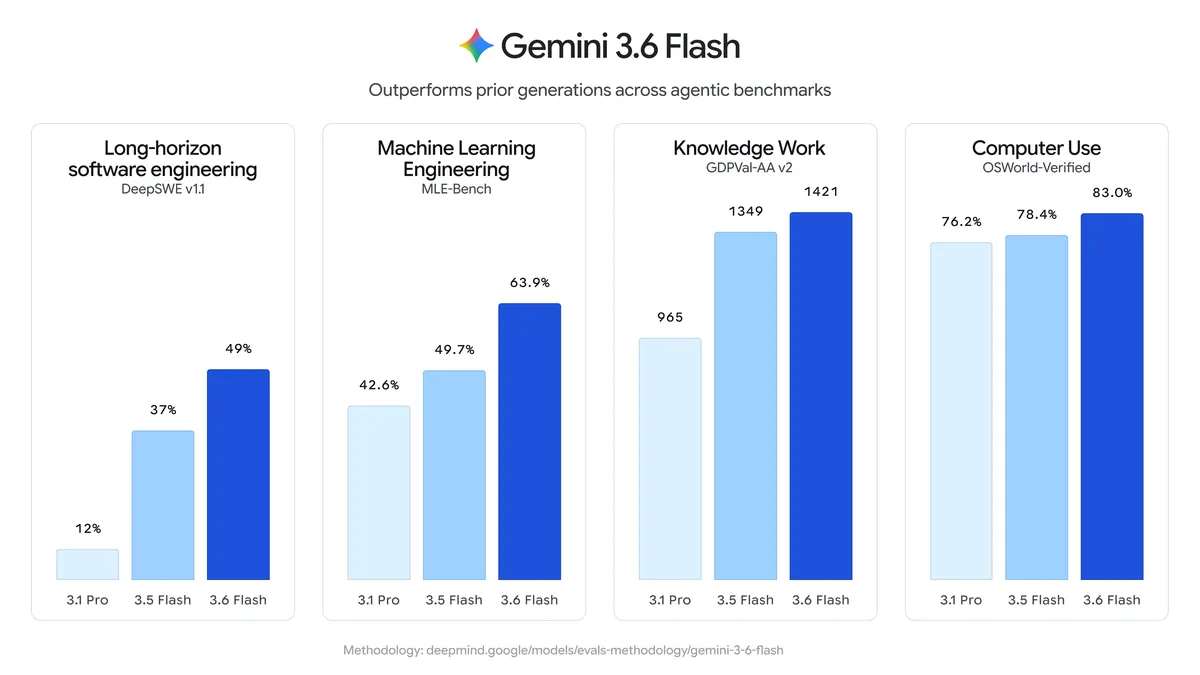
3.6 Flash cũng đạt 83.0 điểm trên OSWorld-Verified, tiêu chuẩn đánh giá việc sử dụng máy tính đo lường khả năng điều khiển trình duyệt hoặc máy tính để bàn thực tế. Flash-Lite không nhắm mục tiêu vào kỹ năng đó. Nếu khối lượng công việc của bạn liên quan đến việc nhấp chuột trên màn hình, đó là công việc dành cho 3.6 Flash. Cụ thể về lập trình, 3.6 Flash đạt 58.7% trên SWE-Bench Pro và 49% trên DeepSWE v1.1, những điểm số này đưa nó vào lĩnh vực lập trình tác nhân thực thụ. Flash-Lite không nhắm vào công việc đó.
Cần phải công bằng với Flash-Lite ở đây. Điểm 54 của nó trên Terminal-Bench 2.1 đã tăng từ 31 so với thế hệ Lite trước, vì vậy tier giá rẻ đã trở nên có khả năng hơn nhiều trong đợt này. Nó không phải là một model yếu. Nó là một model được tinh chỉnh cho một công việc khác: suy luận nhanh, rẻ, đủ tốt cho các tác vụ không phân nhánh. Trang model Flash của Google và thông báo ra mắt định hình hai model này theo cùng một cách: một tier cho khối lượng, một tier cho chiều sâu.
Model nào phù hợp cho công việc nào
Sử dụng bảng này làm ma trận khởi đầu, sau đó điều chỉnh bằng các đánh giá của riêng bạn.
| Nhiệm vụ | Phù hợp nhất |
|---|---|
| Phân loại hoặc trích xuất khối lượng lớn | Flash-Lite |
| Trợ lý trò chuyện và phản hồi ngắn | Flash-Lite |
| Trả lời RAG dựa trên ngữ cảnh đã truy xuất | Flash-Lite |
| UX kiểu tự động hoàn thành, độ trễ quan trọng | Flash-Lite |
| Hệ thống xử lý quy mô tìm kiếm, cho mọi yêu cầu | Flash-Lite |
| Tác nhân đa bước | 3.6 Flash |
| Sử dụng công cụ và chuỗi gọi hàm | 3.6 Flash |
| Viết mã và đánh giá mã | 3.6 Flash |
| Sử dụng máy tính (trình duyệt hoặc máy tính để bàn) | 3.6 Flash |
| Các câu trả lời có rủi ro cao, nơi lỗi tốn kém tiền bạc | 3.6 Flash |
Quy tắc rất đơn giản. Flash-Lite thắng thế khi tác vụ hẹp và khối lượng lớn. 3.6 Flash thắng thế khi tác vụ phân nhánh và chi phí sai sót cao. Một model gắn thẻ các yêu cầu hỗ trợ theo danh mục mười triệu lần một ngày thuộc về Flash-Lite. Một model đọc dấu vết ngăn xếp, chỉnh sửa ba tệp và mở yêu cầu kéo thuộc về 3.6 Flash. Nếu bạn đang cân nhắc điều này so với 3.5 Flash cũ thay vì Flash-Lite, so sánh 3.6 Flash vs 3.5 Flash của chúng tôi sẽ đề cập đến lộ trình nâng cấp đó.
So sánh chi phí trên cùng một khối lượng công việc
Các con số làm cho sự đánh đổi trở nên cụ thể. Giả sử một công việc hàng ngày gửi 10M token đầu vào và tạo ra 2M token đầu ra, một hình dạng điển hình cho một quy trình tóm tắt hoặc trích xuất hàng loạt.
| Model | Đầu vào (10M) | Đầu ra (2M) | Tổng cộng hàng ngày |
|---|---|---|---|
| Flash-Lite | $3.00 | $5.00 | $8.00 |
| 3.6 Flash | $15.00 | $15.00 | $30.00 |
Với sự kết hợp đó, 3.6 Flash tốn kém hơn 3.75 lần: 8.00 đô la so với 30.00 đô la một ngày, hoặc khoảng 240 đô la so với 900 đô la một tháng cho cùng khối lượng.
Tuy nhiên, bội số này không cố định. Bởi vì Flash-Lite rẻ hơn 5 lần đối với đầu vào và rẻ hơn 3 lần đối với đầu ra, khoản tiết kiệm thực tế của bạn nằm ở đâu đó giữa 3 lần và 5 lần tùy thuộc vào hình dạng lưu lượng truy cập của bạn. Công việc nặng về đầu vào (ngữ cảnh RAG dài, tài liệu lớn, phân loại đầu vào lớn) nghiêng về phía 5 lần, và đó chính xác là những khối lượng công việc mà Flash-Lite được xây dựng cho. Việc tạo ra đầu ra nặng nề nghiêng về phía 3 lần.
Vì vậy, câu hỏi thực sự không chỉ là "liệu 3.6 Flash có thể làm được điều này không?" Mà là "liệu chất lượng tăng lên có đáng để trả thêm 3 đến 4 lần mỗi cuộc gọi, với khối lượng của tôi không?" Đối với một quy trình quy mô tìm kiếm, câu trả lời thường là không. Đối với một tác nhân chỉnh sửa mã hoặc gửi một yêu cầu, câu trả lời thường là có.
Cách thực hiện A/B test cả hai trong Apidog
Bạn không cần phải đoán xem tier nào là đủ tốt. API Gemini là một điểm cuối REST đơn giản, vì vậy bạn có thể gửi cùng một lời nhắc đến cả hai model và so sánh các phản hồi trực tiếp. Apidog là một công cụ client API được xây dựng chính xác cho loại kiểm tra song song này.
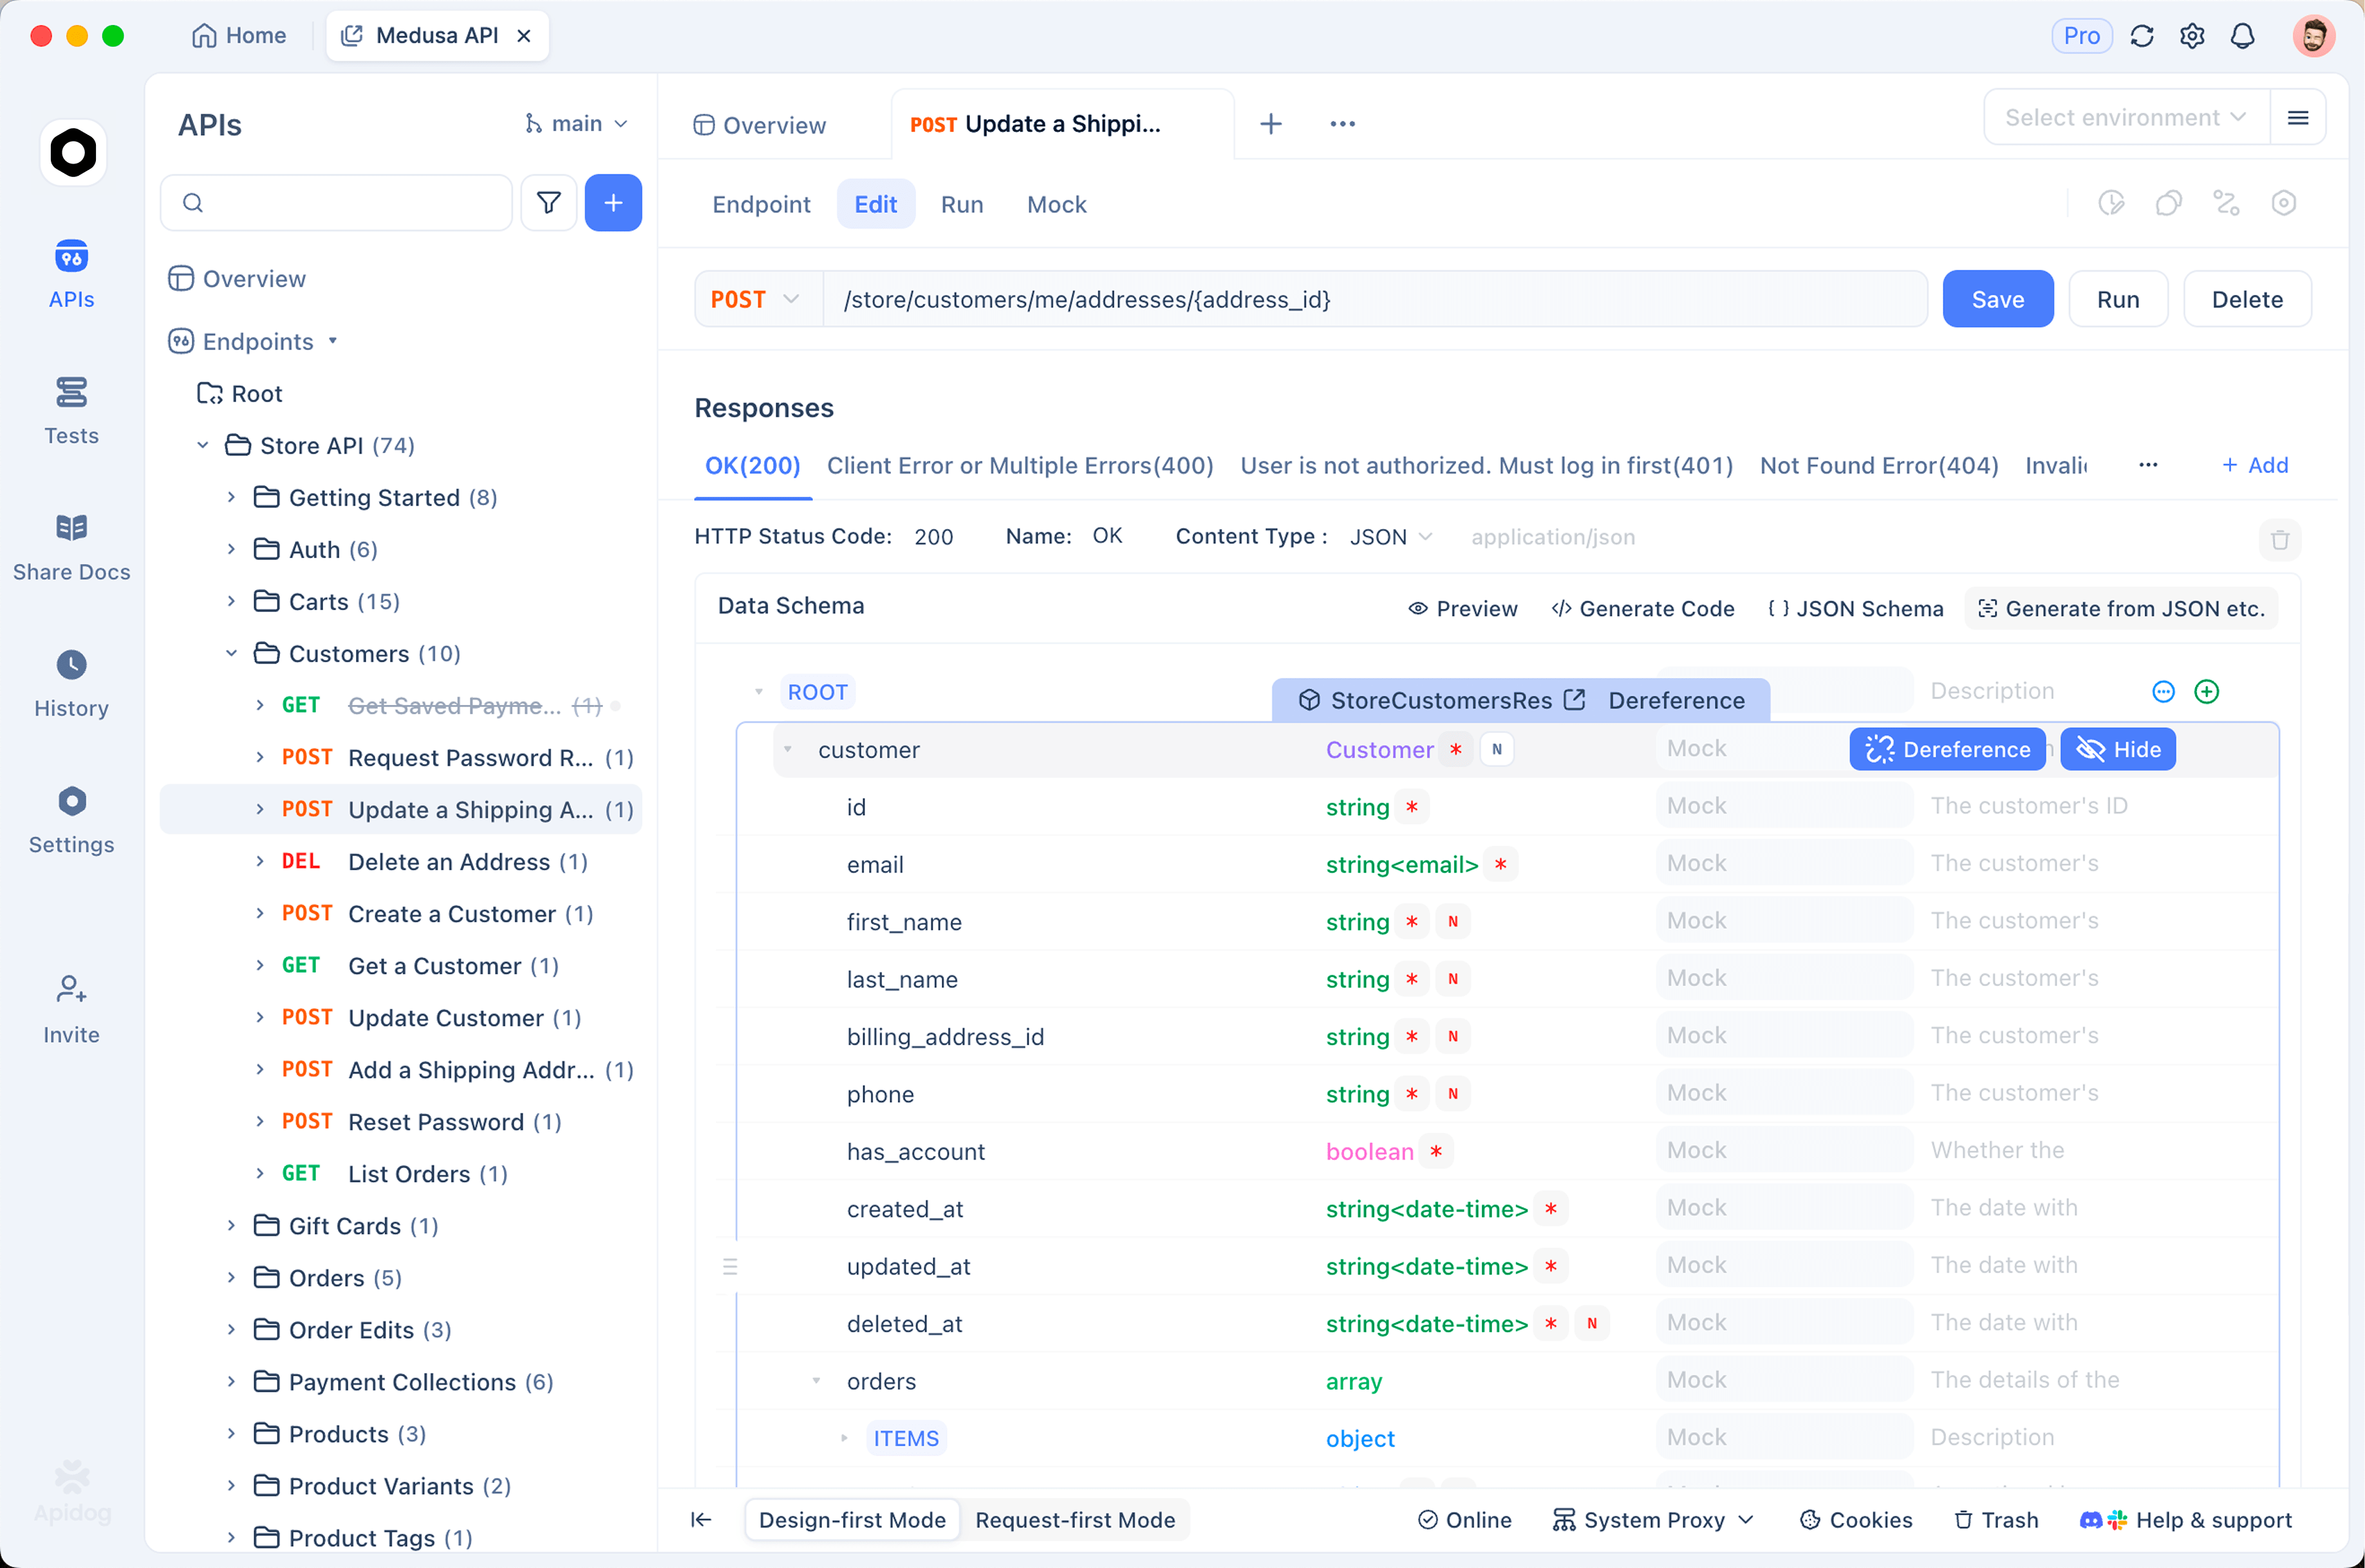
Đây là một quy trình làm việc chỉ mất vài phút:
- Tạo yêu cầu POST tới điểm cuối API của Gemini và lưu khóa API của bạn vào biến môi trường của Apidog, để khóa không bao giờ nằm trong phần thân yêu cầu hoặc trong hệ thống kiểm soát phiên bản.
- Gửi một lần với model được đặt thành
gemini-3.5-flash-lite. Ghi chú phản hồi và độ trễ mà Apidog báo cáo. - Nhân đôi yêu cầu và thay đổi một thứ: ID model thành
gemini-3.6-flash. Cùng một lời nhắc, cùng một tham số, vì vậy biến duy nhất là model. - So sánh chất lượng của hai phản hồi, và so sánh thời gian mà Apidog ghi lại cho mỗi lần gọi.
- Thêm các khẳng định về phản hồi (mã trạng thái, các trường JSON dự kiến, nội dung yêu cầu) để "đủ tốt" được xác định bằng một kiểm tra, chứ không phải bằng mắt thường.
Khi các yêu cầu đã tồn tại, hãy lưu chúng và biến chúng thành một bài kiểm tra có thể lặp lại. Bạn có thể lên lịch các bài kiểm tra API trong Apidog để chạy lại các lời nhắc tương tự theo định kỳ, điều này giúp phát hiện sự thay đổi về chất lượng hoặc độ trễ khi Google cập nhật bất kỳ model nào. Hãy rõ ràng về ranh giới: Apidog gửi các yêu cầu và kiểm tra các khẳng định của bạn, nhưng nó không chạy model và nó sẽ không cho bạn biết câu trả lời nào thông minh hơn. Phán đoán đó vẫn thuộc về bạn. Để làm theo, hãy tải xuống Apidog và trỏ một yêu cầu đến điểm cuối Gemini.
Câu hỏi thường gặp
Flash-Lite có phải chỉ là phiên bản tệ hơn của 3.6 Flash không? Không. Đó là một điểm khác trên đường cong chi phí, chất lượng và tốc độ. Flash-Lite rẻ hơn và nhanh hơn với giới hạn thấp hơn về khả năng suy luận khó; 3.6 Flash đắt hơn và suy luận tốt hơn. Đối với các tác vụ đơn giản, khối lượng lớn, Flash-Lite thường là lựa chọn đúng đắn chính xác vì nó rẻ hơn và nhanh hơn, chứ không phải bất chấp điều đó.
Tại sao một cái được gọi là 3.5 và cái kia là 3.6? Phiên bản hỗn hợp. Trong đợt làm mới này, Google đã chuyển model Flash chủ lực lên 3.6 nhưng vẫn giữ tier Lite ở 3.5 (cùng bản phát hành đó cũng bao gồm model bảo mật 3.5 Flash Cyber). Cùng một họ, số phiên bản khác nhau. Đừng hiểu 3.5 trên Flash-Lite là "cũ và bị bỏ rơi".
Chúng có cùng cửa sổ ngữ cảnh không? Có. Cả hai đều chấp nhận tối đa 1M token đầu vào, vì vậy lời nhắc ngữ cảnh dài không phải là lý do để chọn cái này hơn cái kia. Thay vào đó, hãy chọn dựa trên chất lượng suy luận, giá cả và tốc độ.
Tôi có thể sử dụng cả hai trong một ứng dụng không? Đó là mô hình được khuyến nghị. Chuyển các cuộc gọi rẻ, đơn giản, khối lượng lớn đến Flash-Lite và nâng cấp các cuộc gọi khó đến 3.6 Flash. Vì cấu trúc API giống hệt nhau, việc chuyển đổi chỉ là thay đổi một trường, điều này giúp việc chạy A/B test Apidog ở trên diễn ra nhanh chóng.
Chúng có miễn phí để dùng thử không? Cả hai đều có gói miễn phí trong Google AI Studio, bị giới hạn tốc độ và Google có thể sử dụng dữ liệu từ gói miễn phí để cải thiện sản phẩm của mình. Điều đó tốt cho việc thử nghiệm; hãy đọc các điều khoản trước khi bạn gửi bất kỳ thông tin nhạy cảm nào.
Tóm lại
Hãy chọn Flash-Lite làm mặc định cho các công việc đơn giản, nhanh, rẻ ở quy mô lớn, và chuyển các cuộc gọi khó, phân nhánh hoặc nặng mã đến 3.6 Flash, nơi khoảng cách 24 điểm trên Terminal-Bench chứng minh mức giá gấp 3 đến 4 lần của nó. Đừng chọn một cách trừu tượng: hãy gửi các lời nhắc thực tế của bạn đến cả hai, đo lường chất lượng và độ trễ, và để các con số quyết định. Apidog biến việc so sánh đó thành một công việc chỉ cần hai yêu cầu.