DeepSeek đã công bố thẻ mô hình cho DeepSeek-V4.1-Flash vào ngày 10 tháng 9 năm 2026, và các con số này gây khó chịu cho khách hàng của V4-Pro. Mô hình nhỏ hơn, rẻ hơn này đạt điểm cao hơn so với mô hình hàng đầu trên mọi điểm chuẩn về lập trình và agent mà DeepSeek liệt kê, chi phí mỗi token giảm 70 đến 77% ở mức cao điểm, và vào ngày 14 tháng 9, nó sẽ thay thế hoàn toàn V4-Pro: mọi yêu cầu deepseek-v4-pro sẽ được chuyển hướng đến V4.1-Flash và tính phí theo mức của Flash.
Đây không phải là sự đánh đổi thông thường giữa mô hình nhỏ và mô hình lớn. Đây là một sự so sánh có thời hạn. Nếu bạn đang chạy V4-Pro trong môi trường sản xuất, bạn có bốn ngày để tìm hiểu những thay đổi sẽ xảy ra khi việc chuyển hướng được thực hiện. Nếu bạn đang chạy V4-Flash, sự thay đổi đã diễn ra: tên deepseek-v4-flash hiện đang được phục vụ bởi V4.1-Flash.
Dưới đây: cả ba mô hình về kiến trúc, các điểm chuẩn được DeepSeek báo cáo, giá USD và thông lượng, sau đó là quy trình làm việc để chạy một bộ lời nhắc thông qua cả deepseek-v4-pro và deepseek-flash trong Apidog trước khi chuyển đổi để so sánh đầu ra, độ trễ và số lượng sử dụng. Để tìm hiểu sâu về kiến trúc, hãy đọc DeepSeek-V4.1-Flash là gì trước; để xem danh sách kiểm tra di chuyển, hãy xem hướng dẫn ngừng hoạt động của V4-Pro.
TL;DR
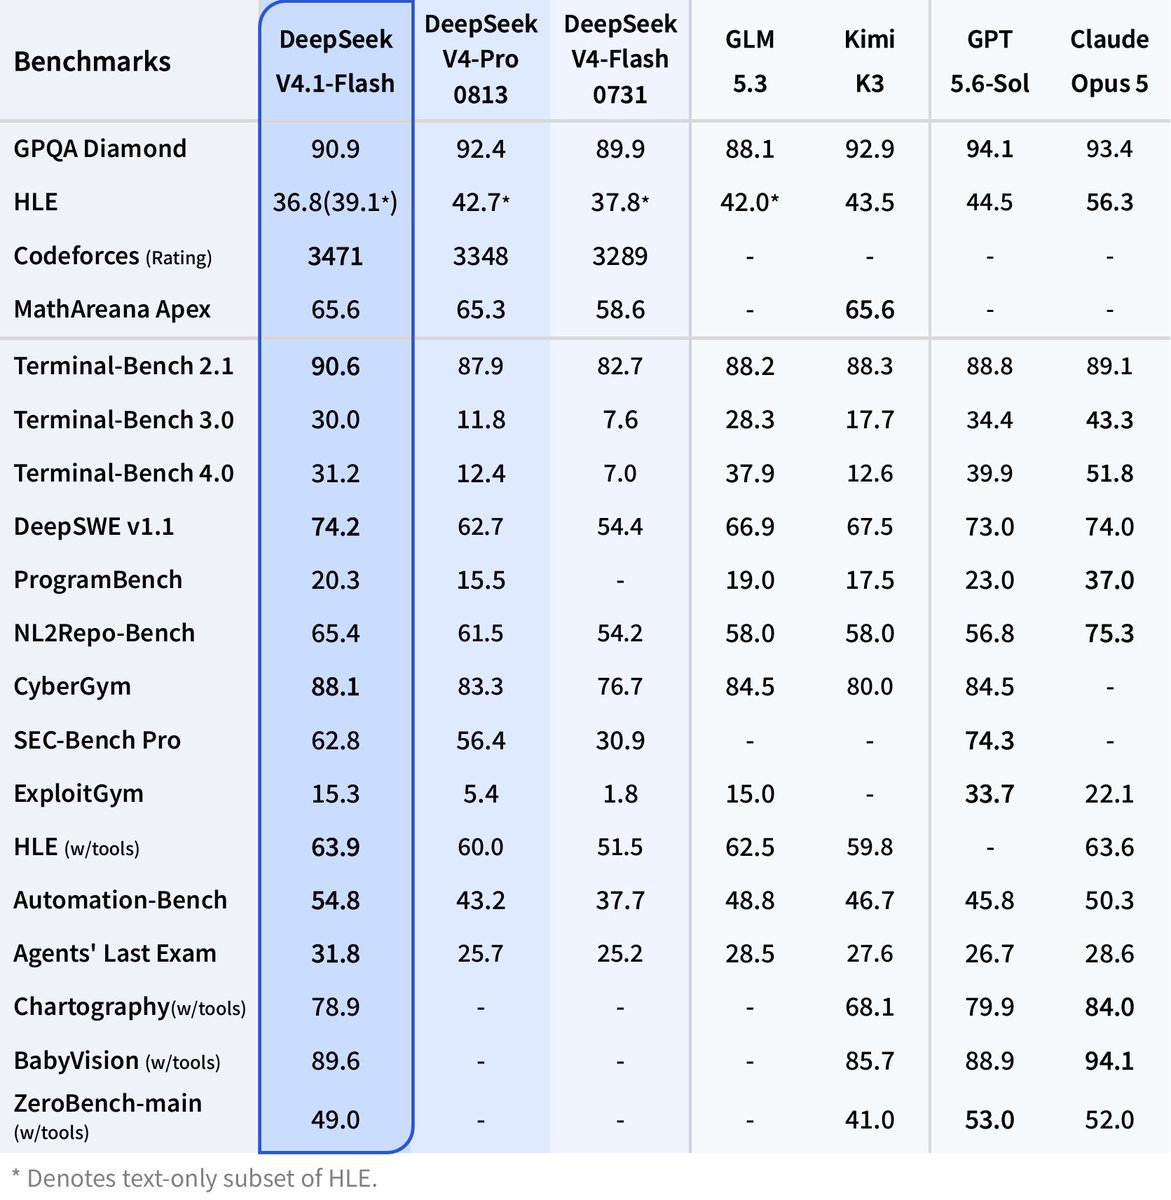
- V4.1-Flash chiến thắng trên các điểm chuẩn riêng của DeepSeek. DeepSWE v1.1 là điểm nổi bật: 74.2 so với 62.7 của V4-Pro và 54.4 của V4-Flash.
- Đây là mô hình rẻ nhất trong ba mô hình. Giá nhập liệu (cache-miss) cao điểm là 0,30 USD mỗi 1 triệu token so với 1,32 USD của V4-Pro và 0,44 USD của V4-Flash cũ.
- Nó được xây dựng để đạt thông lượng cao. 8 tỷ tham số hoạt động khi prefill, bộ đệm KV ở 890 byte mỗi token và giới hạn đồng thời là 2.500.
- Sau ngày 14 tháng 9 chỉ có một lựa chọn. Lưu lượng V4-Pro được chuyển hướng đến V4.1-Flash. Vấn đề là bạn được gì và mất gì, chứ không phải chọn mô hình nào.
Thông số kỹ thuật so sánh
Thế hệ V4.1 là một kiến trúc mới, không phải là một phiên bản được huấn luyện lại. DeepSeek gọi nó là Causal Encoder-Decoder (CED): 40 lớp chia thành 20 lớp mã hóa và 20 lớp giải mã, với 384 chuyên gia được định tuyến cộng với một chuyên gia chung cho mỗi lớp. Thẻ mô hình đặt xương sống ở 552 tỷ tham số (763 tỷ nếu có bộ mã hóa thị giác).
| V4-Flash | V4-Pro | V4.1-Flash | |
|---|---|---|---|
| Thế hệ kiến trúc | V4 MoE | V4 MoE | V4.1 Causal Encoder-Decoder, 40 lớp |
| Tổng số tham số | 284B (liệt kê của OpenRouter về bản dựng thị giác) | Không được tiết lộ ở đây | 552B xương sống, 763B với bộ mã hóa thị giác |
| Tham số hoạt động | 13B | Không được tiết lộ ở đây | 8B prefill, 16B decode |
| Cửa sổ ngữ cảnh | 1M token | 1M token | 1M token |
| Đầu ra tối đa | 384K token | 384K token | 384K token |
| Thị giác | Bản dựng Vision-Exp riêng biệt | Không được tiết lộ ở đây | Tích hợp, bộ mã hóa DeepSeek-ViT |
| Giấy phép | Không được đề cập ở đây | Không được đề cập ở đây | MIT, trọng số trên Hugging Face |
| Giới hạn đồng thời | 2.500 | 500 | 2.500 |
| Trạng thái API | Đã ngừng hoạt động, alias được phục vụ bởi V4.1-Flash | Chuyển hướng đến V4.1-Flash vào ngày 14 tháng 9 | GA từ ngày 10 tháng 9, id mô hình deepseek-flash |
Chi tiết đáng chú ý là số lượng tham số hoạt động được chia: V4-Flash sử dụng 13 tỷ cho mỗi token, trong khi V4.1-Flash dành 8 tỷ cho đầu vào và 16 tỷ cho đầu ra, nơi chất lượng được thể hiện.
Điểm chuẩn: 11,5 điểm đến từ đâu
Mọi con số dưới đây đều do DeepSeek báo cáo từ thẻ mô hình. Chưa có thử nghiệm độc lập nào được công bố, và cụm từ "các thử nghiệm của nhiều bên" trong thông báo ngừng hoạt động không nêu tên các bên đó. Hãy coi chúng là tuyên bố của nhà cung cấp và xác minh bằng các lời nhắc của riêng bạn.
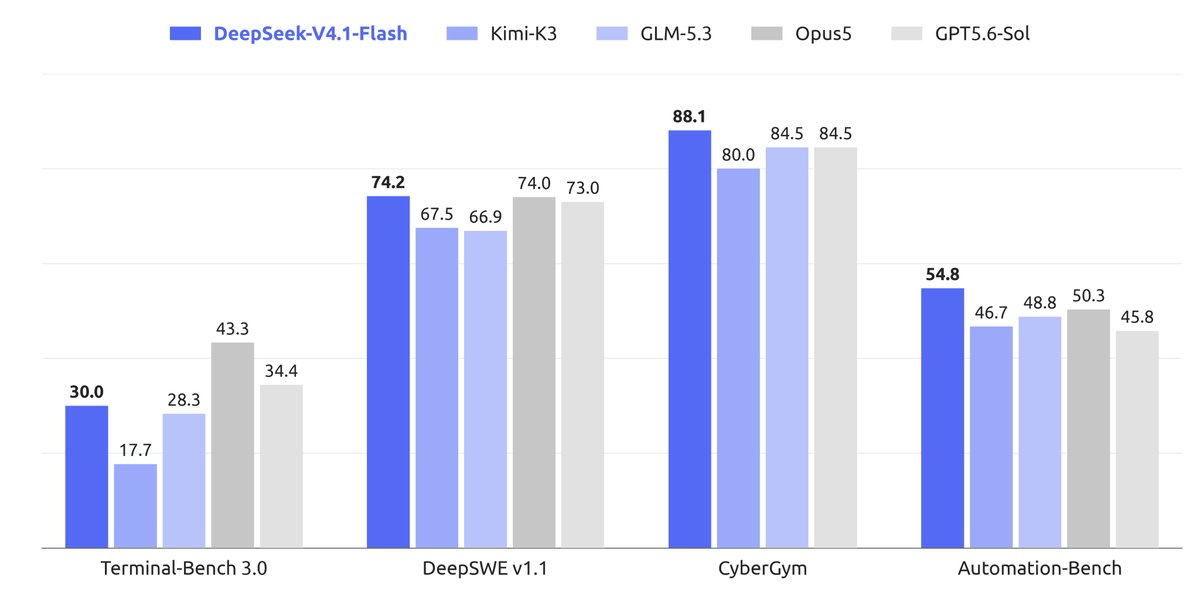
DeepSWE v1.1 (+11.5 so với Pro, +19.8 so với V4-Flash). Đây là điểm nổi bật, và là khoảng cách đủ lớn để thay đổi quyết định. DeepSWE đo lường các tác vụ kỹ thuật phần mềm đa tệp, khối lượng công việc mà các tác nhân lập trình thực hiện hàng ngày. Nếu nó đúng trên kho lưu trữ của bạn, V4.1-Flash vượt trội hơn hẳn mô hình có giá gấp bốn lần.
Terminal-Bench 2.1 (+2.7). Các tác vụ tác nhân dựa trên shell. V4-Flash-0731 đã đánh bại V4-Pro-Preview ở đây vào tháng 7; V4.1 mở rộng lợi thế thêm dưới ba điểm. Có thật, nhưng không mang tính quyết định.
HumanEval (+2.6) và GSM8K (+0.4). Cả hai đều gần đạt đến mức bão hòa: mọi mô hình đều vượt qua 90 trên GSM8K, và HumanEval ít nói lên điều gì về mã sản xuất. Đừng quá chú trọng vào các hàng này.
MiniMax M3 so với DeepSeek V4 so với Qwen 3.7 có các con số của thế hệ V4 so với các mô hình mở khác; chưa có mô hình nào bao gồm V4.1.
Chi phí: ba mô hình, sáu bậc giá
Giờ cao điểm là Thứ Hai đến Thứ Sáu, từ 01:00 đến 04:00 và từ 06:00 đến 10:00 UTC; tất cả các thời điểm khác là giờ thấp điểm với giá bằng một nửa. Giá được tính trên 1 triệu token từ trang giá, có hiệu lực từ ngày 10 tháng 9. Các hàng của V4-Flash sử dụng giá USD ngày 21 tháng 8 năm 2026 làm cột "trước đây".
| Mô hình và bậc | Đầu vào, cache hit | Đầu vào, cache miss | Đầu ra |
|---|---|---|---|
| V4-Flash, giờ thấp điểm (Giá ngày 21 tháng 8) | $0.007 | $0.22 | $0.66 |
| V4-Flash, giờ cao điểm (Giá ngày 21 tháng 8) | $0.014 | $0.44 | $1.32 |
| V4-Pro, giờ thấp điểm | $0.022 | $0.66 | $1.98 |
| V4-Pro, giờ cao điểm | $0.044 | $1.32 | $3.96 |
| V4.1-Flash, giờ thấp điểm | $0.003 | $0.15 | $0.60 |
| V4.1-Flash, giờ cao điểm | $0.006 | $0.30 | $1.20 |
So với V4-Flash, V4.1 giảm chi phí đầu vào (cache-hit) khoảng 57%, đầu vào (cache-miss) khoảng 32% và đầu ra khoảng 9%. So với V4-Pro, mức giảm là 77% đối với đầu vào (cache-miss) và 70% đối với đầu ra vào giờ cao điểm.
Một tháng làm việc. Một tác nhân lập trình xử lý 2 tỷ token đầu vào mỗi tháng với tỷ lệ cache-hit là 70% (lời nhắc hệ thống và ngữ cảnh kho lưu trữ được tái sử dụng qua các lượt) và xuất ra 300 triệu token đầu ra, tất cả đều vào giờ cao điểm.
| V4-Pro, giờ cao điểm | V4-Flash, giờ cao điểm | V4.1-Flash, giờ cao điểm | V4.1-Flash, giờ thấp điểm | |
|---|---|---|---|---|
| 1.4B đầu vào (cache-hit) | $61.60 | $19.60 | $8.40 | $4.20 |
| 600M đầu vào (cache-miss) | $792.00 | $264.00 | $180.00 | $90.00 |
| 300M đầu ra | $1,188.00 | $396.00 | $360.00 | $180.00 |
| Tổng cộng hàng tháng | $2,041.60 | $679.60 | $548.40 | $274.20 |
Mức này thấp hơn 73% so với V4-Pro, và việc chuyển các tác vụ hàng loạt sang giờ thấp điểm sẽ giảm một nửa nữa. Token đầu ra chiếm ưu thế trong mọi cột, vì vậy việc cắt giảm 70% đầu ra quan trọng hơn tiêu đề cache-hit. Phân tích chi tiết giá của V4.1-Flash đề cập đến phép tính cache-hit.
Tốc độ và thông lượng
DeepSeek không công bố con số token mỗi giây, vì vậy câu chuyện về thông lượng dựa trên ba sự thật kiến trúc và một giai thoại.
- Bộ đệm KV ở 890 byte mỗi token. Bộ đệm KV chính FP4 đặt bộ đệm toàn cục vào khoảng một phần tư dung lượng của V4-Flash. Thông báo phát hành nêu rõ nó là 1/4 HBM và 1/8 dung lượng lưu trữ SSD so với thế hệ trước. Một ngữ cảnh 1 triệu token đầy đủ cần khoảng 0,9 GB bộ đệm.
- 8 tỷ tham số hoạt động khi prefill. Ít tính toán hơn cho mỗi token đầu vào so với 13 tỷ của V4-Flash, vì vậy thời gian đến token đầu tiên trên các ngữ cảnh lớn sẽ giảm.
- Đồng thời 2.500 so với 500. Lưu lượng V4-Pro được chuyển hướng kế thừa giới hạn của Flash, tăng 5 lần cho các nhóm tác nhân.
- Báo cáo của một người dùng: "gần 400 t/s". Một người dùng X đã đăng nó từ các bài kiểm tra video trong giai đoạn beta; đó là một giai thoại, không phải là một điểm chuẩn. Luồng beta trên HN chủ yếu là sự nhiệt tình tương tự.
Hãy tự đo p50 và p95 của bạn trước khi tin bất cứ điều gì trong số đó.
Bạn mất gì và được gì sau ngày 14 tháng 9
Không có câu hỏi "nên chọn mô hình nào" sau khi chuyển đổi. deepseek-v4-pro trở thành một alias, vì vậy cách diễn đạt trung thực là một bảng kê.
Bạn được: điểm cao hơn trên mọi điểm chuẩn được liệt kê, giá cao điểm thấp hơn 70 đến 77%, khả năng đồng thời tăng gấp 5 lần, đầu vào hình ảnh gốc mà không cần id mô hình thị giác riêng biệt và một bộ điều chỉnh nỗ lực suy luận mà DeepSeek mô tả là có thể kiểm soát liên tục trên thang điểm từ 1 đến 100.
Bạn mất: khả năng cố định một điểm kiểm tra thế hệ V4. Các lời nhắc được điều chỉnh cho kiểu, độ dài hoặc định dạng gọi công cụ của V4-Pro có thể bị lệch. Độ dài đầu ra và số lượng token suy luận có thể thay đổi, điều này làm thay đổi hóa đơn của bạn theo những cách mà bảng giá không thể hiện. Và việc chuyển hướng xảy ra theo lịch trình của DeepSeek, không phải của bạn.
Danh sách thứ hai đó là lý do tại sao bạn nên so sánh trước ngày 14, không phải sau đó.
So sánh V4-Pro với V4.1-Flash trong Apidog trước khi chuyển đổi
Apidog kiểm tra lớp API, vì vậy đây là nơi thích hợp để chạy một bộ lời nhắc thông qua cả hai id mô hình và so sánh kết quả trả về.
- Thêm điểm cuối. Tạo một dự án và thêm
POST https://api.deepseek.com/chat/completions, hoặc nhập một đặc tả OpenAPI. - Đặt khóa và id mô hình vào môi trường. Lưu trữ
DEEPSEEK_API_KEYvà một biếnMODEL. Tạo hai môi trường,v4-provớiMODEL=deepseek-v4-provàv41-flashvớiMODEL=deepseek-flash, và tham chiếu chúng dưới dạngBearer {{DEEPSEEK_API_KEY}}trong tiêu đề và"model": "{{MODEL}}"trong phần thân. - Lưu các lời nhắc thực của bạn dưới dạng yêu cầu. Chọn 20 đến 30 lời nhắc đại diện cho sản phẩm: lời nhắc hệ thống của bạn, một lượt gọi công cụ, một tóm tắt ngữ cảnh dài, một chỉnh sửa mã đa tệp. Lưu mỗi lời nhắc với
stream: falseđể đối tượngusagenằm trong phần thân phản hồi. - Xác nhận trên các trường thay đổi hóa đơn của bạn. Xây dựng một kịch bản thử nghiệm từ các yêu cầu đã lưu và thêm các xác nhận trên
usage.prompt_tokens,usage.completion_tokensvàusage.prompt_cache_hit_tokens. Ghi lại thời gian phản hồi cho mỗi bước, và thêm một tập lệnh trước yêu cầu để đóng dấu tên môi trường vào tiêu đề để các lần chạy được dán nhãn. - Chạy một lần cho mỗi môi trường, sau đó so sánh. Chạy kịch bản dưới
v4-pro, sau đó dướiv41-flash. So sánh số lượng token hoàn thành (việc chuyển hướng thay đổi hóa đơn đầu ra của bạn), độ trễ cho mỗi bước và nội dung thực tế để tìm sự lệch về định dạng. - Chạy lại trong CI vào ngày 14. Chạy cùng một kịch bản với
apidog-clitrong pipeline của bạn tại thời điểm chuyển đổi. Bất cứ điều gì mà việc chuyển hướng gây ra lỗi sẽ hiển thị dưới dạng xác nhận thất bại thay vì một phiếu hỗ trợ.
So sánh tương tự dưới dạng một tập lệnh:
import os, time
from openai import OpenAI

client = OpenAI(api_key=os.environ["DEEPSEEK_API_KEY"],
                base_url="https://api.deepseek.com")

prompt = "Make payment retries in the checkout service idempotent. Return a unified diff."

for model in ("deepseek-v4-pro", "deepseek-flash"):
    start = time.perf_counter()
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": prompt}],
    )
    print(model, f"{time.perf_counter() - start:.2f}s",
          r.usage.prompt_tokens, r.usage.completion_tokens)
Chạy nó vào giờ cao điểm và thấp điểm và giữ lại kết quả. Tải xuống Apidog để giữ các so sánh, xác nhận và lịch sử chạy ở một nơi.
Câu hỏi thường gặp
V4.1-Flash có tốt hơn V4-Pro trong việc lập trình không? Dựa trên các con số DeepSeek báo cáo, có: 74.2 so với 62.7 trên DeepSWE v1.1 và 90.6 so với 87.9 trên Terminal-Bench 2.1. Để biết cách thế hệ V4 so sánh với Claude về lập trình, hãy xem DeepSeek V4 vs Claude Opus cho lập trình.
Điều gì sẽ xảy ra với tích hợp V4-Pro của tôi vào ngày 14 tháng 9? Từ 04:00 UTC, mọi yêu cầu deepseek-v4-pro sẽ được phục vụ bởi V4.1-Flash và tính phí theo mức của Flash. Mã của bạn vẫn hoạt động; mô hình phía sau nó thay đổi. Hướng dẫn di chuyển có đầy đủ danh sách kiểm tra.
Tôi có cần đổi tên deepseek-v4-flash thành deepseek-flash không? Hiện tại thì chưa. deepseek-v4-flash và deepseek-v4-flash-vision-exp vẫn được chấp nhận và phục vụ bởi V4.1-Flash. DeepSeek chưa đưa ra ngày ngừng sử dụng, vì vậy hãy chuyển sang deepseek-flash vào lần tới khi bạn chỉnh sửa cấu hình.
V4.1-Flash có nhanh hơn V4-Pro không? DeepSeek nói vậy nhưng không công bố số liệu cụ thể. Kiến trúc hỗ trợ tuyên bố này: 8 tỷ tham số hoạt động khi prefill và bộ đệm KV chỉ bằng một phần tư kích thước của V4-Flash. Hãy tự đo lường của riêng bạn.
Tôi có thể chạy V4-Pro ở đâu đó không? Không trên API của DeepSeek sau ngày 14. Nền tảng của thế hệ V4 nằm trong bài viết DeepSeek V4 là gì; trọng số của V4.1-Flash có trên Hugging Face theo giấy phép MIT.
Phiên bản ngắn gọn
V4.1-Flash nhỏ hơn, rẻ hơn và đạt điểm cao hơn cùng lúc, ít nhất là trên bảng của nhà cung cấp, và bảng đó không thể cho bạn biết liệu nó có tốt hơn cho các lời nhắc của bạn hay không. Hãy chạy cả hai ID mô hình với cùng một bộ lời nhắc trong Apidog trong tuần này, giữ lại các so sánh khác biệt, và bạn sẽ biết những thay đổi vào ngày 14 tháng 9 trước cả người dùng của bạn.