
Anthropic ra mắt Claude Opus 5 vào ngày 24 tháng 7 năm 2026, và câu hỏi mà mọi nhóm đặt ra trong vòng một giờ đều giống nhau: nếu Opus 5 tiệm cận Fable 5 với nửa giá, tại sao mọi người lại tiếp tục trả tiền cho Fable 5?
Các con số rất đơn giản. Opus 5 có giá 5 đô la cho mỗi triệu token đầu vào và 25 đô la cho mỗi triệu token đầu ra. Fable 5 có giá 10 đô la và 50 đô la: khoảng cách chính xác gấp đôi ở cả hai phía, không có chi tiết nhỏ về các cấp hoặc mức tối thiểu. Các tuyên bố ra mắt của chính Anthropic cho biết Opus 5 đạt trong vòng 0.5% so với hiệu suất đỉnh của Fable 5 trên CursorBench 3.2 và vượt trội Fable 5 trên OSWorld 2.0 với một phần ba chi phí.
Nếu bạn muốn tự chạy so sánh, bạn có thể gửi cùng một lời nhắc (prompt) tới cả hai ID mô hình từ Apidog và so sánh các phản hồi cũng như số lượng token cạnh nhau.
Tổng quan hai mô hình
| Claude Opus 5 | Claude Fable 5 | |
|---|---|---|
| ID mô hình API | claude-opus-5 |
claude-fable-5 |
| Giá đầu vào | $5 / MTok | $10 / MTok |
| Giá đầu ra | $25 / MTok | $50 / MTok |
| Cửa sổ ngữ cảnh | 1M token (mặc định và tối đa) | 1M token |
| Đầu ra tối đa | 128k (300k trên Batch với tiêu đề beta) | 128k |
| Giới hạn kiến thức | Tháng 5 năm 2026 | Tháng 1 năm 2026 |
| Định vị | Mặc định được Anthropic khuyến nghị | Mô hình mạnh nhất được phát hành rộng rãi |
| Tư duy | Thích ứng, bật mặc định, có thể điều khiển qua mức độ nỗ lực | Luôn bật |
| Ra mắt | 24 tháng 7 năm 2026 | Đầu tháng 6 năm 2026 |
Hai hàng xứng đáng được xem xét kỹ lưỡng trước bất cứ điều gì khác.
Hàng giới hạn kiến thức đi ngược lại câu chuyện thông thường “cấp mới hơn rẻ hơn, cấp cũ hơn thông minh hơn”. Opus 5 biết về thế giới cho đến **Tháng 5 năm 2026**. Fable 5 dừng lại ở **Tháng 1 năm 2026**, cùng giới hạn với Sonnet 5. Bốn tháng phát hành gói, phiên bản framework và thay đổi API nằm trong dữ liệu huấn luyện của Opus 5 và nằm ngoài Fable 5. Nếu công việc của bạn liên quan đến các thư viện thay đổi nhanh chóng, mô hình rẻ hơn cũng là mô hình mới hơn.
Hàng định vị lại đi theo hướng khác. Anthropic vẫn mô tả Fable 5 là mô hình mạnh nhất được phát hành rộng rãi của họ, và họ chưa gắn nhãn đó cho Opus 5. Opus 5 là *mặc định* được khuyến nghị, đó là một tuyên bố khác: đó là điều bạn nên sử dụng khi bạn không chắc chắn, chứ không phải điều bạn nên sử dụng khi nhiệm vụ nằm ở giới hạn của những gì bất kỳ mô hình nào có thể làm được.
Để biết bảng thông số kỹ thuật đầy đủ về mô hình mới hơn, hãy xem bài giải thích Claude Opus 5 của chúng tôi. Để biết chi tiết ra mắt của Fable 5, hãy xem Claude Fable 5 là gì.
Những gì Anthropic thực sự tuyên bố
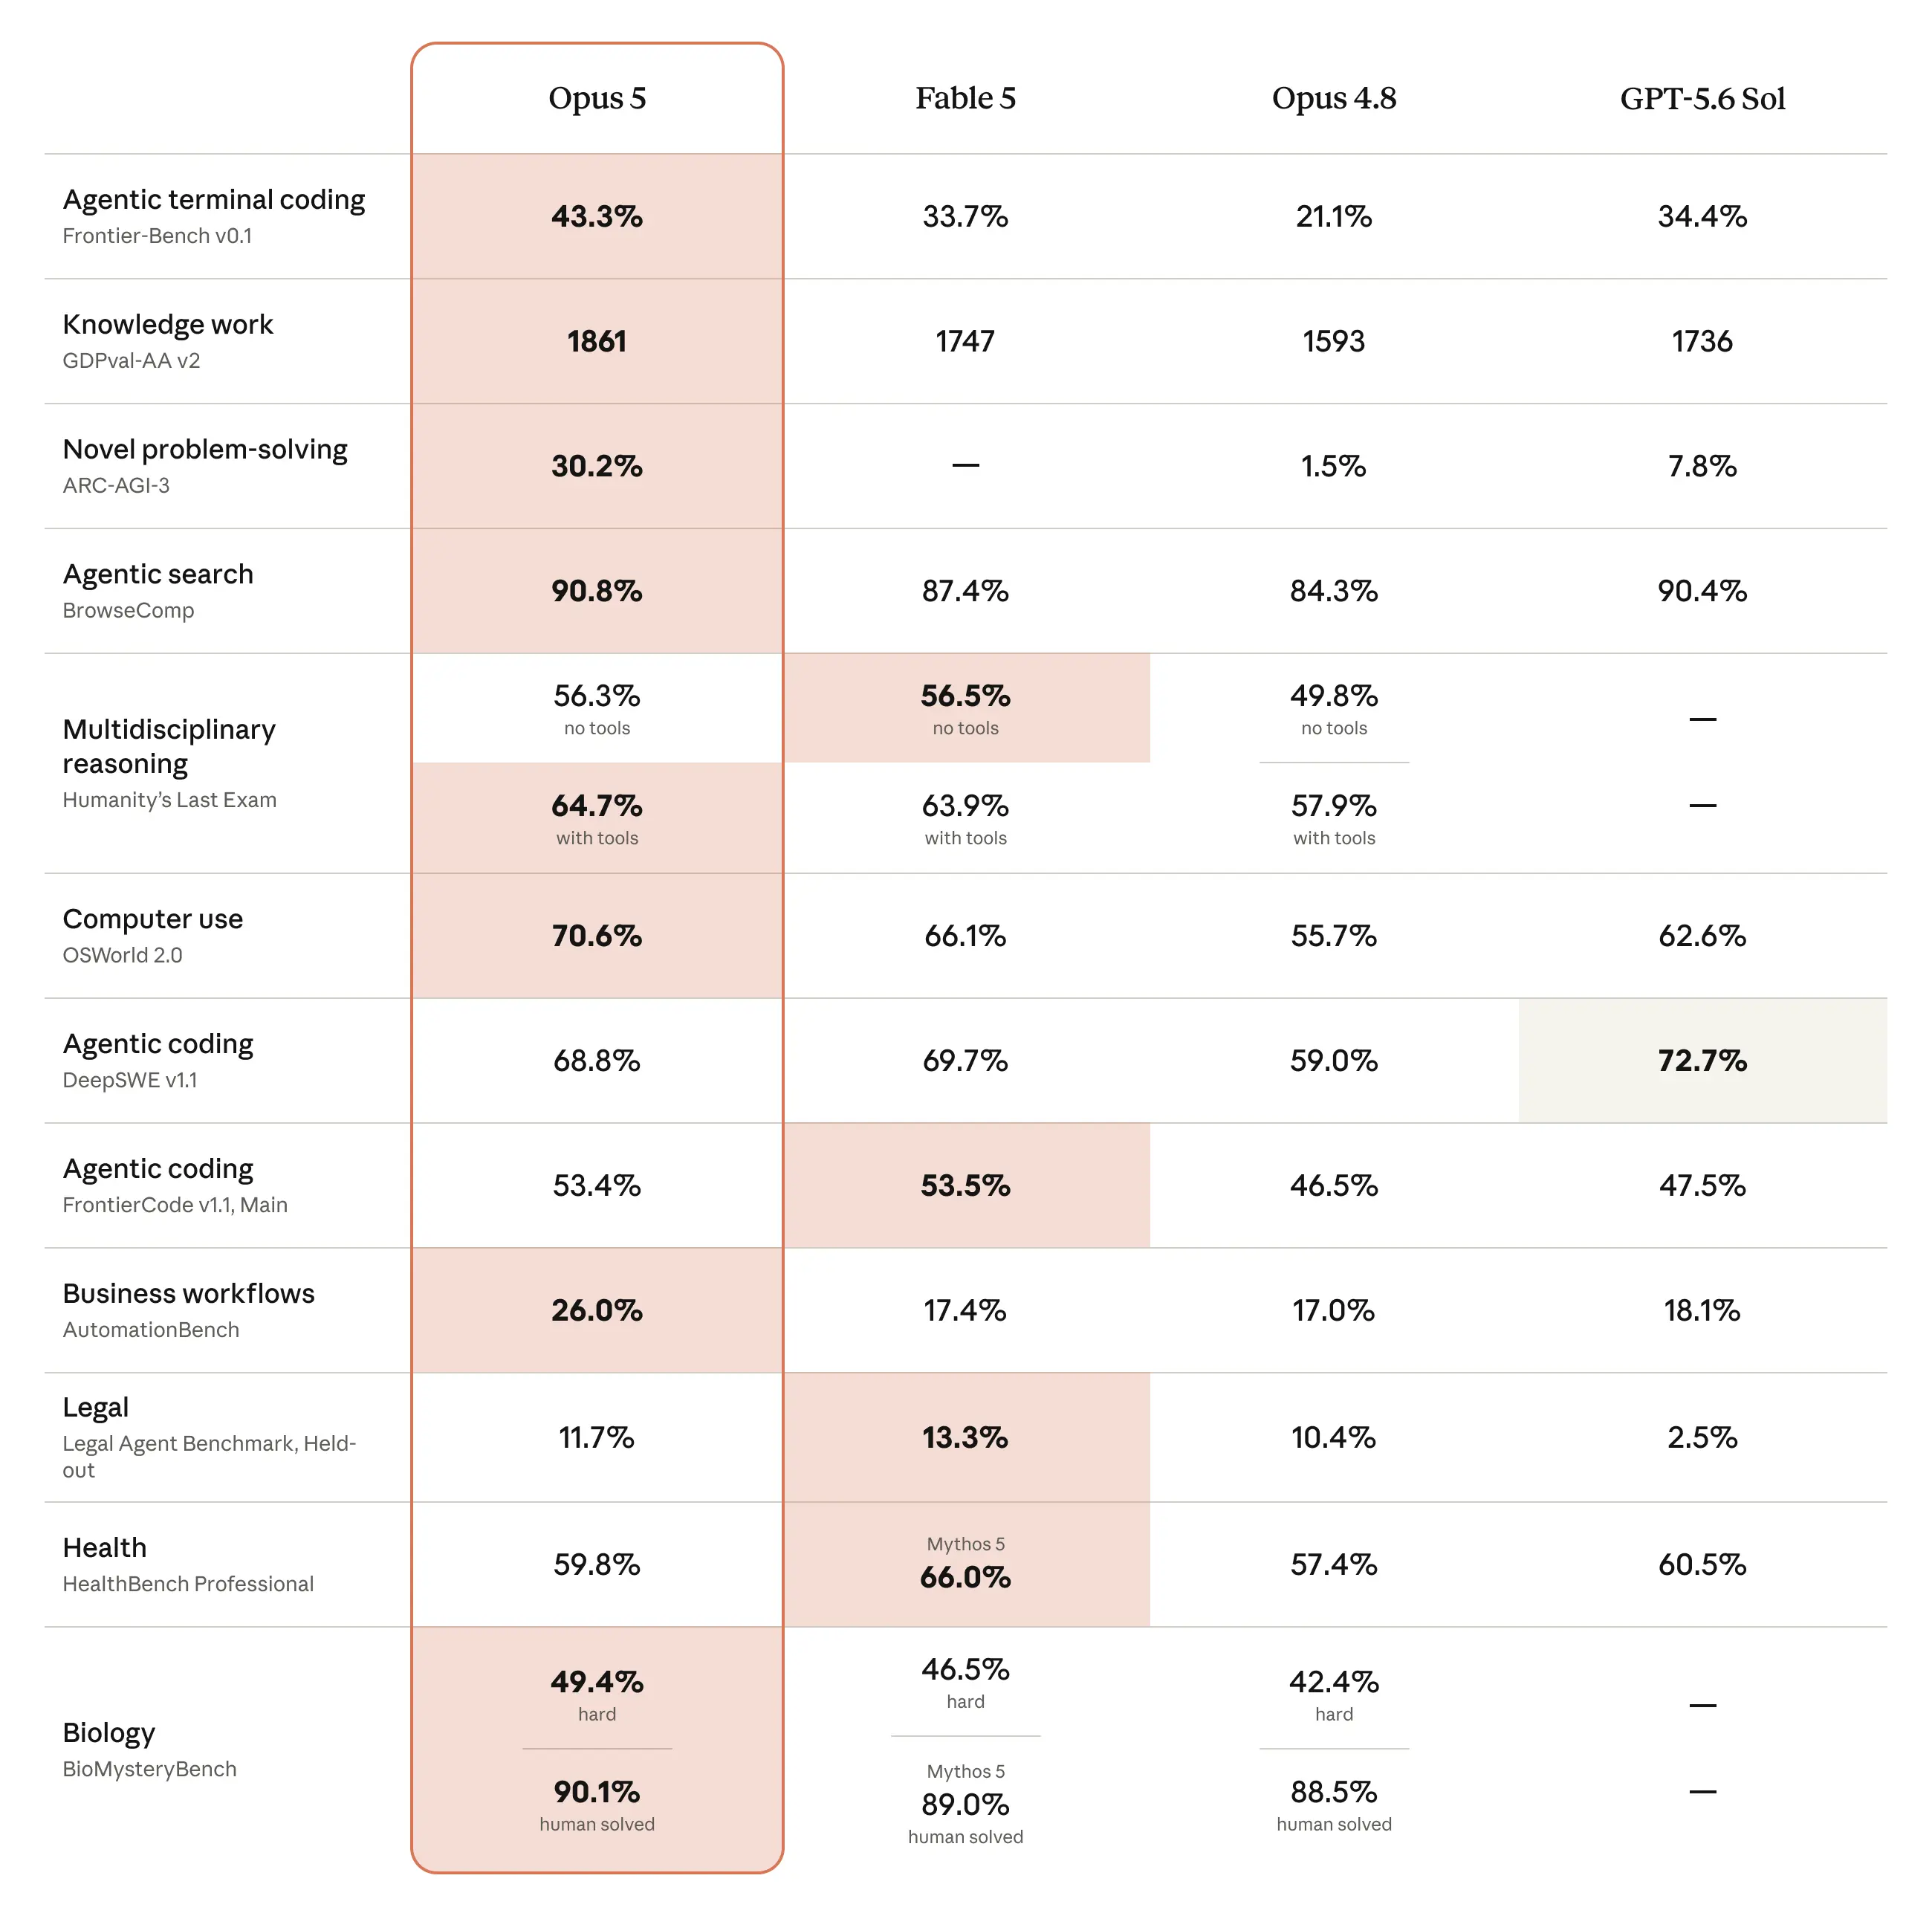
Dưới đây là các tuyên bố ra mắt liên quan đến so sánh này, được Anthropic trình bày:
| Thử nghiệm hiệu năng | Tuyên bố của Anthropic về Opus 5 |
|---|---|
| CursorBench 3.2 | Trong vòng 0.5% so với hiệu suất đỉnh của Fable 5, với nửa giá |
| OSWorld 2.0 (sử dụng máy tính) | Vượt trội Fable 5 với một phần ba chi phí |
| Frontier-Bench v0.1 | Vượt trội tất cả các mô hình khác; tăng hơn gấp đôi điểm của Opus 4.8 |
| ARC-AGI 3 | Gấp khoảng 3 lần mô hình tốt thứ hai |
| Zapier AutomationBench | Tỷ lệ vượt qua khoảng 1.5 lần mô hình tốt thứ hai |
| Hóa hữu cơ | +10.2 điểm so với Opus 4.8 |
| Phân tích protein | +7.7 điểm so với Opus 4.8 |
Bây giờ là lời cảnh báo, vì đó là toàn bộ vấn đề. **Mỗi con số này đều do nhà cung cấp tự chạy.** Anthropic đã thiết kế thiết lập đánh giá, chọn cài đặt nỗ lực và công bố kết quả. Tính đến ngày 25 tháng 7 năm 2026, chưa có kết quả nào được tái tạo độc lập. Đó không phải là một cáo buộc về ý đồ xấu; đó là tình trạng bình thường của một lần ra mắt vào ngày thứ hai. Nhưng “trong vòng 0.5% của Fable 5” mô tả một bộ thử nghiệm cụ thể với một cấu hình cụ thể, và khoảng cách bạn đo được trên các tác vụ của riêng bạn có thể lớn hơn hoặc nhỏ hơn.
Tuyên bố về OSWorld là hai con số đối đầu thú vị hơn, bởi vì đây là nơi Opus 5 được cho là *đánh bại* Fable 5 thay vì chỉ tiệm cận nó. Các tác vụ sử dụng máy tính thưởng cho sự kiên trì và khả năng phục hồi hơn là chiều sâu lập luận thô, điều này phù hợp với một mô hình được tinh chỉnh cho các vòng lặp tác nhân. Tuyên bố về CursorBench là mềm mỏng hơn: “trong vòng 0.5% của hiệu suất đỉnh của Fable 5” có nghĩa là Fable 5 vẫn giữ vị trí đỉnh cao.
Chúng tôi phân tích mọi con số, bao gồm những gì mỗi thử nghiệm đo lường và không đo lường, trong phân tích chuyên sâu các thử nghiệm hiệu năng của Opus 5. Các con số ra mắt của Fable 5 nằm trong bài đăng về các thử nghiệm hiệu năng của Fable 5.
Lợi thế của Opus 5
**Khoảng cách giá cả là cố định và nó nhân lên.** Với 5$/25$ so với 10$/50$, một khối lượng công việc tiêu tốn 3.000$ mỗi tháng trên Fable 5 sẽ chỉ tốn 1.500$ trên Opus 5 với cùng khối lượng token. Không có ngưỡng hoặc cam kết nào làm thu hẹp khoảng cách này.
**Các đòn bẩy chi phí được xếp chồng lên trên mức giảm một nửa.** Tỷ lệ API Batch của Opus 5 là 2.50$/12.50$, giảm thêm 50%. Lượt truy cập và làm mới bộ nhớ đệm có giá 0.50$ cho mỗi triệu, và mức tối thiểu bộ nhớ đệm cho lời nhắc đã giảm xuống còn 512 token (từ 1.024 trên Opus 4.8), do đó các lời nhắc hệ thống ngắn trước đây quá nhỏ để lưu vào bộ nhớ đệm giờ đây có thể được lưu vào bộ nhớ đệm mà không cần thay đổi mã. Chi phí bổ sung cho lời nhắc hệ thống sử dụng công cụ cũng thấp hơn: 286 token với `tool_choice` được đặt thành `auto` hoặc `none`, so với 290 trên Opus 4.8 và 675 trên Opus 4.7. Cùng với nhau, những điều này tạo nên một hóa đơn đáng kể. Phân tích giá Opus 5 của chúng tôi có bảng đầy đủ, và cách cắt giảm hóa đơn API Claude của bạn bao gồm các đòn bẩy chung.
**Bạn có thể tăng chi phí khi một tác vụ xứng đáng.** Tham số `output_config.effort` của Opus 5 mặc định là `high` và các cấp độ đã được hiệu chỉnh lại khi ra mắt, với `low` và `medium` mạnh hơn đáng kể so với các mô hình Opus trước đó. Điều đó mang lại cho bạn một công cụ điều chỉnh thay vì một tỷ lệ cố định: phân loại rẻ ở mức `low`, mã hóa tác nhân khó ở mức `xhigh`. Hướng dẫn tham số nỗ lực giải thích cách chạy để thay thế các cài đặt cũ.
**Đây là mô hình mới hơn**, tính đến bốn tháng.
**Đây là nơi các cài đặt mặc định đang hướng tới.** Opus 5 là mặc định mới cho người đăng ký Max và mô hình hiệu suất cao nhất dành cho người dùng Pro, và nó được cung cấp trên Claude API, claude.ai, Claude Code, Claude Cowork, Amazon Bedrock, Claude Platform trên AWS, Google Cloud, Microsoft Foundry và GitHub Copilot. Tổng quan về các mô hình của Anthropic nói rõ rằng nếu bạn không chắc chắn nên sử dụng mô hình nào, hãy bắt đầu với Opus 5.
Lợi thế của Fable 5
Giải thích lợi thế của một mô hình đắt tiền hơn là công việc khó hơn, vì vậy hãy đi thẳng vào vấn đề thay vì nói một cách lịch sự.
**Chỉ định về khả năng chưa thay đổi.** Anthropic có thể đã công bố Opus 5 là mô hình mạnh nhất được phát hành rộng rãi của họ vào ngày ra mắt. Nhưng họ đã không làm vậy. Khi một nhà cung cấp giữ một danh hiệu cao nhất cho mô hình cũ hơn, đắt tiền hơn trong khi phát hành một mô hình rẻ hơn mà họ rất tự hào, đó là một tín hiệu về đỉnh cao của đường cong khả năng, chứ không phải là một sự bỏ sót trong tiếp thị. Đối với những vấn đề khó nhất, những vấn đề mà một lần chạy lỗi duy nhất tốn kém hơn cả một tháng chi phí API, Fable 5 vẫn là mô hình mà Anthropic hướng tới. Thông báo ra mắt của nó là tài liệu tham khảo cho vị trí này.
**Tư duy luôn bật loại bỏ một chế độ lỗi.** Fable 5 suy nghĩ trong mỗi yêu cầu: so sánh mô hình của Anthropic liệt kê khả năng tư duy thích ứng của nó là “luôn bật,” và đây là mô hình duy nhất hiện tại được mô tả như vậy. Opus 5 cho phép bạn tắt tư duy, và tài liệu hướng dẫn tạo lời nhắc của Anthropic ghi lại điều gì xảy ra khi bạn làm vậy: các lệnh gọi công cụ đôi khi được viết ra dưới dạng văn bản thuần túy thay vì được thực thi (và văn bản bị rò rỉ đó sau đó làm hỏng các lượt tiếp theo trong vòng lặp tác nhân), và các thẻ XML nội bộ đôi khi xuất hiện trong đầu ra hiển thị. Biện pháp giảm thiểu được Anthropic khuyến nghị là giữ tư duy bật và kiểm soát chi phí với mức nỗ lực thấp hơn. Một mô hình không bao giờ cho bạn “chĩa súng vào chân mình” thì không thể bị bắn bởi nó.
**Sự linh hoạt của Opus 5 có những mặt sắc bén.** Kết hợp `thinking: {type: "disabled"}` với mức nỗ lực `xhigh` hoặc `max` sẽ trả về lỗi 400, được thực thi cho mỗi yêu cầu. Tư duy hiện chạy mặc định khi bạn bỏ qua trường `thinking`, vì vậy ngân sách `max_tokens` được định cỡ cho khối lượng công việc không tư duy có thể bị cắt ngắn. Opus 5 cũng ủy quyền cho các tác nhân phụ dễ dàng hơn và tạo ra các phản hồi mặc định dài hơn, cả hai điều này đều âm thầm làm tăng chi phí nếu bạn không giới hạn chúng. Fable 5 không có bất kỳ bề mặt di chuyển nào như vậy. Nếu bạn di chuyển, hướng dẫn di chuyển từ Opus 4.8 sang Opus 5 của chúng tôi có đầy đủ các thay đổi gây phá vỡ.
**Chi phí chuyển đổi không phải bằng không.** Các đánh giá, lời nhắc, cài đặt nỗ lực và mô hình chi phí của bạn được hiệu chỉnh theo mô hình bạn đang chạy hiện nay. “Nửa giá” là một tuyên bố trên mỗi token, không phải là một tuyên bố về chi phí dự án. Nếu việc di chuyển mất hai kỹ sư trong một tuần và khối lượng công việc nhỏ, phép tính không có ý nghĩa. So sánh Fable 5 và Opus 4.8 bao gồm những gì cấp Fable mang lại so với cấp Opus nói chung, và giá Fable 5 bao gồm cấu trúc chi phí của nó.
Khoảng cách giá trông như thế nào trong các yêu cầu thực tế
Các hệ số nhân rất dễ gật đầu đồng ý nhưng khó cảm nhận được. Đây là một tác vụ mã hóa tác nhân: 200.000 token đầu vào (một ngữ cảnh kho lưu trữ lớn cộng với lịch sử gọi công cụ dài) và 20.000 token đầu ra.
| Opus 5 | Fable 5 | |
|---|---|---|
| Đầu vào (200k) | $1.00 | $2.00 |
| Đầu ra (20k) | $0.50 | $1.00 |
| Mỗi tác vụ | $1.50 | $3.00 |
| 500 tác vụ/tháng | $750 | $1,500 |
| 5.000 tác vụ/tháng | $7.500 | $15.000 |
Ở 500 tác vụ mỗi tháng, khoảng cách là 750 đô la. Con số này nằm trong mức dao động của hầu hết các ngân sách kỹ thuật, và nếu Fable 5 giúp nhóm của bạn tiết kiệm một lần chạy lỗi mỗi tháng, thì nó tự chi trả cho mình. Ở 5.000 tác vụ mỗi tháng, khoảng cách là 90.000 đô la mỗi năm, đây là một vấn đề cần thảo luận về nhân sự.
Vì vậy, **quy tắc quyết định là về khối lượng, không phải về việc mô hình nào thông minh hơn.** Dưới vài trăm tác vụ khó mỗi tháng, hãy chọn dựa trên khả năng và bỏ qua giá cả. Trên vài nghìn tác vụ, bạn cần bằng chứng Fable 5 tốt hơn *trên khối lượng công việc của bạn*, chứ không phải trên bộ thử nghiệm của Anthropic.
Một phép tính khác: chế độ nhanh của Opus 5 (tốc độ đầu ra gấp 2.5 lần, bản xem trước nghiên cứu chỉ trên API của bên thứ nhất) có giá 10$/50$, chính xác bằng mức cơ bản của Fable 5. Nếu độ trễ là hạn chế thay vì khả năng, bạn có thể chi tiền của Fable-5 cho một Opus 5 nhanh hơn thay vì một Fable 5 chậm hơn. Lưu ý rằng `inference_geo: "us"` cộng thêm hệ số 1.1x cho mọi danh mục token trên Opus 5, làm thay đổi các con số này thêm 10%.
Khung quyết định theo khối lượng công việc
| Khối lượng công việc của bạn | Chọn | Lý do |
|---|---|---|
| Lập trình tác nhân, khối lượng lớn | Opus 5 | Anthropic báo cáo trong vòng 0.5% trên CursorBench với nửa giá; khối lượng lớn khiến chênh lệch trở thành tiền thật |
| Sử dụng máy tính và tự động hóa trình duyệt | Opus 5 | Thử nghiệm hiệu năng duy nhất mà Anthropic tuyên bố Opus 5 vượt trội Fable 5 hoàn toàn |
| Công việc liên quan đến thư viện sau tháng 1 năm 2026 | Opus 5 | Giới hạn tháng 5 năm 2026 so với tháng 1 năm 2026 |
| Lưu lượng sản xuất nhạy cảm về chi phí | Opus 5 | Nửa giá, cộng thêm batch, bộ nhớ đệm tối thiểu 512 token, và mức nỗ lực thấp/trung bình |
| Các tác vụ suy luận rủi ro cao, đơn lẻ | Fable 5 | Vẫn là mô hình mạnh nhất được Anthropic phát hành rộng rãi; chi phí mỗi lần chạy không đáng kể với khối lượng thấp |
| Các phiên tự chủ dài hạn mà việc thất bại giữa chừng tốn kém | Fable 5 | Tư duy luôn bật, không có lỗi do tắt tư duy, không có bề mặt di chuyển mới |
| Đã ổn định trên Fable 5, khối lượng thấp | Fable 5 | Chi phí di chuyển vượt quá khoản tiết kiệm |
| Khai thác an ninh mạng hoặc nghiên cứu sinh học tự chủ | Không mô hình nào, xem bên dưới | Cả hai đều kém Mythos 5 về các lĩnh vực này |
Mô hình: **Opus 5 thắng về kinh tế thông lượng, Fable 5 thắng về rủi ro đuôi.** Nếu bạn chạy nhiều tác vụ và có thể chấp nhận một kết quả yếu hơn đôi khi, việc giảm một nửa hóa đơn là một bước đi rõ ràng. Nếu bạn chạy ít tác vụ và một kết quả xấu duy nhất tốn kém, sự chênh lệch giá không phải là điều bạn nên tối ưu.
Chạy so sánh trên khối lượng công việc của riêng bạn
Các thử nghiệm hiệu năng của nhà cung cấp cho bạn biết điều gì đã xảy ra với các tác vụ của người khác. Con số quyết định điều này cho bạn đến từ bộ đánh giá của riêng bạn, và việc thực hiện nó mất một buổi chiều. Cả hai mô hình đều nằm sau cùng một điểm cuối Tin nhắn (Messages), vì vậy việc so sánh chỉ là một thay đổi nhỏ về chuỗi:
curl https://api.anthropic.com/v1/messages \
  --header "x-api-key: $ANTHROPIC_API_KEY" \
  --header "anthropic-version: 2023-06-01" \
  --header "content-type: application/json" \
  --data '{
    "model": "claude-opus-5",
    "max_tokens": 8192,
    "output_config": {"effort": "high"},
    "messages": [
      {"role": "user", "content": "Refactor this handler and explain the tradeoffs."}
    ]
  }'
Thay `claude-opus-5` bằng `claude-fable-5` và bạn sẽ có phía còn lại của bài kiểm tra. Một thiết lập thực tế trong Apidog trông như thế này:
- Lưu khóa API dưới dạng biến môi trường để nó không bao giờ nằm trong phần thân yêu cầu, và tạo một môi trường cho mỗi mô hình với ID mô hình là một biến.
- Lưu yêu cầu trong một bộ sưu tập và chạy cùng một kịch bản trên cả hai môi trường, để điều duy nhất thay đổi là chuỗi mô hình.
- Đọc các trường `usage` trên mỗi phản hồi. So sánh các token đầu vào, đầu ra và đọc từ bộ nhớ đệm; đó là nơi sự khác biệt chi phí thực sự xuất hiện, vì Opus 5 có xu hướng tạo ra các phản hồi mặc định dài hơn.
- Kiểm tra luồng SSE và các payload gọi công cụ khi bạn so sánh hành vi tác nhân. Việc một mô hình thực thi một công cụ hay viết lệnh gọi ra dưới dạng văn bản có thể nhìn thấy trong luồng sự kiện thô.
- Lặp lại chạy Opus 5 ở mức nỗ lực `low`, `medium`, `high`, và `xhigh`. Câu hỏi thực sự thường không phải là “Opus 5 hay Fable 5” mà là “mức nỗ lực nào trên Opus 5 khớp với đầu ra của Fable 5 mà tôi đang trả tiền.”
Bước thứ năm là bước mà hầu hết các nhóm bỏ qua và là bước quyết định về tiền bạc. Tải xuống Apidog để thiết lập các môi trường, hoặc làm theo hướng dẫn yêu cầu đầy đủ trong hướng dẫn API Opus 5 của chúng tôi. Trang giá của Anthropic có các tỷ lệ chính thức cho cả hai mô hình.
Giới hạn trung thực
Không mô hình nào trong so sánh này là đỉnh cao trong bộ sản phẩm của Anthropic.
Fable 5 vẫn là mô hình mạnh nhất được Anthropic phát hành rộng rãi theo chỉ định của chính họ, và Opus 5 chưa giành được danh hiệu đó. Và trên cả hai, ở hai khía cạnh khả năng cụ thể, là Mythos 5: Anthropic tuyên bố rằng Opus 5 vẫn kém Mythos 5 về **khai thác an ninh mạng** và **nghiên cứu sinh học tự chủ**. Mythos 5 là phiên bản không bộ phân loại được phát hành cho Fable 5 cùng với một chương trình giới hạn thay vì cho công chúng nói chung, vì vậy nó không phải là một lựa chọn cho hầu hết các nhóm; so sánh Fable 5 với Mythos 5 của chúng tôi bao gồm điều kiện đủ.
Do đó, tóm tắt chính xác về Opus 5 hẹp hơn so với các tiêu đề: **khả năng đẳng cấp tiên phong với nửa giá của mô hình tiên phong, với một giới hạn được đặt tên ở trên nó.** Đó là một sản phẩm mạnh mẽ. Nó không phải là “mô hình tốt nhất giờ chỉ còn một nửa giá,” và bất kỳ ai bán cho bạn phiên bản đó đều đang bỏ qua phần mà chính Anthropic đã giữ vương miện khả năng cho mô hình đắt tiền hơn.
Câu hỏi thường gặp (FAQ)
Claude Opus 5 có tốt hơn Fable 5 không? Theo các thử nghiệm hiệu năng của Anthropic, Opus 5 vượt trội Fable 5 trong các tác vụ sử dụng máy tính OSWorld 2.0 và đạt trong vòng 0.5% so với hiệu suất đỉnh của Fable 5 trên CursorBench 3.2, cả hai đều với một phần chi phí nhỏ. Các con số này do nhà cung cấp tự chạy và chưa được tái tạo tính đến ngày 25 tháng 7 năm 2026. Anthropic vẫn chỉ định Fable 5 là mô hình mạnh nhất được phát hành rộng rãi của họ, vì vậy đối với các tác vụ khó nhất, Fable 5 vẫn giữ lợi thế.
Opus 5 rẻ hơn Fable 5 bao nhiêu? Chính xác một nửa ở cả hai phía: 5$/25$ cho mỗi triệu token đầu vào/đầu ra so với 10$/50$. Tỷ lệ API Batch của Opus 5 là 2.50$/12.50$ làm rộng thêm khoảng cách cho các công việc không khẩn cấp.
Mô hình nào có giới hạn kiến thức mới hơn? Opus 5, hơn bốn tháng. Giới hạn đáng tin cậy của nó là tháng 5 năm 2026; của Fable 5 là tháng 1 năm 2026.
Tôi có nên di chuyển khối lượng công việc Fable 5 của mình sang Opus 5 không? Trước tiên hãy tính toán về khối lượng. Dưới vài trăm tác vụ khó mỗi tháng, khoản tiết kiệm hiếm khi đủ để biện minh cho công việc di chuyển. Trên vài nghìn, chúng rõ ràng có ý nghĩa, với điều kiện bộ đánh giá của riêng bạn xác nhận chất lượng được giữ vững.
ID mô hình cho mỗi loại là gì? `claude-opus-5` và `claude-fable-5`, cả hai đều không có hậu tố ngày. Trên Amazon Bedrock, Opus 5 là `anthropic.claude-opus-5`.
Có tính năng nào Opus 5 hỗ trợ mà Fable 5 không có không? Opus 5 cung cấp tham số `output_config.effort` với các cấp độ được hiệu chỉnh lại, chấp nhận các tin nhắn hệ thống giữa cuộc trò chuyện, hỗ trợ chế độ nhanh ở mức 10$/50$, và lưu vào bộ nhớ đệm các lời nhắc ngắn đến 512 token. Một khoảng cách theo hướng ngược lại: Cấp độ ưu tiên (Priority Tier) không được hỗ trợ trên Opus 5, mặc dù Opus 4.8 vẫn giữ nó.
Câu trả lời ngắn gọn
Nửa giá là đáng giá đối với hầu hết các nhóm, và lý do là khối lượng chứ không phải khả năng. Các con số của Anthropic cho thấy Opus 5 đủ gần về mã hóa tác nhân và dẫn đầu về sử dụng máy tính, khiến khoản tiết kiệm gấp đôi tích lũy thành ngân sách thực tế ở hàng nghìn tác vụ mỗi tháng. Thêm vào giới hạn kiến thức tháng 5 năm 2026 mới hơn và công cụ điều chỉnh mức nỗ lực, câu trả lời mặc định là Opus 5.
Hãy giữ Fable 5 khi tác vụ nằm ở giới hạn của những gì bất kỳ mô hình nào có thể làm, khi một lần chạy lỗi duy nhất tốn kém hơn sự chênh lệch giá, hoặc khi khối lượng của bạn đủ thấp để công việc di chuyển lớn hơn khoản tiết kiệm. Và hãy coi mọi thử nghiệm hiệu năng ở đây như chính nó: một phép đo của nhà cung cấp, trên bộ thử nghiệm của nhà cung cấp, đang chờ người khác tái tạo. Bộ đánh giá của bạn là yếu tố quyết định.