
Đối với Claude Fable 5.2 so với Opus 5.5, hãy bắt đầu với Opus 5.5 cho công việc lập trình và tri thức hàng ngày. Hãy thử Fable 5.2 khi các tác vụ suy luận khó khăn, các dự án di chuyển mơ hồ hoặc các dự án agent kéo dài vượt quá khả năng nền tảng của Opus. So sánh mức cài đặt effort và chi phí trên mỗi kết quả được chấp nhận trước khi chuyển toàn bộ khối lượng công việc của bạn.
Khuyến nghị này dựa theo thông báo Fable 5.2 của Anthropic, đã kiểm tra vào ngày 10 tháng 11 năm 2026. Đây là bài so sánh dựa trên nguồn tài liệu; chúng tôi chưa chạy một bài benchmark đối đầu độc lập. Bài so sánh Opus 5 vs Fable 5 trước đây của chúng tôi bao gồm thế hệ cũ. Các mức giá, giá trị mặc định và bằng chứng dưới đây áp dụng cho các phiên bản mới hơn này.
Tổng quan nhanh: Claude Fable 5.2 so với Opus 5.5
| Điểm quyết định | Claude Fable 5.2 | Claude Opus 5.5 |
|---|---|---|
| Vai trò khởi đầu | Suy luận đòi hỏi cao và công việc agent dài hạn | Lựa chọn mặc định cho hầu hết khối lượng công việc |
| Model ID API của Claude | claude-fable-5-2 |
claude-opus-5-5 |
| Giá input tiêu chuẩn, mỗi triệu token | 8 đô la | 4 đô la |
| Giá output tiêu chuẩn, mỗi triệu token | 40 đô la | 20 đô la |
| Mức effort mặc định qua API | High | Medium |
| Cửa sổ ngữ cảnh | 1 triệu token | 1 triệu token |
| Output tối đa | 128 nghìn token | 128 nghìn token |
| Nhãn độ trễ so sánh | Trung bình | Trung bình |
Nguồn: tổng quan các mô hình Claude hiện tại. Cả hai mô hình đều nhận văn bản và hình ảnh, tạo văn bản, hỗ trợ công cụ (tools), và sử dụng tư duy thích ứng (adaptive thinking) luôn bật. Do đó, kích thước cửa sổ ngữ cảnh không phải điểm phân biệt. Khả năng hoàn thành tác vụ cụ thể của bạn mới là điều đáng lưu ý.
Mức giá token tiêu chuẩn của Fable cao gấp đôi Opus. Điều đó khiến Opus trở thành điểm khởi đầu hợp lý khi cả hai mô hình đều đáp ứng tiêu chí chấp nhận của bạn ở lượng token tương đương. Nhưng điều này không xác định được mô hình nào có hóa đơn thấp hơn khi độ sâu suy luận, số lần thử lại và lệnh gọi công cụ khác nhau.
Những tác vụ lập trình nào đáng để chuyển sang Fable 5.2?
Dùng Opus cho các thay đổi có giới hạn rõ ràng với các bước kiểm tra cụ thể. Hãy thử Fable khi agent phải tự khám phá vấn đề, phối hợp nhiều thay đổi phụ thuộc lẫn nhau, hoặc phục hồi từ một hướng đi thất bại. Đây là những khuyến nghị về khối lượng công việc được suy ra từ định vị và kết quả của Anthropic, chứ không phải bảo đảm đã đo lường cho codebase của bạn.
| Tác vụ của bạn | Lựa chọn khởi đầu | Bằng chứng đáng để nâng cấp |
|---|---|---|
| Thêm một endpoint đã được tài liệu hóa | Opus 5.5 | Lặp lại nhiều lỗi hợp đồng hoặc tích hợp |
| Cập nhật test sau một refactor nhỏ | Opus 5.5 | Agent không xác định được bất biến (invariant) đã thay đổi |
| Debug một lỗi chéo dịch vụ xuất hiện ngẫu nhiên | Opus, sau đó Fable | Opus lặp lại các bản sửa mà không kiểm thử các nguyên nhân cạnh tranh |
| Di chuyển một dịch vụ với các phụ thuộc không rõ ràng | So sánh cả hai | Fable hoàn thành nhiều thay đổi được chấp nhận hơn trong ngân sách |
| Phối hợp một dự án kỹ thuật dài hạn | Dùng thử Fable | Kế hoạch tốt hơn tồn tại qua giai đoạn thực thi và review |
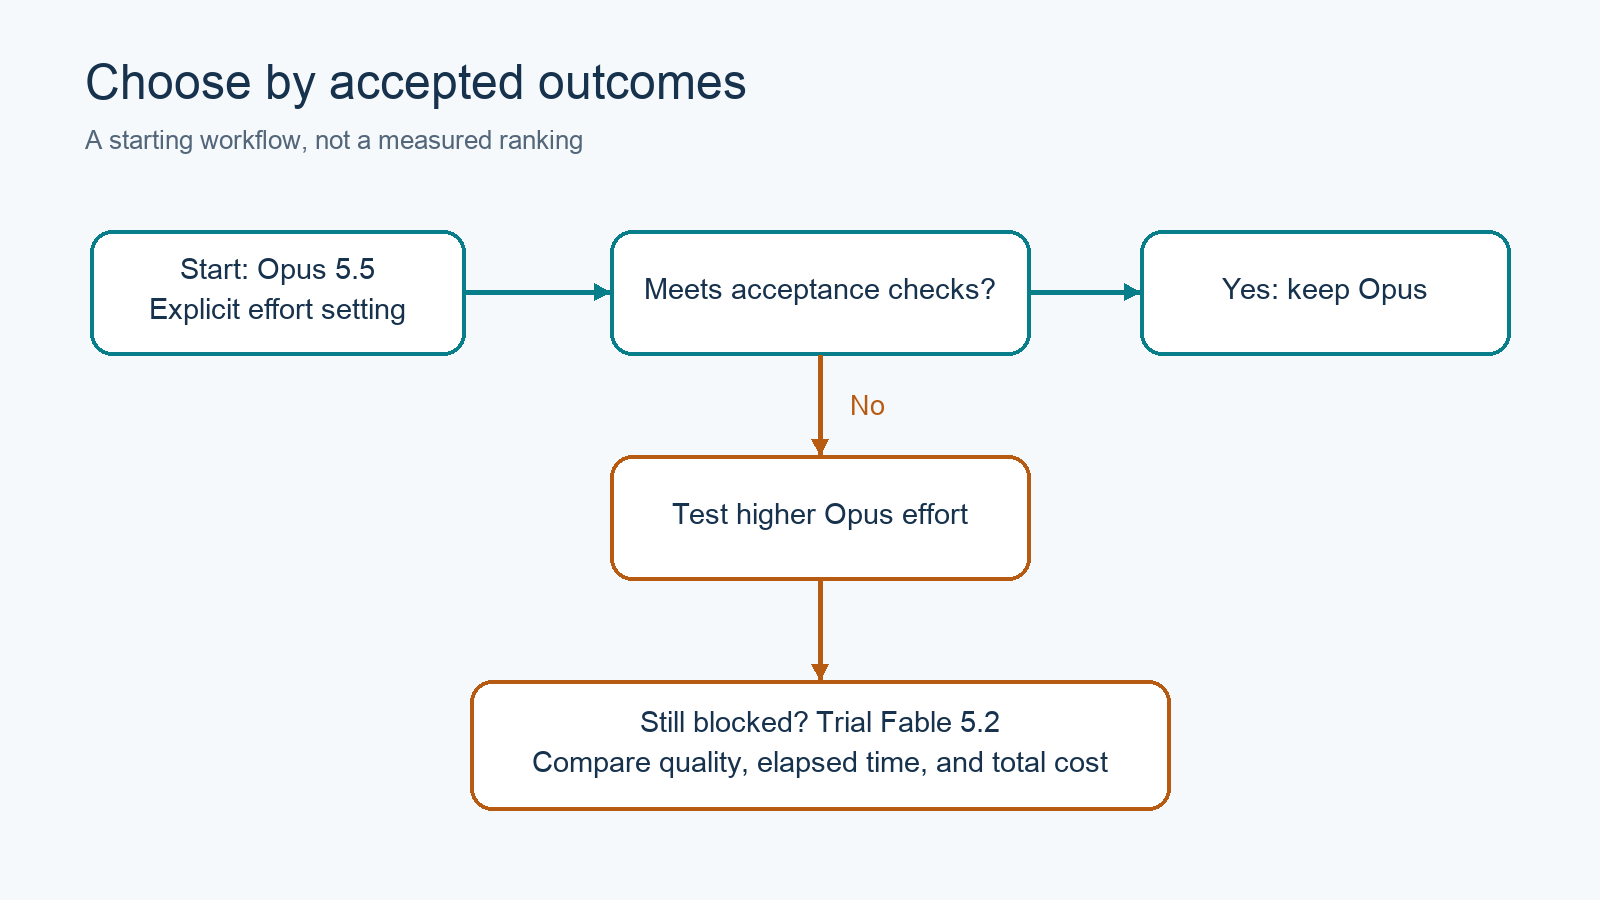
Nâng cấp có chọn lọc: giữ các tác vụ thông thường trên nền tảng cơ sở và giao công việc khó cho mô hình vượt qua các bước kiểm tra của bạn.
Hãy nghĩ đến một webhook thanh toán thỉnh thoảng xử lý một sự kiện hai lần. Nếu bản sửa đã được chỉ định sẵn, Opus có một tác vụ lập trình có giới hạn rõ ràng. Nếu agent phải tái dựng logic đồng thời (concurrency) qua các lần thử lại, bộ lưu trữ và các dịch vụ hạ nguồn, việc điều tra đó là ứng viên mạnh hơn cho một đợt dùng thử Fable.
Hãy cung cấp cho cả hai mô hình cùng bằng chứng sự cố và cùng ràng buộc. Một mô hình đắt hơn không thể bù đắp cho nhật ký thiếu sót, các phụ thuộc không truy cập được, hoặc một bài test chấp nhận khuyến khích hành vi sai.
Các benchmark của Anthropic cho thấy điều gì?
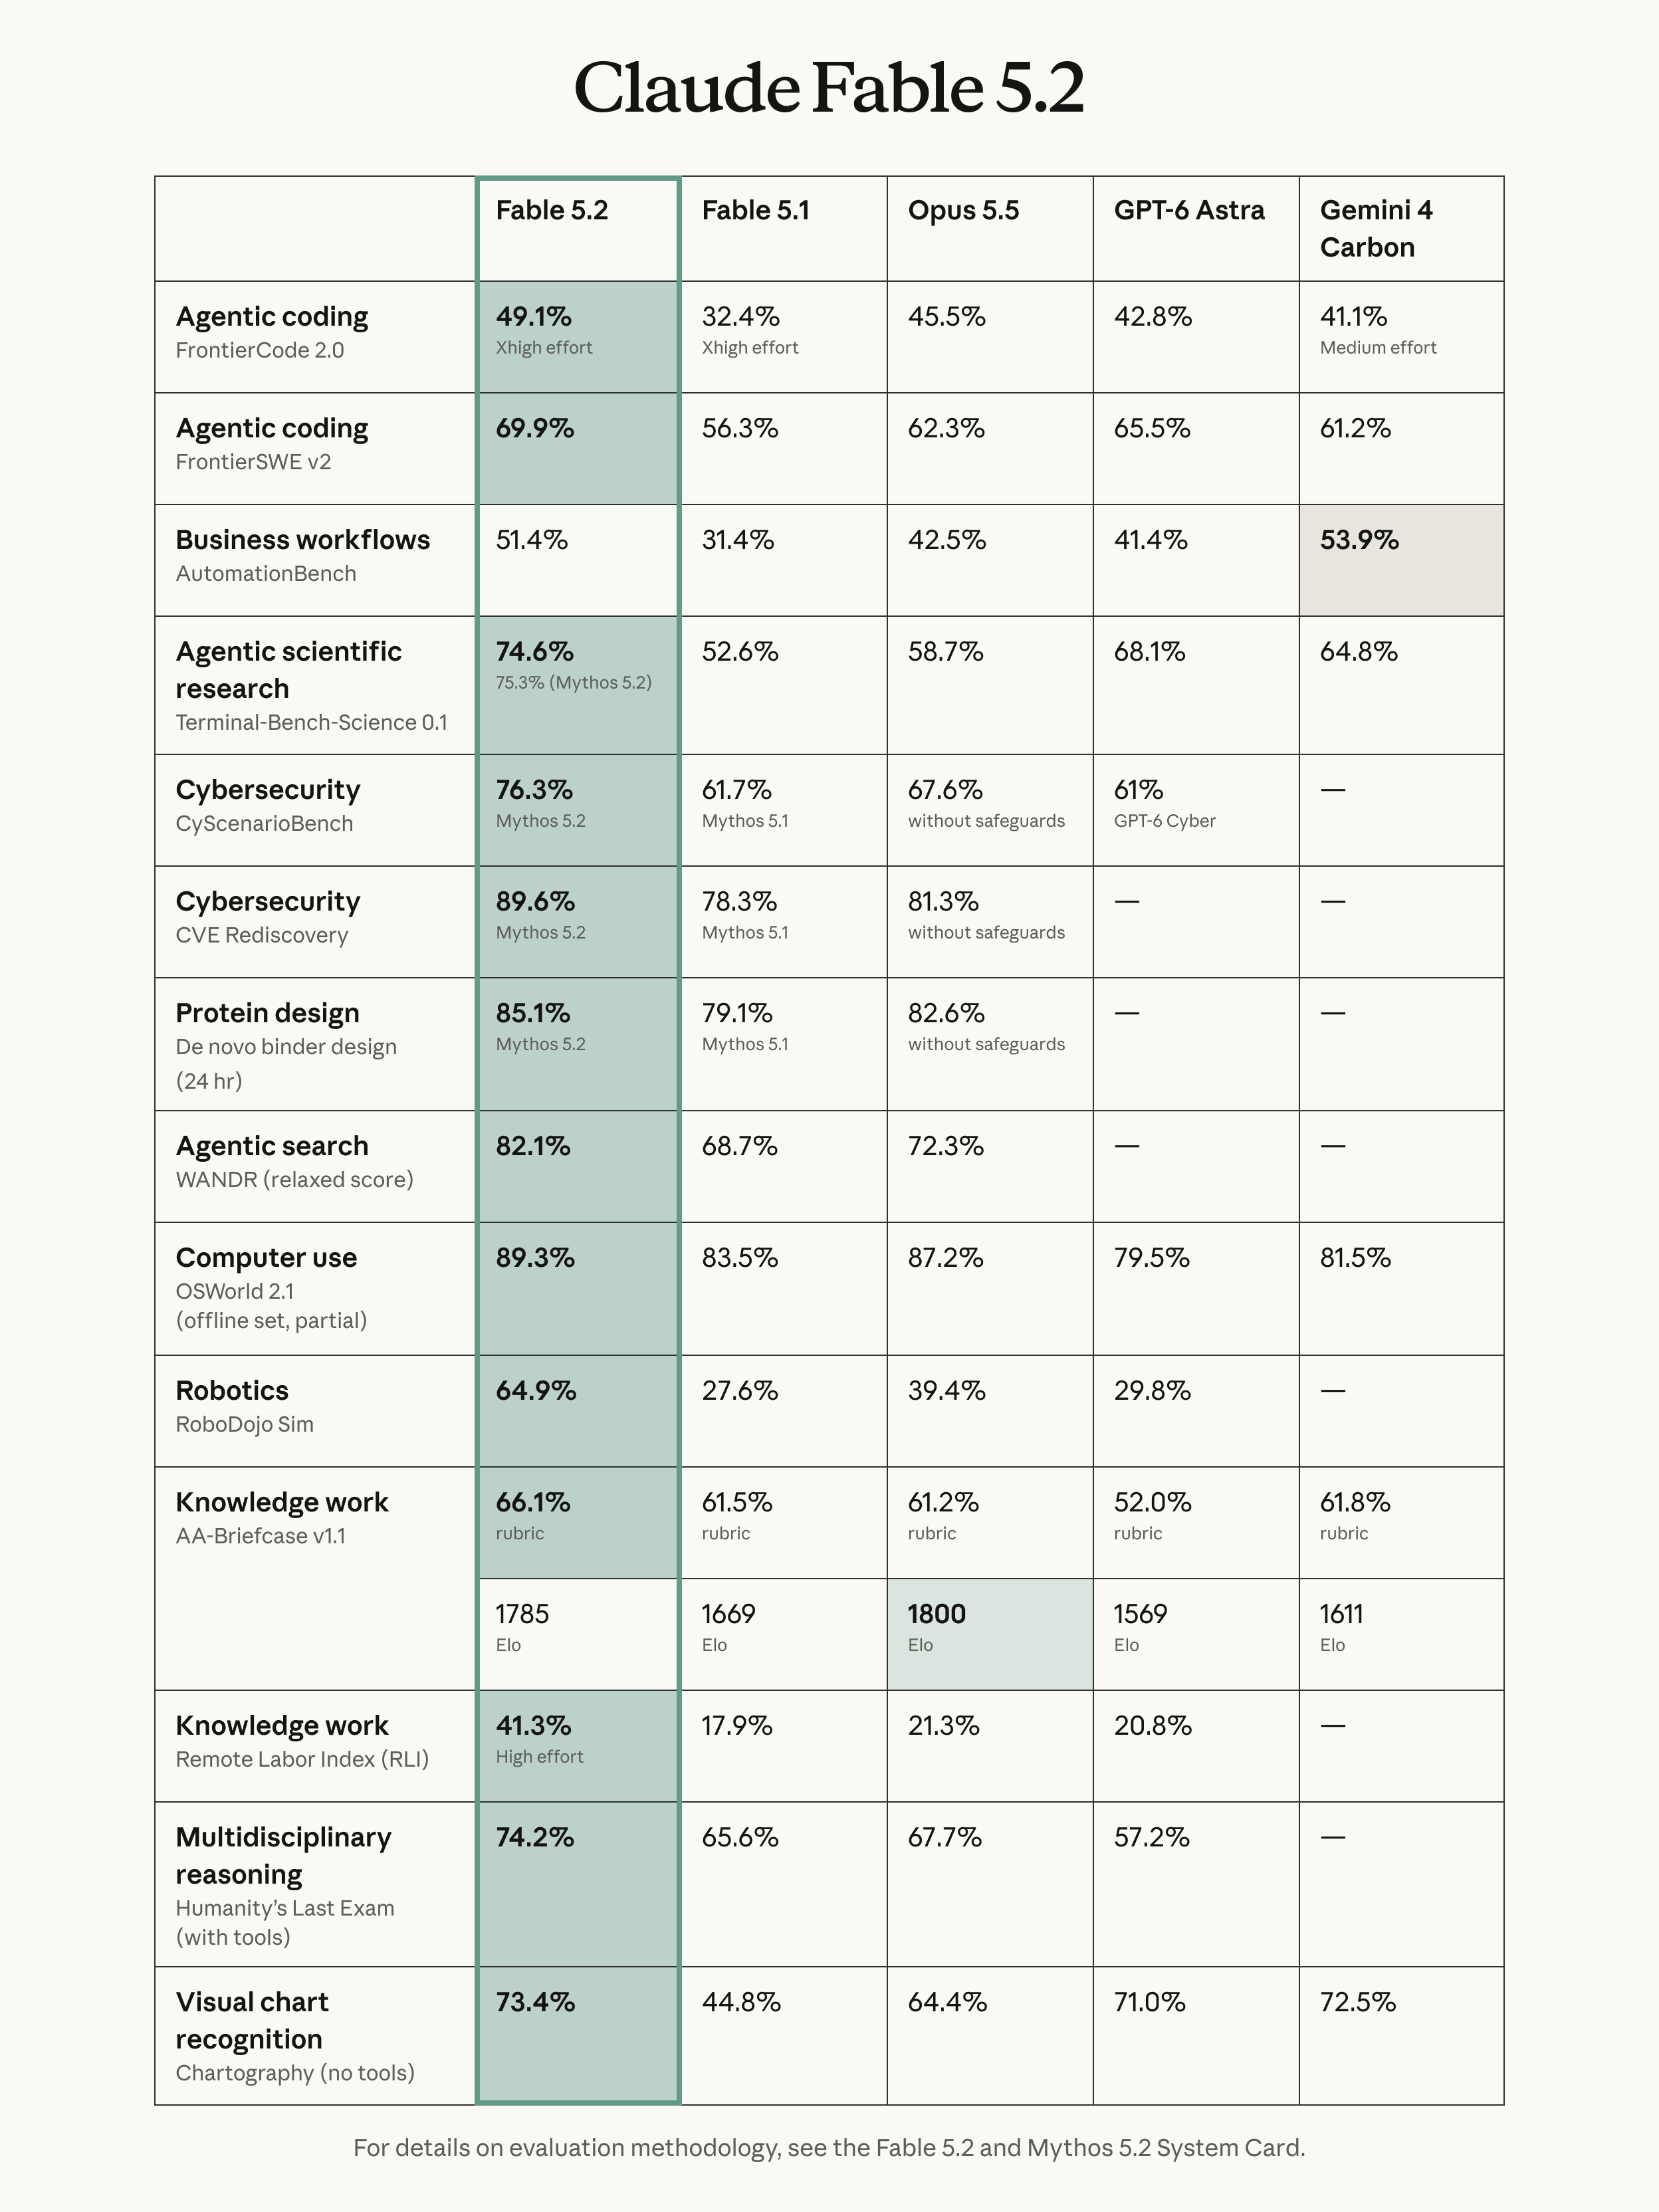
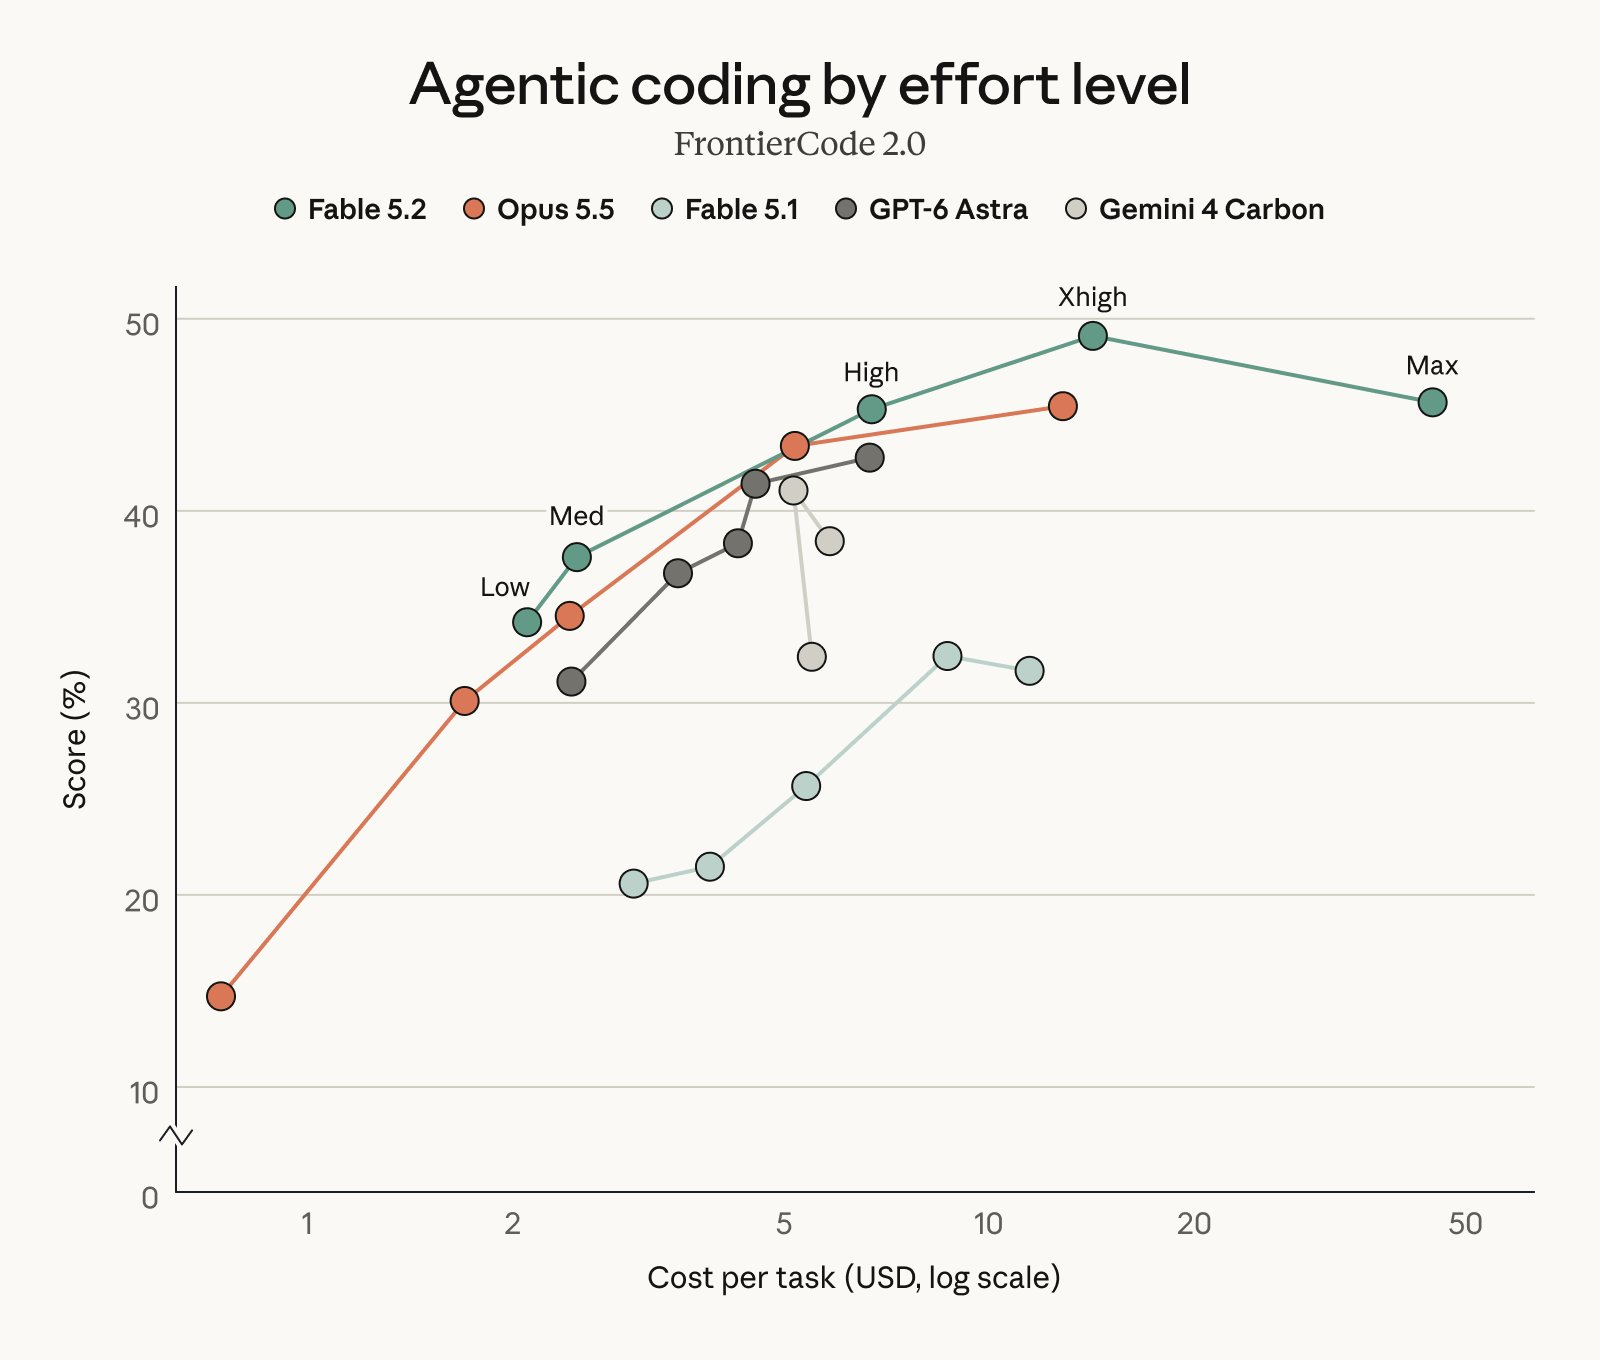
Anthropic báo cáo điểm Fable 5.2 cao hơn trên nhiều bài đánh giá lập trình và suy luận. Tín hiệu thực tế mạnh nhất là kết quả effort-so-với-chi phí: Fable ở mức High gần như ngang với Opus ở mức Max trên FrontierCode 2.0, với chi phí mỗi tác vụ chỉ bằng khoảng một nửa trong giai đoạn thử nghiệm ban đầu của Anthropic.
| Bài đánh giá do nhà cung cấp báo cáo | Fable 5.2 | Opus 5.5 |
|---|---|---|
| FrontierCode 2.0, lập trình agentic | 49,1% ở mức Xhigh | 45,5% |
| FrontierSWE v2, lập trình agentic | 69,9% | 62,3% |
| WANDR, tìm kiếm agentic, điểm nới lỏng | 82,1% | 72,3% |
| OSWorld 2.1, bộ offline một phần | 89,3% | 87,2% |
Các con số này đến từ thông báo chính thức, trong đó nêu rõ điểm số sử dụng mức effort cao nhất có sẵn trừ khi có ghi chú khác. Chúng mô tả điều kiện đánh giá của Anthropic, không phải cài đặt mặc định hay tỷ lệ đậu kỳ vọng trên các công việc của bạn.
So sánh chi phí còn hẹp hơn nữa. Fable ở mức High đạt 45,3%, so với 45,5% là điểm tốt nhất của Opus. Điều này ủng hộ việc thử cấu hình rẻ hơn cho bài đánh giá đó. Nhưng không có nghĩa là mọi quy trình làm việc với Fable đều có chi phí bằng một nửa so với Opus.
Tránh biến một con số phần trăm benchmark thành dự báo năng suất. Điểm lập trình không đo lường hàng đợi review của bạn, rủi ro triển khai, hay thời gian sửa một bản di chuyển sai. Cũng hãy loại trừ các kết quả an ninh mạng và sinh học chỉ dành cho Mythos khỏi bảng điểm của Fable: thông báo xác định có một mô hình nền tảng dùng chung nhưng với các biện pháp bảo vệ và quyền truy cập khác nhau.
Cài đặt effort thay đổi cuộc so sánh
Hãy đặt effort một cách tường minh khi so sánh các mô hình. Giá trị mặc định qua API là High cho Fable 5.2 và Medium cho Opus 5.5. Thông báo của Anthropic cũng mô tả riêng rằng Medium là mặc định trong các ứng dụng Claude và Claude Code. Hãy ghi rõ sản phẩm và cài đặt thay vì giả định một giá trị mặc định áp dụng cho mọi nơi.
Tài liệu về effort định nghĩa các mức low, medium, high, xhigh và max cho cả hai mô hình. Effort ảnh hưởng đến văn bản phản hồi, tham số công cụ và tư duy. Đây là tín hiệu hành vi, không phải giới hạn chi tiêu cứng.
Bắt đầu với cấu hình Opus đang hoạt động tốt của bạn. Nếu chưa đủ, hãy so sánh mức effort cao hơn của Opus với Fable ở mức Medium hoặc High. Dành các đợt thử Xhigh và Max cho những tác vụ mà phần suy luận bổ sung có khả năng mang lại lợi ích và bạn có thể chấp nhận chi phí.
Một cuộc so sánh cùng mức effort trả lời một câu hỏi: các mô hình này hành xử ra sao dưới cùng một cài đặt có tên? Một cuộc so sánh cân bằng chi phí trả lời câu hỏi khác: cấu hình nào tạo ra kết quả chấp nhận được mạnh nhất với ngân sách của bạn? Không cái nào thay thế được cái kia.
Độ trễ: đo cả tác vụ
Cả hai mô hình đều mang nhãn độ trễ so sánh ở mức Trung bình trong tổng quan của Anthropic. Không có người thắng tuyệt đối từ nhãn đó. Hãy đo thời gian đến một kết quả đã được review, bao gồm cả công cụ và các lần thử lại, thay vì coi tốc độ output là tốc độ của toàn bộ quy trình phát triển của bạn.
Anthropic cho biết Fable 5.2 tạo output nhanh hơn tới 30% so với Fable 5.1. So sánh đó là với thế hệ trước, không phải Opus 5.5. Chế độ nhanh tùy chọn của nó cung cấp tốc độ tạo token nhanh hơn tới 2,5 lần — cũng chỉ là tuyên bố của nhà cung cấp chứ không phải mức giảm đã đo lường trong thời gian tác vụ của bạn.
Một tác vụ bị chi phối bởi biên dịch hay một cơ sở dữ liệu chậm sẽ không tăng tốc tương ứng với tốc độ tạo token nhanh hơn. Ngược lại, một agent tránh được hai hướng đi thất bại có thể hoàn thành sớm hơn dù tạo token chậm hơn. Hãy theo dõi riêng từng yếu tố trước khi trả tiền cho tốc độ.
So sánh chi phí trên mỗi kết quả được chấp nhận
Hãy dùng tổng chi tiêu của quy trình làm việc chia cho số kết quả được chấp nhận làm chỉ số quyết định. Giá token xác định đơn giá, nhưng lượng token, caching, các lần thử thất bại, công cụ và review mới xác định thứ bạn mua. Phép tính dưới đây chỉ mang tính minh họa, không phải đo lường hành vi của mô hình nào.
Giả sử một yêu cầu tiêu tốn 100.000 token input không cache và 10.000 token output, với định tuyến toàn cầu tiêu chuẩn và không có phí công cụ bổ sung:
| Cấu hình | Chi phí input | Chi phí output | Tổng |
|---|---|---|---|
| Opus 5.5 tiêu chuẩn | 0,40 đô la | 0,20 đô la | 0,60 đô la |
| Fable 5.2 tiêu chuẩn | 0,80 đô la | 0,40 đô la | 1,20 đô la |
| Opus 5.5 fast | 0,80 đô la | 0,40 đô la | 1,20 đô la |
| Fable 5.2 fast | 1,60 đô la | 0,80 đô la | 2,40 đô la |
Các mức giá đã được đối chiếu với tài liệu định giá của Anthropic vào ngày 10 tháng 11 năm 2026. Các hạn mức của gói đăng ký đăng ký tách biệt với mức giá API này. Các nhà cung cấp đám mây, caching, tùy chọn định vị dữ liệu và các tính năng khác có thể thay đổi hóa đơn.
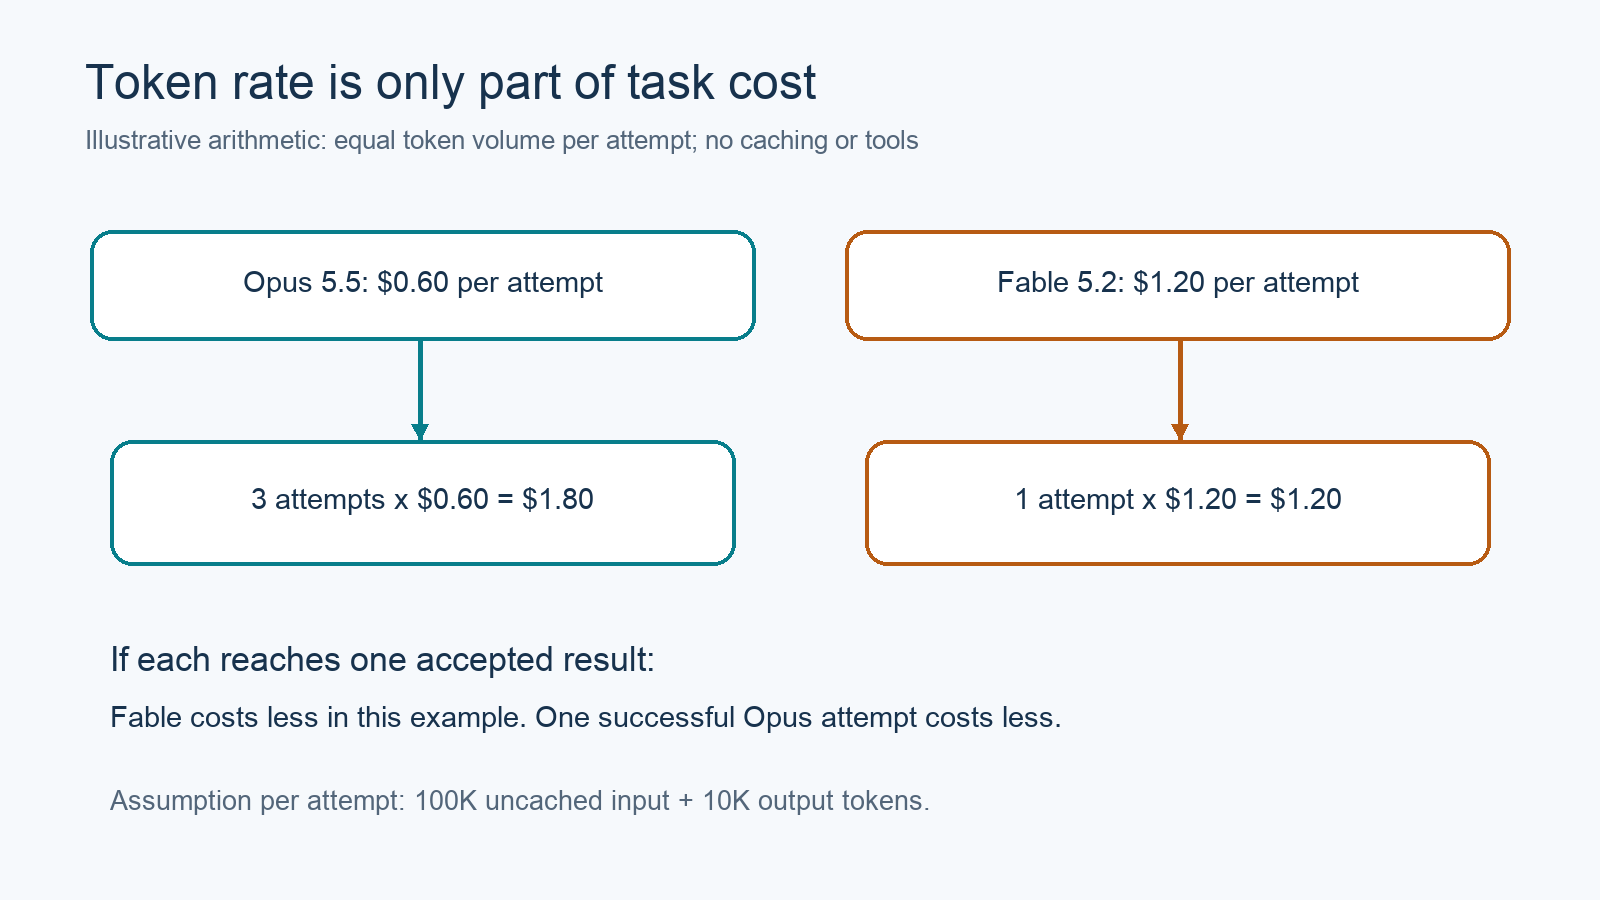
Hãy so sánh tất cả các lần thử cần thiết để có được một kết quả thành công, bao gồm cả lần thử lại và review.
Trong ví dụ đơn giản hóa này, ba lần thử Opus với cùng dung lượng tốn 1,80 đô la; một lần thử Fable tốn 1,20 đô la. Điều đó khiến Fable rẻ hơn chỉ khi nó đạt kết quả được chấp nhận trong đúng một lần thử đó. Một lần thử Opus thành công vẫn rẻ hơn. Các lần thử lại thực tế thường tiêu tốn dung lượng khác nhau, vì vậy hãy dùng dữ liệu sử dụng đã ghi nhận thay vì nhân một con số trung bình phỏng đoán.
Hãy đặt thời gian review kỹ thuật bên cạnh chi tiêu API. Một bản vá vượt qua test nhưng đòi hỏi sửa chữa đáng kể chưa vượt qua cùng một chuẩn với một bản vá sẵn sàng review.
Cho phép agent lập trình của bạn kiểm tra API bằng Apidog CLI
Dùng Apidog CLI để agent lập trình của bạn tạo và chạy các bước kiểm tra API có thể lặp lại. Các bước kiểm tra này có thể phát hiện sự hồi quy ở request hoặc response khi bạn đổi mô hình. Chúng không xác định được liệu các thay đổi của agent trong codebase có đúng hay không; hãy giữ các test trên codebase và review của con người song song với chúng.
Cài đặt CLI, sau đó cho agent của bạn đọc hướng dẫn cài đặt chính thức:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_APIDOG_TOKEN>
Đưa cho Claude Code hoặc agent bạn ưu tiên prompt này:
Read https://apidog.com/apidog-cli-installation-guide.md.
In project <PROJECT_ID>, create a test case for our Claude Messages
request. Compare claude-opus-5-5 and claude-fable-5-2 using the same
prompt and explicit medium effort. Keep API credentials in private
variables. Assert the expected status and response structure, record
usage and elapsed time, and summarize failures. Don't claim these
checks measure coding quality. Validate every write payload first.
Agent sẽ kiểm tra schema, chọn một danh mục test case hợp lệ, tạo case.json, sau đó chạy các lệnh như sau. Các cờ (flags) đã được đối chiếu với phần trợ giúp của CLI 2.2.12 đã cài đặt:
apidog test-case category --project <PROJECT_ID>
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <PROJECT_ID> --file case.json
apidog run --test-case <CASE_ID> --project <PROJECT_ID> \
  -e <ENVIRONMENT_ID> -r cli,json
Thay các placeholder bằng tài nguyên dự án của bạn. Đây là một mẫu quy trình làm việc, không phải một cuộc so sánh mô hình đã thực thi. Hãy làm theo hướng dẫn Apidog CLI trong Claude Code hoặc hướng dẫn tích hợp Codex để thiết lập agent.
Câu hỏi thường gặp
Fable 5.2 có tốt hơn Opus 5.5 cho mọi tác vụ lập trình không?
Không. Anthropic khuyến nghị Opus 5.5 cho hầu hết các tác vụ lập trình và tri thức. Fable đáng để thử khi công việc khó vượt quá nền tảng đó. Điểm benchmark của nhà cung cấp cao hơn không bảo đảm kết quả tốt hơn trên mọi tác vụ.
Fable 5.2 có đắt gấp đôi không?
Mức giá token input và output tiêu chuẩn của nó cao gấp đôi Opus 5.5. Tổng chi phí mỗi tác vụ có thể khác nhau vì các cấu hình tiêu tốn lượng token khác nhau và đòi hỏi số lần thử khác nhau.
Bạn có nên luôn dùng mức effort tối đa không?
Không. Hãy so sánh các cài đặt với các bước kiểm tra chấp nhận và ngân sách của bạn. Mức effort cao hơn cho phép chi tiêu token nhiều hơn; nó không bảo đảm cải thiện hữu ích cho một tác vụ có giới hạn rõ ràng.
Fable 5.2 có nhanh hơn Opus 5.5 không?
Các nguồn được xem xét ở đây không xác định được người thắng tuyệt đối về độ trễ đối đầu. Cả hai đều có nhãn độ trễ Trung bình. Hãy đo quy trình làm việc thực tế của bạn và coi chế độ fast là một cấu hình riêng biệt.
Apidog có thể quyết định mô hình nào viết code tốt hơn không?
Apidog CLI có thể giúp agent của bạn chạy các bước kiểm tra API và thu thập bằng chứng phản hồi. Chất lượng code vẫn cần test trên codebase và review. Hãy dùng các kết quả được chấp nhận đó để quyết định mô hình và cài đặt effort nào xứng đáng với chi phí của chúng.