
Chain of Recall là phương pháp cung cấp bộ nhớ cho một AI agent chạy dài hạn (long-running agent) mà không cần nhồi nhét mọi thứ vào cửa sổ ngữ cảnh (context window). Mỗi Trigger, Thread và Worker đều được gán một ID cố định. Ngữ cảnh chỉ lưu giữ các ID, tóm tắt ngắn gọn cùng những tin nhắn lân cận, và agent sẽ lần theo các liên kết giữa các ID để truy xuất lại dữ liệu cũ hơn chỉ sau vài bước nhảy (hops).
Thuật ngữ này bắt nguồn từ bài viết phân tích thiết kế của DeepSeek Harness mang tên “Exploring Super-agent Design”, xuất bản ngày 01-11-2026. Một lưu ý trước khi đi sâu hơn: bài viết này mô tả một kiến trúc, không phải một tính năng đã phát hành hoàn chỉnh. Một số thành phần của nó nằm trong plugin nguyên mẫu dsh-superagent-prototype, được các tác giả gọi là “không phải sản phẩm chính thức của DeepSeek.” Không có công tắc nào để bạn chỉ việc bật Chain of Recall lên. Đây là một mô hình kiến trúc (pattern) mà bạn phải tự xây dựng.
Vấn đề về cửa sổ ngữ cảnh trong agent chạy dài hạn
Một agent chạy dài hạn sớm muộn cũng sẽ chạm giới hạn ngữ cảnh vì khối lượng công việc liên tục đổ về. Một super-agent theo dõi tin nhắn chat, GitHub và hệ thống CI phải xử lý hàng trăm sự kiện mỗi ngày, và cửa sổ ngữ cảnh chứa công việc của ngày hôm qua không thể nào gánh thêm cả phần việc của ngày hôm nay.
Những cách xử lý thông thường đều phải đánh đổi:
- Giữ lại tất cả. Cửa sổ ngữ cảnh nhanh chóng bị lấp đầy và chi phí tăng vọt theo từng lượt tương tác.
- Tóm tắt các lượt trao đổi cũ. Bản tóm tắt thường vô tình làm mất thông báo lỗi chính xác hoặc số hiệu PR cụ thể mà bạn cần dùng sau này.
- Truy xuất theo độ tương đồng ngữ nghĩa. Hoạt động ổn cho đến khi thông tin bạn cần tìm lại không hề dùng từ ngữ tương tự như câu truy vấn của bạn.
Tài liệu hướng dẫn của Anthropic về context engineering cho AI agent định nghĩa ngữ cảnh là một nguồn tài nguyên hữu hạn cần được chọn lọc kỹ càng. Chain of Recall là một giải pháp cụ thể cho quá trình chọn lọc đó, và bài viết giải thích của chúng tôi về cơ chế hoạt động của bộ nhớ AI agent sẽ cung cấp một bức tranh toàn diện hơn về các lựa chọn khác.
Inline và spill: xem ngữ cảnh như một bộ nhớ đệm (cache)
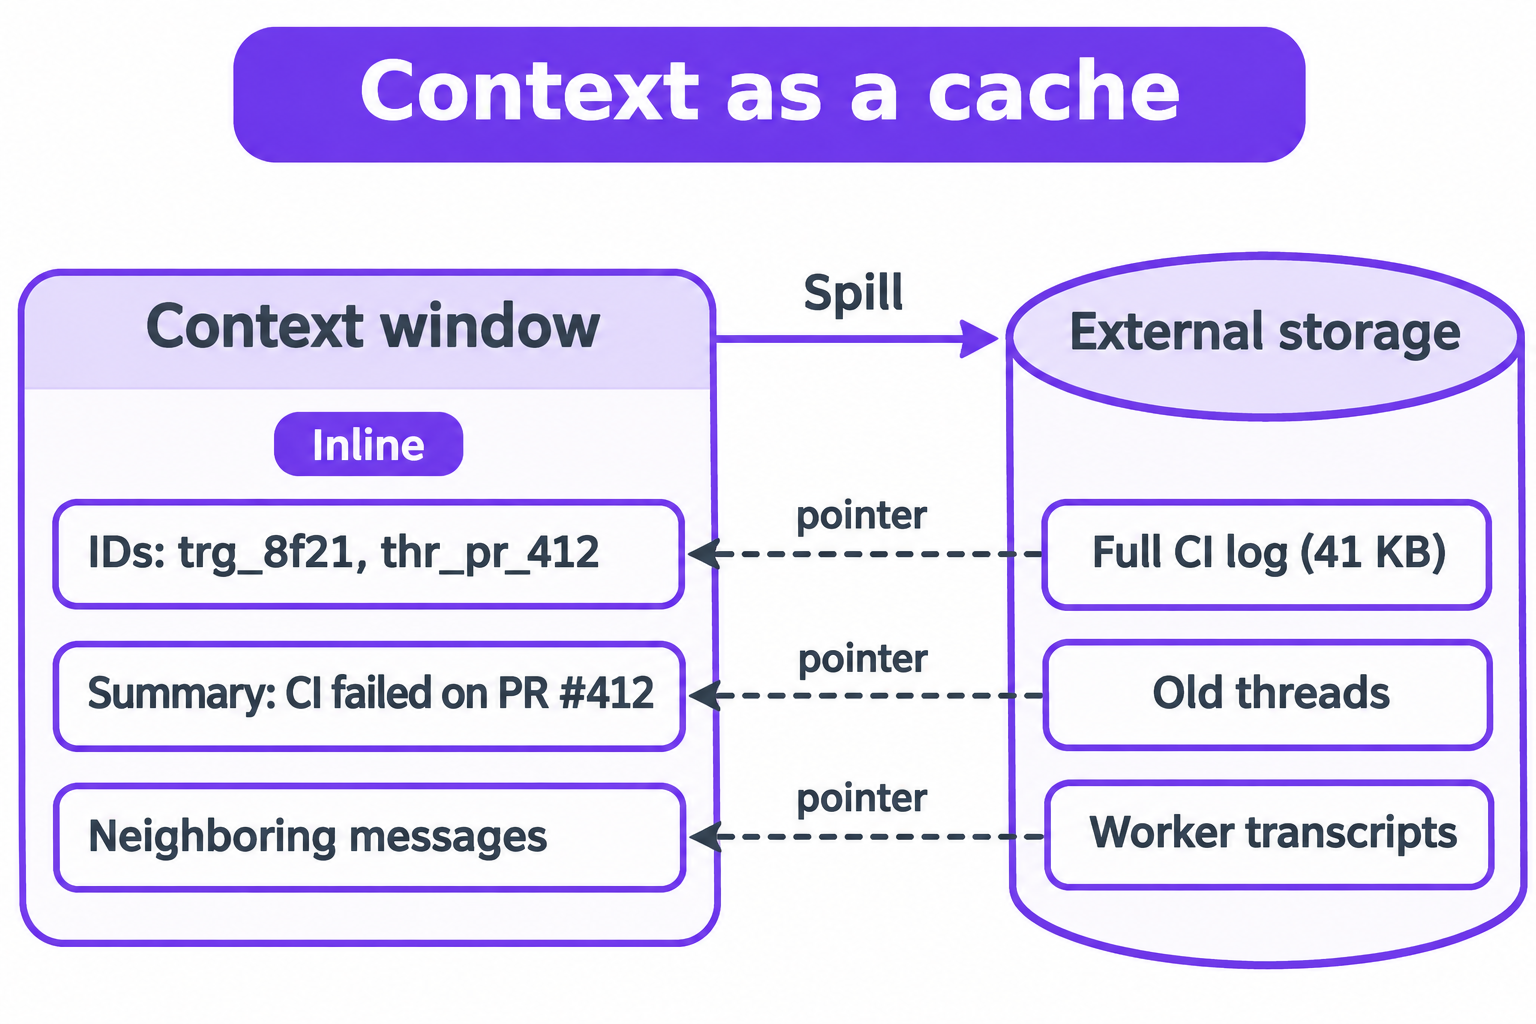
Bài viết tiếp cận cửa sổ ngữ cảnh như một bộ nhớ cache với hai thao tác chính:
- Inline những thông tin agent có thể cần ngay lập tức: các ID, phần tóm tắt ngắn và các tin nhắn lân cận.
- Spill mọi thứ còn lại: cắt ngắn nội dung và để lại một con trỏ (pointer) để agent có thể truy xuất sau khi cần.
Một mục dữ liệu khi bị "spill" không hề bị xóa bỏ; chỉ có con trỏ của nó được giữ lại trong prompt.
Dưới đây là ví dụ minh họa về một thông báo lỗi CI gửi đến Router. Cấu trúc này mang tính minh họa, không phải mã nguồn chính thức của DeepSeek:
{
  "trigger_id": "trg_8f21",
  "source": "github.check_run",
  "thread_id": "thr_pr_412",
  "summary": "CI failed on PR #412: 3 of 118 tests red in payments/",
  "neighbours": ["trg_8f1c: review comment asking for retry logic"],
  "spilled": {
    "full_log": "GET /triggers/trg_8f21/payload (41 KB, truncated)"
  }
}
Nếu dòng tóm tắt một câu là đủ dùng, agent sẽ không bao giờ phải tốn tài nguyên cho file log nặng 41 KB. Nếu cần thiết, nó sẽ chủ động fetch toàn bộ log thông qua ID.
ID cố định và đồ thị tham chiếu
Chain of Recall phát huy hiệu quả vì các ID không bao giờ thay đổi. Trong thiết kế của bài viết, có ba loại đối tượng mang các ID này:
| Đối tượng | Bản chất | ID ví dụ |
|---|---|---|
| Trigger | Một sự kiện gửi đến: tin nhắn chat, webhook, callback từ CI | trg_8f21 |
| Thread | Một chuỗi các sự kiện liên quan trên một PR, chủ đề IM hoặc luồng email | thr_pr_412 |
| Worker | Một phiên agent độc lập đảm nhận xử lý một tác vụ | wkr_77a0 |
Một Trigger thuộc về một Thread, một Thread do một hoặc nhiều Worker đảm nhiệm, và báo cáo của Worker sẽ dẫn chiếu đến các Trigger mà nó đã xử lý. Các mối liên kết này tạo thành một đồ thị tham chiếu (reference graph), và chính đồ thị đó là bộ nhớ của agent.
Quá trình truy hồi (recall) diễn ra bằng cách lần theo từng liên kết một bước (hop), thay vì phải nạp toàn bộ lịch sử hay tìm kiếm văn bản tương đồng. Bài viết hướng dẫn song hành về cách xây dựng super-agent sẽ giải thích chi tiết vị trí của Trigger, Thread và Worker trong toàn bộ mô hình Router và Worker.
Quy trình truy hồi qua nhiều bước nhảy (multi-hop)
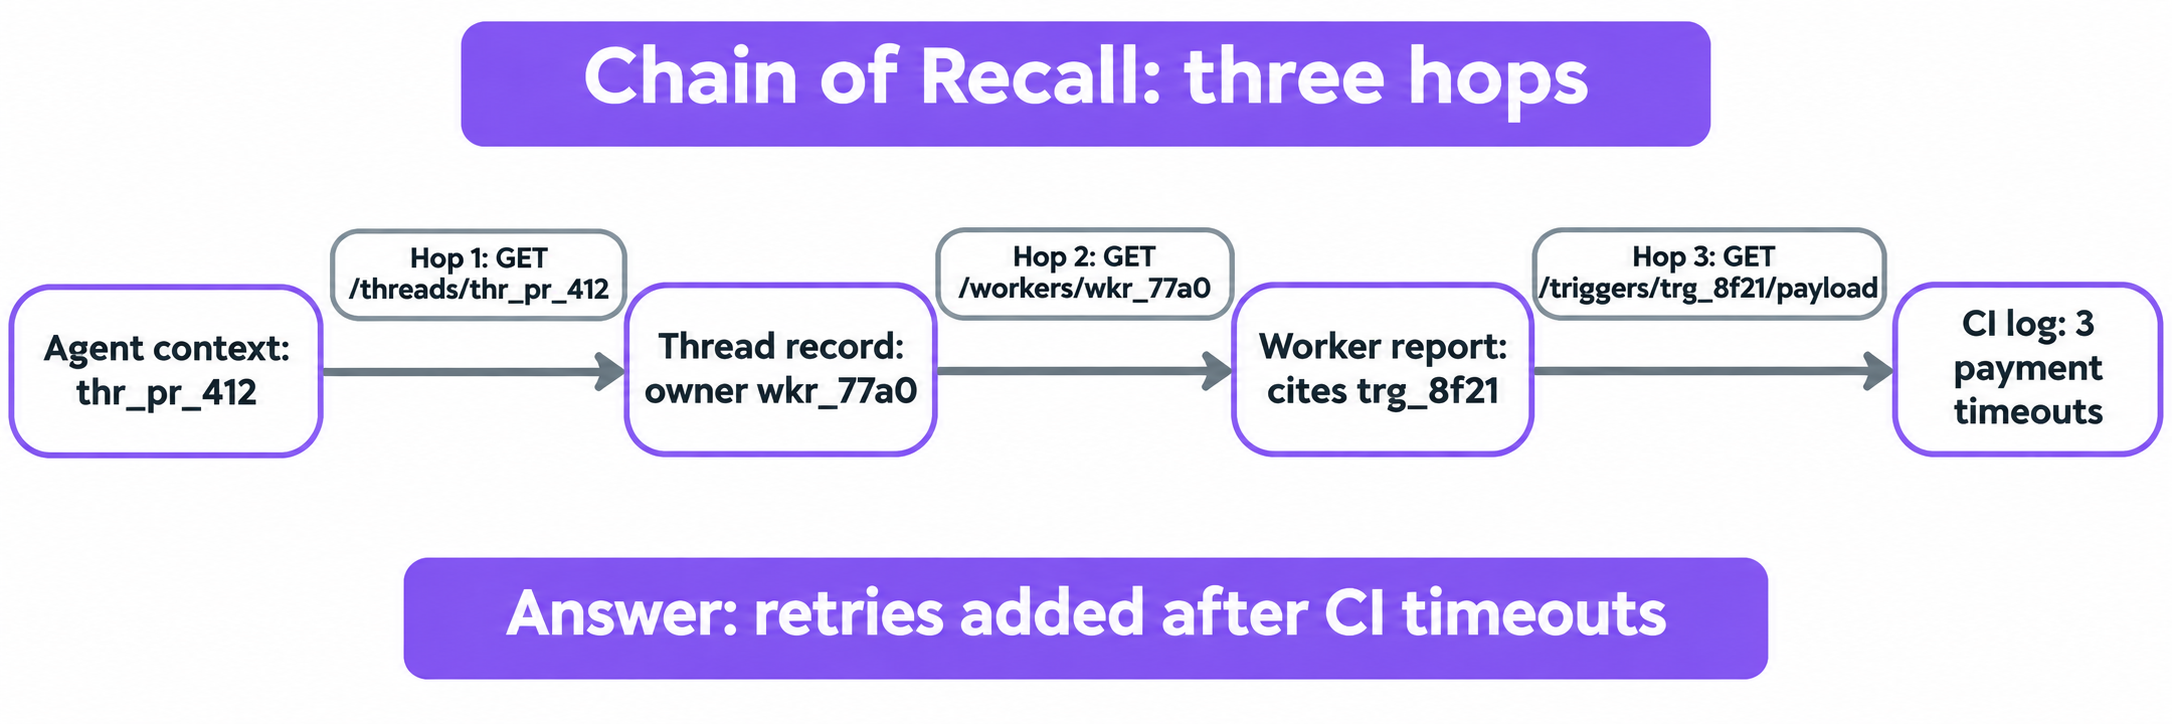
Giả sử vào thứ Sáu, một đồng nghiệp hỏi Router: “Tại sao chúng ta lại thêm logic retry vào payment client?” Cuộc thảo luận ban đầu diễn ra từ thứ Ba và đã bị spill từ lâu. Đây là các bước agent thực hiện:
- Bước 1: Tìm Thread. Ngữ cảnh của Router vẫn còn lưu một mục chỉ mục một dòng:
thr_pr_412: payments retry PR, merged Wed. Nó gửi yêu cầuGET /threads/thr_pr_412. - Bước 2: Tìm Worker. Bản ghi Thread liệt kê
owner_workers: ["wkr_77a0"]. Router tiếp tục gọiGET /workers/wkr_77a0và đọc báo cáo cuối cùng của worker này. - Bước 3: Tìm nguyên nhân. Báo cáo dẫn chiếu đến
trg_8f21, sự kiện CI bị lỗi. Router lấy payload của Trigger đó và đọc các lỗi timeout trong log. - Câu trả lời. “CI trên PR #412 bị thất bại do 3 lỗi timeout thanh toán vào thứ Ba. Worker wkr_77a0 đã thêm logic retry kèm backoff và PR đã được merge vào thứ Tư.”
Chỉ với ba lượt truy xuất nhỏ và chính xác tuyệt đối. Không có gì phải suy đoán, và cũng không có thông tin dư thừa nào phải nằm trong prompt suốt ba ngày.
So sánh Chain of Recall với bộ nhớ vector và tóm tắt
Chain of Recall không thay thế các kỹ thuật quản lý bộ nhớ khác, mà trả lời cho một câu hỏi khác. Truy xuất vector, được phổ biến qua bài báo khoa học về retrieval-augmented generation (RAG), trả lời câu hỏi: “Thông tin nào tương tự như thế này?” Còn Chain of Recall trả lời câu hỏi: “Thông tin nào được liên kết với đối tượng này?”
| Chain of Recall | Bộ nhớ Vector (RAG) | Tóm tắt cuộn (Rolling summaries) | Memory MCP server | |
|---|---|---|---|---|
| Cơ chế truy hồi | Lần theo các liên kết ID cố định | Tìm kiếm tương đồng trên embedding | Đọc lại phần lịch sử đã nén | Gọi công cụ bộ nhớ do server cung cấp |
| Độ chính xác | Bản ghi chính xác tuyệt đối theo ID | Xấp xỉ, xếp hạng theo điểm số | Mất chi tiết do bản chất tóm tắt | Phụ thuộc vào kho lưu trữ của server |
| Phù hợp nhất cho | Lịch sử sự kiện: PR, ticket, lượt chạy CI | Tập tài liệu lớn, câu hỏi tìm kiếm mờ | Phiên ngắn, duy trì mạch hội thoại | Dữ liệu dùng chung giữa các công cụ và phiên làm việc |
| Yêu cầu kỹ thuật | ID bất biến, các API truy xuất theo ID | Embedding model và index | Một lượt xử lý tóm tắt | Một MCP server đang chạy |
| Điểm yếu | Không thể tìm thấy thứ không được liên kết | Bỏ sót dữ liệu nếu diễn đạt khác đi | Đánh mất thông tin chi tiết | Phải vận hành và bảo mật thêm một dịch vụ |
Trong thực tế, bạn sẽ kết hợp chúng: dùng vector index để tìm ra Thread ID khởi đầu, sau đó dùng Chain of Recall để lần tới các dữ kiện chính xác. Mô hình phân cấp bộ nhớ theo kiểu hệ điều hành trong bài báo về MemGPT cũng là một khái niệm tương đồng. Nếu bạn muốn bắt đầu ngay với một kho lưu trữ có sẵn, hãy xem hướng dẫn của chúng tôi về cách bổ sung bộ nhớ bền vững cho AI agent bằng MCP.
Có hai hạn chế cần lưu ý: Bài viết của DeepSeek xếp bộ nhớ dài hạn vào nhóm các bài toán mở và không khẳng định Chain of Recall đã giải quyết triệt để vấn đề này. Ngoài ra, trong thử nghiệm của họ, việc loại bỏ tính năng chuyển tiếp Thread (Thread pass-through) đã làm số token đọc từ cache tăng từ 23,2 triệu lên 31,8 triệu mỗi lần chạy (khoảng 37%): đây là chi phí phát sinh do thiếu tính năng, chứ không phải lượng token tiết kiệm được nhờ Chain of Recall.
Những cam kết bắt buộc của các API bên dưới
Mỗi bước nhảy trong quy trình truy hồi đều là một lệnh gọi API. Nếu một lệnh gọi trả về bản ghi sai lệch hoặc không trả về gì, chuỗi liên kết sẽ bị đứt và agent sẽ rơi vào trạng thái bế tắc hoặc tự đưa ra câu trả lời dựa trên phỏng đoán. Do đó, các API hỗ trợ Chain of Recall phải tuân thủ bốn nguyên tắc giao ước sau:
- ID không bao giờ được thay đổi. Một ID trả về hôm nay phải trỏ tới đúng đối tượng đó vào tháng sau. Không tái sử dụng ID đã xóa, không đánh số lại sau khi chuyển đổi cơ sở dữ liệu (migration).
- Truy xuất theo ID phải nhẹ và chính xác tuyệt đối.
GET /threads/{id}chỉ trả về duy nhất bản ghi đó. Nó không thực hiện tìm kiếm và không bao giờ trả về "kết quả gần đúng nhất". - Báo lỗi rõ ràng khi không tìm thấy ID. Một ID không tồn tại phải trả về mã lỗi
404 Not Foundđúng chuẩn RFC 9110 kèm nội dung thông báo lỗi rõ ràng. Việc trả về mã200kèm một object rỗng sẽ khiến agent hiểu lầm rằng dữ liệu đó có tồn tại. - Phân trang qua Cursor phải liên tục, không bị sót. Endpoint
GET /threads/{id}/events?cursor=dùng để duyệt qua một Thread dài theo đúng thứ tự. Mọi sự kiện chỉ xuất hiện một lần duy nhất, không bỏ sót phần tử nào, và cursor phải luôn hợp lệ ngay cả khi có sự kiện mới phát sinh.
Những giao ước này rất dễ bị phá vỡ một cách âm thầm trong quá trình refactor mã nguồn, vì vậy chúng bắt buộc phải được đưa vào kiểm thử tự động. Dữ liệu trả về của công cụ cũng cần được giữ ở mức tinh gọn, như chúng tôi đã phân tích chuyên sâu trong bài viết về kết quả trả về của tool và cửa sổ ngữ cảnh của agent.
Để coding agent kiểm thử các API truy hồi bằng Apidog CLI
Độ tin cậy của Chain of Recall phụ thuộc hoàn toàn vào các endpoint fetch-by-ID, và một coding agent hoàn toàn có thể viết cũng như chạy lại các bài kiểm thử này cho bạn. Apidog CLI cung cấp cho agent các lệnh để định nghĩa endpoint, tạo test case và thực thi chúng trực tiếp từ terminal.
Thiết lập một lần duy nhất:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó, cung cấp cho Claude Code, Codex hoặc bất kỳ agent nào bạn dùng một prompt duy nhất:
In Apidog project <projectId>, define three endpoints for our agent memory
service: GET /threads/{id}, GET /threads/{id}/events?cursor=, and
GET /workers/{id}. Then create test cases that check:
1. A thread_id returned by GET /threads/{id} resolves to the same record
   on a second call, and each owner worker ID resolves via GET /workers/{id}.
2. An unknown thread ID and an unknown worker ID both return 404.
3. Paging GET /threads/{id}/events with the cursor returns every event
   once, in order, with no gaps.
Run them against the staging environment and summarize any failures.
Agent sẽ đọc schema của từng payload, validate cấu trúc JSON trước khi ghi dữ liệu, sau đó khởi tạo và chạy các test case:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file thread-get.json
apidog endpoint create --project <projectId> --file thread-get.json

apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file id-resolves.json
apidog test-case create --project <projectId> --file id-resolves.json

apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
Bộ báo cáo cli sẽ in kết quả pass hoặc fail của từng assertion trực tiếp trên terminal, và báo cáo json cung cấp cho agent một file dữ liệu có thể đọc được để giải thích chính xác bước nhảy nào đã bị lỗi. Nếu một ID không còn truy xuất được sau đợt migration, bạn sẽ phát hiện ra ngay trên báo cáo trước khi agent đưa ra câu trả lời dựa trên một chuỗi liên kết đã đứt. Để chạy các bước kiểm tra này tự động trên mỗi lượt merge, bạn chỉ cần đổi tùy chọn reporter sang -r junit; bài viết hướng dẫn sử dụng Apidog CLI trong Claude Code sẽ chỉ ra toàn bộ quy trình lặp hoàn chỉnh của agent.
Khi nào nên áp dụng Chain of Recall?
Hãy áp dụng Chain of Recall khi bộ nhớ của agent là một chuỗi các sự kiện riêng lẻ và có thể liên kết với nhau: PR, ticket, lượt chạy CI, luồng hỗ trợ, hoặc các phiên deploy. Những thực thể này vốn dĩ đã có sẵn các ID tự nhiên, và các câu hỏi mà con người đặt ra xoay quanh chúng (“tại sao chúng ta làm điều này?”, “chuyện gì xảy ra sau đó?”) thực chất là những câu hỏi về mối liên kết.
Hãy dùng truy xuất vector cho các tài liệu phi cấu trúc và các câu hỏi tìm kiếm mờ, và dùng tóm tắt cho các phiên làm việc ngắn hạn, nơi việc mất mát một vài chi tiết nhỏ không gây ảnh hưởng lớn.
Chain of Recall xuất phát từ một bài viết và một bản nguyên mẫu thử nghiệm: một ý tưởng rõ ràng, có thể kiểm chứng được, chứ không phải một sản phẩm thương mại đóng gói sẵn. Để tìm hiểu thêm về công cụ đằng sau bài viết này, bạn có thể bắt đầu với bài viết DeepSeek Harness là gì.
Câu hỏi thường gặp (FAQ)
Chain of Recall có phải là một tính năng của DeepSeek mà tôi có thể bật lên dùng ngay không? Không. Đây là một thuật ngữ xuất phát từ bài viết về kiến trúc super-agent của DeepSeek Harness, và một số phần của nó hiện diện trong một plugin nguyên mẫu mà nhóm tác giả nhấn mạnh không phải là sản phẩm chính thức của DeepSeek. Bạn sẽ cần tự mình lập trình và triển khai mô hình này.
Sự khác biệt giữa inline và spill là gì? Inline giữ các ID, bản tóm tắt ngắn và các tin nhắn lân cận trực tiếp trong prompt. Spill cắt ngắn phần nội dung còn lại và để lại một con trỏ để agent có thể truy xuất theo ID khi thực sự cần đến.
Chain of Recall có thay thế hoàn toàn RAG không? Không. RAG dùng để tìm kiếm các nội dung có ngữ nghĩa tương đồng; còn Chain of Recall lần theo các liên kết ID chính xác tuyệt đối. Nhiều hệ thống agent kết hợp đồng thời cả hai kỹ thuật này.
Có phải Chain of Recall giúp giảm 37% lượng token không? Không. Con số 37% phản ánh cơ chế Thread pass-through: việc loại bỏ nó đã khiến số cache-read token tăng từ 23,2 triệu lên 31,8 triệu mỗi lần chạy trong thử nghiệm của bài viết. Bản thân bài viết không đưa ra số liệu tiết kiệm token cụ thể nào do Chain of Recall mang lại.
API fetch-by-ID nên phản hồi như thế nào khi nhận một ID không tồn tại? API phải trả về mã 404 Not Found kèm nội dung lỗi cụ thể trong body. Nếu trả về mã 200 với một object rỗng, agent sẽ nhầm tưởng rằng bản ghi đó tồn tại, dẫn đến việc chuỗi truy hồi bị đứt gãy trong âm thầm.
Làm thế nào để kiểm tra tính ổn định của các API bộ nhớ cho agent? Hãy xây dựng các test case đảm bảo rằng một ID lấy từ một lệnh gọi này sẽ luôn truy xuất thành công ở lệnh gọi tiếp theo, các ID không tồn tại trả về mã 404, và cursor phân trang đầy đủ không sót dữ liệu. Một coding agent có thể tự động khởi tạo và chạy các kiểm thử này bằng Apidog CLI trong mỗi lần merge code.