
Cerebras chỉ bán một con số: tốc độ. Lời chào hàng là các chip quy mô tấm wafer của họ đẩy token ra nhanh hơn bất kỳ cụm GPU nào, và gói miễn phí là cách công ty khiến bạn để ý đến điều đó. Nhưng "nhanh" không phải là thứ bạn nên tin theo lời nhà cung cấp. Đó là thứ bạn phải đo đạc, trên kết nối của chính bạn, với prompt của chính bạn, rồi lưu lại làm hồ sơ để có thể chạy lại mỗi khi Cerebras phát hành model mới hoặc thay đổi giới hạn.
Hướng dẫn này sẽ thực hiện phép đo đó cùng bạn. Bạn sẽ lấy một API key của Cerebras, thực hiện một lệnh gọi chat completion thực tế tới endpoint tương thích OpenAI, đo thời gian tới token đầu tiên và toàn bộ phản hồi, rồi để coding agent của bạn biến toàn bộ request đó thành một bài test trên Apidog CLI để nó tồn tại qua lần đổi model tiếp theo.
TL;DR
Cerebras cấp cho tài khoản mới một gói Free Trial: $5 credit hết hạn sau 30 ngày kể từ khi được cấp, giới hạn trong hai model (gpt-oss-120b và qwen-3.8-27b) với 5 request mỗi phút và 30K token chưa cache mỗi phút cho mỗi model, theo giới hạn tốc độ được Cerebras công bố. API tương thích với OpenAI tại https://api.cerebras.ai/v1, nên bạn có thể trỏ một client OpenAI sẵn có vào đó và chỉ đổi ba dòng. Bên dưới, bạn sẽ tự xây dựng một request đo thời gian tới token đầu tiên và số token mỗi giây, thay vì tin vào một trang marketing.
Gói miễn phí ghi rõ những gì, và không ghi rõ những gì
Trang giá của Cerebras render các con số phía client, nghĩa là mức giá chính xác trên mỗi triệu token cho sử dụng trả phí không phải là thứ bạn có thể lấy từ một lần fetch tĩnh trang đó. Đừng đoán con số đó. Khi cần, hãy tự mở tab thanh toán của Cerebras Cloud console, vì đó là nơi duy nhất đảm bảo mức giá hiện hành chính xác.
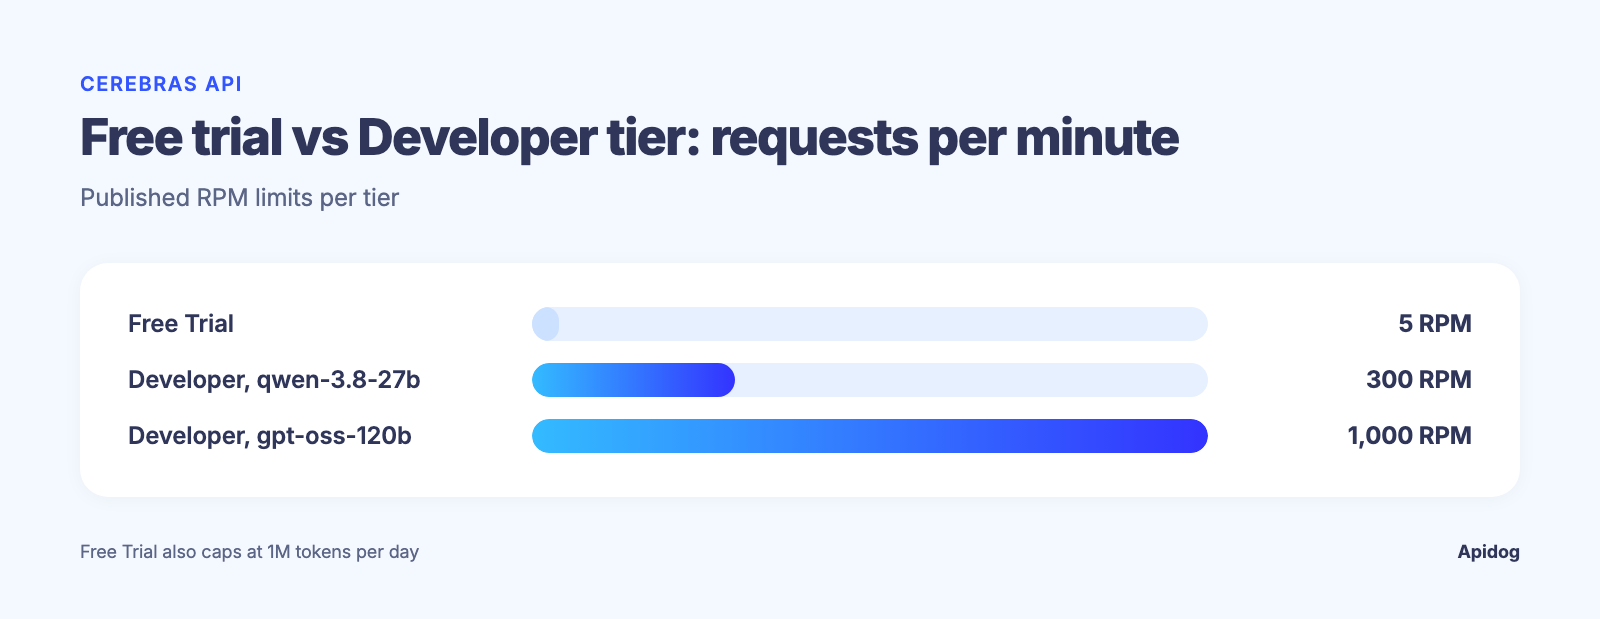
Điều mà tài liệu nói rõ ràng, trong trang giới hạn tốc độ hỗ trợ, là hình dạng của gói Free Trial:
| Tier | Models | RPM | Uncached TPM | Total TPM | TPH | TPD |
|---|---|---|---|---|---|---|
| Free Trial | gpt-oss-120b, qwen-3.8-27b |
5 | 30K | 90K | 1M | 1M |
Developer (gpt-oss-120b) |
pay-as-you-go | 1,000 | 1M | 3M | none | none |
Developer (qwen-3.8-27b) |
pay-as-you-go | 300 | 150K | 450K | none | none |
Có hai điều quan trọng ở đây. Thứ nhất, "uncached TPM" mới là trần thực sự: đó là những token cần tính toán đầy đủ, và tổng hạn mức TPM của bạn xấp xỉ gấp ba lần con số đó sau khi tính cả cache hit. Thứ hai, tài khoản Free Trial bị giới hạn theo credit và thời gian, không phải giới hạn request mãi mãi: một khi $5 hết hoặc 30 ngày trôi qua, bạn sẽ rơi xuống mức mà tier tài khoản cho phép cho tới khi bạn thêm phương thức thanh toán. Mọi thứ ngoài bảng này (giá mỗi token, giá theo seat, điều khoản doanh nghiệp) đều nằm sau trang giá render bằng JavaScript và console, không phải tài liệu tĩnh, nên hãy kiểm tra ở đó trước khi lập ngân sách dựa trên nó.
Nếu bạn từng đụng phải bức tường như thế này ở nhà cung cấp khác, mô thức cũng giống như trong hướng dẫn của chúng tôi về phải làm gì khi nhận phản hồi 429 rate-limit-exceeded: đọc nội dung lỗi, lùi lại, và kiểm tra dashboard trước khi cho rằng API hỏng.
Lấy key và thực hiện một lệnh gọi thực tế
Đăng ký tại cloud.cerebras.ai, mở API Keys, và tạo một key. Hướng dẫn nhanh của chính Cerebras bảo bạn đặt nó thành biến môi trường để nó không bao giờ lọt vào body request bằng tay:
export CEREBRAS_API_KEY="your-key-here"
Base URL là https://api.cerebras.ai/v1, và endpoint chat completions khớp trực tiếp với cấu trúc của OpenAI: POST /v1/chat/completions với một model và một mảng messages. Khả năng tương thích này được ghi trong tài liệu tham chiếu API, và đó là lý do bạn có thể đưa Cerebras vào code viết cho thư viện client của OpenAI chỉ bằng cách đổi base URL và key. Một lệnh gọi curl thô trông như sau:
curl https://api.cerebras.ai/v1/chat/completions \
  -H "Content-Type: application/json" \
  -H "Authorization: Bearer ${CEREBRAS_API_KEY}" \
  -d '{
    "model": "qwen-3.8-27b",
    "messages": [
      {"role": "user", "content": "Explain time-to-first-token in two sentences."}
    ]
  }'
Chạy nó, và phản hồi mang theo nhiều hơn phần text hoàn thành. Nó bao gồm một khối usage (prompt_tokens, completion_tokens, total_tokens) và một khối time_info (queue_time, total_time) mà Cerebras trả về trong mọi lệnh gọi.
Nếu nhóm của bạn đang test nhiều hơn một model hoặc nhà cung cấp, đây là thời điểm tốt để ngừng dựa vào các lệnh curl chạy một lần. Phần Apidog CLI bên dưới sẽ để coding agent của bạn biến lệnh gọi này thành một bài test mà nó chạy lại mỗi khi Cerebras thêm model hoặc thay đổi giới hạn.
Đo tuyên bố tốc độ: thời gian tới token đầu tiên và token mỗi giây
Hai con số cho bạn biết "nhanh" có thật với workload của bạn không: thời gian tới token đầu tiên (TTFT) và số token sinh ra mỗi giây. Cả hai đều không xuất hiện như một chỉ số tiêu đề trong phản hồi API, nên bạn tự tính chúng từ những gì lệnh gọi cung cấp.
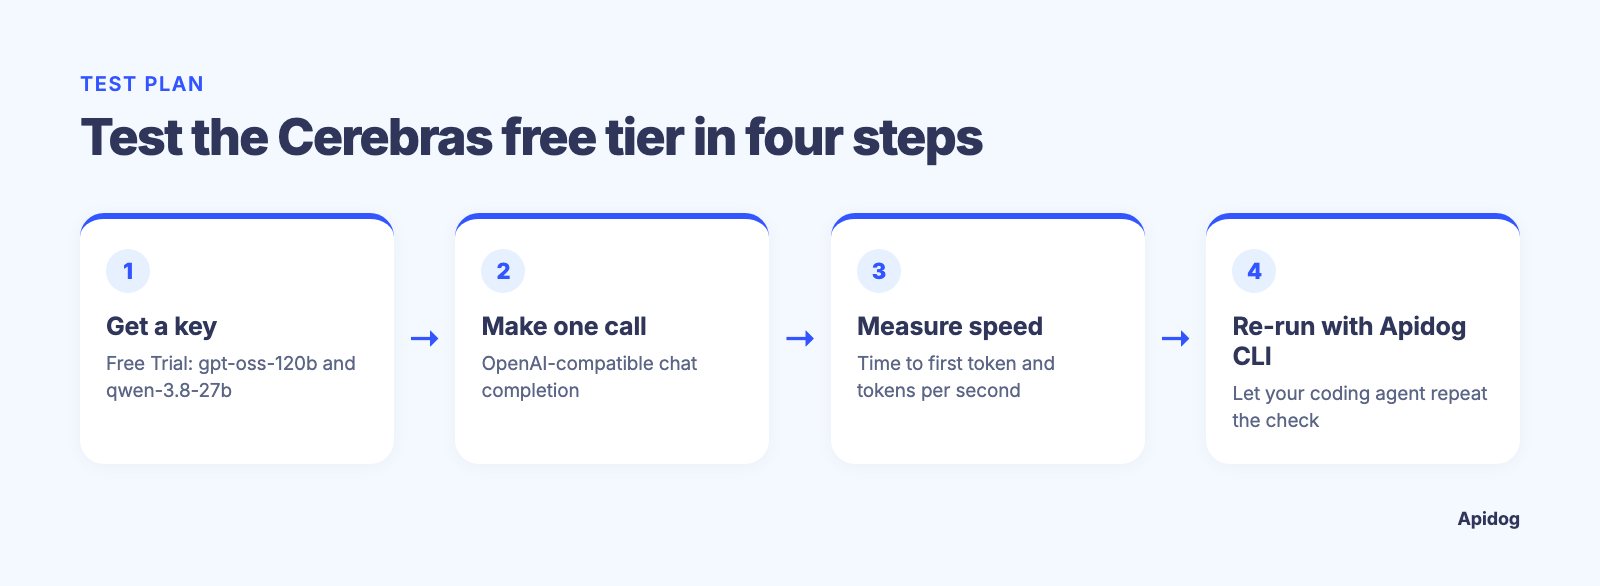
Với TTFT, hãy stream phản hồi và ghi lại khoảng thời gian thực giữa lúc gửi request và lúc nhận chunk đầu tiên:
import time
from cerebras.cloud.sdk import Cerebras

client = Cerebras()
start = time.perf_counter()
first_token_at = None

stream = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Write a haiku about wafer-scale chips."}],
    stream=True,
)

for chunk in stream:
    if first_token_at is None and chunk.choices[0].delta.content:
        first_token_at = time.perf_counter() - start
        print(f"Time to first token: {first_token_at:.3f}s")
Với số token mỗi giây, hãy dùng một lệnh gọi không stream và chia số completion token cho total_time mà Cerebras báo trong time_info:
response = client.chat.completions.create(
    model="qwen-3.8-27b",
    messages=[{"role": "user", "content": "Explain the CS-3 wafer-scale engine in 100 words."}],
)

tokens = response.usage.completion_tokens
seconds = response.time_info.total_time
print(f"{tokens / seconds:.1f} tokens/sec")
Hãy chạy nó vài lần, vào các giờ khác nhau, với một prompt gần giống với thứ sản phẩm của bạn gửi đi. Giữ cả hai script lại và chạy lại chúng mỗi khi Cerebras thêm một model vào gói miễn phí, vì con số token mỗi giây thay đổi theo từng model, không chỉ theo nhà cung cấp.
Đọc giới hạn trước khi chúng đọc bạn
Thiết kế giới hạn tốc độ của Cerebras có một điểm tinh tế đáng biết trước khi bạn viết script: nó theo dõi hai bucket token riêng biệt cho mỗi tổ chức, uncached TPM và total TPM, và thực thi cả hai cùng lúc. Một loạt prompt ngắn, lặp lại có thể đụng trần request mỗi phút trước khi tiến gần tới trần token, đúng cái bẫy được mô tả trong bài viết rộng hơn của chúng tôi về cách giới hạn tốc độ API hoạt động.
Một lỗ hổng thật thà trong tài liệu: Cerebras không công bố một bộ header phản hồi x-ratelimit-* như một số nhà cung cấp khác. Tài liệu tham chiếu API không liệt kê cái nào, và trang giới hạn tốc độ cũng vậy. Điều này khác với API chat completions của chính OpenAI, nơi trả về header quota còn lại trong mọi lệnh gọi, một mô thức được hướng dẫn giới hạn tốc độ GPT API của chúng tôi đề cập chi tiết hơn. Với Cerebras, hai nơi để kiểm tra tình trạng thật của bạn là phần Limits trong Cloud console và body của phản hồi 429, nơi nêu rõ bạn đã vượt trần token chưa cache hay trần token tổng. Hãy xây dựng logic retry của bạn dựa trên body lỗi đó thay vì giả định rằng một header sẽ cho bạn biết trước.
Để coding agent của bạn chạy lại nó với Apidog CLI
Một phép đo trong file nháp chẳng chứng minh được gì vào tháng sau. Hãy để coding agent của bạn biến lệnh gọi thành một bài test mà nó có thể chạy lại qua Apidog CLI. Cài đặt một lần:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Token lấy từ Apidog trong Account Settings, API Access Token. Sau đó đưa cho agent một prompt:
Use Apidog CLI on project <id>. Create a Cerebras environment with base URL
https://api.cerebras.ai/v1 and add POST /chat/completions with Bearer auth from
{{CEREBRAS_API_KEY}} and model set to {{MODEL}}. Create a test case asserting
status 200 and time_info.total_time under {{MAX_TOTAL_TIME}}, run it for
gpt-oss-120b and qwen-3.8-27b, and report completion tokens per second for each.
Các lệnh nó chạy, đã kiểm chứng với Apidog CLI 2.2.7:
apidog environment create Cerebras --project <id> --base-url https://api.cerebras.ai/v1
apidog endpoint create --project <id> --file cerebras-chat.json
apidog cli-schema validate test-case-create --file speed-case.json
apidog test-case create --project <id> --file speed-case.json
apidog run --test-case <caseId> --project <id> -e <envId> -d models.csv \
  --delay-request 12000 --env-var "CEREBRAS_API_KEY=$CEREBRAS_API_KEY" -r cli,json
models.csv chứa một cột MODEL, nên một lần chạy bao phủ cả hai model, và bất cứ thứ gì Cerebras ra mắt tiếp theo chỉ là thêm một dòng. --delay-request 12000 giãn các lệnh gọi cách nhau 12 giây để nằm dưới mức 5 request mỗi phút của Free Trial. Với luồng 429, hãy yêu cầu một case thứ hai cố tình vượt qua giới hạn đó và assert trên body lỗi, để nó được ghi lại và quản lý phiên bản thay vì bị phát hiện lại trong production. Đó là một workflow, không phải một benchmark chạy một lần; xem tổng hợp của chúng tôi về các công cụ test API dành cho workload agent và LLM nếu bạn đang so sánh các lựa chọn, và Apidog CLI trong Claude Code cho phía agent.
Free tier hay Developer tier: khi nào nên chuyển
Gói Free Trial được xây dựng đúng cho những gì hướng dẫn này đi qua: xác nhận tuyên bố tốc độ và hình dạng request trước khi bạn cam kết gắn thẻ. Một khi bạn xây dựng thật sự dựa trên Cerebras, bước nhảy của Developer tier, từ 5 RPM lên 1,000 RPM trên gpt-oss-120b, thường là con số buộc bạn phải quyết định, chứ không phải giá mỗi token. Nếu lượng prompt của bạn có tính bùng nổ thay vì đều đặn, hãy so sánh các con số của Cerebras với các lựa chọn thay thế trước khi cam kết; danh sách các lựa chọn thay thế OpenRouter và bài hướng dẫn của chúng tôi về gói API miễn phí của Groq đều đáng đọc song song với bảng trên, vì tốc độ suy luận và trần gói miễn phí khác nhau giữa các nhà cung cấp nhiều hơn mức mà hầu hết bài so sánh thừa nhận. Một khác biệt đáng biết trước khi bạn chọn: Groq ghi rõ giới hạn Free Plan theo từng model, ví dụ openai/gpt-oss-120b ở mức 30 RPM, 1,000 RPD, 8K TPM, và 200K TPD, và trả về header phản hồi x-ratelimit-* trong mọi lệnh gọi, nên bạn luôn biết ngân sách còn lại từ chính phản hồi. Cerebras không cho bạn cả hai; bạn đọc tình trạng của mình từ Cloud console hoặc suy ra từ body 429, như đã đề cập ở trên.
FAQ
Gói miễn phí của Cerebras có yêu cầu thẻ tín dụng không? Gói Free Trial dựa trên credit ($5, hết hạn sau 30 ngày) thay vì một gói miễn phí định kỳ, và tài liệu của chính Cerebras dẫn bạn tới Cloud console để biết yêu cầu đăng ký hiện hành, vì chi tiết đó có thể thay đổi độc lập với tài liệu tĩnh.
Những model nào có sẵn trên gói miễn phí? Theo tài liệu giới hạn tốc độ hiện hành, có hai: gpt-oss-120b và qwen-3.8-27b. Cả hai dùng chung giới hạn Free Trial (5 RPM, 30K uncached TPM).
Tôi có thể dùng code OpenAI SDK sẵn có với Cerebras không? Có. Trỏ base URL của client vào https://api.cerebras.ai/v1 và đổi sang key Cerebras của bạn; cấu trúc /v1/chat/completions khớp, theo tài liệu tham chiếu API.
Tại sao tôi nhận 429 dù đang dưới ngân sách token? Cerebras thực thi uncached TPM, total TPM, và RPM như các trần riêng biệt. Một loạt request nhỏ có thể chạm giới hạn RPM từ rất lâu trước khi bất kỳ bucket token nào đầy, đây cũng là kiểu lỗi được đề cập trong hướng dẫn xử lý rate-limit-exceeded của chúng tôi.
Làm sao kiểm tra mức sử dụng hiện tại mà không phải đụng tường trước? Cerebras không trả về header phản hồi quota còn lại, nên hãy kiểm tra trực tiếp phần Limits trong Cloud console thay vì suy ra từ phản hồi API. Gói miễn phí của Groq làm ngược lại và trả về header x-ratelimit-* trong mọi lệnh gọi, nên hãy cân nhắc khác biệt đó nếu việc giám sát dựa trên header quan trọng với thiết lập của bạn.
Lợi thế thật sự của Cerebras thể hiện trong khối time_info trên chính các lệnh gọi của bạn, không phải trên một tiêu đề marketing.