
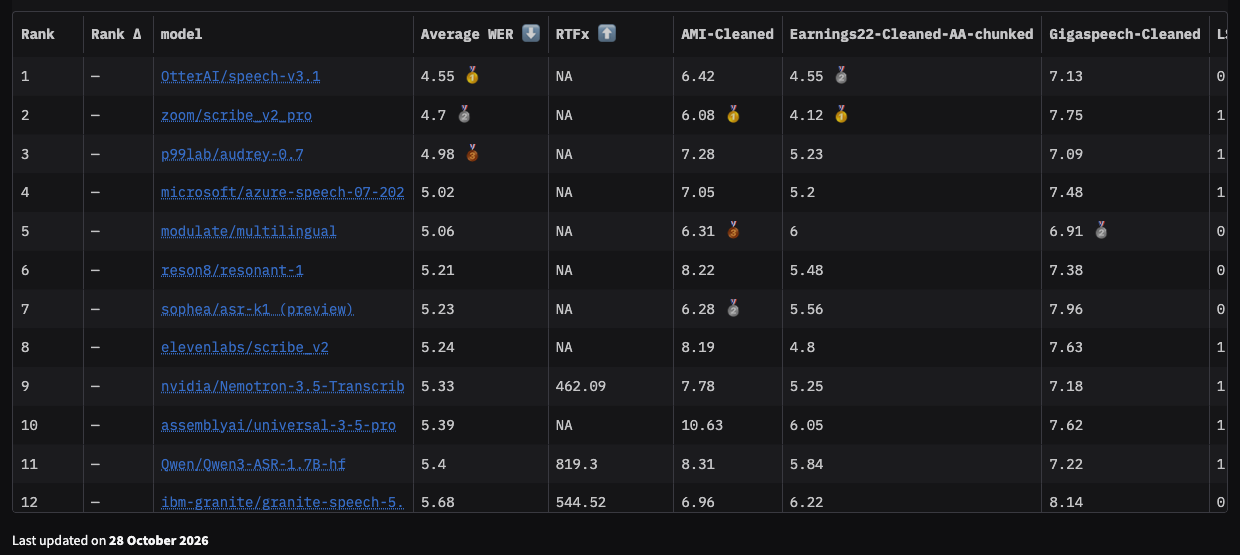
Mô hình chuyển giọng nói thành văn bản mã nguồn mở tốt nhất vào tháng 10 năm 2026 là Nemotron 3.5 Transcribe của NVIDIA, được phát hành ngày 28 tháng 10. Trên Bảng xếp hạng Open ASR của Hugging Face được cập nhật cùng ngày hôm đó, nó đạt tỷ lệ lỗi từ trung bình 5.33% và xếp thứ 9 trong số 61 mô hình. Tất cả tám mô hình đứng trên nó đều là API thương mại đóng. whisper-large-v3 của OpenAI, vẫn là lựa chọn mặc định trong nhiều bài hướng dẫn, đứng thứ 41 với 7.16%.
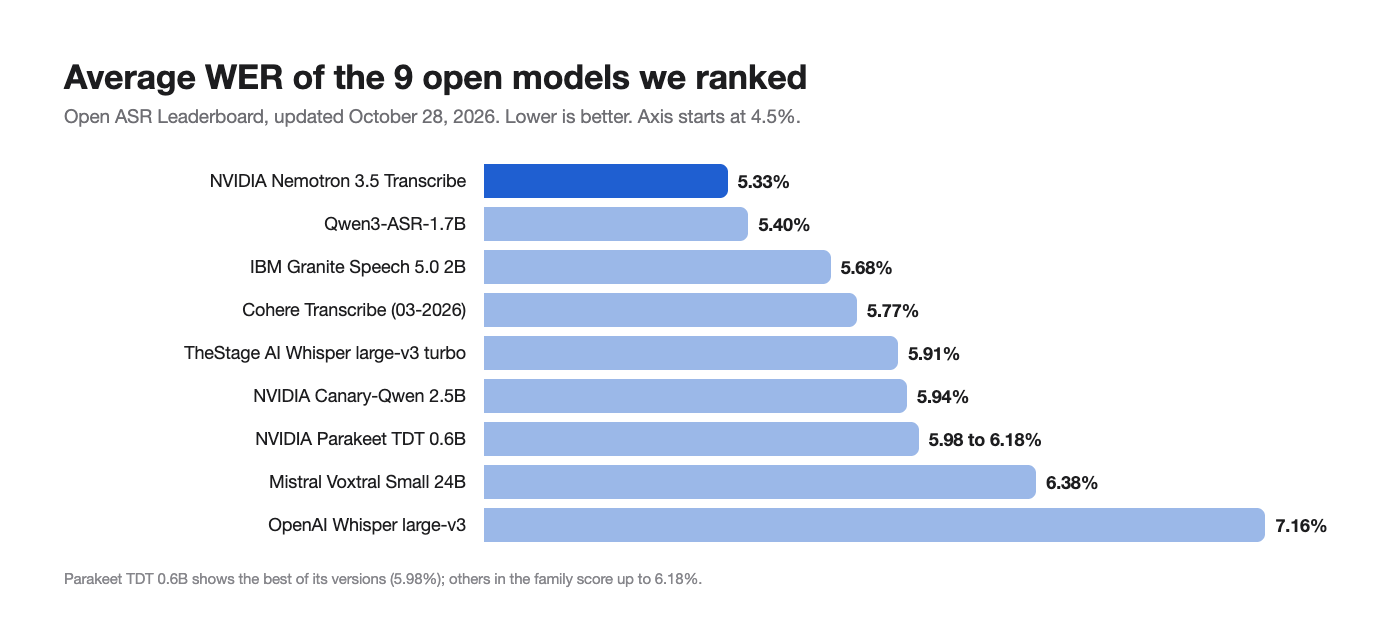
Dưới đây là chín mô hình nhận dạng giọng nói trọng số mở đáng cân nhắc ngay lúc này, được xếp hạng theo bảng xếp hạng đó, kèm tốc độ, điểm mạnh và công việc mà mỗi mô hình phù hợp. Mọi chỉ số WER và tốc độ đều lấy từ bảng xếp hạng tính đến ngày 29 tháng 10 năm 2026.
Nếu bạn đang cân nhắc giữa các API được lưu trữ thay vào đó, hãy đọc hướng dẫn API Nemotron 3.5 Transcribe của chúng tôi và hướng dẫn API Whisper.
Cách chúng tôi xếp hạng chúng
Bảng xếp hạng Open ASR chạy mọi mô hình trên cùng các bộ kiểm thử tiếng Anh: các cuộc họp (AMI), cuộc gọi báo cáo tài chính (Earnings22), podcast và YouTube (GigaSpeech), sách nói (LibriSpeech), cuộc gọi tài chính (SPGISpeech), giọng nói nhiễu (URGENT24), âm thanh hội thoại (Voice Arena Monsoon), bài phát biểu quốc hội (VoxPopuli), và hai bộ riêng tư. Chỉ số xếp hạng là WER trung bình, trong đó thấp hơn là tốt hơn.
Chúng tôi cũng liệt kê RTFx, thước đo tốc độ của bảng xếp hạng: số giây âm thanh được chuyển thành văn bản trên mỗi giây tính toán. Cao hơn là nhanh hơn. Các API đóng hiển thị “NA” vì không thể đo thời gian trên cùng phần cứng.
Chúng tôi coi một mô hình là trọng số mở khi checkpoint của nó có thể tải xuống và bảng xếp hạng báo cáo RTFx cho nó. Hãy kiểm tra từng giấy phép trước khi dùng thương mại.
Bảng xếp hạng trong nháy mắt
| Hạng (mở) | Mô hình | WER trung bình | RTFx | Hạng chung cuộc |
|---|---|---|---|---|
| 1 | NVIDIA Nemotron 3.5 Transcribe 30B-A4B | 5.33% | 462 | 9 |
| 2 | Qwen3-ASR-1.7B | 5.40% | 819 | 11 |
| 3 | IBM Granite Speech 5.0 2B | 5.68% | 545 | 12 |
| 4 | Cohere Transcribe (03-2026) | 5.77% | 902 | 14 |
| 5 | TheStage AI Whisper large-v3 turbo | 5.91% | 1,177 | 17 |
| 6 | NVIDIA Canary-Qwen 2.5B | 5.94% | 862 | 21 |
| 7 | NVIDIA Parakeet TDT 0.6B (các phiên bản) | 5.98% đến 6.18% | không so sánh | 24 đến 31 |
| 8 | Mistral Voxtral Small 24B | 6.38% | không so sánh | 35 |
| 9 | OpenAI Whisper large-v3 | 7.16% | không so sánh | 41 |
Để tham khảo, các API đóng tốt nhất trên cùng bảng: Otter speech-v3.1 ở 4.55%, Zoom Scribe v2 Pro ở 4.70%, ElevenLabs Scribe v2 ở 5.24%, AssemblyAI Universal-3.5 Pro ở 5.39% và OpenAI gpt-transcribe ở 5.96%. Nemotron 3.5 Transcribe đánh bại AssemblyAI và mô hình được lưu trữ của OpenAI trong khi vẫn miễn phí tải về.
1. NVIDIA Nemotron 3.5 Transcribe: tốt nhất tổng thể
5.33% WER, RTFx 462, giấy phép OpenMDW-1.1
Mô hình mới của NVIDIA không phải là một mạng ASR cổ điển. Nó là một mô hình ngôn ngữ được tăng cường giọng nói: một bộ mã hóa ASR 600 triệu tham số và một bộ mã hóa người nói cấp dữ liệu cho một LLM kết hợp Mamba-2 lai và Transformer mixture-of-experts với tổng 34B và khoảng 4.3B tham số hoạt động. Chính thiết kế đó là lý do nó làm được nhiều hơn việc chuyển thành văn bản.
Vì sao nó xếp thứ nhất:
- 40 ngôn ngữ, với 13 ngôn ngữ được đánh giá là “dẫn đầu”
- Tệp dài một giờ trong một lượt xử lý, với ngữ cảnh 65,536 token
- Gán nhãn người nói (tối đa tám người nói) và dấu thời gian theo từ từ một mô hình duy nhất
- Câu lệnh gợi ý: nguyên văn hoặc diễn đạt sạch, thuật ngữ ngữ cảnh cho biệt ngữ, dịch thuật
- Độ chính xác với âm thanh dài: WER trung bình 10.98% trên các bộ âm thanh dài của bảng xếp hạng, so với 13.37% của Parakeet-TDT-0.6B-v3, theo thẻ mô hình
- Cuộc họp: cpWER trung bình 15.80% trên các bộ nhiều người nói, vượt qua pipeline DiCoW cộng DiariZen ở 16.83%
Đánh đổi: nó cần một GPU lớn (một H100 80 GB ở BF16, hoặc một RTX 5090 với trọng số NVFP4), nó không truyền trực tuyến, và hỏi đáp về âm thanh chỉ hỗ trợ tiếng Anh.
Chọn nó cho: cuộc họp, podcast, cuộc gọi báo cáo tài chính, kho lưu trữ đa ngôn ngữ và bất cứ thứ gì mà nhãn người nói hoặc tệp dài một giờ quan trọng. Bắt đầu với các cách miễn phí hoặc chạy nó cục bộ.
2. Qwen3-ASR-1.7B: độ chính xác tốt nhất trên mỗi đô la GPU
5.40% WER, RTFx 819
Qwen3-ASR-1.7B của Alibaba chỉ kém Nemotron 0.07 điểm trên mức trung bình tiếng Anh trong khi chạy nhanh hơn khoảng 1.8 lần trên phần cứng của bảng xếp hạng, từ một mô hình có tổng kích thước bằng một phần hai mươi. Trong so sánh đa ngôn ngữ bảy ngôn ngữ của chính NVIDIA, Nemotron dẫn trước rõ ràng hơn: WER trung bình 4.62% so với 6.49%.
Chọn nó cho: chuyển hàng loạt thiên về tiếng Anh trên các GPU nhỏ hơn, nơi bạn không cần gán nhãn người nói tích hợp sẵn. Nếu bạn đã dùng các mô hình đa phương thức của Qwen, hãy xem hướng dẫn của chúng tôi về Qwen3.5-Omni.
3. IBM Granite Speech 5.0 2B: tốt nhất với âm thanh cuộc họp so với kích thước của nó
5.68% WER, RTFx 545
Granite Speech 5.0 của IBM đạt WER 6.96% trên các bản ghi cuộc họp AMI, điểm AMI tốt nhất trong số sáu mô hình mở hàng đầu ở đây và tốt hơn mức 7.78% của Nemotron trên bộ đó. Điểm yếu của nó là các cuộc gọi tài chính SPGISpeech ở 3.36%.
Chọn nó cho: các đội doanh nghiệp đang chuẩn hóa trên nền tảng Granite của IBM, và chuyển văn bản cuộc họp trên các GPU tầm trung.
4. Cohere Transcribe: nhanh và chính xác
5.77% WER, RTFx 902
Mô hình chuyển thành văn bản tháng 3 năm 2026 của Cohere Labs kết hợp điểm chính xác mở trong top năm với một trong những tốc độ cao nhất ở đây. Nó mạnh nhất trên LibriSpeech (0.97% sạch, 2.05% khác) và yếu hơn trên VoxPopuli ở 5.38%.
Chọn nó cho: các pipeline tiếng Anh khối lượng lớn, nơi thông lượng quan trọng ngang với độ chính xác.
5. TheStage AI Whisper large-v3 turbo: nhanh nhất trong nhóm hàng đầu
5.91% WER, RTFx 1,177
Đây là bản dựng Whisper large-v3 turbo được tối ưu hóa từ TheStage AI, và nó là mô hình nhanh nhất trong danh sách của chúng tôi. Nó đạt 1.62% trên SPGISpeech, điểm tốt thứ ba trên bộ đó trong toàn bộ 61 mô hình. Nó cho thấy dòng Whisper vẫn còn sức sống đến mức nào khi có người tinh chỉnh nó.
Chọn nó cho: các đội đã có mã Whisper và muốn nâng cấp tốc độ lẫn độ chính xác mà không cần thay đổi nhiều.
6. NVIDIA Canary-Qwen 2.5B: mô hình chủ lực trước đây của NVIDIA
5.94% WER, RTFx 862
Canary-Qwen là mô hình giọng nói kết hợp LLM trước đó của NVIDIA, và Nemotron 3.5 Transcribe đã thay thế nó ở vị trí đầu. Nó vẫn nhanh, và điểm 1.70% trên SPGISpeech của nó rất xuất sắc. Trong bài kiểm thử preference-ASR của NVIDIA, Nemotron đạt 7.56% so với 8.16% của Canary-Qwen.
Chọn nó cho: các triển khai NeMo hiện có chưa thể chuyển sang GPU 80 GB.
7. NVIDIA Parakeet TDT 0.6B: lựa chọn nghiêm túc nhỏ nhất
5.98% đến 6.18% WER giữa các phiên bản
Parakeet TDT có nhiều phiên bản 0.6 tỷ tham số trên bảng, tất cả đều chênh lệch khoảng 0.2 điểm so với nhau. Với 600M tham số, nó là mô hình nhỏ nhất ở đây vẫn giữ được mức gần 6% WER, nên nó chạy được trên các GPU khiêm tốn. Điểm yếu của nó là âm thanh dài, nơi Nemotron đánh bại nó hơn hai điểm.
Chọn nó cho: thiết bị biên, GPU rẻ, và các đoạn ngắn như lệnh thoại hoặc đoạn trích cuộc gọi.
8. Mistral Voxtral Small 24B: giọng nói cộng với một LLM mạnh
6.38% WER
Voxtral Small kết hợp đầu vào giọng nói với một mô hình ngôn ngữ Mistral 24B, nên giống như Nemotron, nó có thể trả lời câu hỏi về âm thanh chứ không chỉ chuyển thành văn bản. Nó kém nhóm năm mô hình đầu về WER thuần túy. Bài phân tích Voxtral so với Whisper của chúng tôi đi sâu vào bản phát hành trước đó của nó.
Chọn nó cho: trợ lý giọng nói và hỏi đáp âm thanh, nơi mô hình ngôn ngữ quan trọng hơn điểm WER cuối cùng.
9. OpenAI Whisper large-v3: mốc cơ sở
7.16% WER, thứ 41 chung cuộc
Whisper large-v3 vẫn là mô hình mở được triển khai rộng rãi nhất, với hệ sinh thái wrapper, bản tinh chỉnh và hướng dẫn lớn nhất. Về độ chính xác, nó hiện kém hơn mọi mô hình khác trong danh sách này. Nếu bạn đang chạy nó trong môi trường sản xuất, chuyển sang bất kỳ mô hình nào trong sáu mô hình hàng đầu là cách nâng cấp chất lượng rẻ nhất hiện có.
Chọn nó cho: các nguyên mẫu phụ thuộc vào công cụ dành riêng cho Whisper, hoặc làm mốc cơ sở để vượt qua.
Bạn nên chọn cái nào?
| Công việc của bạn | Lựa chọn |
|---|---|
| Cuộc họp có nhiều người nói | Nemotron 3.5 Transcribe |
| Podcast hoặc cuộc gọi dài một giờ trong một lượt xử lý | Nemotron 3.5 Transcribe |
| Kho lưu trữ đa ngôn ngữ | Nemotron 3.5 Transcribe |
| Công việc hàng loạt tiếng Anh trên các GPU nhỏ hơn | Qwen3-ASR-1.7B |
| Thông lượng tối đa | TheStage Whisper large-v3 turbo hoặc Cohere Transcribe |
| Phần cứng biên hoặc chi phí thấp | Parakeet TDT 0.6B |
| Hỏi đáp âm thanh kèm chuyển thành văn bản | Nemotron 3.5 Transcribe hoặc Voxtral Small |
| Mã Whisper hiện có, thay đổi tối thiểu | TheStage Whisper large-v3 turbo |
Một lưu ý: WER trung bình trên bảng xếp hạng che giấu những khoảng cách theo lĩnh vực. Nemotron tốt nhất tổng thể, nhưng Granite đánh bại nó trên AMI và một số mô hình đánh bại nó trên LibriSpeech. Hãy kiểm thử hai hoặc ba mô hình hàng đầu trên 50 đến 100 bản ghi âm của chính bạn trước khi quyết định.
Đánh giá các ứng viên bằng coding agent và Apidog CLI của bạn
Cách nhanh nhất để chạy cuộc so tài đó là để coding agent của bạn làm việc đó. Hãy phục vụ hai hoặc ba mô hình sau các endpoint /v1/audio/transcriptions kiểu OpenAI (SGLang-Omni phục vụ Nemotron theo cách này), rồi để agent xây dựng và chạy cùng các kiểm tra đó với Apidog CLI.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Sau đó đưa cho agent của bạn một câu lệnh:
In Apidog project <id>, create one environment per speech server (nemotron, qwen3-asr,
whisper) with its baseUrl. Create test cases that POST each file in samples/ to
{{baseUrl}}/v1/audio/transcriptions, assert status 200 and non-empty text, and save the
transcript to a variable. Run the cases against each environment and give me a table
of failures and response times per server.
Agent đọc schema, xác thực payload của nó, viết các test case và chạy chúng theo từng môi trường:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Hãy chấm điểm các bản chuyển văn bản đã lưu so với văn bản tham chiếu của bạn bằng bất kỳ script WER nào, và giữ lần chạy của môi trường thắng cuộc trong CI với -r junit. Xem Apidog CLI trong Claude Code và Apidog CLI trong pipeline CI/CD.
Câu hỏi thường gặp
Mô hình chuyển giọng nói thành văn bản mã nguồn mở chính xác nhất là gì? NVIDIA Nemotron 3.5 Transcribe, với WER trung bình 5.33% trên Bảng xếp hạng Open ASR ngày 28 tháng 10 năm 2026.
Whisper có còn tốt không? Nó vẫn hoạt động, nhưng whisper-large-v3 xếp thứ 41 với 7.16%. Các bản dựng Whisper được tinh chỉnh như large-v3 turbo của TheStage đạt 5.91%.
Mô hình mở nào nhanh nhất? Trong số các mô hình ở đây, Whisper large-v3 turbo của TheStage AI, với RTFx là 1,177.
Liệu các mô hình mở có đánh bại API trả phí hiện nay không? Một số có. Nemotron 3.5 Transcribe đánh bại AssemblyAI Universal-3.5 Pro (5.39%) và OpenAI gpt-transcribe (5.96%). Otter, Zoom và ElevenLabs vẫn dẫn đầu tổng thể. Về các lựa chọn được lưu trữ, hãy xem tổng hợp các API chuyển giọng nói thành văn bản của chúng tôi.
Mô hình nào hỗ trợ phân tách người nói? Nemotron 3.5 Transcribe làm điều đó trong cùng một mô hình, với tối đa tám người nói. Hầu hết các mô hình khác cần một bước phân tách người nói riêng.
Kết luận
Với hầu hết các đội vào cuối năm 2026, hãy bắt đầu với Nemotron 3.5 Transcribe nếu bạn có GPU 80 GB hoặc có thể trả $0.12 một giờ trên một API được lưu trữ. Chọn Qwen3-ASR-1.7B khi ngân sách GPU eo hẹp, và Parakeet khi phần cứng còn eo hẹp hơn nữa. Dù bạn chọn gì, hãy kiểm thử nó trên âm thanh của chính bạn, và để agent của bạn duy trì các kiểm tra Apidog hoạt động để mô hình bạn chọn tiếp tục hoạt động tốt sau mỗi lần nâng cấp.