
OpenAI LifeVal, bir çocuğu okula kaydettirmek, ev bütçesini yönetmek veya bir devlet dairesiyle işleri halletmek gibi günlük yaşam görevlerinden oluşan 169 görevlik bir kıyaslama setidir; bir yapay zekâ ajanı bu görevleri tarayıcı kullanımı, bilgisayar kullanımı ve bağlayıcılar aracılığıyla tamamlar. Her deneme bir rubrikle puanlanır ve puan, 0 ile 1 arasındaki ortalama ödüldür. GPT-6 Astra, xhigh efor düzeyinde %80,6 puan alır.
Kısa versiyonu bu. Aşağıda OpenAI'nin LifeVal'i nasıl oluşturduğunu, yayımladığı her model puanını (yalnızca sayfanın etkileşimli grafiğinde bulunan efor bazlı sayılar dahil), bu sayıların akıl yürütme eforu hakkında ne söylediğini ve kıyaslamanın neleri dışarıda bıraktığını bulacaksınız.
OpenAI LifeVal nedir?
LifeVal, bir modelin kodlama veya sınav soruları yerine sıradan yaşamın gündelik işlerini ne kadar iyi tamamladığını ölçen bir OpenAI Research kıyaslamasıdır. 169 görevi ajan tabanlıdır: model tarayıcıda gezinir, bir bilgisayarı kullanır ve bağlayıcıları çağırır; sonucu ise senaryoya özel bir rubrik puanlar.
OpenAI yedi görev alanı belirtiyor:
- Bakım verme
- Sağlık
- Eğitim
- Ev idaresi
- Kişisel finans
- Alışveriş
- Devlet hizmetlerine erişim
Öne çıkan metrik ortalama ödüldür. Her nokta, tek bir görev içindeki denemelerin ortalamasını alır, ardından 169 görev ortalamasını eşit ağırlıkla ortalar. %80,6'lık bir puan, 0,806'lık bir ödül anlamına gelir. Grafik notlarında "WTP ağırlıklandırması yok" yazıyor; buna tekrar döneceğiz.
OpenAI, LifeVal görev setini nasıl oluşturdu
OpenAI görev listesini sıfırdan icat etmedi. İnsanların zamanlarını gerçekte nasıl geçirdiğinden yola çıktı; bunun için iki kamuya açık veri seti ve kendi anketini kullandı:
- ABD Çalışma İstatistikleri Bürosu'nun, Amerikalıların saat saat ne yaptığını kaydeden American Time Use Survey çalışması.
- Ülkeler arasındaki zaman kullanımı günlüklerini uyumlu hale getiren Multinational Time Use Study.
- Yapay zekâdan nerede yardım isteyeceklerinin sorulduğu, demografik açıdan temsili 3.995 katılımcıyla yapılan kendi anketi.
Zaman kullanımı verisi, OpenAI'ye insanların günlerini hangi etkinliklerin doldurduğunu söyler. Anket ise bu etkinliklerden hangilerini insanların bir ajana devredeceğini söyler. Kesişim kümesi 169 senaryoyu oluşturdu.
Sayfa, her biri bir puana sahip beş örnek görev kartı gösteriyor. Bunlar rastgele bir örneklem değil, OpenAI'nin seçtiği örnekler:
| Örnek görev (OpenAI'nin seçimi) | Puan |
|---|---|
| Taşındıktan sonra doğru anaokuluna kaydolmak | %93,1 |
| Sel öncesinde gönüllüleri yönetmek | %98,0 |
| Ailem için yeni bir ev bulmak | %100 |
| Uzaktaki büyükanneyle birlikte maç izlemek | %96,3 |
| Yeni diyabet teşhisi konmuş bir ebeveyn için yemek hazırlamak | %90,4 |
LifeVal puanları: her OpenAI modeli
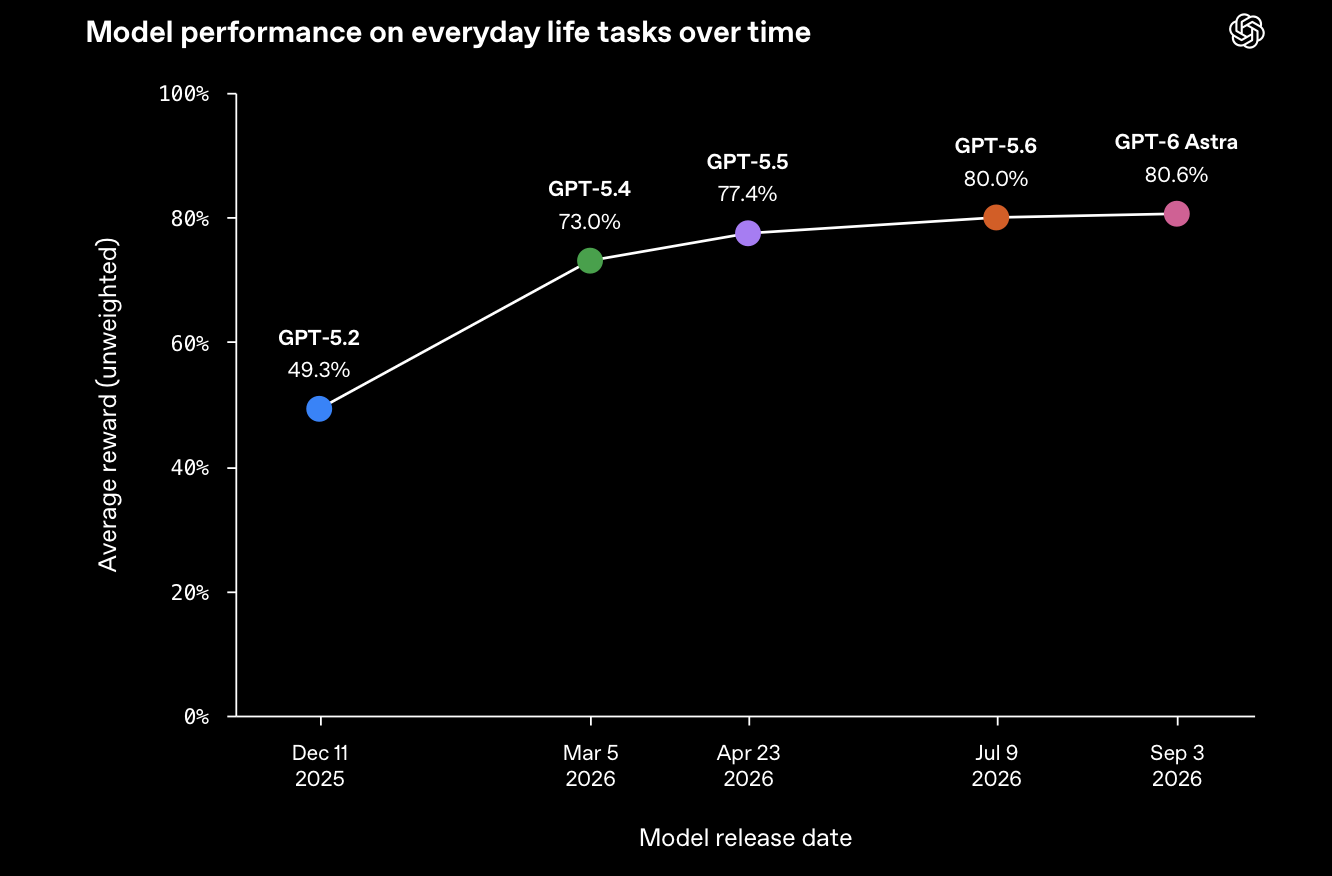
OpenAI'nin ilk grafiği, her modeli xhigh akıl yürütme eforuyla çıkış tarihine göre işliyor. GPT-6 Astra, "lansman blogundaki xhigh ayarını" kullanıyor.
| Model | Çıkış tarihi | LifeVal ortalama ödülü (xhigh) |
|---|---|---|
| GPT-5.2 | 2025-12-11 | %49,3 |
| GPT-5.4 | 2026-03-05 | %73,0 |
| GPT-5.5 | 2026-04-23 | %77,4 |
| GPT-5.6 | 2026-07-09 | %80,0 |
| GPT-6 Astra | 2026-09-03 | %80,6 |
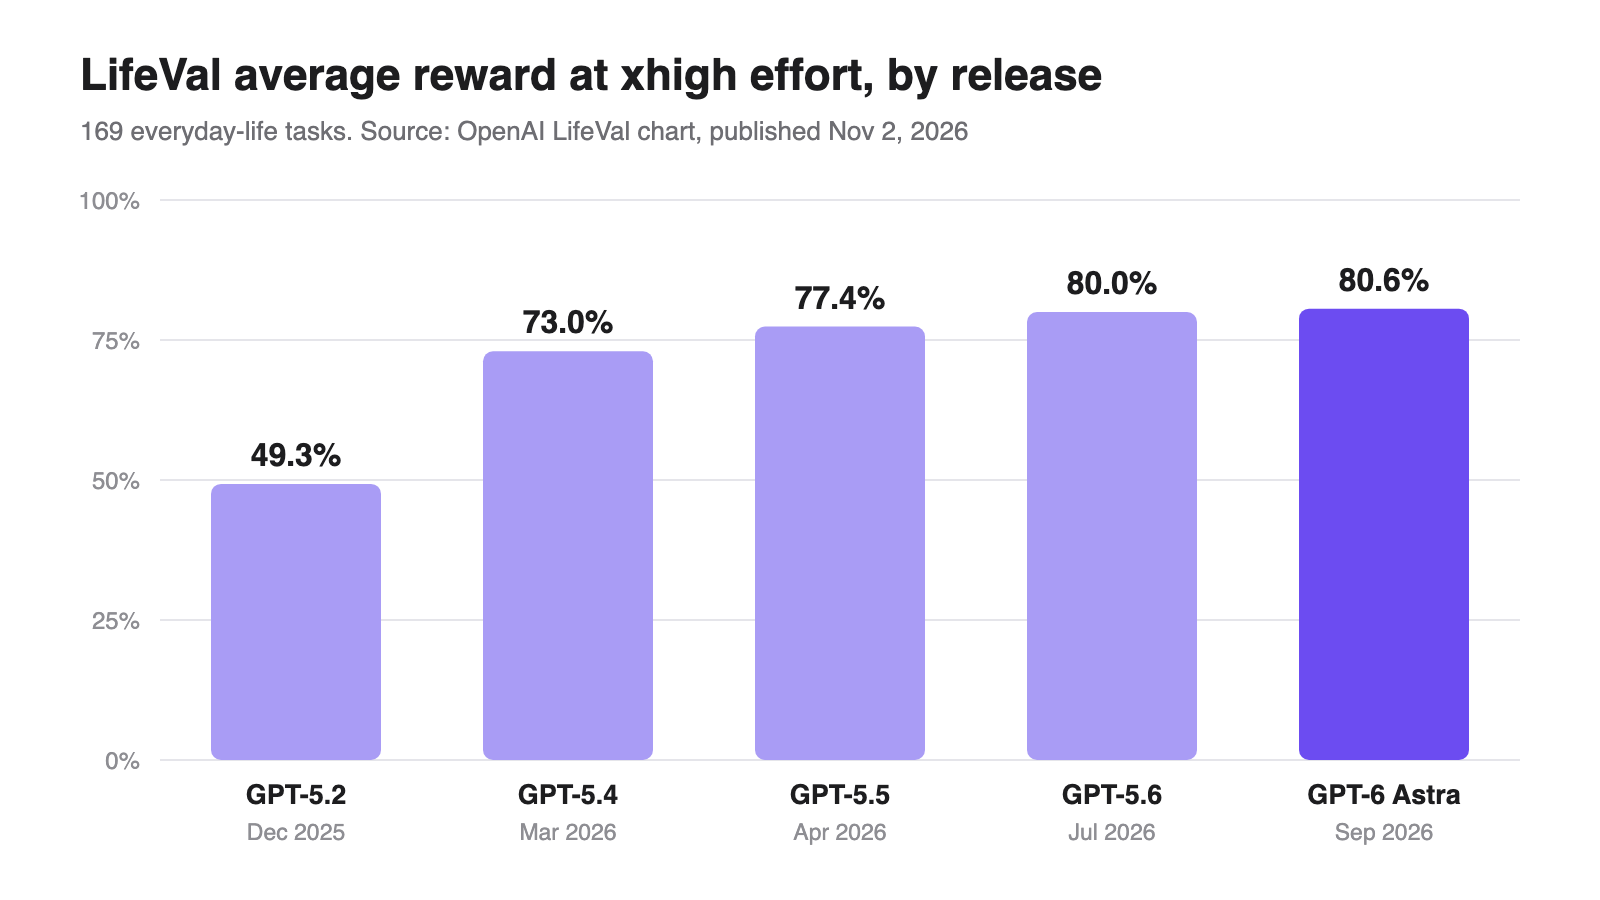
Eğri önce dik, sonra düzleşiyor. GPT-5.2'den GPT-5.4'e geçiş üç ayda 23,7 puan ekledi. Sonraki üç sürüm toplamda 7,6 puan ekledi ve GPT-6 Astra, GPT-5.6'yı 0,6 puan geçti.
GPT-5.4'teki sıçrama yalnızca kaliteyle ilgili değildi. xhigh düzeyinde ortalama gecikme 121,0 saniyeden 16,7 saniyeye, görev başına üretilen token sayısı da 202,0K'dan 30,6K'ya düştü. Yeni model, çıktının yaklaşık yedide biriyle çok daha iyi bir yanıta ulaştı.
GPT-6.1 Sol ve GPT-6.1 Terra, ikisi de piyasaya çıkmış olmasına rağmen iki grafikte de yer almıyor. Zaman çizelgesi 3 Eylül 2026'da sona eriyor. Bir ajan ürünü için GPT-6.1 Sol ile Astra arasında seçim yapıyorsanız, LifeVal size henüz yardımcı olamaz.
Akıl yürütme eforuna göre LifeVal
İkinci grafik daha faydalısı ve onu yalnızca fareyle üzerine gelerek görebiliyorsunuz. Her modeli akıl yürütme eforuna göre ayrıştırıyor ve her nokta için dört sayı veriyor: ödül, gecikme, üretilen token sayısı ve API maliyeti. Her ayar için ödüller şöyle:
| Model | low | medium | high | xhigh | max |
|---|---|---|---|---|---|
| GPT-5.2 | %27,7 | %37,2 | %45,2 | %49,3 | yok |
| GPT-5.4 | %62,8 | %70,1 | %72,0 | %73,0 | yok |
| GPT-5.5 | %57,1 | %71,3 | %75,6 | %77,4 | yok |
| GPT-5.6 | %63,9 | %75,0 | %78,8 | %80,0 | %82,6 |
| GPT-6 Astra | %66,6 | %77,6 | %80,7 | %80,6 | %82,5 |
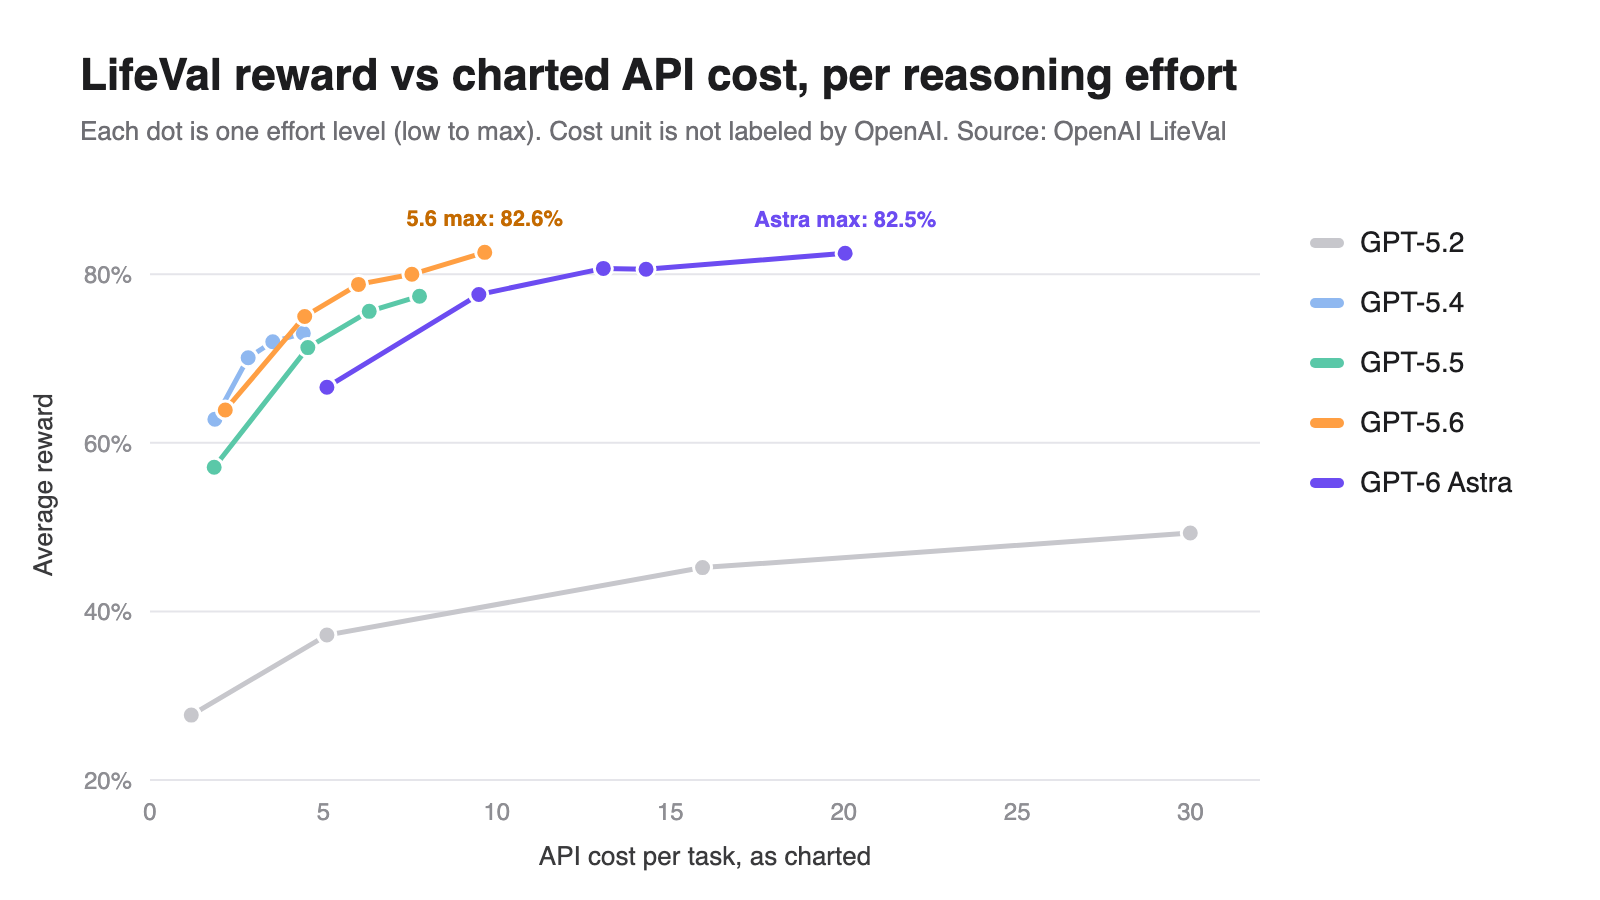
Maliyet sütunuyla ilgili bir not. OpenAI bunu API maliyeti olarak etiketliyor ama birimini belirtmiyor; bu yüzden aşağıdaki rakamları "grafikte gösterildiği şekliyle görev başına API maliyeti" olarak, yani oranlar için faydalı bir gösterge olarak değerlendirin, dolar olarak değil.
GPT-5.6 max düzeyinde GPT-6 Astra max ile başa baş
| Ayar | Ödül | Gecikme | Token | Grafikteki maliyet |
|---|---|---|---|---|
| GPT-5.6, max | %82,6 | 22,2 sn | 29,7K | 9,65 |
| GPT-6 Astra, max | %82,5 | 20,6 sn | 26,3K | 20,04 |
| GPT-5.6, xhigh | %80,0 | 17,5 sn | 20,7K | 7,55 |
| GPT-6 Astra, high | %80,7 | 13,6 sn | 12,4K | 13,07 |
GPT-5.6 max düzeyinde, yaklaşık yarı grafik maliyetiyle Astra max'ı 0,1 puan geçiyor. Eşit eforda Astra'nın GPT-5.6'ya karşı üstünlüğü her ayarda üç puanın altında; xhigh'ta 0,6 puan ve max düzeyinde tamamen kayboluyor. Astra biraz daha hızlı ve daha az token kullanıyor, ancak bu görevlerde ona yaklaşık iki kat fazla ödüyorsunuz. Bu oranı kendi trafiğinizle karşılaştırmak isterseniz, GPT-5.6 fiyatlandırma analizimizde ve GPT-6 Astra API rehberimizde token başına ücretler yer alıyor.
"high" düzeyinin ötesinde daha fazla akıl yürütme neredeyse hiçbir şey kazandırmıyor
GPT-6 Astra'da high %80,7, xhigh ise %80,6 puan alıyor. Fazladan efor, biraz daha düşük bir puan karşılığında 1,4 saniye ve 2,1K token daha fazla maliyete yol açıyor. GPT-5.4 de aynı şekli gösteriyor: high'dan xhigh'a bir puan.
Büyük kazanımlar eğrinin alt kısmında. GPT-5.5'i low'dan medium'a taşımak 14,2 puan ekliyor. high'dan xhigh'a taşımak ise 1,8 ekliyor. Ajanınız bunun gibi günlük görevleri yürütüyorsa, ilk test edilecek ayar medium veya high'dır. OpenAI'nin akıl yürütme rehberi, Responses API'de effort parametresinin nasıl çalıştığını açıklıyor.
LifeVal neleri dışarıda bırakıyor
LifeVal faydalı bir sinyal, ancak kendi kendine bildirilen bir sinyal. Ondan alıntı yapmadan önce sınırlarını bilin.
- Kamuya açık değil. İndirilebilir bir görev seti ve herkese açık bir liderlik tablosu yok; OpenAI rubrikleri ya da puanlayıcılarını nasıl kalibre ettiğini de yayımlamadı. Yeniden çalıştıramazsınız.
- Yalnızca OpenAI modellerini puanlıyor. Hiçbir Claude, Gemini veya açık ağırlıklı model yer almıyor; dolayısıyla GPT-6.1 Sol'un Claude Sonnet 5.5 ile nasıl karşılaştığı ya da başka bir satıcılar arası eşleşme hakkında hiçbir şey söylemiyor.
- Ağırlıklandırılmış bir sürüm bir yerlerde var. Grafikte "WTP ağırlıklandırması yok" yazıyor; WTP, ödeme istekliliği anlamına geliyor. Bu, OpenAI'nin insanların her görev için ne ödemeye razı olacağına göre ağırlıklandırılmış bir varyantı hesapladığını ya da değerlendirdiğini, ancak yayımlamadığını ima ediyor.
- Örnek kartlar el ile seçilmiş. Sayfadaki beş kart %90,4 ile %100 arasında puan alıyor. En iyi modelin 169 görevlik ortalaması %80,6. Örnekler kıyaslamanın en iyi günlerini gösteriyor, tipik olanı değil.
Bunların hiçbiri LifeVal'i yanlış yapmaz. Onu bir satıcı kıyaslaması yapar. Herhangi bir lansman grafiğini okuduğunuz gibi okuyun: kendi görevlerinizde test edebileceğiniz bir iddia olarak.
Apidog CLI ile kendi akıl yürütme eforu testinizi çalıştırın
LifeVal'in efor bazlı tablosu bir ödül-maliyet eğrisidir. Aynı eğriyi kendi promptunuz için de çizebilirsiniz. İstekleri elle göndermek yerine işi kodlama ajanınıza verin ve Apidog CLI'yı onun yönlendirmesine bırakın.
CLI'ı kurun, oturum açın ve ajanınıza Apidog skill'ini ekleyin:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ardından Claude Code, Codex veya Cursor'a tek bir prompt verin:
In Apidog project <projectId>, add a POST https://api.openai.com/v1/responses
endpoint that sends {{model}}, reasoning.effort = {{effort}} and my test prompt.
Create a test case that asserts status 200 and saves latency,
usage.output_tokens and usage.output_tokens_details.reasoning_tokens.
Add a test data set with effort = low, medium, high, xhigh, run the case
once per row against environment <envId>, and give me a table of
latency, tokens and estimated cost per effort.
Ajan her payload şemasını okur, JSON'unu doğrular ve ardından şunları yazar:
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json

apidog test-case category --project <projectId>
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json

apidog cli-schema validate test-data-create --file efforts.json
apidog test-data create --project <projectId> --file efforts.json

apidog run --test-case <caseId> --project <projectId> -e <envId> \
  -d <testDataId> -r cli,json --out-dir ./effort-runs
-d bayrağı, her veri satırı için bir yineleme besler ve -r cli,json ajana tabloyu oluşturması için bir JSON raporu verir. Çalıştırmaları sonrasında Apidog uygulamasında gözden geçirmek isterseniz --upload-report ekleyin. apidog run komut referansı tüm bayrakları listeler ve Claude Code kurulum rehberi ajan tarafını ele alır.
Bunu bir taneyle değil, gerçek promptlarınızdan beş veya on tanesiyle çalıştırın. LifeVal 169 görevin ortalamasını alıyor, bunun bir nedeni var: tek bir prompt size efordan çok varyans hakkında bilgi verir.
Model seçerken LifeVal'e güvenmeli misiniz?
Bunu kararlar için değil, yön bulmak için kullanın. LifeVal size harekete geçebileceğiniz üç şey söylüyor: OpenAI'nin modelleri Aralık 2025 ile Mart 2026 arasında çok adımlı günlük görevlerde çok daha iyi hale geldi, o tarihten sonraki kazanımlar küçük ve high'ın üzerindeki akıl yürütme eforu bu tür işlerde nadiren karşılığını veriyor.
Size söyleyemediği şeyler ise OpenAI dışı bir modelin nasıl puan alacağı, sizin görevlerinizin OpenAI'nin 169 göreviyle nasıl karşılaştığı veya puanlayıcının neyi ödüllendirdiği. Bunun için yukarıdaki gibi kendi efor taramanızı çalıştırın ve görebildiğiniz sayıları karşılaştırın. GPT-6 Astra uygulamalı testimiz, yapmaya değer kontroller için bir başlangıç noktası.
SSS
LifeVal neyin kısaltması?
OpenAI sayfada adın açılımını vermiyor. Bu, günlük yaşam ("Life") görevlerinin bir değerlendirmesi ("Val"): bakım verme, sağlık, eğitim, ev idaresi, kişisel finans, alışveriş ve devlet hizmetleri genelinde 169 ajan tabanlı senaryo.
GPT-6 Astra'nın LifeVal puanı nedir?
xhigh efor düzeyinde %80,6 ortalama ödül; bu, OpenAI'nin Astra lansman blogunda kullandığı ayar. max efor düzeyinde Astra %82,5, high düzeyinde ise %80,7 puan alıyor.
LifeVal'i kendim çalıştırabilir miyim?
Hayır. OpenAI görev setini, rubrikleri veya puanlayıcıyı yayımlamadı. Apidog CLI gibi bir test altyapısıyla kendi promptlarınız üzerinde onun efor-maliyet analizine benzer bir analiz yapabilirsiniz, ancak LifeVal puanlarını yeniden üretemezsiniz.
LifeVal Claude veya Gemini'yi içeriyor mu?
Hayır. Her iki grafik de yalnızca GPT-5.2'den GPT-6 Astra'ya kadar OpenAI modellerini içeriyor. GPT-6.1 Sol ve GPT-6.1 Terra da eksik.
LifeVal maliyet sütunu dolar cinsinden mi?
OpenAI bunu API maliyeti olarak etiketliyor ama birimini belirtmiyor. Görev başına dolar değeri olarak değil, ayarları birbiriyle karşılaştırmak için kullanın; örneğin GPT-5.6 max 9,65'e karşı Astra max 20,04.
Günlük ajan görevleri için hangi akıl yürütme eforunu kullanmalıyım?
LifeVal'de kazancın çoğunu medium veya high yakalıyor. GPT-6 Astra high düzeyinde %80,7, xhigh düzeyinde %80,6 puan alıyor; bu yüzden daha fazlası için ödeme yapmadan önce kendi görevlerinizde medium ve high'ı test edin.