
Grok 4.6, xAI'ın 12 Ağustos 2026'da piyasaya sürülen öncü dil modelidir. Grok 4.5 üzerine inşa edilmiş olup, uzun süreli çalışan ajanlara, ajanik kodlamaya ve etkileşimli veya görsel çalışmalara odaklanır; milyon girdi token'ı başına 2 dolar ve milyon çıktı token'ı başına 6 dolar karşılığında 500.000 token'lık bir bağlam penceresi sunar. Yapay Analiz İstihbarat Endeksi'nde 61 puan alarak OpenAI'ın GPT-5.6 Sol'u ile eşleşiyor ve Anthropic'in Claude Fable 5'inin bir puan gerisinde kalıyor, bu da onu şu anda istihbarat sınırındaki en ucuz model yapıyor.
Bu, tek paragraflık cevaptır. Bu yazının geri kalanı, Grok 4.5'ten bu yana nelerin değiştiğini, kıyaslama rakamlarının ne anlama geldiğini, modeli bugün nerede kullanabileceğinizi ve eğer LLM API'lerine karşı geliştirme yapıyorsanız sizin için ne anlama geldiğini kapsıyor. Eğer bu son kısım sizin için geçerliyse, Apidog size, önce bir istemci yazmadan Grok 4.6'yı denemek için kullanışlı, LLM API çağrılarını tasarlamak, test etmek ve taklit etmek için ücretsiz bir çalışma alanı sunar.
TL;DR
- Yayınlanma: 12 Ağustos 2026, xAI tarafından.
- Odak: Uzun ufuklu ajanlar, çok adımlı kodlama, etkileşimli ve görsel çalışma. xAI, modelin ilerlemeden önce kendi kendini test ettiğini ve kendi işini daha sık doğruladığını belirtiyor.
- Teknik Özellikler: 500K bağlam penceresi, bilgi kesme tarihi 1 Şubat 2026.
- Fiyatlandırma: 1M girdi başına 2$, 1M çıktı başına 6$. Daha hızlı bir varyant 2 kat daha pahalıdır. İlk hafta Grok Build ve Cursor'da 2 kat kullanım hakkıyla birlikte gelir.
- Kıyaslamalar: İstihbarat Endeksi 61 (GPT-5.6 Sol ile eşit), DeepSWE'de 4.5'e göre büyük sıçramalar (54 → 65.9) ve APEX-Ajanlar'da (47.1 → 57.5).
- Nerede kullanılır: xAI API, Grok Build, Cursor, OpenRouter, Vercel ve Cloudflare.
Grok 4.6'ya Hızlı Bakış
| Özellik | Grok 4.6 |
|---|---|
| Geliştirici | xAI |
| Yayınlanma tarihi | 12 Ağustos 2026 |
| Bağlam penceresi | 500.000 token |
| Bilgi kesme tarihi | 1 Şubat 2026 |
| Girdi / çıktı fiyatı | 1M token başına 2$ / 6$ |
| Hızlı varyant | 2 kat fiyat |
| İstihbarat Endeksi | 61 (GPT-5.6 Sol: 61, Claude Fable 5: 62) |
| Erişilebilirlik | xAI API, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
Grok 4.5'e Kıyasla Gerçekten Ne Yeni?
Grok 4.6 bir mimari tanıtımı değil, bir eğitim hikayesidir. xAI'a göre model, Grok 4.5'ten daha uzun bir ek eğitim sürecinden geçti ve üç ana bileşen bu ağır işi üstlendi:
- Akıl yürütme ve gelişmiş teknik kavramları hedefleyen, özenle seçilmiş model tarafından oluşturulmuş veriler.
- xAI'ın gerçek geliştirme oturumları üzerinde eğitim vermeye başladığında başlayan yoğun kodlama diyetini sürdüren yüksek kaliteli mühendislik veri kümeleri.
- Akıl yürütme ve alana özgü alanlarda denetimli ince ayar yörüngeleri yeniden oluşturulmuş, geliştirilmiş bir optimize edici ve eğitim tarifi.
Geliştiricilerin fark edeceği davranışsal değişiklik, kendini doğrulamadır. Uzun ajanik çalışma süreçlerinde, Grok 4.6 doğrulanmamış bir varsayım üzerinden ilerlemek yerine, bir sonraki adıma geçmeden önce kendi işini kontrol eder, az önce yazdığı testi çalıştırır, az önce düzenlediği dosyayı yeniden okur. xAI ayrıca etkileşimli ve görsel projelerde (panolar, küçük uygulamalar ve kullanıcı arayüzü çalışmaları) ilk denemelerde daha güçlü sonuçlar bildirmektedir: ilk geçişte daha kullanışlıya yakın sonuçlar verir.
Eğer Grok 4.5'in eğitim yaklaşımı ilginizi çektiyse, Cursor oturum eğitiminin geliştiriciler için ne anlama geldiğine dair analizimiz, bu modelin üzerine inşa edildiği soyağacını kapsar.
Önemli Farklarla Kıyaslamalar
Satıcı lansman rakamları şüpheyle yaklaşmayı hak eder, ancak 4.5'ten 4.6'ya olan farklar anlamlı olacak kadar büyüktür. İşte rekabetin nerede durduğunu içeren tablo:
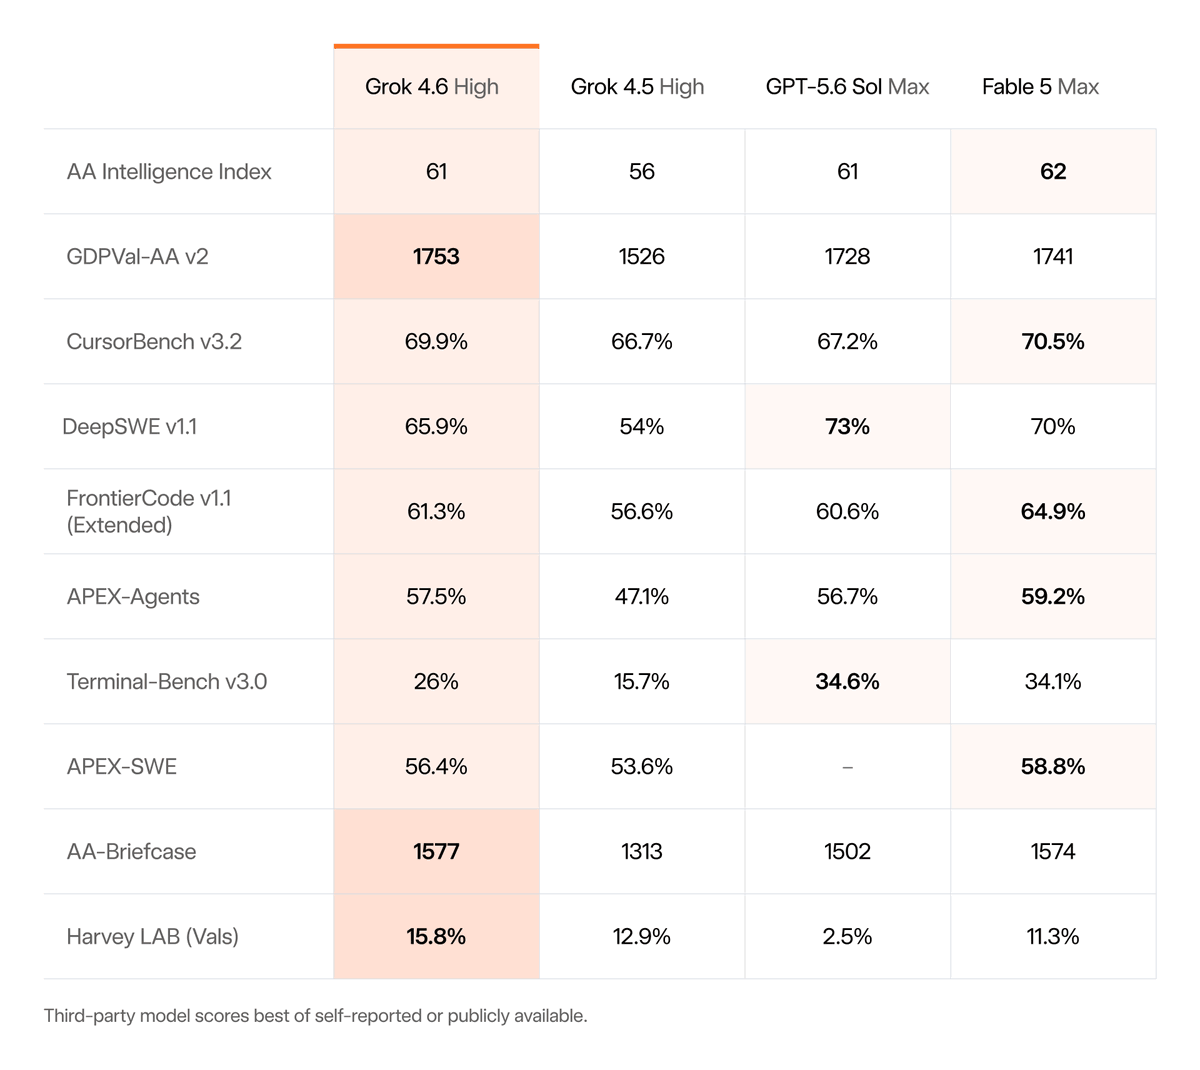
Üç önemli çıkarım:
- Ajan farkı kapandı. APEX-Ajanlar'da 10.4 puanlık sıçrama, Grok'u “açıkça geride” olmaktan Fable 5 Max'in 1.7 puan yakınına ve GPT-5.6 Sol Max'in (56.7%) biraz önüne taşıyor.
- Depo ölçekli kodlama en çok gelişti. DeepSWE'nin yaklaşık 12 puan artması, çoklu dosya değişikliklerinde tökezleyen bir model ile rekabet eden bir model arasındaki farkı gösteriyor, ancak Sol Max bu kıyaslamada hala büyük bir farkla önde.
- Bağımsız veriler hikayeyi destekliyor. Yapay Analiz, ajanik değerlendirmelerinde görev başına ortalama 0.84 dolarlık bir maliyet ölçtü, bu öncü seviye modeller arasında en düşüğüydü ve profesyonel bilgi çalışmaları için GDPval-AA v2'de 1753 Elo puanına ulaştı.
xAI'ın kıyaslama yayınlarını nasıl okuyacağınıza dair bağlam ve önceki nesilde de geçerli olan uyarılar için, Grok 4.5 kıyaslama analizimize bakınız.
Fiyatlandırma: Öncü Modelin Değer Stratejisi
Grok 4.6, Grok 4.5'in fiyatlandırmasını korudu: milyon girdi token'ı başına 2 dolar, milyon çıktı token'ı başına 6 dolar. Şu anda kıyaslandığı modellere karşı bu, belirgin bir fark:
| Model | Çıktı fiyatı / 1M token |
|---|---|
| Grok 4.6 | $6 |
| Claude Opus 4.8 | $25 |
| GPT-5.6 Sol | $30 |
Bu, birleşik istihbarat endeksinde GPT-5.6 Sol ile eşit olan bir model için çıktı tarafında 5 katlık bir fark anlamına geliyor. Ucuz token'lar otomatik olarak ucuz görevler anlamına gelmez; inceleme ve onarım gerektiren daha zayıf bir çalışma, token faturasından daha fazlaya mal olur, ancak bağımsız görev başına maliyet verileri, verimliliğin gerçek olduğunu, sadece düşük bir etiket fiyatı olmadığını gösteriyor.
2 kat fiyatla (4$/12$) sunulan daha hızlı varyant, gecikmeye duyarlı etkileşimli kullanım için tasarlanmıştır. Ve 19 Ağustos'a kadar, Grok Build ve Cursor kullanıcıları modeli test etmek için 2 kat dahil kullanım hakkı kazanır.
Grok 4.6'yı Bugün Nerede Kullanabilirsiniz?
- xAI API aracılığıyla console.x.ai üzerinden, OpenAI uyumlu. Grok 4.5 API rehberimiz doğrudan geçerlidir; sadece model adını değiştirin.
- Cursor, bir model seçeneği olarak mevcuttur; Cursor, xAI'ınkilerle birlikte kendi lansman notlarını yayınladı.
- Grok Build, xAI'ın kendi ajanik çalışma alanı, 2 kat lansman haftası kullanım bonusu ile.
- OpenRouter, Vercel ve Cloudflare, birden fazla modeli tek bir ağ geçidi üzerinden yönlendiren ekipler için; OpenRouter'da
x-ai/grok-4.6olarak listelenmiştir.
Burada çözülmesi gereken ayrı bir tüketiciye yönelik lansman yok: bu, geliştirici odaklı bir sürüm ve onu değerlendirmenin en hızlı yolu API veya onu zaten destekleyen bir IDE aracılığıyladır.
Sınırlamalar ve Açık Sorular
Lansman haftası değerlendirmesi, manşet rakamlarının yanı sıra dikkat edilmesi gerekenleri de size borçludur:
- Kıyaslamalar çoğunlukla satıcı tarafından bildirilmiştir. Yapay Analiz, genel olarak uyuşan bağımsız puanlar yayınlamış olsa da, belirli kodlama rakamları (DeepSWE, FrontierCode, CursorBench) xAI'ın kendi lansman tablosundan gelmektedir. Grok 4.5'in lansman rakamları bağımsız testlerde sadece kısmen doğrulandı; burada da ortalamaya doğru bir miktar gerileme olacağını varsayın.
- Bağlam penceresi öncü modeller arasında en küçüğüdür. 500K token çoğu gerçek iş yükünü karşılar, ancak GPT-5.6 Sol 1.05M ve Claude Fable 5 ise 1M sunar. Eğer tüm monorepuları veya büyük belge setlerini tek bir çağrıda işliyorsanız, bu fark önemlidir.
- Sol hala en zorlu alanlarda önde. 7 puanlık DeepSWE açığı, büyük mevcut kod tabanları üzerindeki tam otonom çalışmaların GPT-5.6 Sol Max'te daha güçlü kaldığı anlamına gelir ve bu, ekonomik olarak en değerli ajan iş yüküdür.
- Ekosistem olgunluğu geride kalıyor. xAI platformundaki toplu işleme, prompt önbellekleme katmanları ve kullanım kontrolleri, OpenAI ve Anthropic'in eşdeğerlerinden daha yenidir. OpenAI uyumluluğu bu durumun çoğunu, ancak tamamını örtmez.
Bunların hiçbiri diskalifiye edici değildir. Grok 4.6'nın nerede konumlandığını tanımlarlar: itibara dayanarak benimsediğiniz varsayılan seçenek değil, ciddiyetle değerlendireceğiniz fiyat-performans seçeneğidir.
API Geliştiricileri İçin Ne Anlama Geliyor?
Stratejik okuma: öncü modeller artık gerçek bir fiyat rakibine sahip. Bu sürüme kadar, GPT-5.6 Sol seviyesinde çıktı elde etmek, milyon çıktı token'ı başına 25-30 dolar ödemek anlamına geliyordu. Grok 4.6 bunu 6 dolara yapıyor, bu da özellikle ajan döngülerindeki matematiği değiştiriyor; görev başına 40 model çağrısı yapan bir ajan, çıktı fiyatındaki 5 katlık farkı hemen hisseder.
Pratik olarak, OpenAI uyumlu API, onu değerlendirmenin bir öğleden sonrası sürmesi anlamına geliyor, bir sprint değil. Mevcut istemcinizi https://api.x.ai/v1 adresine yönlendirin, gerçek iş yükünüzü ona karşı çalıştırın ve karşılaştırın. Bu karşılaştırmayı Apidog'da ayarlayın ve GPT-5.6, Claude ve Grok 4.6 isteklerini tek bir projede yan yana tutabilirsiniz; her sağlayıcı için ortamlar ve üçünün de çıktı kalitesini, token kullanımını ve gecikmeyi kontrol eden doğrulamalar ile, herhangi birine bir üretim iş yükü taahhüt etmeden önce faydalı kanıtlar elde edersiniz.
Modelin ajan odaklılığı, araç çağrısı doğruluğunun önemini de artırıyor. Grok entegrasyonunuz fonksiyon çağrısı içeriyorsa, sadece yazdığı metni değil, oluşturduğu payload'ları da test edin.
Sıkça Sorulan Sorular
Grok 4.6 tek bir cümlede nedir? xAI'ın Ağustos 2026 öncü modeli, uzun süreli çalışan ajanlar ve kodlama için ayarlanmış, 500K bağlam penceresi ve rakiplerinin çıktı fiyatının yaklaşık beşte biri maliyetinde öncü seviye kıyaslama puanlarına sahip.
Grok 4.6, GPT-5.6'dan daha mı iyi? Yapay Analiz İstihbarat Endeksi'nde 61 puanla eşitler. GPT-5.6 Sol Max, depo ölçekli kodlamada (DeepSWE) liderdir; Grok 4.6 APEX-Ajanlar'da öne geçer ve çıktı token'ı başına yaklaşık 5 kat daha az maliyetlidir.
Grok 4.5 ile 4.6 arasındaki fark nedir? Aynı fiyat, aynı API, anlamlı derecede daha iyi bir model: DeepSWE'de +11.9 puan, APEX-Ajanlar'da +10.4 puan ve uzun görevler sırasında kendini doğrulama eğilimi.
Grok 4.6'yı ücretsiz deneyebilir miyim? Grok Build ve Cursor, lansman haftası boyunca 2 kat kullanım içerir ve Grok 4.5'i ücretsiz kullanma rehberimizdeki yöntemler büyük ölçüde 4.6'ya taşınabilir.