
Bir model ailesindeki en ucuz katman, eskiden güvenmediğiniz katman olurdu. Oraya sınıflandırma, özetleme ve yeniden deneme trafiği gönderir, temsilci tabanlı her şeyi amiral gemisinde tutar ve bütçe modelinin bir görev birden fazla adım gerektirdiğinde çökeceğini kabul ederdiniz.
22 Eylül 2026'da duyurulan GPT-6 Luna, o katman gibi fiyatlandırılmış olmasına rağmen o şekilde davranmıyor. Milyon giriş belirteci başına 0,10 dolar ve milyon çıkış belirteci başına 0,50 dolara mal oluyor, 1 milyon belirteçlik bir bağlam penceresine sahip ve OpenAI'nin yayınladığı rakamlar, onu görev başına maliyetlerinin küçük bir kısmında, temsilci tabanlı kodlama kıyaslamalarında öncü modellerin aralığına yerleştiriyor.
Öncelikle netleştirmemiz gereken bir şey var: bu, halihazırda bir yedekleme zincirine bağlamış olabileceğiniz GPT-5.6 Luna değil. Aynı katman adı, yeni model, yeni fiyat, yeni bağlam penceresi. Aksi takdirde varsaymak, sessiz bir davranış değişikliği göndermenin ve bunu ancak bir destek biletinden öğrenmenin kolay bir yoludur.
GPT-6 Luna'ya Genel Bakış
| Öğe | Değer |
|---|---|
| API model Kimliği | gpt-6-luna |
| Giriş fiyatı | Milyon belirteç başına $0.10 |
| Çıkış fiyatı | Milyon belirteç başına $0.50 |
| Önbelleğe alınmış giriş okumaları | %90 indirim |
| Bağlam penceresi | 1.000.000 belirteç |
| Yapay Analiz İstihbarat Endeksi | 37 |
| Duyurulma tarihi | 22 Eylül 2026, GPT-6 Sol ile birlikte |
| Kullanılabilirliği | ChatGPT Work ve Codex, Ücretsiz ve Go kullanıcıları için masaüstü uygulaması, ayrıca API |
| Mevcut olmadığı yerler | Lansman itibarıyla Sohbet |
Aynı aile içinde, GPT-6 Sol, 872.000 belirteçlik bir pencere ve 48'lik bir endeksle 2$/10$ olarak fiyatlandırılırken, GPT-6 Astra 10$/50$'dır. OpenAI, Astra'nın “genel olarak en iyi modelimiz olmaya devam ettiğini” belirtiyor, bu nedenle Luna en akıllı model olarak satılmıyor. Görev başına maliyetin düştüğü model olarak satılıyor.
Bu yeni bir model, yeniden adlandırılmış bir katman değil
GPT-5.6 ailesi Sol, Terra ve Luna'dan oluşuyordu. GPT-6 ailesi Astra, Sol ve Luna'dan oluşuyor. İki isim taşınırken, Terra taşınmadı ve Astra yeni. OpenAI, Sol ve Luna'yı GPT-6 Astra ile benzer yöntemlerle eğitilmiş olarak tanımlıyor, yani eski modellerle aynı adlandırma geleneğini paylaşan yeni modellerdir.
GPT-6 Terra diye bir şey yok. GPT-5.6 adlandırma şeması etrafında bir yönlendirme merdiveni inşa ettiyseniz, orta basamak artık mevcut değil ve Sol'un Terra ve Luna'ya karşı önceki karşılaştırmamız artık güncel rehberlikten ziyade tarih olarak okunuyor.
Fiyat soy ağacı, katmanın ne kadar ilerlediğini gösteriyor:
| Katman | GPT-5.6 liste | GPT-5.6 promosyonel | GPT-6 |
|---|---|---|---|
| Sol | $5 / $30 | $4 / $20 | $2 / $10 |
| Terra | $2.50 / $15 | $2 / $12 | GPT-6 Terra yok |
| Luna | $1 / $6 | $0.20 / $1.20 | $0.10 / $0.50 |
Tüm rakamlar milyon giriş belirteci ve milyon çıkış belirteci başına verilmiştir. GPT-5.6 satırları, o zamanki haberlerimizden, GPT-5.6 fiyatlandırması ve GPT-5.6 fiyat indiriminden alınmıştır.
OpenAI, Sol ve Luna'yı GPT-5.6 promosyonel fiyatlandırmasından %50 daha ucuz olarak tanımlıyor. "Promosyonel" kelimesi OpenAI'nin kendi ifadesidir ve iddianın anlamını değiştirir: karşılaştırma, GPT-5.6'nın piyasaya sürüldüğü fiyat üzerinden değil, indirimli bir oran üzerinden yapılmıştır. GPT-5.6 Luna'nın 1$/6$'lık liste fiyatına göre ölçüldüğünde, 0,10$/0,50$ olan GPT-6 Luna, girişte %90 ve çıkışta %92'lik bir indirim anlamına geliyor. Gerçek indirim başlıktan daha büyüktür ve başlık bir indirim üzerinden ölçülmüştür. Bütçe modelinize ilk rakamı değil, ikinci rakamı koyun.
Ucuz model daha büyük bağlam penceresine sahip
Lansman haberlerinin çoğu bu detayı atladı. Luna 1.000.000 belirteçlik bir bağlam penceresiyle geliyor. Sol ise yirmi katı fiyata 872.000 ile geliyor.
Bu, birçok yönlendirme kodunun kodladığı bir varsayımı tersine çeviriyor: yük büyüdüğünde bir isteği daha pahalı bir modele yükseltmeniz gerektiği varsayımı. GPT-6 ile ailedeki en büyük pencere fiyat listesinin en altında yer alıyor. 900.000 belirteçlik bir belge Sol'a sığmazken Luna'ya sığar.
Hesaplama iki fiyattan geliyor. Luna'nın tam penceresini bir kez doldurmak giriş belirteçlerinde 0,10 dolara mal olur. Sol'un 872.000 belirteçlik penceresini bir kez doldurmak yaklaşık 1,74 dolara mal olur. Claude Opus 5.5'in 1M penceresini milyon başına 4 dolardan doldurmak 4,00 dolara mal olur. Aynı yük sınıfı için, okumak için ödediğiniz fiyatta kırk katlık bir fark var.
OpenAI'nin önbellekleme çalışmasını bunun üzerine ekleyin ve fark tekrar açılır. GPT-6, önbelleğe alınmış giriş okumalarına %90 indirim uyguluyor, bu nedenle çağrılar arasında önbellekte kalan 1M belirteçlik bir önek, 0,10 dolar yerine yaklaşık 0,01 dolara yeniden okunur. OpenAI ayrıca GPT-6'nın varsayılan olarak daha yüksek önbellek isabet oranları aldığını, muhakeme çabasını veya araç kullanılabilirliğini değiştirmenin artık önbelleği geçersiz kılmadığını ve açık kesme noktalarının önbelleğe alınmış bir önekin nerede bittiğini kontrol etmenize olanak tanıdığını belirtiyor. GitHub, milyarlarca istekte %50'den fazla daha az istem belirtecinin yeni işleme ihtiyacı olduğunu bildiriyor.
OpenAI ne yayınladı
Aşağıdaki her sayı OpenAI'nin lansman materyalinden alınmıştır. Muhakeme çabası ayarları parantez içinde görünmektedir, çünkü bu modeller farklı çaba seviyelerinde çok farklı puanlar alır ve çaba ayarı olmayan bir kıyaslama satırı kullanılabilir bir sayı değildir.
| Kıyaslama | GPT-6 Luna | Karşılaştırma noktası |
|---|---|---|
| DeepSWE 1.1 | %66,6 (maks) | Orta düzeyde Claude Opus 5 ve Claude Fable 5 ile karşılaştırılabilir, görev başına Opus 5'ten %93 ve Fable 5'ten %96 daha ucuz |
| AutomationBench 1.0.6 | Selefini 5,4 puan geride bırakıyor (yüksek) | Görev başına %58 daha düşük maliyetle |
| OSWorld 2.0 çevrimdışı | Maksimum çabayla GPT-5.6 Sol'u (orta) geçiyor | Yaklaşık onda bir maliyetle |
| Gerçeklik | Daha yüksek çabayla GPT-5.6 Sol ile eşleşiyor | Yaklaşık yüzde bir maliyetle |
DeepSWE satırı üzerinde durulması gereken bir nokta. Milyon giriş belirteci başına 0,10 dolar olan bir modelin, orta çaba düzeyindeki iki öncü modelle aynı bölgede, temsilci tabanlı bir yazılım mühendisliği kıyaslamasında %66,6 puan alması ve bunlardan birine göre görev başına %93 daha az maliyetle gelmesi, bir bütçe katmanından farklı bir önermedir. Bu, Luna'nın en zorlu işlerinizde öncü bir modelin yerini alacağı anlamına gelmez. Bu, “bunu ucuz modele yönlendir” ile “bu pahalı olanı gerektiriyor” arasındaki sınırın değiştiği anlamına gelir ve bu çizgiyi Eylül 2026'dan önce nereye çizmiş olursanız olun, şimdi yanlış yere çizilmiştir.
Gerçeklik sonucu, sıradan ürün çalışmaları için en önemli olma olasılığı yüksek olandır. Önceki neslin orta katmanıyla olgusal doğrulukta eşleşmesi, yaklaşık yüzde bir maliyetle, Luna'yı sadece dahili toplu işler yerine kullanıcıya yönelik özetleme ve çıkarma için uygun kılan şeydir.
Buradaki her karşılaştırma Claude Opus 5'e karşı yapılmıştır
Bu satırların hangi Claude modeline karşı kıyaslandığını unutmayın. Claude Opus 5.
Anthropic, aynı gün Claude Opus 5.5'i Opus 5'in 5$/25$'ına karşı 4$/20$ fiyatla piyasaya sürdü ve Yapay Analiz İstihbarat Endeksi'nde 58 puanla en üst sırayı alarak 212 model arasında birinci oldu. OpenAI'nin lansman yazısı Opus 5.5'in varlığından önce yazıldığından, Opus 5'e karşı yapılan her görev başına maliyet karşılaştırması, yayınlandıktan birkaç saat içinde yerini alan bir modele karşı ölçülmüştür.
Bu, OpenAI'nin rakamlarını yanlış yapmaz. Yapılan karşılaştırma için doğrudurlar. Ancak “Opus 5'ten %93 daha ucuz” ifadesini hangi Opus'a atıfta bulunduğunu belirtmeden bir tedarik belgesine piyasanın mevcut durumu olarak taşımamanız gerektiği anlamına gelir. Hiçbir satıcı, Luna'yı Opus 5.5'e karşı doğrudan karşılaştıran bir yayın yapmadı ve sosyal medyada dolaşan karşılaştırmalar, laboratuvarlardan ziyade bireysel test kullanıcılarından geliyor. Fiyat savaşı sütunumuz, her üç lansmanı tek bir tabloda birbirine karşı takip ediyor.
Gecikme süresi: ucuz model hızlı model değildir
Yapay Analiz'den alınan üçüncü taraf ölçümleri, GPT-6 Luna'yı saniyede 153,9 çıkış belirteci ve ilk belirteç için 124,23 saniyelik bir süre ile konumlandırıyor. İki uyarı geçerlidir ve her ikisi de önemlidir. Bunlar üçüncü taraf rakamlarıdır, satıcı tarafından yayınlanmamıştır. Ve mevcut en yavaş ve en pahalı yapılandırma olan maksimum muhakeme varyantı üzerinde ölçülmüştür.
Her iki uyarıya rağmen, yönü anlamaya değer: Luna, ilk belirtece ulaşmada Sol'dan daha yavaş ölçülüyor; Sol 102,15 saniye ölçülmüştür. Bu ailede fiyat ve gecikme süresi korelasyonlu değildir. İlk belirteç gelmeden önce iki dakikalık bir bekleme, varsayılan bir HTTP istemcisi zaman aşımını kırar, bir yük dengeleyiciyi boşta bırakır ve çoğu sunucusuz çalışma zamanında yürütme tavanını aşar. Yüksek çabayla senkronize bir uç noktayı Luna'ya yönlendiriyorsanız, entegrasyon çalışması isteminizde değil, zaman aşımı ve akış katmanınızda yer alır.
Kendi iş yükünüze karşı test etmeden önce ona yönlendirmeyin
Kıyaslama tabloları toplu veridir. Sizin isteminiz ise değildir. Asıl önemli soru, Luna'nın trafiğinizde karşılayabileceğiniz bir çaba düzeyinde ne kadar iyi performans gösterdiğidir ve bu soruyu doğru bir şekilde yanıtlamak yaklaşık on dakika sürer.
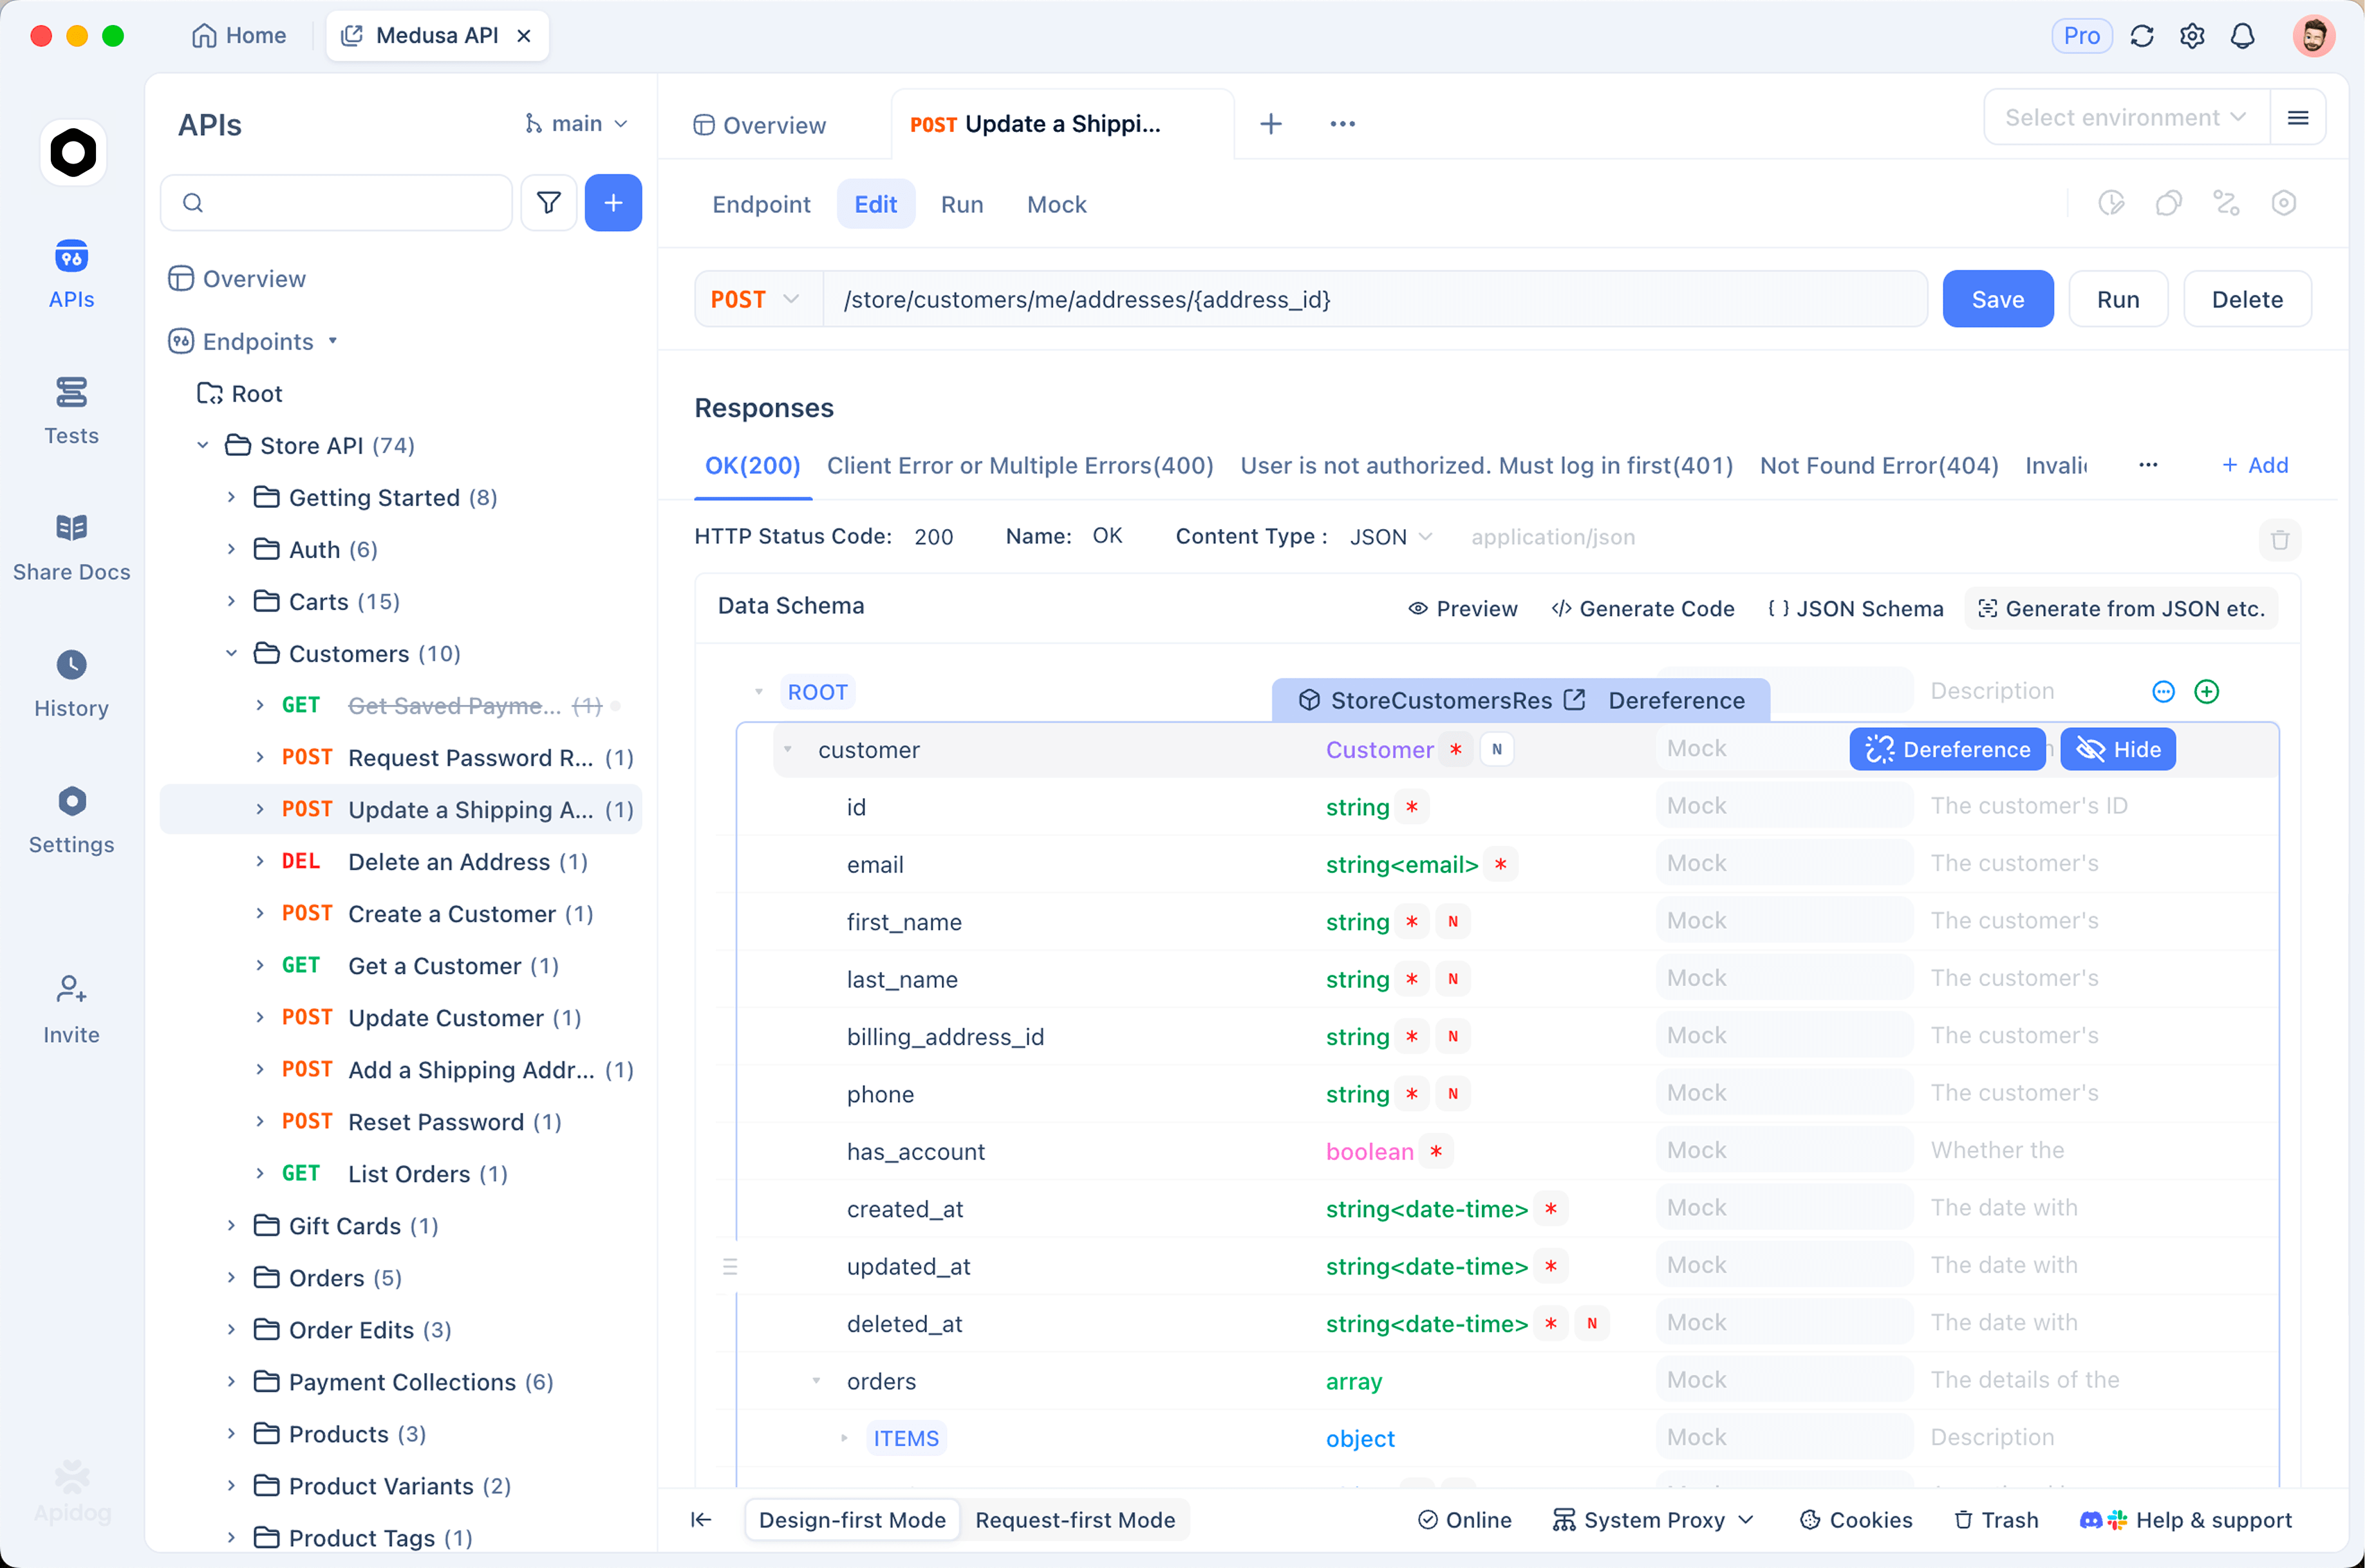
Her model için bir istek ayarlayın, model kimliğini parametreleştirin ve aynı yükü katman boyunca çalıştırın:
curl https://api.openai.com/v1/responses \
  -H "Authorization: Bearer $OPENAI_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-luna",
    "input": "Extract every endpoint, method and required parameter from the OpenAPI document below as JSON.",
    "reasoning": { "effort": "high" }
  }'
Bu şekil üzerine inşa etmeden önce uç nokta ve parametre adlarını OpenAI'nin mevcut model referansına göre doğrulayın. `gpt-6-luna` model kimliği, lansman materyalinden onaylanan kısımdır.
Apidog'da, aynı istek, model kimliği bir ortam değişkeni olarak kaydedilmiş bir uç nokta haline gelir, böylece tek bir koleksiyon Luna, Sol ve Astra'yı hiçbir şeyi tekrarlamadan kapsar. Bunu bir test senaryosu olarak çalıştırın ve her çalıştırma başına yanıt süresi ve belirteç kullanımını alırsınız, ayrıca yanıt şekli üzerinde iddialar, ki bu daha ucuz bir modelin gerçek hata modunu yakalayan şeydir: yanlış bir cevap değil, ayrıştırıcınızın beklediği JSON şemasına uymayı bırakan bir yanıt. Aynı senaryoyu üç farklı çaba düzeyinde çalıştırın ve başkasının kıyaslama paketinden ziyade kendi istemleriniz için bir maliyet, gecikme süresi ve güvenilirlik tablosuna sahip olursunuz.
Luna ne zaman doğru seçimdir
Yük büyük olduğunda, görev iyi tanımlanmış olduğunda ve çıktıyı programlı olarak doğrulayabildiğinizde Luna'ya yönlendirin. Belge çıkarma, spesifikasyon ayrıştırma, günlük triyajı, test üretimi, yüksek hacimli sınıflandırma ve 1M'lik bir pencerenin size bir bölme hattı maliyetinden tasarruf ettirdiği herhangi bir toplu işin hepsi uygun durumlardır ve uzun bir önek çağrılar arasında sabit kaldığında önbellekleme indirimi katlanır.
Cevabı ucuza kontrol edemediğiniz işler için ve kendi trafiğinizde ilk belirteç süresini ölçene kadar gecikmeye duyarlı her şey için pahalı katmanı saklayın. Luna çizgiyi hareket ettirdi. Onu silmedi.