
Together AI, Fireworks AI ve Groq'un üçü de aynı vaadi satıyor: mevcut OpenAI istemcinizi yeni bir base URL'e yönlendirin, anahtarı değiştirin ve açık ağırlıklı modelleri maliyetin çok altında bir fiyata kullanın. Bu vaat doğru. Doğru olmayan şey ise ücretsiz katmanlarını karşılaştırmanın üç sayıyı yan yana dizmek kadar basit olduğu; çünkü üç sağlayıcıdan ikisi sabit bir sayı bile yayımlamıyor.
Groq istisna: rate-limits sayfası, çoğu okuyucunun yanındaki Developer Plan sekmesine geçerken gözden kaçırdığı bir sekmede, her model için gerçek Free Plan sayılarını yayımlıyor. Together AI ise kendi dokümanlarında, yayımlanacak sabit model başına limiti olmadığını açıkça söyledi; tavanınız kullanımınızla birlikte hareket ediyor. Fireworks AI ücretsiz erişimini bir plan katmanına değil, tek seferlik bir kredi bakiyesine bağlıyor. Üç farklı tasarım ve "hangi ücretsiz katman daha büyük" başlıklı bir makale bunu hâlâ tek bir sayıya indirgeyemiyor.
Kısaca
Groq, Together AI ve Fireworks AI'nın üçü de OpenAI uyumlu bir endpoint sunuyor; yani aralarında geçiş yapmak yeniden yazım değil, bir base URL ve bir API anahtarı meselesi. Groq erişimi bir Free Plan ile ücretli bir Developer Plan olarak ikiye ayırıyor ve diğer ikisinden farklı olarak, model başına gerçek Free Plan sayılarını yayımlıyor; örneğin gpt-oss-120b ve gpt-oss-20b için 30 RPM / 1K RPD / 8K TPM / 200K TPD. Together AI sabit ücretsiz katman sayıları yayımlamıyor; dokümanları limitlerin canlı kapasitenize ve son başarılı kullanımınıza göre dinamik olarak hareket ettiğini söylüyor. Fireworks AI ise yeni hesaplara yinelenen bir ücretsiz kota yerine tek seferlik bir kredi bakiyesi ($1, fiyatlandırma sayfasına göre) veriyor. Manşet sayıdan daha önemli olan karar, gerçekte hangi modellere ihtiyacınız olduğu ve sınıra ulaştığınızda her sağlayıcının tavanının nasıl davrandığı. Apidog, tek bir isteği kaydedip base URL ile anahtarı ortam başına değiştirmenize olanak tanır; böylece bir tabloya güvenmek yerine üçünü de kendiniz ölçebilirsiniz.
Tek API şekli, üç anahtar
Üç sağlayıcı da bilinçli olarak OpenAI Chat Completions şemasını birebir taklit ediyor. Bu araçların geçiş kılavuzlarının her seferinde aynı şekilde okunmasının nedeni de bu: base_url'i değiştir, Authorization başlığını değiştir, kodunun geri kalanını olduğu gibi bırak. Groq'un OpenAI uyumlu base'i https://api.groq.com/openai/v1/. Together AI'nınki, hızlı başlangıç dokümanlarında doğrudan doğrulandığı üzere https://api.together.ai/v1. Fireworks AI'nınki ise OpenAI uyumluluk kılavuzuna göre https://api.fireworks.ai/inference/v1.
Bu ortak şekil, kafa kafaya bir testin neden yapmaya değer olduğunu açıklıyor: dördüncü ya da beşinci bir sağlayıcıyı eklemek yeniden tasarım değil, birkaç dakika demek. Bu tür çok sağlayıcılı bir kurulumu yönetmenin mekaniğini Apidog'da ortamlar arasında base URL'leri nasıl yöneteceğiniz yazımızda ele alıyoruz; yönlendirme seçeneklerini daha geniş açıdan değerlendiriyorsanız, OpenRouter alternatifleri derlememiz bu üçünün o tablodaki yerini kapsıyor.
Her ücretsiz katman hakkında gerçekten doğrulayabilecekleriniz
İşte yalnızca her sağlayıcının Eylül 2026 itibarıyla kamuya açık şekilde belirttiklerinden oluşturulmuş karşılaştırma. Bir sağlayıcı bir sayı açıklamadığında tablo, tahmin yürütmek yerine bunu belirtiyor.
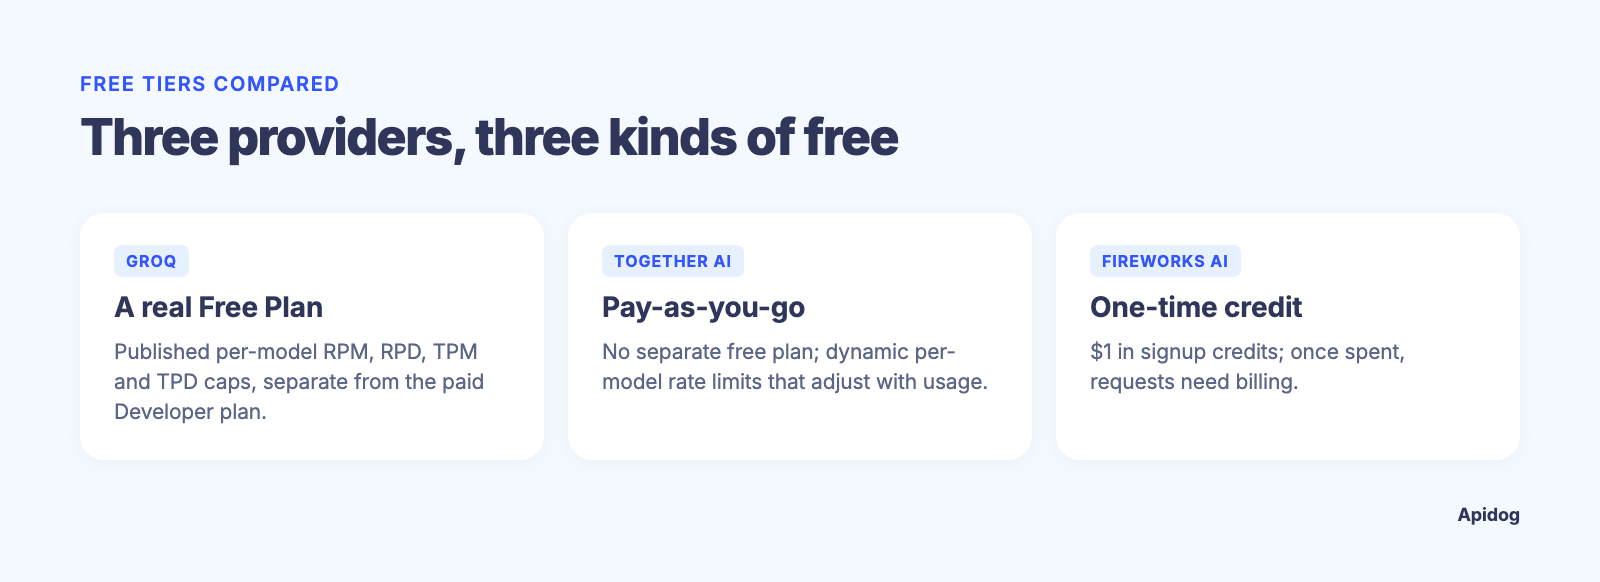
| Groq | Together AI | Fireworks AI | |
|---|---|---|---|
| Ücretsiz erişim modeli | Free Plan (ücretli Developer Plan'dan ayrı) | Kayıttan itibaren kullandıkça öde; ayrı bir "ücretsiz plan" adı yok | Tek seferlik kayıt kredisi |
| Belgelenmiş ücretsiz kota | Model başına yayımlanıyor: gpt-oss-120b/gpt-oss-20b 30 RPM, 1K RPD, 8K TPM, 200K TPD; compound 30 RPM, 250 RPD, 70K TPM (Groq rate limits sayfasına göre, okunduğu tarih 2026-09-15) |
Sabit sayılar olarak yayımlanmıyor; organizasyon başına dinamik olduğu belirtiliyor | Fireworks fiyatlandırmasına göre 1 $ ücretsiz kredi |
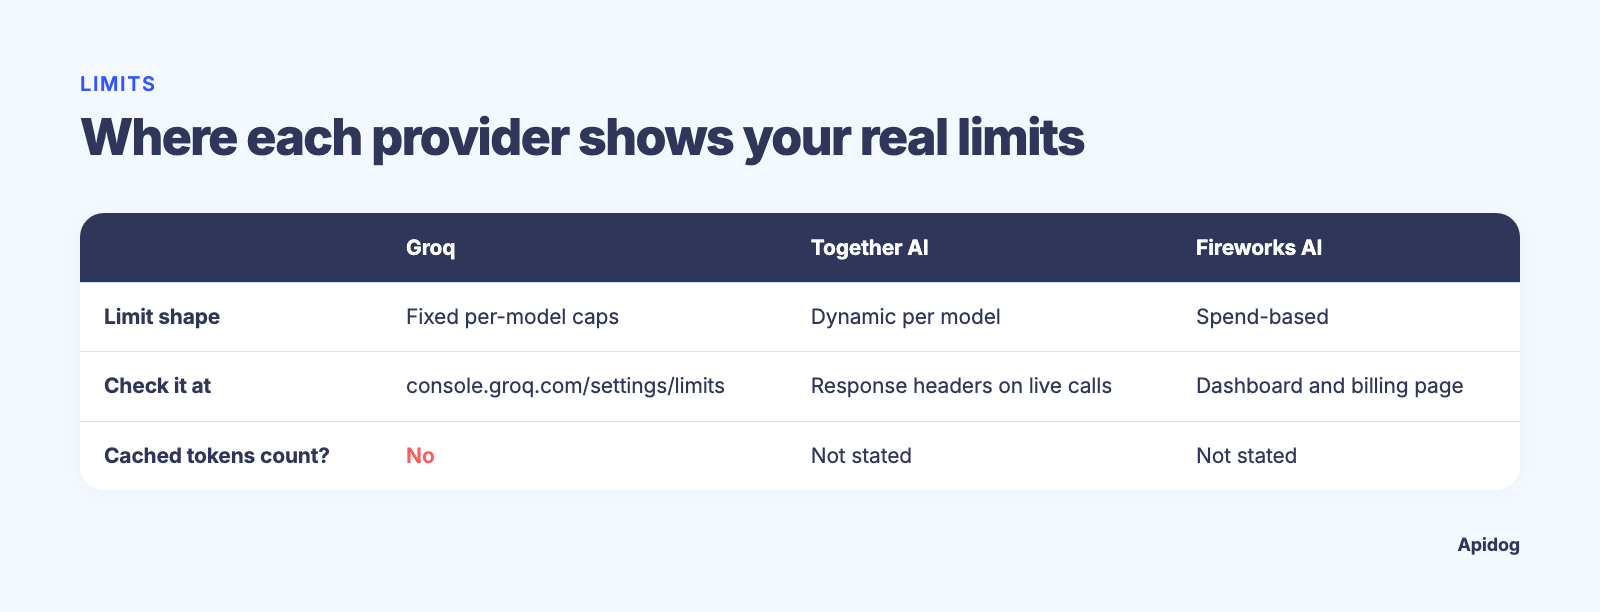
| Limitler nasıl şekilleniyor | Model başına RPM/RPD/TPM/TPD üst sınırları, organizasyon düzeyinde uygulanıyor | Model başına dinamik hız; canlı kapasitenize ve son başarılı kullanımınıza göre ayarlanıyor | Harcama bazlı; kredi tükendiğinde istekler için faturalandırmanın etkinleştirilmesi gerekir |
| Kendi sayılarınızı nereden kontrol edersiniz | console.groq.com/settings/limits |
Canlı çağrılardaki yanıt başlıkları, örn. x-ratelimit-reset |
Hesap paneli ve faturalandırma sayfası |
| Önbelleğe alınan token'lar limitlere sayılır mı? | Hayır, Groq'un kendi dokümanlarına göre | İncelediğimiz sayfalarda belirtilmemiş | İncelediğimiz sayfalarda belirtilmemiş |
Bir özellik özeti yerine kaynak sayfaları gerçekten okuduğunuzda iki şey öne çıkıyor. Birincisi, yukarıdaki Groq Free Plan sayıları yayımlanmış varsayılanlar; aynı sayfada daha yüksek tavanlı bir Developer Plan sekmesi de var ve sizinkiler farklıysa yetkili kaynak console.groq.com/settings/limits. İkincisi, Together AI'nın hız sınırlaması bir tablo değil. Kendi rate-limits sayfası, "yayımlanmış sabit model başına limit yok" ifadesini açıkça kullanıyor ve tavanınızın "sürekli, başarılı trafikle" yükseleceğini belirtiyor. Bu, statik bir ücretsiz katman satırından anlamlı biçimde farklı bir model ve şu anlama geliyor: "Together'ın ücretsiz RPM'i kaç?" sorusunun dürüst cevabı bir tablodan çekilen bir sayı değil, "yanıt başlıklarınıza bakın" olur.
Her seferinde tek bir ürün için doğrulanabilir sayılarla tek sağlayıcılı derinlemesine incelemeler istiyorsanız, Groq API ücretsiz katmanı ve Cerebras API ücretsiz katmanı yazılarımıza bakın. Bu makale merkez nokta; o ikisi sağlayıcı bazında kazı işini tümüyle yapıyor.
İstekler vs token'lar, sabit vs dinamik
Bu üçü arasındaki gerçek tasarım farkı ücretsiz kotanın büyüklüğü değil, tavanın şekli.
Groq'un modeli, çoğu geliştiricinin başka yerlerde hız limitleriyle çalışırken zaten bildiği model: zaman penceresi başına sabit bir üst sınır, RPM, RPD, TPM ve TPD olarak bölünmüş ve API anahtarı başına değil organizasyon düzeyinde uygulanıyor. Yani tek bir Groq hesabı altında üç hizmet için üç anahtar oluşturursanız, hepsi tek bir havuzu paylaşır. GPT API hız limitleri genel kılavuzumuz, token bazlı üst sınırlarla daha önce çalışmadıysanız aynı RPM/TPM yapısını daha derinlemesine ele alıyor.
Together AI'nın modeli, ani trafiği sert bir duvarla cezalandırmak yerine istikrarlı, başarılı trafiği ödüllendiriyor. Sakin bir hesap ile yoğun ama uslu bir hesap aynı tavanı almıyor; çünkü tavan, hesabınızın kendi son geçmişine ve o andaki modelin canlı kapasitesine göre ayarlanıyor. İş yükünüz güvenilirse bu iyi haber; trafiğiniz doğası gereği ani dalgalıysa bu gerçek bir bilinmez.
Fireworks AI, yeni kullanıcılar için ücretsiz dönemi istek hızı penceresine değil bir dolar bakiyesine bağlayarak hız limiti tasarımını neredeyse tamamen devre dışı bırakıyor. API'yi ne kadar hızlı çağırdığınızla sınırlanmıyorsunuz; bakiye tükenmeden çağrılarınızın ne kadara mal olduğuyla sınırlanıyorsunuz. Bu, planlama sorusunu "dakikada kaç istek"ten "bu modelin token başına fiyatıyla 1 $ kaç token alır"a çeviriyor; ki bu tamamen hangi modeli seçtiğinize bağlı.
Bunlar, bir "ücretsiz" katmanın ne tür bir kullanıma karşı koruma sağlaması gerektiğine dair farklı bahisler: sürekli hacim, ani zirveler ya da toplam harcama. Hangisine karşı geliştiriyor olursanız olun, sonunda bir 429 ile karşılaşacaksınız ve bir sağlayıcının o anı nasıl bildirdiği, onu tetikleyen sayı kadar önemli. Hız limiti aşıldı sorun giderme kılavuzumuz, bu yanıt başlıklarını okumayı ve sorunu daha da kötüleştirmeyen yeniden deneme mantığı kurmayı adım adım anlatıyor.
Beş dakikada kendiniz kanıtlayın
Bu verilerin büyük kısmı bir giriş ekranının ya da canlı bir yanıt başlığının arkasında olduğu için gerçek bir cevaba giden en hızlı yol başka bir özellik özeti makalesi değil, kodlama ajanınızın üçüne karşı çalıştıracağı tek bir test. Apidog CLI ile bu tek bir istem. Bir kez kurun:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Token, Apidog'da Hesap Ayarları, API Access Token altından alınır. Ardından ajana tek bir istem verin:
Use Apidog CLI on project <id>. Create Groq, Together and Fireworks environments
with the OpenAI-compatible base URLs from this article and a comparable model id
in a MODEL variable. Add POST /chat/completions with Bearer auth from {{API_KEY}}
and one test case with an identical prompt and max_tokens. Run it once per
environment with that provider's key, then compare status, latency and the
x-ratelimit headers.
Çalıştırdığı komutlar, Apidog CLI 2.2.7'ye göre doğrulandı:
apidog environment create Groq --project <id> --base-url https://api.groq.com/openai/v1
apidog environment create Together --project <id> --base-url https://api.together.ai/v1
apidog environment create Fireworks --project <id> --base-url https://api.fireworks.ai/inference/v1
apidog cli-schema validate test-case-create --file chat-case.json
apidog test-case create --project <id> --file chat-case.json
apidog run --test-case <caseId> --project <id> -e <togetherEnvId> \
  --env-var "API_KEY=$TOGETHER_API_KEY" -r cli,json
Artık sağlayıcı değiştirmek bir ortam kimliği; yeniden yazım değil. Başlıklar, Together AI'nın dinamik tavanının gerçek zamanlı olarak göründüğü ve Groq organizasyonunuzun yayımlanan Free Plan tablosuyla eşleştiğini doğrulayabileceğiniz yer. Gecikmeyi de karşılaştırmada tutun: teknik olarak ücretsiz ama yavaş bir model, etrafından dolaşmak için harcanan zamanı hesaba kattığınızda aslında daha ucuz değildir. Bu, üç pazarlama sayfasını kendi hesabınızdan tek bir karşılaştırılabilir veri kümesine dönüştürür. Karşılaştırmayı daha büyük bir ajan yapısı içinde sürekli çalıştırıyor musunuz? AI ajanları için API test araçları yazımız bunu kapsıyor ve Cursor'da Apidog CLI yazımız ajan kurulumunu gösteriyor.
Hangi ücretsiz katman kullanım senaryonuza uyuyor
Yalnızca bugün doğrulanabilir olanlara dayanarak, birkaç dürüst öneri:
- Giriş yapmadan okuyabileceğiniz öngörülebilir model başına üst sınırlar: Groq gerçek Free Plan sayılarını yayımlıyor (
gpt-ossmodellerinde 30 RPM / 1K RPD / 8K TPM / 200K TPD) vellama-3.1-8b-instant,llama-3.3-70b-versatileileopenai/gpt-ossmodellerindeki 131.072 token'lık bağlam penceresi, tek bir endpoint üzerinde çok çeşitli açık ağırlıklı iş yüklerini karşılıyor. - İstikrarlı, uslu trafik ve hız limitlerini takip etmeye ilgi duymama: Together AI'nın dinamik modeli bu kalıba uyuyor; sürekli başarılı kullanım, sizi ilk günden belirlenmiş bir sayıda sınırlamak yerine kendi tavanınızı zamanla yükseltiyor.
- Sıfır kurulum sürtünmesi, bir harcama duvarına çarpmakta rahat olma: Fireworks AI'nın kredi bazlı ücretsiz erişimi, ilk çağrıdan itibaren gerçek token başına fiyatlandırmayı test ediyor; asıl soru istek sayısı değil ölçekte maliyet olduğunda kullanışlı.
Üçü de açık ağırlıklı modellerin farklı alt kümelerini barındırıyor ve bir sağlayıcıda görevinize uyan bir model diğerinde olmayabilir.
SSS
Together AI, Fireworks AI ve Groq'un üçü de OpenAI SDK'yı mı kullanıyor? Evet. Üçü de OpenAI uyumlu endpoint'ler belgeliyor; yani base URL ve anahtarı değiştirdiğinizde standart openai istemci kütüphanesi bunlardan herhangi biriyle çalışıyor.
Hangi sağlayıcının ücretsiz katmanı en büyük? Doğrudan karşılaştırabileceğiniz bir şekilde değil. Groq model başına gerçek Free Plan sayılarını yayımlıyor (gpt-oss-120b/gpt-oss-20b için 30 RPM / 1K RPD / 8K TPM / 200K TPD), Together AI hiç sabit bir sayı belirlemiyor ve Fireworks AI ücretsiz erişimini bir kota yerine tek seferlik kredi bakiyesine bağlıyor. Sizinkiler farklıysa console.groq.com/settings/limits sayfasına bakın.
Hız limitleri API anahtarı başına mı yoksa hesap başına mı geçerli? Groq'ta limitler organizasyon düzeyinde geçerli, yani tek hesap altındaki birden fazla anahtar aynı havuzu paylaşıyor; bu, kendi rate-limits dokümantasyonunda belirtiliyor. Together AI ve Fireworks AI, incelediğimiz sayfalarda bunu açıkça belirtmiyor; aksini varsaymadan önce kendi panelinizde doğrulayın.
Bu sağlayıcılardan herhangi birinde hız limitine ulaştığımda ne olur? HTTP 429 yanıtı alırsınız. Ayrıntılar farklılık gösteriyor; çoğu OpenAI uyumlu API'nin döndürdüğü yeniden deneme başlıklarını nasıl okuyacağınızı ve tahmin yürütmek yerine nasıl geri çekilme mantığı kuracağınızı öğrenmek için hız limiti aşıldı kılavuzumuza bakın.
Her doküman sayfasını kendim okumaktan daha hızlı bir karşılaştırma yolu var mı? Kodlama ajanınıza, yukarıda anlatıldığı gibi üç ortama karşı tek bir Apidog CLI test senaryosu çalıştırtın. Apidog CLI ile geçirilen yirmi dakika, size gerçek iş yükünüz hakkında bu dahil herhangi bir karşılaştırma tablosundan daha fazlasını söyleyecektir.