
Qwen 3.8 27B'yi yerel olarak çalıştırmak için Ollama'yı kurun ve ollama pull qwen3.8:27b komutunu, ardından ollama run qwen3.8:27b komutunu çalıştırın. Varsayılan sürüm 18 GB'lık bir 4-bit indirmedir; bu nedenle 24 GB VRAM'li bir GPU ya da 32 GB birleşik bellekli bir Mac isteyeceksiniz. Ağırlıklar Apache-2.0 lisanslıdır, yani modelin kendisi ücretsizdir. Tek maliyetiniz donanım ve elektriktir.
Kısa versiyon bu. Bu kılavuzun geri kalanında kullanılmaya değer dört çalıştırıcıyı (Ollama, LM Studio, llama.cpp ve MLX), her kuantın ne kadar bellek gerektirdiğini, gerçek donanımda ne kadar hız beklemeniz gerektiğini ve yerel uç noktanız ayağa kalktıktan sonra kodlama ajanınızın Apidog CLI ile bunu nasıl test edeceğini ele alıyoruz.
Aileye yeni mi geldiniz? Qwen 3.8 nedir yazısı, 2,4 trilyon parametreli Max amiral gemisini ele alıyor. Bu kılavuz ise masaüstünüze sığan küçük, yoğun (dense) kardeşi hakkında.
Qwen 3.8 27B nedir?
Qwen 3.8 27B, Alibaba'nın Qwen ekibinin Ağustos 2026'da Apache-2.0 lisansıyla yayımladığı, 27 milyar parametreli yoğun bir görme-dil modelidir. Metin, görsel ve video okur, varsayılan olarak yanıt vermeden önce düşünür ve YaRN ölçeklemeyle 1 milyon tokena kadar genişleyebilen yerleşik 262.144 tokenlik bir bağlam penceresine sahiptir.
Resmi model kartı şu özellikleri listeliyor:
| Özellik | Qwen 3.8 27B |
|---|---|
| Parametreler | 27B yoğun (Hub, görme kodlayıcı dahil 28B listeliyor) |
| Katmanlar | Gated DeltaNet ve Gated Attention bloklarının hibriti olan 64 katman |
| Bağlam | 262.144 yerleşik, YaRN ile 1.000.000'a kadar |
| Girdiler | Metin, görsel, video |
| Düşünme | Varsayılan olarak açık, xhigh, medium veya low olarak reasoning_effort |
| Ekstralar | Çoklu token tahmini (MTP) katmanları |
| Lisans | Apache-2.0 |
Qwen'in kendi kıyaslama tablosunda SWE-bench Pro'da 61,7, Terminal Bench 2.1'de 73,0 ve GPQA Diamond'da 89,2 puan alıyor. Bunlar üretici rakamlarıdır. Qwen 3.8 kıyaslama dökümümüz, Qwen'in kendi içinde geliştirdiği satırlar da dahil olmak üzere bu tablonun nasıl okunacağını açıklıyor.
Yerelde neden önemli: 4-bit'te 27B'lik yoğun bir model, tek bir tüketici GPU'suna sığar; araç çağırma, görme yeteneği ve düşünme aynı dosyada gelir.
Qwen 3.8 27B için ne kadar RAM ve VRAM gerekir?
Kuantınızın dosya boyutu artı KV önbelleği ve çalışma zamanı için 3 ila 6 GB planlayın. Varsayılan Q4_K_M için bu, GPU'da 24 GB VRAM ya da 32 GB'lik bir Mac demektir.
9 Kasım 2026'da kontrol edilen, unsloth'un kuant deposundaki GGUF dosya boyutları şöyle:
| Kuant | Dosya boyutu | Gerçekçi donanım |
|---|---|---|
| UD-IQ2_XXS | 7,27 GB | 16 GB Mac veya 12 GB GPU, belirgin kalite kaybı |
| UD-Q3_K_XL | 13,1 GB | 16 GB GPU, 24 GB Mac |
| UD-Q4_K_M | 16,5 GB | 24 GB GPU, 32 GB Mac (tatlı nokta) |
| UD-Q5_K_M | 19,8 GB | Kısa bağlamla 24 GB GPU, 32 GB Mac |
| UD-Q6_K | 22 GB | 32 GB GPU, 48 GB Mac |
| Q8_0 | 29 GB | 48 GB GPU, 64 GB Mac |
Görsel girdi istiyorsanız görme projektörü (mmproj-F16.gguf) ek 928 MB ekler. Ollama'nın varsayılan qwen3.8:27b etiketi, görme özelliğini paketlediği için 18 GB'dır.
Bağlam uzunluğu gizli maliyettir. llm-speed'in planlama hesaplaması, Q4_K_M'in 32.000 tokenlik bağlamla yaklaşık 21,9 GB'a ulaştığını gösteriyor. Bu yüzden 24 GB'lik kartlar Q4 için pratik alt sınırdır ve bellek bol olmadıkça 262K penceresinin tamamını yüklememelisiniz.
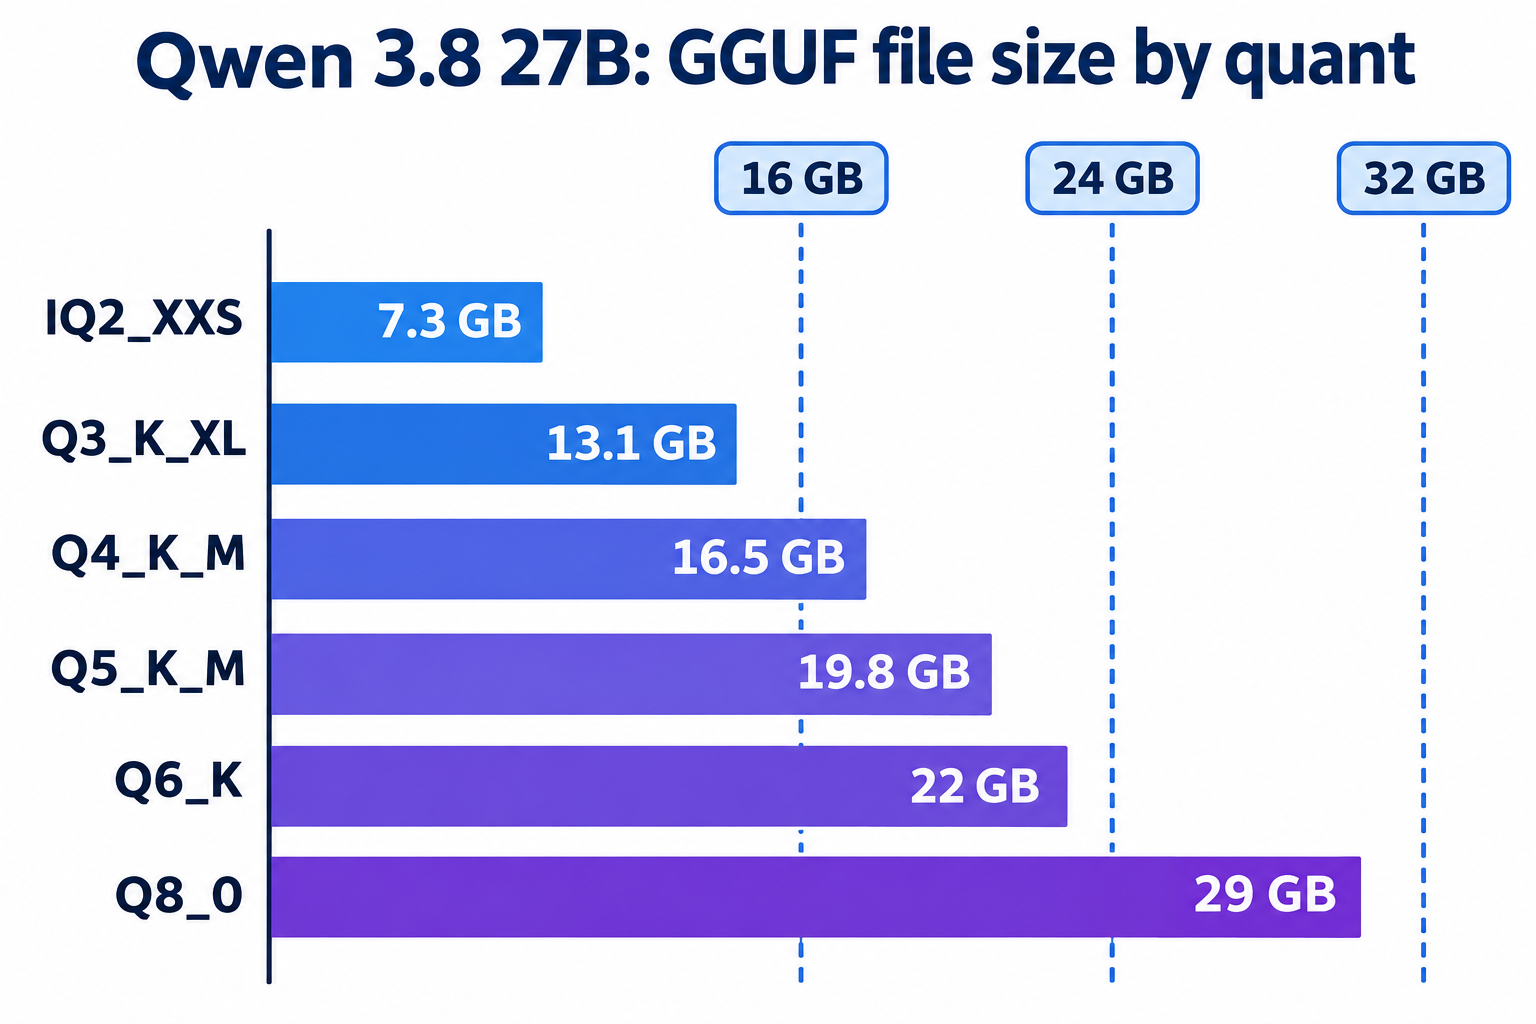
Mac'lerde macOS'un birleşik belleğin bir kısmını sistem için sakladığını unutmayın. 24 GB'lik bir Mac teknik olarak Q4_K_M'i yükleyebilir, ancak bağlam veya tarayıcınız için fazla yer kalmaz. Orada Q3_K_XL'i seçerdik.
Qwen 3.8 27B yerel olarak ne kadar hızlı çalışır?
RTX 3090 veya 4090 üzerinde Q4_K_M ile llama.cpp kullanırken saniyede yaklaşık 38 ila 44 token, RTX 5090'da ise 65 ila 75 token bekleyin. M3 Ultra'lı bir Mac Studio, saniyede yaklaşık 25 ila 27 token çözümler (decode).
Bu kıyaslamayı kendimiz yapmadık. Bunlar llm-speed tarafından yayımlanan, belirtilen donanım ve çalışma zamanıyla ölçülmüş çalışmalardır:
| Donanım | Kuant / çalışma zamanı | Decode tok/sn | Prefill tok/sn |
|---|---|---|---|
| RTX 3090 24 GB | Q4_K_M, llama.cpp | 38.6 (kısa sohbet, 4K bağlam) | 482 |
| RTX 4090 24 GB | Q4_K_M, llama.cpp | 43.4 (kısa sohbet, 4K bağlam) | 448 |
| RTX 5090 32 GB | Q4_K_M, llama.cpp | 75.2 (kısa sohbet, 4K bağlam) | 563 |
| L40S 45 GB | Q4_K_M, llama.cpp | 34.3 (kısa sohbet) | 569 |
| M3 Ultra 96 GB | Q4_K_M, llama.cpp | 25.2 (kısa sohbet) | 45 |
| M3 Ultra 96 GB | 4-bit, MLX 0.31.3 | 27.3 (kısa sohbet) | 12 |
GPU'larda çözümleme hızı bağlamla neredeyse düşmüyor: 4090, 33.133 tokenlik bir istemden sonra bile 39,0 tok/sn yaptı. Mac'lerin geride kaldığı nokta prefill'dir. 11.827 tokenlik bir istemde M3 Ultra yaklaşık 283 tok/sn işledi; 4090'da ise bu rakam kabaca 2.000 ila 3.000 arasında, yani büyük bir kod tabanı ilk token öncesinde düzinelerce saniye anlamına geliyor.
Düşünme de zaman bütçenizi yer. Simon Willison yerel bir Qwen 3.8 27B'den ham model ağırlıklarından oyun tanımasını istediğinde, tek bir yanıt 46 dakika ve 43.506 akıl yürütme tokeni aldı. Günlük görevler için reasoning_effort değerini low seviyesine indirin ya da düşünmeyi tamamen kapatın.
Qwen 3.8 27B'yi Ollama ile çalıştırma
Ollama, herhangi bir işletim sisteminde en hızlı yoldur. ollama.com adresinden kurun, ardından:
ollama pull qwen3.8:27b
ollama run qwen3.8:27b
Apple Silicon'da aynı 18 GB boyutunda MLX arka ucunu kullanan qwen3.8:27b-mlx etiketini deneyin.
Ollama'nın varsayılan bağlamı küçüktür; bu da uzun ajan oturumlarını bozar. Sunucuyu başlatmadan önce yükseltin:
OLLAMA_CONTEXT_LENGTH=32768 ollama serve
Ollama ayrıca http://localhost:11434/v1 adresinde OpenAI uyumlu bir API sunar; böylece temel URL'yi değiştirerek herhangi bir OpenAI SDK'sı çalışır:
curl http://localhost:11434/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model": "qwen3.8:27b",
       "messages": [{"role": "user", "content": "Write a Python function that validates an email address."}]}'
Bunu bir kodlama ajanının içinde mi istiyorsunuz? Ollama başlatma kısayollarıyla gelir: ollama launch claude --model qwen3.8 komutu Claude Code'u yerel modele karşı başlatır, ollama launch opencode --model qwen3.8 ise OpenCode için aynısını yapar.
LM Studio ile çalıştırma
Grafik arayüz ve modele özel yükleme ayarları istiyorsanız LM Studio tercih edilecek seçenektir. Qwen 3.8 27B'yi arayın, Q4_K_M (16,8 GB) olarak lmstudio-community/Qwen3.8-27B-GGUF sürümünü indirin ve yükleyin.
Tek bir ayar önemlidir: modeli yüklerken bağlam uzunluğunu yükseltin. Simon Willison, varsayılan 8.192 tokenlik bağlamın uzun isteminde hatalarla başarısız olduğunu gördü ve daha büyük bir pencere yüklemek zorunda kaldı.
Ardından Developer (Geliştirici) sekmesini açıp yerel sunucuyu başlatın veya bir terminalden lms server start komutunu çalıştırın. OpenAI uyumlu uç nokta http://localhost:1234/v1 adresinde bulunur.
llama.cpp ile çalıştırma
llama.cpp size en fazla kontrolü sunar ve yukarıdaki kıyaslama çalışmalarının çoğunu güçlendirir. macOS veya Linux'ta:
brew install llama.cpp

llama-server -hf unsloth/Qwen3.8-27B-GGUF:UD-Q4_K_M \
  --jinja -c 32768 -ngl 99 \
  --temp 1.0 --top-p 0.95 --top-k 20 \
  --port 8080
-hf kuantu doğrudan Hugging Face'ten indirir, --jinja modelin sohbet şablonunu uygular (araç çağrıları ve düşünme için gerekli), -c bağlamı ayarlar ve -ngl 99 tüm katmanları GPU'ya yerleştirir. Örnekleme değerleri, Qwen'in düşünme modu için önerileridir. Düşünme olmayan mod için model kartı sıcaklık 0,7, top_p 0,8, top_k 20 ve presence_penalty 1,5 önerir.
Tek bir istek için düşünmeyi kapatmak isterseniz gövdede "chat_template_kwargs": {"enable_thinking": false} gönderin.
Mac'te MLX ile çalıştırma
MLX, Apple'ın kendi dizi çerçevesidir ve Apple Silicon'da çözümleme (decode) için genellikle en hızlı çalışma zamanıdır. mlx-lm kurun ve mlx-community 4-bit dönüştürmesini kullanın:
pip install mlx-lm

mlx_lm.generate --model mlx-community/Qwen3.8-27B-4bit \
  --prompt "Explain the difference between a mutex and a semaphore." \
  --max-tokens 1024

mlx_lm.server --model mlx-community/Qwen3.8-27B-4bit --port 8080
mlx_lm.server, OpenAI uyumlu bir /v1/chat/completions rotası sunar. mlx-community organizasyonu, belleği kalite veya hızla takas etmek isterseniz 8-bit, mxfp4 ve MTP varyantlarını da yayımlıyor.
Kodlama ajanınızın yerel uç noktayı Apidog CLI ile test etmesini sağlama
Her çalıştırıcı aynı OpenAI uyumlu yapıyı sunar, ancak her biri düşünme bloklarını, araç çağrılarını ve zaman aşimlarını farklı işler. Bir uygulamayı localhost'a yönlendirmeden önce, kodlama ajanınızın Apidog CLI ile tekrarlanabilir bir test oluşturmasını sağlayın; böylece bozuk bir şablon veya bağlam sınırı, görevin ortasında değil saniyeler içinde ortaya çıkar.
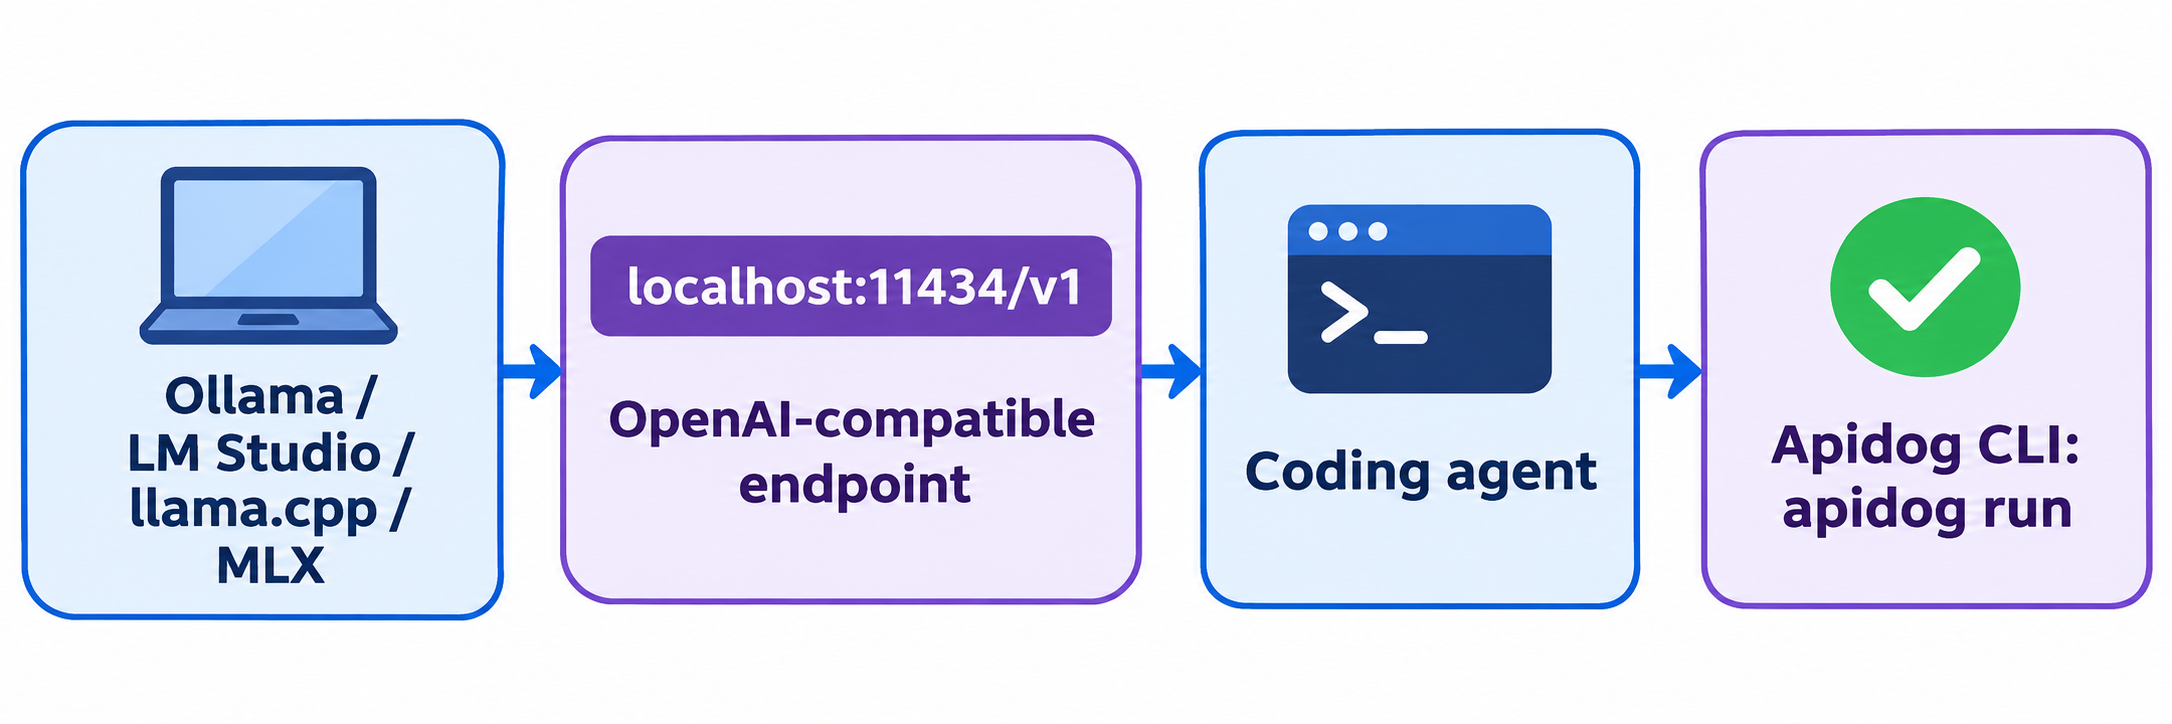
Tek seferde kurun:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ardından Claude Code, Codex veya Cursor'a tek bir istem verin:
In Apidog project <projectId>, create an environment "qwen-local" with base URL
http://localhost:11434/v1. Add a POST /chat/completions endpoint for model
qwen3.8:27b, then a test case that asserts status 200, a non-empty
choices[0].message.content, usage.completion_tokens > 0, and a second request
with a tools array that returns a tool_calls entry. Run it and summarize failures.
Ajan her yük şemasını okur, JSON'unu doğrular, kaynakları oluşturur ve test vakasını çalıştırır:
apidog environment create qwen-local --project <projectId> --base-url http://localhost:11434/v1
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 300000
Uzun --timeout-request değeri burada önemli: düşünme modundaki 27B'lik bir model bir Mac'te dakikalar alabilir. Temel URL'yi http://localhost:1234/v1 veya :8080/v1 olarak değiştirin; aynı test vakası LM Studio, llama.cpp veya MLX'i kontrol eder. Daha fazla ajan kurulumu için Claude Code'da Apidog CLI yazısına ve apidog run komut referansına bakın. Apidog'un Ücretsiz planı 4 kullanıcıya kadar kapsar.
Yerel mi, barındırılan Qwen 3.8 API'si mi?
Yerel çalıştırmak istemleri kendi makinenizde tutar, çevrimdışı çalışır ve token başına hiçbir maliyeti yoktur. Pazarlık ise hız ve ölçek üzerinedir: barındırılan bir uç nokta, çok daha büyük olan Qwen 3.8-Max'i 1M bağlam ve prefill beklemeden sunar. Amiral gemisine ihtiyacınız varsa Qwen 3.8 API kılavuzumuzu veya ücretsiz erişim yollarını okuyun. Her iki boyutta da ajanlı kodlama için kodlama için Qwen 3.8 yazısı çerçeve (harness) kurulumlarını karşılaştırır.
SSS
Qwen 3.8 27B yerel olarak ücretsiz mi çalışır? Evet. Ağırlıklar Hugging Face'te Apache-2.0 lisanslıdır ve Ollama, LM Studio, llama.cpp ile MLX ücretsizdir. Yalnızca donanım ve elektrik için ödeme yaparsınız.
Qwen 3.8 27B'yi 16 GB'lik bir Mac'te çalıştırabilir miyim? Yalnızca UD-IQ2_XXS (7,27 GB) gibi 2-bit kuantlarla ve kısa bağlamla çalışır; kalitede belirgin düşüş olur. Q4_K_M çalıştıran 32 GB'lik bir Mac, rahat kurulumdur.
Qwen 3.8 27B bir RTX 3090'da çalışır mı? Evet. Q4_K_M, 16K ila 32K bağlam için yer kalacak şekilde 24 GB'a sığar ve llm-speed, llama.cpp üzerinde saniyede yaklaşık 38 token ölçtü.
Düşünme modunu nasıl kapatırım? llama.cpp veya vLLM'de "chat_template_kwargs": {"enable_thinking": false} gönderin ya da reasoning_effort değerini low seviyesine indirin. Qwen, düşünme olmayan mod için sıcaklık 0,7 ve top_p 0,8 önerir.
Yerel model görselleri destekliyor mu? Evet. Ollama'nın 18 GB'lik etiketi görme özelliğini içerir. llama.cpp ile modelin yanında mmproj-F16.gguf dosyasını da indirin.
Qwen 3.8 27B ile Qwen 3.8-Max arasındaki fark nedir? Max, Alibaba'nın API'si üzerinden sunulan 2,4 trilyon parametreli bir uzman karışımı (mixture-of-experts) amiral gemisidir. 27B ise tek bir GPU'ya veya 32 GB'lik bir Mac'e sığacak kadar küçük yoğun bir modeldir.