
NVIDIA’nın yeni Nemotron 3.5 Transcribe’ını tek bir GPU’da çalıştırabilir ve saatler süren kayıtları 40 dilde dakika başı ödeme yapmadan veya sesi kimseye göndermeden yazıya dökebilirsiniz. Hugging Face Open ASR Leaderboard’daki en iyi açık ağırlıklı modeldir, ticari kullanıma uygun OpenMDW-1.1 lisansı altında sunulur ve NVIDIA, çıkış günü olan 28 Ekim 2026’da BF16, FP8 ve NVFP4 ağırlıklarını yayınladı.
Bu kılavuz, ihtiyacınız olan donanımı, onu çalıştırmanın üç yolunu (vLLM, SGLang-Omni ve Transformers), resmi model kartındaki tam komutları ve insanların takıldığı ayarları kapsar. Tüm komutlar 29 Ekim 2026’da karttan kopyalanmıştır.
Modele yeni misiniz? ücretsiz kılavuzumuz ne yaptığını ve nasıl sıralandığını açıklar. GPU’nuz yok mu? barındırılan API dakika başına 0,002 $ tutar.
Neden yerel olarak çalıştırmalısınız?
- Dakika başına fatura yok. DeepInfra’nın dakika başına 0,002 $ ücretiyle 10.000 saat 1.200 $ tutar. Kendi GPU’nuzda ise yalnızca elektrik maliyeti olur.
- Gizlilik. Müşteri aramaları, tıbbi dikte ve hukuki kayıtlar ağınızdan asla ayrılmaz.
- Tam özellik seti. vLLM yolu kelime zaman damgalarını, konuşmacı ayrıştırmayı, çeviriyi ve bağlam istemlerini destekler. Bazı barındırılan uç noktalar bunun yalnızca bir kısmını sunar.
- İnce ayar. NVIDIA’nın lansman yazısı, tıbbi bir ince ayarın WER’i %30,8’den %11,8’e düşürdüğünü gösteriyor. Bunu yalnızca ağırlıklarla yapabilirsiniz.
Donanım: onu ne çalıştırır
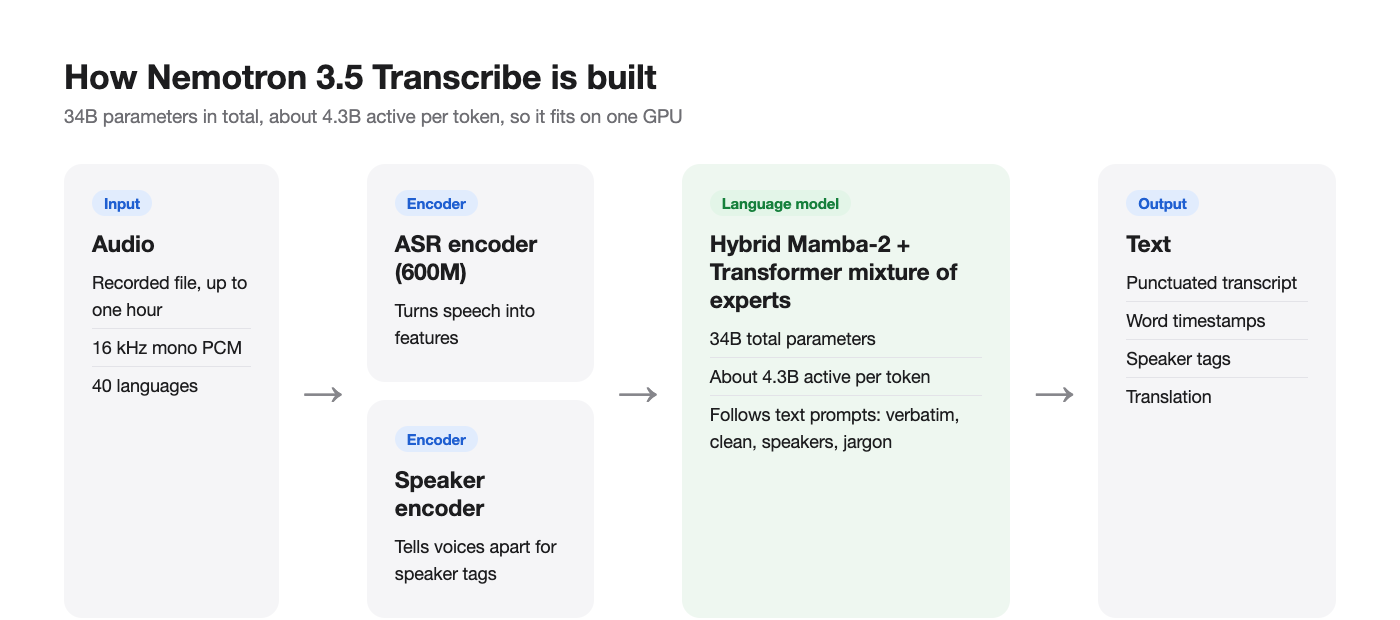
Modelin toplamda 34B parametresi ve yaklaşık 4,3B aktif parametresi vardır, bu nedenle token başına hesaplama küçük olsa da ağırlıklar büyüktür. NVIDIA’nın referans hedefi BF16’da bir H100 80 GB'dır. Model kartındaki uyumluluk tablosu:
| GPU | Hassasiyetler | Çalışma Zamanları |
|---|---|---|
| H100, H200 | BF16, FP8 | vLLM 0.32.0, Transformers, SGLang-Omni 0.2.0 (H100) |
| A100 80 GB | BF16 | vLLM 0.32.0, Transformers |
| L40S 48 GB | FP8 | vLLM 0.32.0, Transformers |
| B200, GB200, GB300 DGX Station | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| DGX Spark (GB10), Jetson Thor | BF16, FP8, NVFP4 | vLLM 0.32.0, Transformers |
| RTX PRO 6000 Blackwell Server | BF16, FP8, NVFP4 | vLLM, Transformers, SGLang-Omni, GGML |
| RTX 5090 (32 GB) | yalnızca NVFP4 | vLLM 0.32.0, Transformers, GGML |
Kartınıza uygun kontrol noktasını seçin:
nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B(BF16)nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-FP8nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B-NVFP4
RTX 4090 gibi 24 GB'lık bir kart listede yok ve Apple Silicon desteklenmiyor. İşletim sistemleri Linux veya WSL2 üzerinden Windows'tur. GGML yerel Windows'ta da çalışır, ancak NVIDIA'nın lansman yazısı NeMo-Speech.cpp yerel derlemesinin hâlâ "yakında" olduğunu söylüyor.
Seçenek 1: vLLM sunucusu (önerilir)
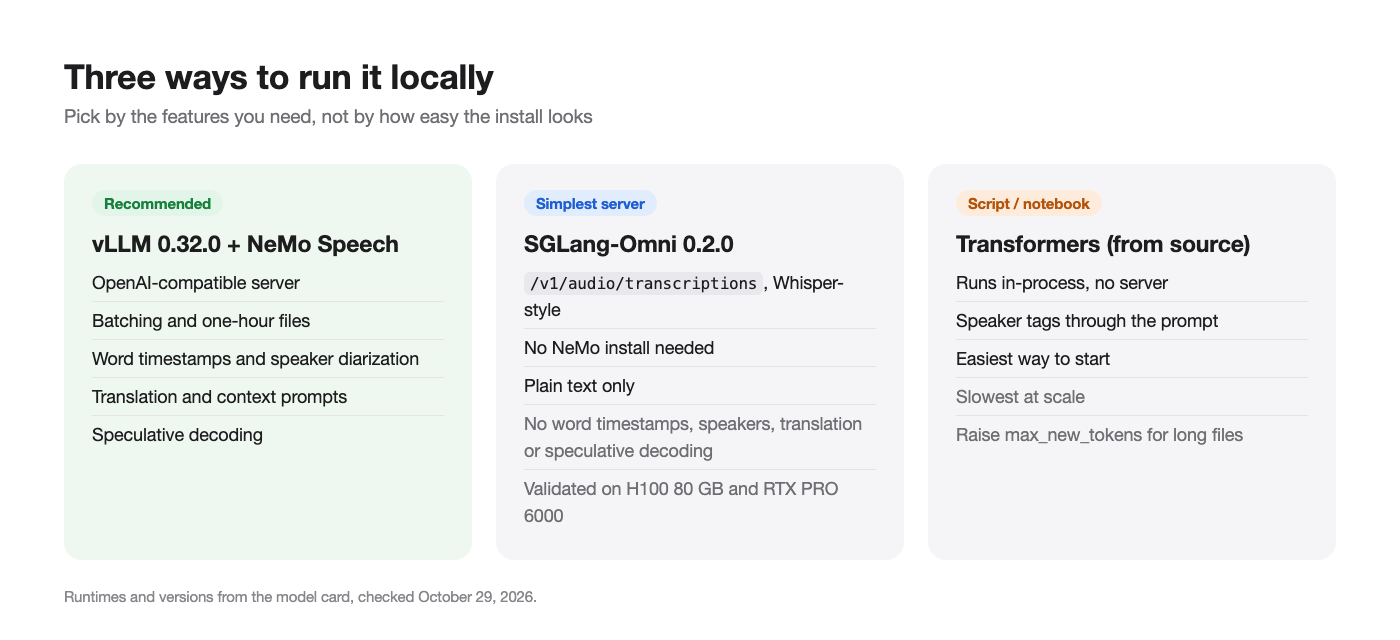
vLLM size toplu işleme, bir saatlik dosyalar, spekülatif kod çözme ve kelime zaman damgalarıyla OpenAI uyumlu bir uç nokta sunar. Modelin vLLM eklentisini sağlayan vLLM 0.32.0 ile en son NeMo Speech ana dalına ihtiyaç duyar.
Kurulum
Kart, uv ve Python 3.13 kullanır:
git clone https://github.com/NVIDIA-NeMo/Speech.git nemo-speech
cd nemo-speech
uv venv --python 3.13 .venv
UV_PROJECT_ENVIRONMENT=$PWD/.venv uv sync --extra asr --extra vllm --locked --no-install-project
uv pip install --python .venv/bin/python --no-deps -e .
uv pip install --python .venv/bin/python --no-deps av==19.0.2
uv pip install --python .venv/bin/python --no-deps opencv-python-headless==5.0.0.93
source .venv/bin/activate
hf download nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B --local-dir ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
PyAV (av), sistem FFmpeg'i olmadan M4A ve diğer sıkıştırılmış biçimlerin kodunu çözmesini sağlar. OpenCV, vLLM ona ihtiyaç duyduğu ve NeMo'nun bağımlılık ayarları onu dışarıda bıraktığı için oradadır.
Sunucuyu başlatın
export VLLM_PLUGINS=nemo_speechlm
export VLLM_MAX_AUDIO_DECODE_DURATION_S=3600
export VLLM_MAX_AUDIO_CLIP_FILESIZE_MB=180
export VLLM_USE_V2_MODEL_RUNNER=0
vllm serve ./NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --served-model-name nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --trust-remote-code --dtype bfloat16 --gpu-memory-utilization 0.94 \
  --max-model-len 65536 --max-num-batched-tokens 4096 --max-num-seqs 192 \
  --enable-chunked-prefill --no-enable-prefix-caching \
  --use-replayssm --mamba-backend flashinfer --mamba-cache-mode none \
  --mm-processor-cache-gb 0 --no-async-scheduling \
  --limit-mm-per-prompt '{"audio":{"count":6,"length":120000000}}' \
  --speculative-config '{"method":"mtp","num_speculative_tokens":8}' \
  --reasoning-parser nemotron_v3 \
  --trust-request-mm-kwargs \
  --middleware nemo.collections.speechlm2.vllm.salm.ctc_serving.ctc_timestamp_middleware
Anlaşılması gereken bayraklar:
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600vLLM'in ses sınırını 600 saniyeden bir saate yükseltir. Bunu unutursanız uzun dosyalar başarısız olur.VLLM_USE_V2_MODEL_RUNNER=0kelime zaman damgalarının ihtiyaç duyduğu V1 çalıştırıcısını korur.--speculative-configsekiz taslak token ile çoklu token tahminini (MTP8) etkinleştirir. NVIDIA, bir H100'de MTP8 ile 270 ve MTP2 ile 410 toplu İngilizce RTFx ölçtü; bu nedenle gecikmeden çok aktarım hızını önemsiyorsanız"num_speculative_tokens":2deneyin.--middleware ... ctc_timestamp_middlewareve--trust-request-mm-kwargs, isteklerin kelime zaman damgası istemesini sağlar.- Ayarlar 80 GB'lık bir H100'ü hedefler. Diğer kartlarda
--gpu-memory-utilization,--max-model-lenveya--max-num-seqsdeğerlerini düşürün.
Sunucu 127.0.0.1:8000 adresini dinler. Ağınızdaki diğer makinelerden erişmek için --host 0.0.0.0 ekleyin.
Dosya gönderin
import base64
from openai import OpenAI

client = OpenAI(base_url="http://127.0.0.1:8000/v1", api_key="EMPTY")
audio = base64.b64encode(open("standup.wav", "rb").read()).decode()

response = client.chat.completions.create(
    model="nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B",
    messages=[{"role": "user", "content": [
        {"type": "text", "text": "Transcribe the following audio."},
        {"type": "audio_url", "audio_url": {"url": f"data:audio/wav;base64,{audio}"}},
    ]}],
    temperature=0,
    extra_body={"chat_template_kwargs": {"enable_thinking": False}, "skip_special_tokens": False},
)
print(response.choices[0].message.content)
Metin talimatını herhangi bir görev istemiyle değiştirin. Birkaç sesin olduğu bir toplantı için:
Transcribe verbatim, including fillers. Write numbers as spoken, without punctuation or capitalization. Start every speaker turn with <spk:0>, <spk:1>, etc. Keep one stable tag per speaker. Output only the speaker-tagged transcript.
Kelime zaman damgası isteklerinin kuralları vardır: istek başına bir kayıt, stream=false ve n=1. Yanıt daha sonra kelimeleri, saniye cinsinden başlangıç ve bitiş zamanlarını ve konuşmacı etiketlerini içeren bir ctc_timestamps nesnesi içerir.
Seçenek 2: Düz transkripsiyon için SGLang-Omni
Yalnızca tüm dosyalardan metin çıkarmanız gerekiyorsa, SGLang-Omni 0.2.0 daha basittir ve NeMo'ya ihtiyaç duymaz. BF16 veya FP8 kontrol noktasıyla bir H100 80 GB ve bir RTX PRO 6000 Blackwell üzerinde doğrulanmıştır.
sgl-omni serve \
  --model-path nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B \
  --model-name nemotron-transcribe \
  --mem-fraction-static 0.85 \
  --port 8000

curl http://localhost:8000/v1/audio/transcriptions \
  -F model=nemotron-transcribe \
  -F file=@audio.wav
Bu /v1/audio/transcriptions rotası, OpenAI'nın Whisper API'sinin kullandığı şekille eşleşir, bu nedenle mevcut Whisper istemci kodu genellikle yalnızca yeni bir temel URL'ye ihtiyaç duyar. Ödünleşim: bu entegrasyonda kelime zaman damgaları, konuşmacı etiketleri, çeviri veya spekülatif kod çözme yoktur.
Seçenek 3: Bir betikte Transformers
Not defterleri ve tek seferlik işler için, kaynaktan yüklenen Hugging Face Transformers ile süreç içinde çalıştırın:
pip install git+https://github.com/huggingface/transformers
from transformers import AutoModelForMultimodalLM, AutoProcessor

model_id = "nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B"
processor = AutoProcessor.from_pretrained(model_id)
model = AutoModelForMultimodalLM.from_pretrained(model_id, device_map="auto")

prompt = ("Transcribe this audio with punctuation and capitalization. Include all spoken words "
          "and verbal fillers. Put speaker tags <spk:0> <spk:1> <spk:2> <spk:3> on the transcription.")
inputs = processor.apply_transcription_request(["podcast.mp3"], prompt=[prompt]).to(model.device)
outputs = model.generate(**inputs, max_new_tokens=4096)
print(processor.decode(outputs[:, inputs.input_ids.shape[1]:], skip_special_tokens=False))
Başlamanın en kolay ve ölçekte çalıştırmanın en yavaş yoludur. Uzun dosyalar için max_new_tokens değerini artırın: yoğun bir saat yaklaşık 20.000 token üretebilir.
Kendi GPU'nuzda ne kadar hızlı?
NVIDIA'nın manşet rakamı, NVFP4 ağırlıkları ve DFlash2 spekülatif kod çözme ile bir RTX PRO 6000 Blackwell üzerinde saniyede 2.238 saniye sestir ve 30 saniyelik bir klibi döndürmek 0,13 saniye sürer. Dipnotu okuyun: bu rakamlar, sunum değişiklikleri henüz açık kaynak olmayan optimize edilmiş NIM'den gelir. Kart, açık vLLM entegrasyonunun yaklaşık iki kat daha yavaş olmasının beklendiğini söylüyor.
H100'de BF16'da toplu İngilizce transkripsiyon için kart şu RTFx sayılarını listeler (hesaplama saniyesi başına ses saniyesi):
| Spekülatif kod çözme | RTFx |
|---|---|
| MTP2 | 410 |
| DFlash2, K=7 | 340 |
| MTP8 | 270 |
| DFlash2, K=15 | 260 |
En yavaş satır bile toplu işte 15 saniyenin altında GPU süresinde bir saatlik sesi işler. DFlash2 taslak modelini istiyorsanız, vLLM 0.32.0'ın karttan küçük bir yamaya ihtiyaç duyduğunu, DFlash2'nin kelime zaman damgalarını devre dışı bıraktığını ve bunu MTP ile birleştirmemeniz gerektiğini unutmayın.
Yaygın sorunlar ve çözümleri
- Uzun dosyalar 10 dakikada kesiliyor.
VLLM_MAX_AUDIO_DECODE_DURATION_S=3600ayarını atladınız. - Yanıtta zaman damgası yok.
VLLM_USE_V2_MODEL_RUNNER=0,--middlewarebayrağını ve isteğinstream=falseile tek kayıt içerdiğini kontrol edin. - Daha küçük kartlarda bellek yetersiz. FP8 veya NVFP4 kontrol noktasına geçin ve
--max-num-seqsdeğerini düşürün. - Transkriptin sonunda tekrarlanan ifadeler. Kart, nihai çıktılar için bir üretim döngüsü koruması önerir.
max_tokensdeğerini sınırlayın ve tekrarları kırpın. - Adların yanlış yazımı. İsteme
Context terms: <names>ekleyin. - Transkriptte arka plan sesleri. Karttan deneysel yakın alan istemini deneyin; bu, NVIDIA'nın testinde karışık seste WER'i %27,32'den %4,78'e düşürdü.
vLLM'e yeniyseniz, vLLM açıklayıcımız istekleri nasıl toplu işlediğini ve GPU belleğini nasıl yönettiğini anlatır.
Kodlama aracınızın yerel sunucuyu Apidog CLI ile test etmesine izin verin
Yerel bir model ancak uç noktası vLLM yükseltmeleri, istem ayarlamaları ve kontrol noktası değişimleri boyunca doğru kaldığı sürece kullanışlıdır. Kodlama aracınızın bunu Apidog CLI ile üstlenmesine izin verin ve aynı makineden http://127.0.0.1:8000 adresine karşı kontroller çalıştırın.
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ardından aracınıza bir istem verin:
In Apidog project <id>, add POST {{baseUrl}}/v1/chat/completions for my local
Nemotron 3.5 Transcribe server. Create test cases that send samples/en.wav and
samples/two-speakers.wav as base64 audio_url content with temperature 0, and assert
status 200, a non-empty choices[0].message.content, and at least two distinct <spk:N>
tags for the two-speaker file. Run them against the local environment and report failures.
Aracı şemayı okur, yükünü doğrular, vakaları yazar ve çalıştırır:
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <id> --file case.json
apidog run --test-case <caseId> --project <id> -e <envId> -r cli,json
Her sunucu yükseltmesinden sonra çalıştırın veya CI/CD iş akışında Apidog CLI bölümünde gösterildiği gibi apidog run ... -r junit komutunu CI'ya bağlayın. Aracı kurulumu için Claude Code'da Apidog CLI bölümüne bakın.
SSS
Nemotron 3.5 Transcribe'ı RTX 4090'da çalıştırabilir miyim? NVIDIA'nın uyumluluk listesinde yok. Listelenen en küçük tüketici kartı, NVFP4 kontrol noktasına sahip RTX 5090'dır.
Mac'te çalışır mı? 29 Ekim 2026 itibarıyla hiçbir resmi çalışma zamanı Apple Silicon'ı desteklemiyor.
Ticari ürünler için yerel kullanım ücretsiz mi? OpenMDW-1.1 lisansı ticari ve ticari olmayan kullanıma izin verir. Gönderim yapmadan önce atıf koşulları için lisans metnini okuyun.
Canlı sesi yazıya dökebilir mi? Hayır. Kaydedilmiş dosyalar için çevrimdışı bir modeldir. NVIDIA, canlı kullanım için ayrı bir Nemotron 3.5 ASR Streaming modeli sunar.
Hangisi daha hızlı, vLLM mi yoksa SGLang-Omni mi? NVIDIA baş başa bir karşılaştırma yayınlamıyor. Zaman damgalarına, konuşmacılara veya çeviriye ihtiyacınız olduğunda vLLM'i, en basit yalnızca metin sunucusu için SGLang-Omni'yi kullanın.
Diğer yerel modellere karşı sıralaması nasıl? 28 Ekim Open ASR Leaderboard'da her açık ağırlıklı modelin önünde. en iyi açık kaynak konuşmadan metne modelleri listemiz onu Qwen3-ASR, Granite Speech, Canary-Qwen, Voxtral ve Whisper ile karşılaştırır.
Çalıştırın
GPU'nuza uyan kontrol noktasını indirin, vLLM'i bir saatlik ses sınırı ve zaman damgası ara katmanıyla başlatın ve OpenAI istemcisi aracılığıyla bir WAV dosyası gönderin. Ardından aracınızın yerel uç noktaya karşı Apidog kontrolleri çalıştırmasına izin verin, böylece her yükseltme, gerçek kayıtlarla güvenmeden önce hâlâ yazıya döktüğünü kanıtlasın.