
ERNIE 5.5 Flash'ı yerel olarak çalıştırmak için vLLM 0.32.0 ve Baidu'nun vLLM-ERNIE eklentisini kurun, ardından çoklu GPU'lu bir düğümde veri ve uzman paralelliği ile vllm serve baidu/ERNIE-5.5-Flash-Base komutunu çalıştırın. Sonuçta 8000 numaralı bağlantı noktasında OpenAI uyumlu bir sunucu elde edersiniz. Püf noktası şu: Şu anda açık ağırlıklar, metni devam ettiren bir ön eğitim kontrol noktası olan Base modeli; sohbet modeli değil.
Aşağıda: neleri indirebileceğiniz, Baidu'nun listelediği donanım, tam serve komutları ve uç noktayı nasıl test edeceğiniz. Aşağıdaki her komut ve sayı, 12 Kasım 2026'da kontrol edilen Baidu'nun Hugging Face model kartından ve vLLM-ERNIE deposundan alınmıştır.
Modele yeni mi geldiniz? ERNIE 5.5 Flash'ın ne olduğuna göz atın. GPU kümesi olmadan sohbet modelini istiyorsanız, ERNIE 5.5 Flash API rehberi daha hızlı bir yol sunar.
Bugün yerel olarak neyi çalıştırabilirsiniz?
Hugging Face'te FP8 ve BF16 olarak yayınlanan ERNIE 5.5 Flash Base'i çalıştırabilirsiniz. Bu, token başına 14B aktif parametreye sahip, 33.5T token üzerinde eğitilmiş 280B parametreli seyrek bir uzman karışımı (mixture-of-experts) modelidir. Sohbet için ince ayarlanmış ERNIE 5.5 Flash Preview ise şu an için yalnızca API üzerinden erişilebilir; Baidu, ağırlıklarının Apache 2.0 lisansıyla "yakında" geleceğini söylüyor.
Kendi kendine barındırma açısından iki sürümün karşılaştırması şöyle:
| ERNIE 5.5 Flash Base | ERNIE 5.5 Flash Preview | |
|---|---|---|
| Nedir | Ön eğitimin sonundaki kontrol noktası | İlk eğitim sonrası (sohbet, akıl yürütme, ajan) işlenmiş model |
| Ağırlıklar | Hugging Face ve ModelScope, FP8 ve BF16 | 12 Kasım 2026 itibarıyla yayınlanmadı |
| Çağırdığınız uç nokta | /v1/completions (metin devam ettirme) |
Akıl yürütme ve araç destekli sohbet tamamlamaları |
| Lisans | ERNIE 5.5 Flash Base Model Lisansı v1.0 | Yayınlandığında Apache 2.0 vaat edildi |
| Şu anda nerede kullanılır | Kendi GPU'larınız | Qianfan API, OpenRouter |
Şu anda Baidu'nun ERNIE-5.5-Flash koleksiyonunda yalnızca iki Base kontrol noktası bulunuyor ve vLLM-ERNIE README dosyası sohbet modelini "Coming soon" (yakında) olarak işaretliyor. Preview sürüm duyurusu bir tarih vermiyor.
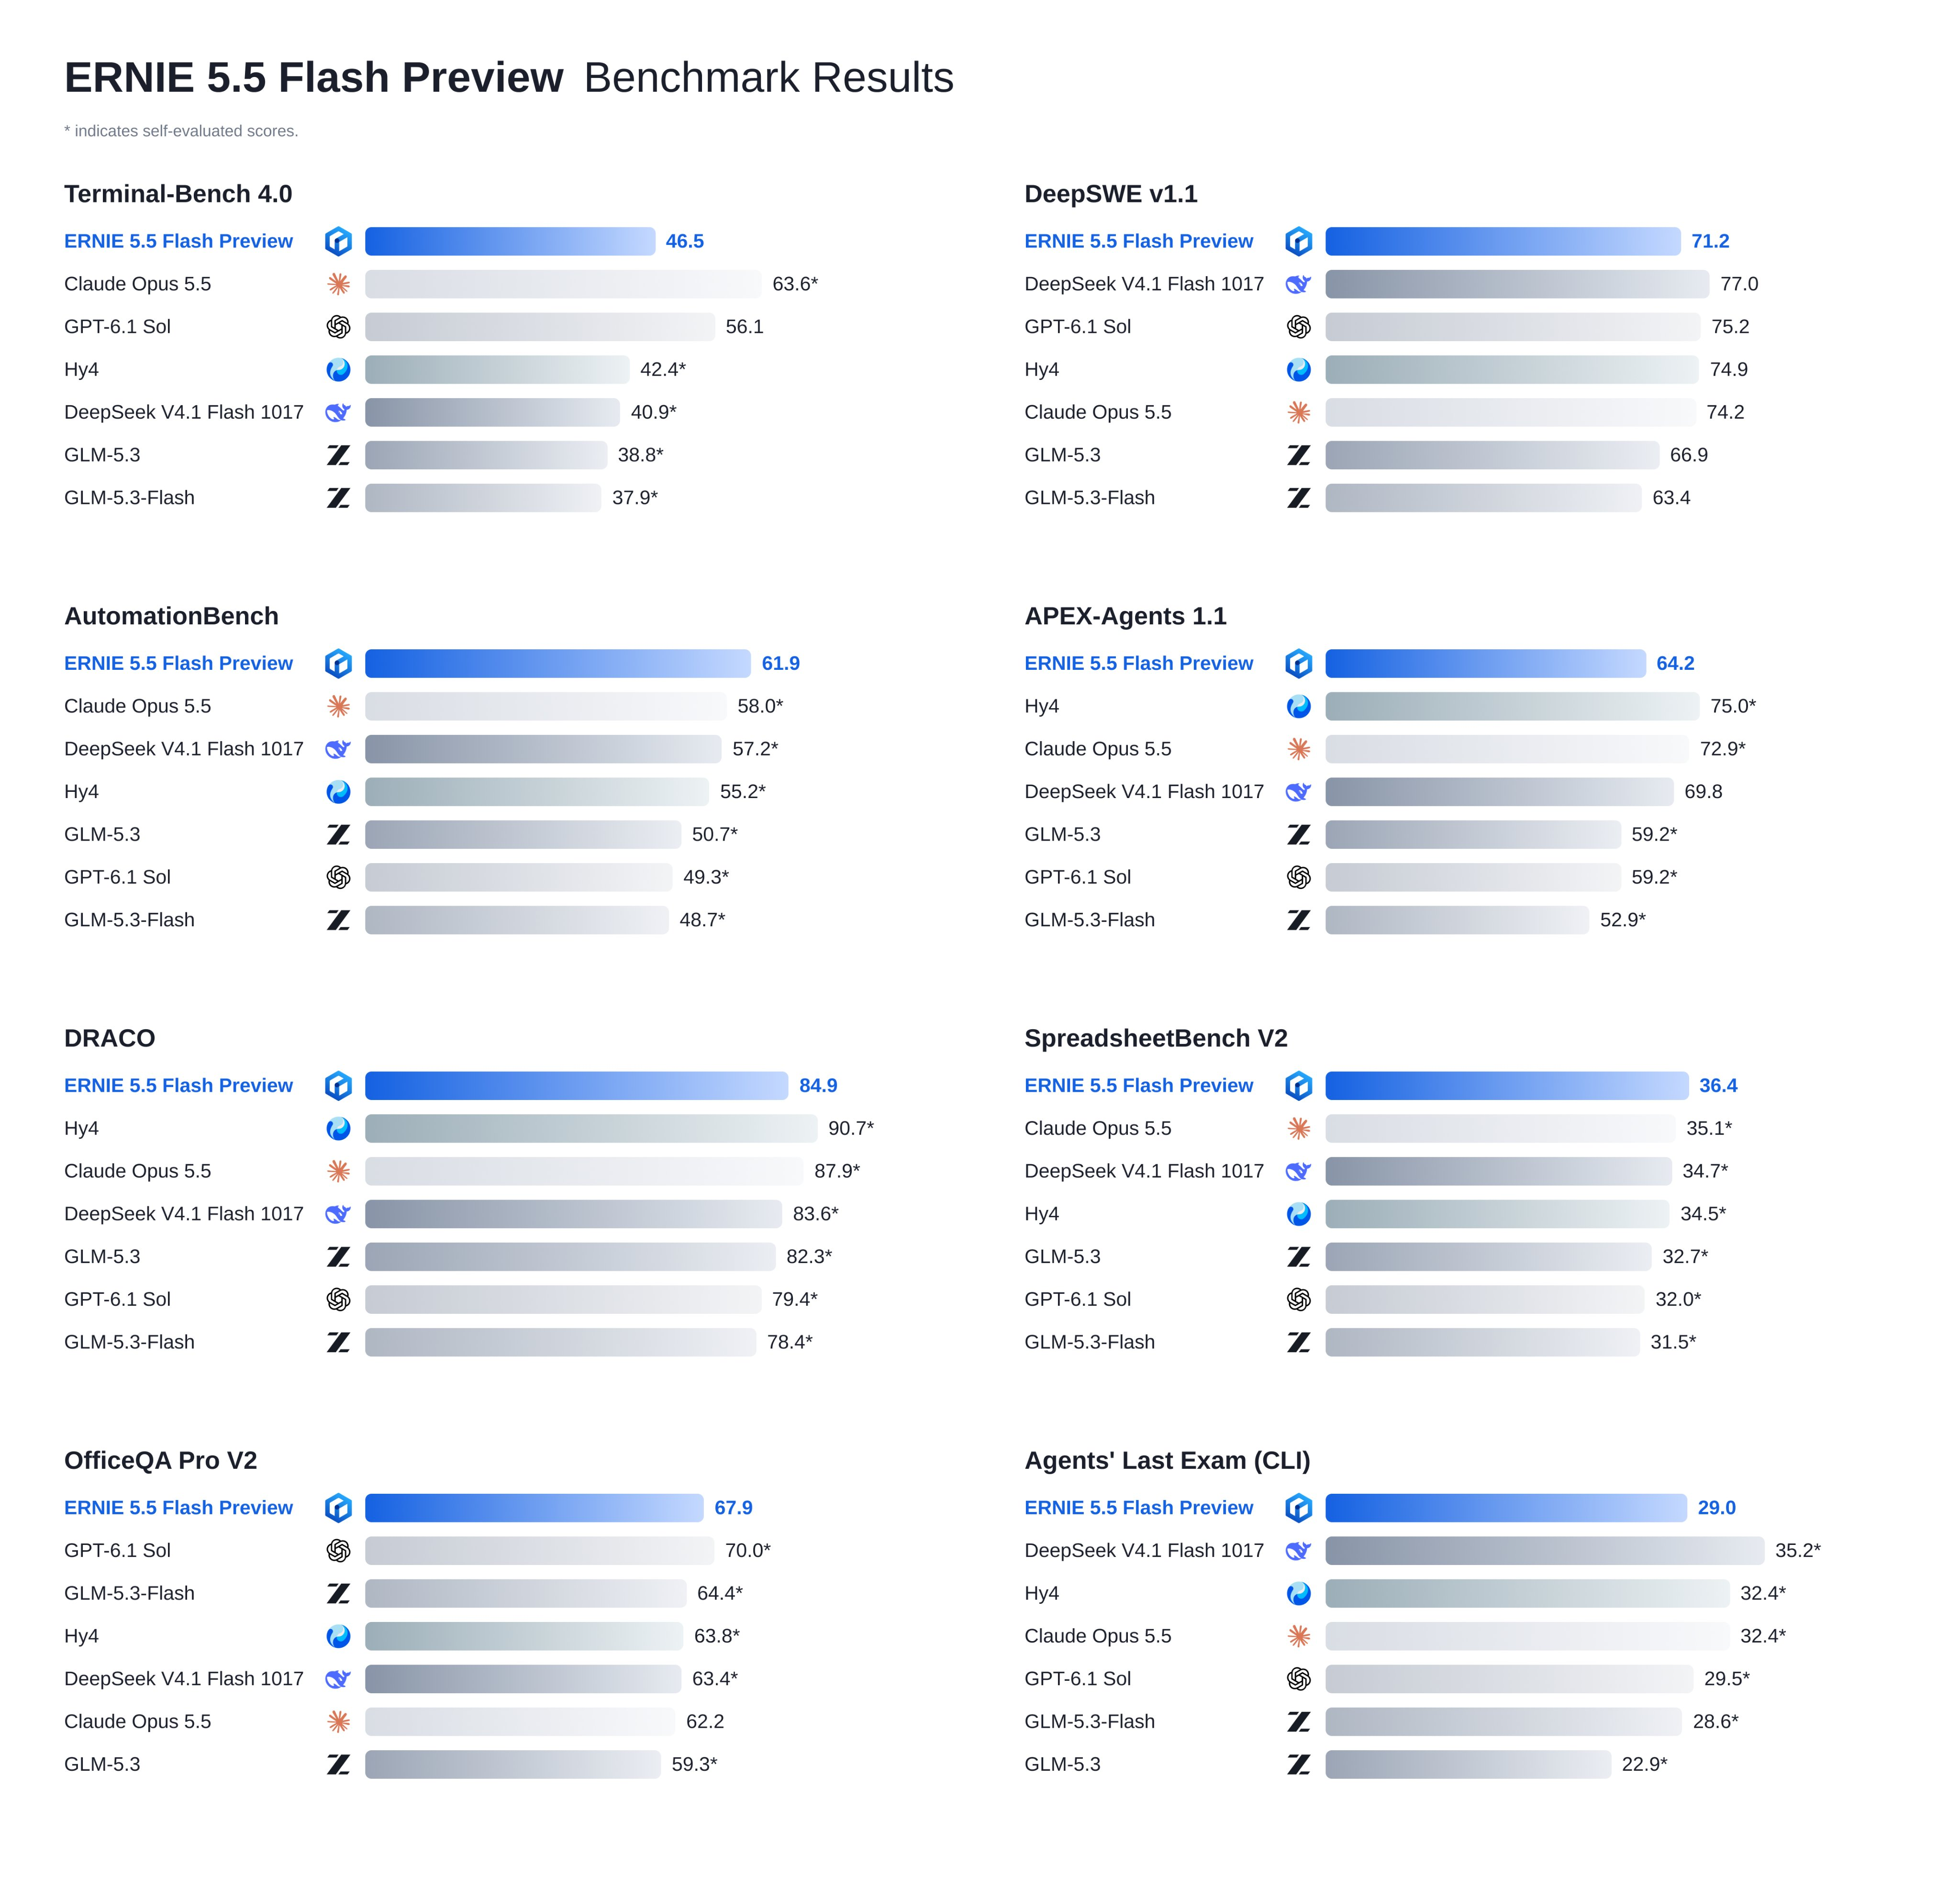
Bugün bir kodlama asistanı istiyorsanız, yerel bir Base model size bunu sağlamaz. İnce ayar veya few-shot araştırması için bir başlangıç noktası istiyorsanız, Base zaten Baidu'nun bu amaçla geliştirdiği modeldir.
ERNIE 5.5 Flash donanım gereksinimleri
FP8 ağırlıkları yaklaşık 280 GB, BF16 ağırlıkları ise yaklaşık 560 GB GPU belleği kaplar; dolayısıyla bu, dizüstü bilgisayarda değil, çoklu GPU'lu bir sunucuda yapılacak bir iştir. vLLM-ERNIE README dosyası, ağırlıkları barındırabilecek en düşük GPU sayılarını listeler ve eklenti yalnızca NVIDIA GPU'larda çalışır.
| Kart başına GPU belleği | FP8 (~280 GB ağırlık) | BF16 (~560 GB ağırlık) |
|---|---|---|
| 288 GB | 2 GPU | 4 GPU |
| 192 GB | 4 GPU | 8 GPU (veya 2 düğüm x 4 GPU) |
| 80 GB | 8 GPU | 2 düğüm x 8 GPU |
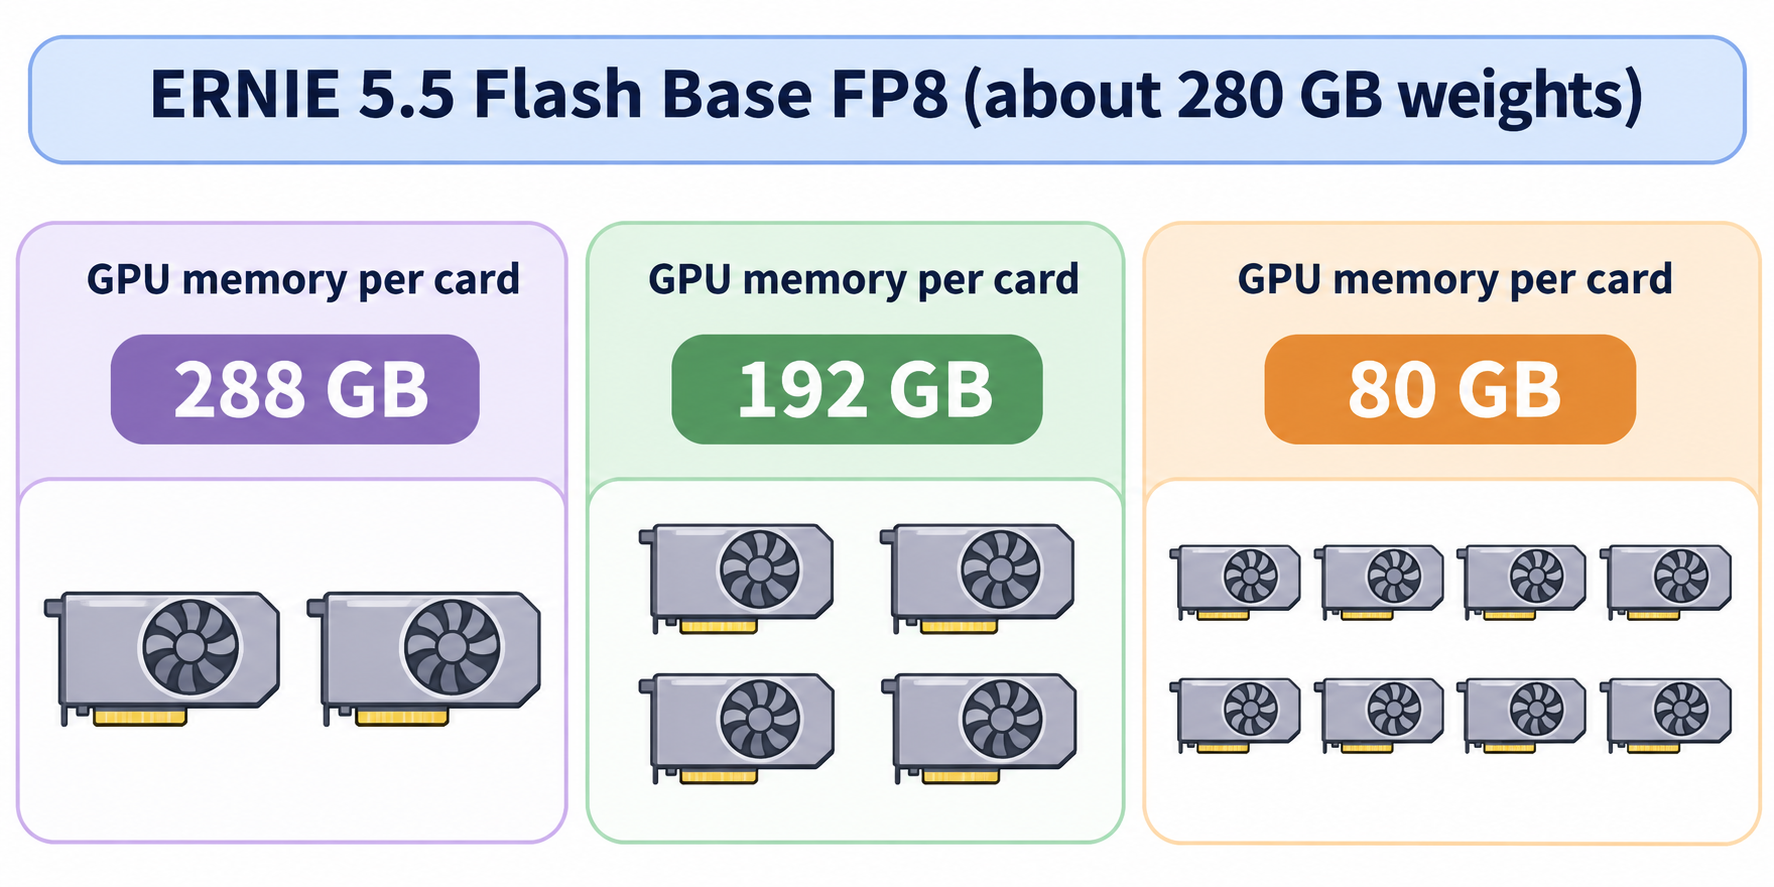
Bunlar, ağırlıkları yüklemek için gereken minimum değerlerdir. KV önbelleğinin de üstüne yer ihtiyacı vardır; bu yüzden sunabileceğiniz bağlam uzunluğu kartlarınıza bağlıdır:
- 80 GB GPU'lar: 8 GPU'da
--data-parallel-size 8ve--gpu-memory-utilization 0.93ile FP8 sunun. 262.144 tokene kadar sığar; 1M sığmaz. - 1M token bağlam: Baidu'nun değerleri 184 GiB bellekli GPU'lar içindir; 1M tokenlik bir prefill, onlarca GB geçici bellek gerektirdiğinden kullanım oranı 0.85'e düşürülmüştür.
- Mimari önemlidir: FP8 komutları, Blackwell GPU'larda FP8 ağırlıklarla modelin SiTU aktivasyonunu destekleyen
--moe-backend hummingbayrağını geçirir. Hopper GPU'larda bu bayrağı kaldırın ve vLLM'in varsayılan MoE çekirdeğini kullanın.
"Yerel" ifadesi, kontrol ettiğiniz donanım anlamına gelir: kiralık bir 8 GPU'lu düğüm, kurumsal bir sunucu veya bir laboratuvar kümesi.
vLLM ve ERNIE eklentisini kurma
vLLM, ERNIE 5.5 mimarisini (Ernie5_5_MoeForCausalLM) kutudan çıktığı gibi desteklemez. Baidu bunu, değiştirilmeden yayınlanmış vLLM 0.32.0 wheel'i üzerinde çalışan bir eklenti olarak sunar. Bir Python 3.12 ortamı oluşturun ve ikisini de kurun:
uv venv --python 3.12
source .venv/bin/activate
uv pip install vllm==0.32.0
uv pip install git+https://github.com/baidu/vLLM-ERNIE.git
Eklenti, her vLLM işleminde vLLM'in vllm.general_plugins giriş noktası üzerinden yüklenir. vllm serve daha sonra Model architectures ['Ernie5_5_MoeForCausalLM'] are not supported derse, eklenti vllm komutunun çalıştığı ortamda kurulu değildir ya da VLLM_PLUGINS ayarlanmıştır ama içinde ernie yoktur.
Ağırlıkları Hugging Face yerine ModelScope'tan çekmek için VLLM_USE_MODELSCOPE=True ayarlayın. Depo adları her iki hub'da da aynıdır. vLLM'e yeni geliyorsanız, vLLM genel bakışımız sunucuyu ve OpenAI uyumlu API'sini açıklar.
ERNIE 5.5 Flash için vLLM serve komutu
Aşağıdaki, vLLM-ERNIE README'sinden alınan ve tek bir 4 GPU'lu düğümde 128K eğitim bağlamıyla ECHO spekülatif kod çözme açıkken kullanılan FP8 komutudur:
export VLLM_ENGINE_READY_TIMEOUT_S=3600
vllm serve baidu/ERNIE-5.5-Flash-Base \
    --host 0.0.0.0 \
    --port 8000 \
    --data-parallel-size 4 \
    --enable-expert-parallel \
    --moe-backend humming \
    --kv-cache-dtype fp8 \
    --max-model-len 131072 \
    --speculative-config '{"method":"mtp","num_speculative_tokens":2}'
Baidu'nun notlarına göre her seçimin yaptığı iş şöyle:
- Veri paralelliğinde dikkat + uzman paralelliğinde MoE (
--data-parallel-size 4 --enable-expert-parallel) en fazla KV önbelleğini tutar ve en yüksek verim sağlar. Tensor paralelliği (--tensor-parallel-size2, 4 veya 8), düşük eşzamanlılıkta gecikmeyi azaltır ama daha az KV önbelleği tutar. - FP8 KV önbelleği (
--kv-cache-dtype fp8) önbelleği FP8 olarak saklar;autoise BF16 olarak tutar. - ECHO spekülatif kod çözme, modelin kendi son katmanını yerleşik bir draft (taslak) model olarak yeniden kullanır. Burada 2 adımlık taslak üretir; 1 veya 3 de çalışır. Taslaksız sunum için
--speculative-configseçeneğini kaldırın.
Model kartı, 30000 numaralı bağlantı noktasında spekülatif yapılandırma olmadan daha kısa bir varyant gösterir.
Güvenliği sıkılaştırın. Bu komutlar 0.0.0.0 adresine kimlik doğrulaması olmadan bağlanır. Baidu'nun README'si, ağ güvenilir değilse --api-key <key> eklemenizi veya 127.0.0.1 adresine bağlanmanızı söyler. Bağlantı noktasını dışarıya açmadan önce ikisinden birini yapın.
BF16 ve 1M bağlam
BF16, iki adet 4 GPU'lu düğümde (DP8 artı EP8) --data-parallel-size 8, --data-parallel-size-local 4, --data-parallel-address ${HEAD_IP} ve --data-parallel-hybrid-lb ile çalışır; ikinci düğüm --data-parallel-start-rank 4 ekler. Tam komutu README'den kopyalayın; düğümler arasındaki ağ arayüzünü de ayarlar.
Tam 1.048.576 tokenlik pencere için --max-model-len 1048576 ve --gpu-memory-utilization 0.85 geçirin ve her bir rank'ın KV önbelleğinin tam 1M tokenlik istekleri tutabilmesi için --max-num-seqs değerini düşürün.
OpenAI uyumlu uç noktayı çağırma
vLLM, OpenAI tarzı rotalar sunar ancak bir base modelin sohbet şablonu yoktur; bu yüzden /v1/completions ucunu ham bir prompt ile çağırırsınız. Few-shot kullanımı için örnekleri prompt'a koyun ve bir cevabın sonunda durdurun:
curl http://127.0.0.1:8000/v1/completions \
    -H 'Content-Type: application/json' \
    -d '{
        "model": "baidu/ERNIE-5.5-Flash-Base",
        "prompt": "Question: What is 15% of 240?\nAnswer:",
        "max_tokens": 64,
        "temperature": 0,
        "stop": ["\n"]
    }'
Baidu'nun README'sine göre tamamlama metni 36 olarak döner. Üç ayrıntı insanları zorluyor:
- Greedy kod çözme için
"temperature": 0geçirin. Modelingeneration_config.jsondosyasıdo_sample=false,temperature=1.0vetop_p=0.95ayarlar. vLLM, temperature ve top_p değerlerini uygular amado_sampleseçeneğini yok sayar; bu yüzden üzerine yazmadığınız sürece örnekleme yapılır. <|ERNIE_MASK|>tokenini kendiniz eklemeyin. Tokenizer, bunu (token id 2) tamamlama prompt'larına kendisi ekler.- Model adını eşleştirin. BF16 ağırlıkları sunuyorsanız
baidu/ERNIE-5.5-Flash-Base-BF16kullanın.
base_url adresini http://<host>:8000/v1 olarak ayarlayıp chat completions yerine completions çağırdığınız sürece herhangi bir OpenAI SDK'sı çalışır.
Base mi Preview mı: Hangisini kullanmalısınız?
Üzerine eğitim yapmayı planlıyorsanız Base'i kullanın; şu anda çalışan bir asistan istiyorsanız Preview'ı kullanın. Base size tam kontrol ve sunucularınızdan asla çıkmayan veriler sunar. Preview, yalnızca Qianfan veya OpenRouter üzerinden sohbet, akıl yürütme ve araç çağırma imkânı verir.
Preview ağırlıkları çıktığında, eklenti zaten onlara göre hazır olacak. README, "Coming soon" olarak işaretlenen ek bayrakları belgeliyor: --reasoning-parser ernie5 --tool-call-parser ernie5 --enable-auto-tool-choice, ayrıca spekülatif kod çözme için bir DSpark draft modeli. Akıl yürütme süreci reasoning_content içinde, araç çağrıları ise message.tool_calls içinde dönecek; böylece bugün kurduğunuz sunucu, ağırlıkları değiştirip üç bayrak ekleyerek bir sohbet arka ucuna dönüşecek.
Lisans da diğer farktır. Base, Apache 2.0 değil, ERNIE 5.5 Flash Base Model Lisans Sözleşmesi v1.0 altında dağıtılır. Üzerine ürün geliştirmeden önce tam lisansı okuyun. 12 Kasım 2026 itibarıyla şunlar yazıyordu:
- Ticari olmayan kullanım ücretsizdir; bildirim gerekmez.
- İlgili ürünün yılda 50 milyon ABD dolarına kadar gelir elde ettiği ticari kullanım lisans ücretinden muaftır, ancak "Powered by ERNIE" ibaresini görüntülemeniz ve Baidu'ya tek seferlik bir bildirim göndermeniz gerekir.
- Yıllık gelir 50 milyon ABD dolarının üzerindeyse, önce Baidu'nun ayrı bir yazılı izni gerekir.
- Lisansın "Bölge" (Territory) tanımı Avrupa Birliği, Birleşik Krallık ve Güney Kore'yi kapsamaz.
Daha az GPU ile kendi kendine barındırabileceğiniz daha küçük bir açık ağırlıklı model için GLM-5.3 kendi kendine barındırma rehberimize bakın.
Kodlama ajanınızın uç noktayı Apidog CLI ile test etmesini sağlayın
Yeni bir vLLM kurulumu, her bayrak değişikliğinden sonra yeniden çalıştırılabilen bir duman testine ihtiyaç duyar: durum, yanıt şeması ve saniyedeki token sayısı. curl komutlarını tekrar tekrar yazmak yerine bunu kodlama ajanınıza ve Apidog CLI'ya bırakın.
CLI'ı bir kez kurun:
npm install -g apidog-cli@latest
apidog login --with-token <YOUR_TOKEN>
npx -y skills add https://apidog.com   # pick your agent when prompted
Ardından Claude Code, Codex veya Cursor'a tek bir prompt verin:
In Apidog project <projectId>, create an environment "ernie-local" with base URL
http://<gpu-host>:8000. Add a test case for POST /v1/completions with model
baidu/ERNIE-5.5-Flash-Base, prompt "Question: What is 15% of 240?\nAnswer:",
max_tokens 64, temperature 0. Assert status 200, that choices[0].text exists,
and that usage.completion_tokens > 0; log completion_tokens divided by the
response time in seconds as tokens/s. Run it and summarize the result.
Ajan, payload şemasını okur, doğrular, test senaryosunu yazar ve çalıştırır:
apidog environment create ernie-local --project <projectId> --base-url http://<gpu-host>:8000
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog run --test-case <caseId> --project <projectId> -e <envId> -r cli,json
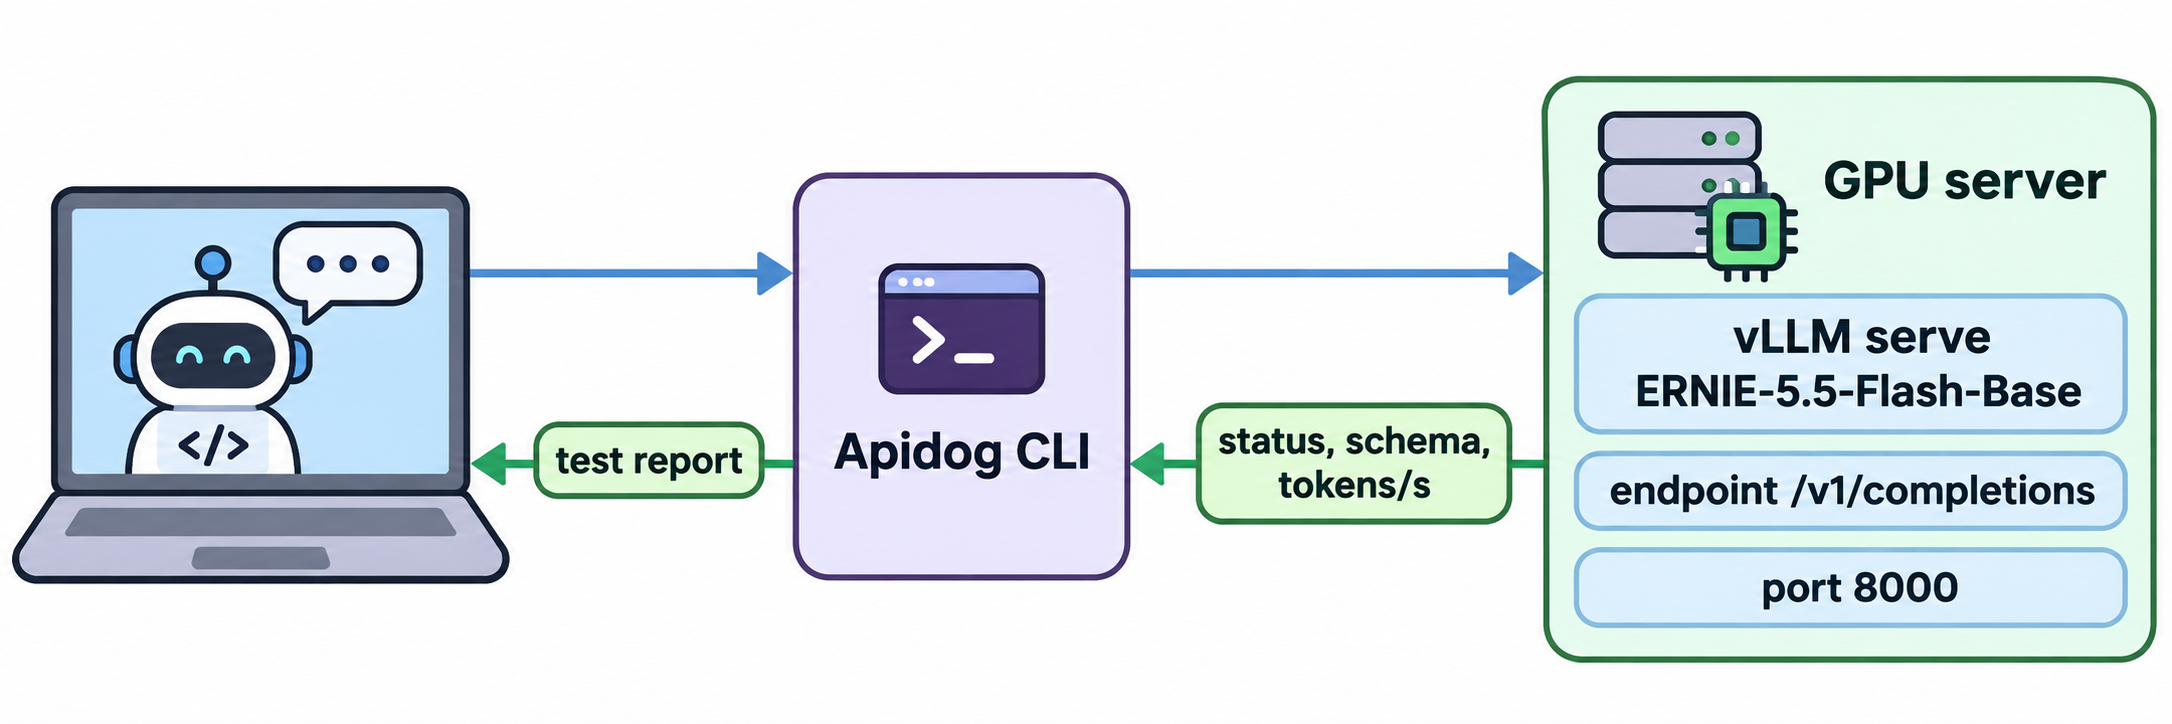
CLI'ı, 8000 numaralı bağlantı noktasına erişebilen bir makineden çalıştırın. Sunucuda --api-key ayarladıysanız, ajanın bunu bir ortam değişkeni olarak saklamasını ve Bearer token olarak göndermesini isteyin. --tensor-parallel-size değerini değiştirdikten, spekülatif kod çözmeyi kaldırdıktan veya --max-model-len değerini artırdıktan sonra aynı senaryoyu yeniden çalıştırın; böylece bire bir karşılaştırma elde edersiniz. -r junit eklerseniz aynı çalıştırma CI hattına girebilir. Ajan kurulumunu adım adım görmek için Claude Code'da Apidog CLI yazısına bakın. Apidog Free planı 4 kullanıcıya kadar kapsar.
SSS
ERNIE 5.5 Flash'ı tek bir tüketici GPU'sunda çalıştırabilir miyim? Hayır. FP8 ağırlıkları yaklaşık 280 GB'dir ve Baidu'nun listelediği en küçük kurulum, 288 GB bellekli 2 GPU'dur. 80 GB'lık kartlarla 8 tanesine ihtiyacınız var. Bu donanıma sahip değilseniz Preview'ı API üzerinden kullanın.
ERNIE 5.5 Flash Preview ağırlıkları mevcut mu? 12 Kasım 2026 itibarıyla hayır. Baidu, bunların yakında Apache 2.0 altında açık kaynak olarak yayınlanacağını söylüyor ve vLLM-ERNIE eklentisi sohbet modelini "Coming soon" olarak listeliyor. Hugging Face'te yalnızca Base ağırlıkları (FP8 ve BF16) bulunuyor.
Base modelde /v1/chat/completions neden başarısız oluyor? Base'in sohbet eğitimi veya sohbet şablonu yoktur. Baidu bunu /v1/completions üzerinden ham metin prompt'u ile sunar. Few-shot örneklerini prompt'a koyun ve bir durdurma dizisi kullanın.
vLLM, ERNIE 5.5'ı yerel olarak destekliyor mu? Çekirdek vLLM'de hayır. vLLM 0.32.0 üzerine Baidu'nun vLLM-ERNIE eklentisine ihtiyacınız var. Yalnızca NVIDIA GPU'larda çalışır. SGLang de modeli, model kartında adı geçen özel bir Docker imajıyla sunar.
ERNIE 5.5 Flash Base'i ticari olarak kullanabilir miyim? Evet, koşullarla. Yılda 50 milyon ABD dolarına kadar gelir elde eden ürünler, "Powered by ERNIE" atfı ve Baidu'ya tek seferlik bir bildirimle lisans ücreti ödemeden kullanabilir. Bunun üzerinde yazılı izin gerekir ve lisans bölgesi AB, Birleşik Krallık ve Güney Kore'yi kapsamaz.