
llama-modchip adlı açık kaynaklı bir llama.cpp yaması setini kullanarak DeepSeek V4 Flash'ı GPU olmadan yerel olarak çalıştırabilirsiniz; bu yama seti 284B'lik modeli ağırlık başına 1.71 bit ile 56.56 GiB'lik bir GGUF'a küçültüyor. 64 GB RAM'e sahip 16 çekirdekli bir AMD Zen 5 dizüstü işlemcisinde saniyede yaklaşık 44 token ön-doldurma (prefill) ve saniyede 9 ila 15 token kod çözme (decode) hızı sunuyor; swap kullanımı sıfır.
Bu kılavuz; donanımı, komutları, kalite ödünleşimini ve kodlama ajanınızın yerel uç noktayı nasıl test edebileceğini ele alıyor.
llama-modchip aslında ne yapıyor?
llama-modchip; seyrek Mixture-of-Experts modellerini tamamen sistem RAM'inde çalıştırmak için ggml ve llama.cpp çekirdek yamaları, niceleme transkodlayıcıları ve çalışma zamanı araçlarından oluşan bir set. v2.4.0 sürümü iki model boyutunu hedefliyor: 64 GB'lik makinelerde 284B'lik DeepSeek-V4-Flash ve 16 ila 32 GB'lik makinelerde 30B'lik MoE modelleri.
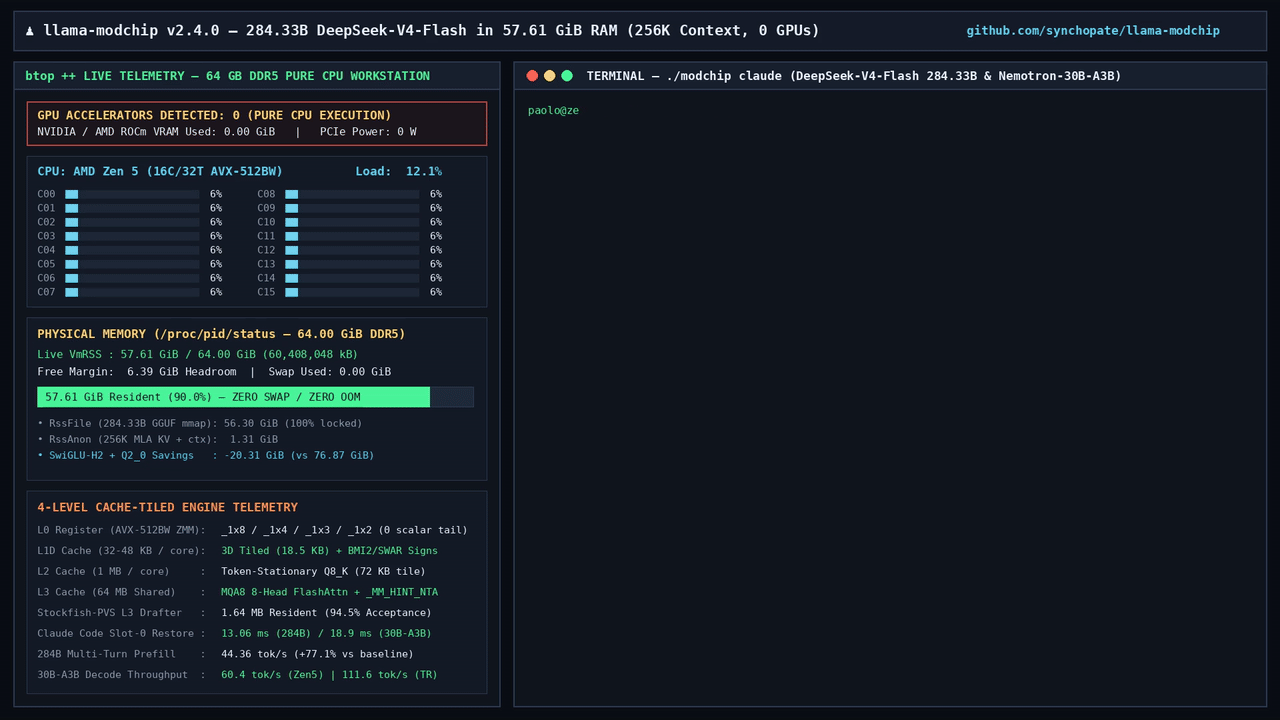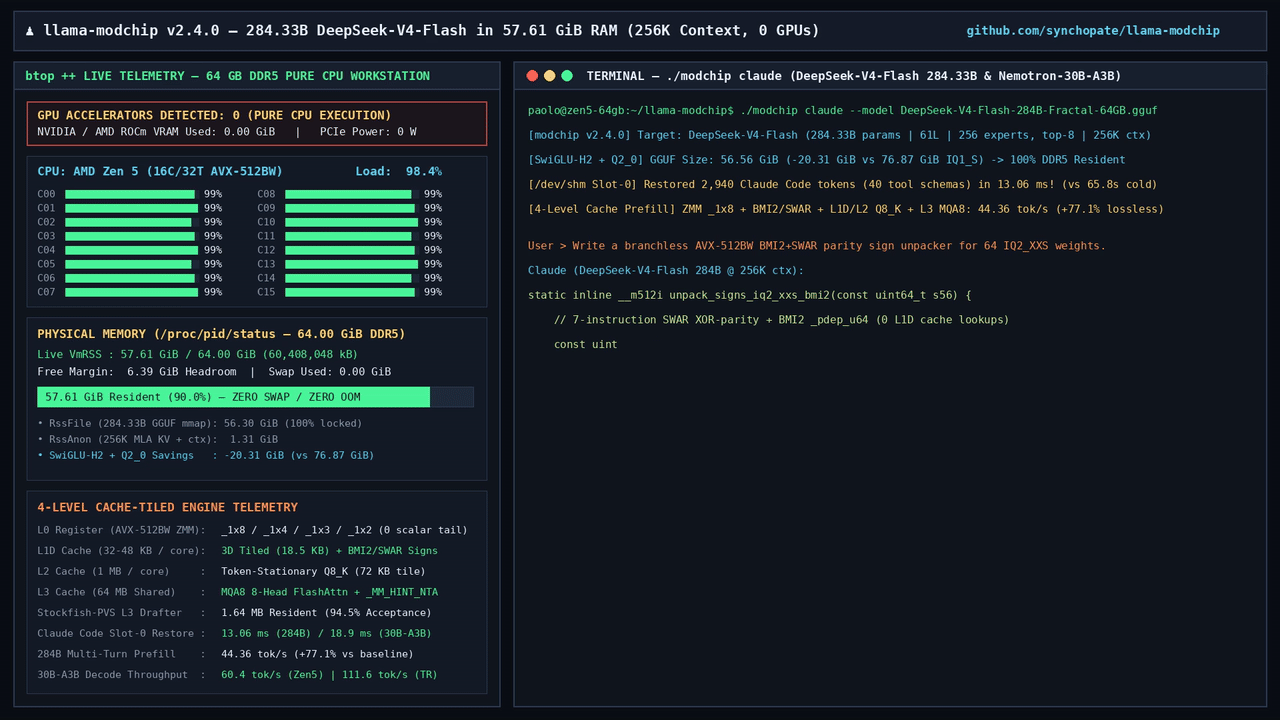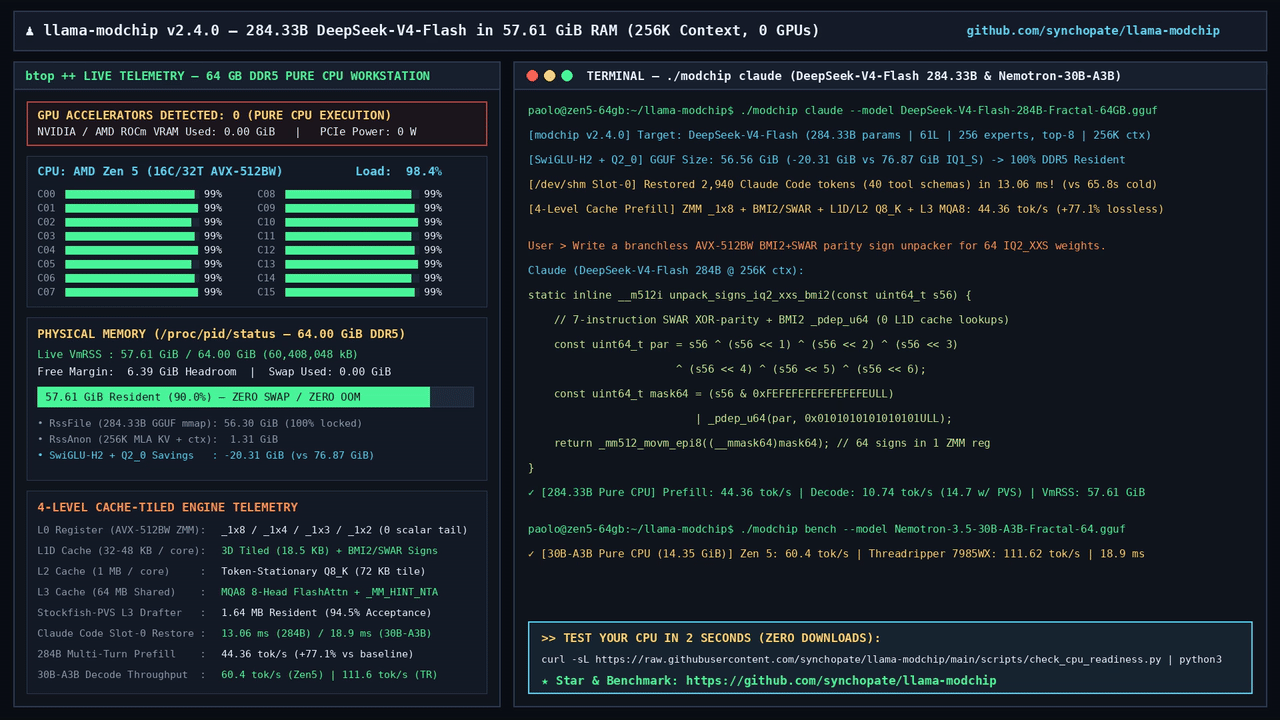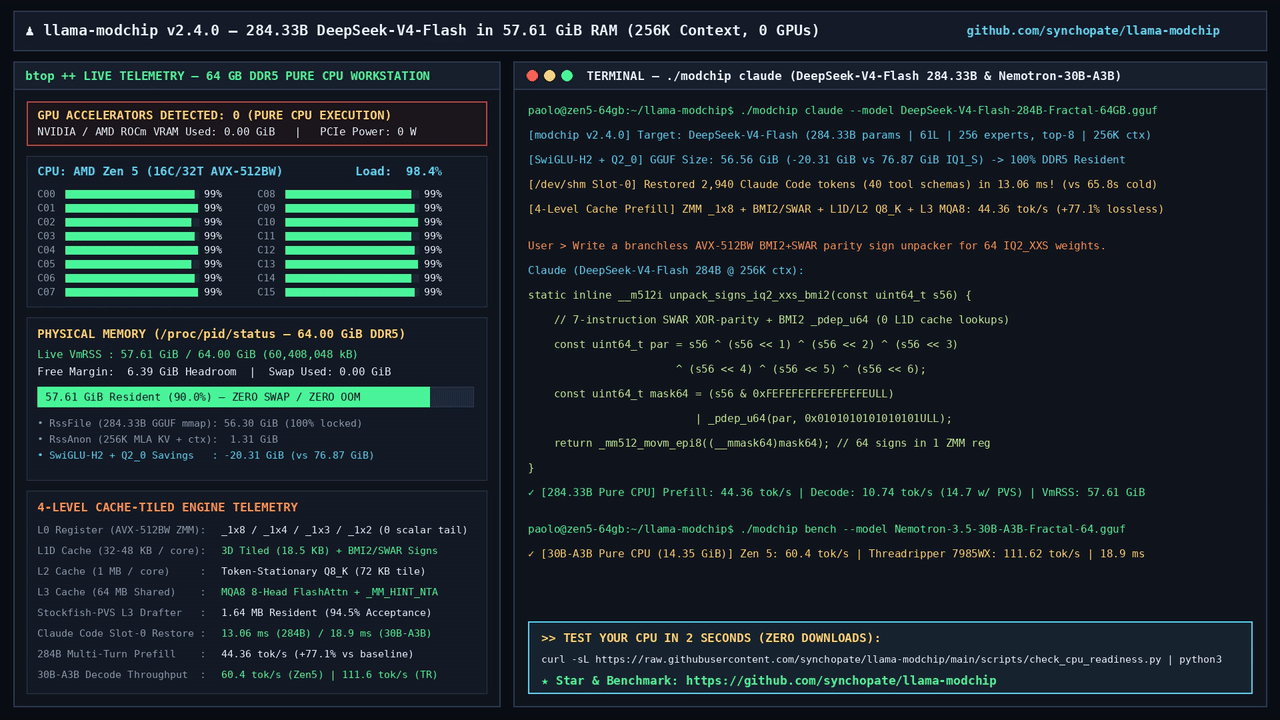
Proje 8 Kasım 2026'da Hacker News'te paylaşıldı ve 370 puanı geçti. Depo, Apache 2.0 lisanslı.
284B'nin sığmasını sağlayan üç şey var:
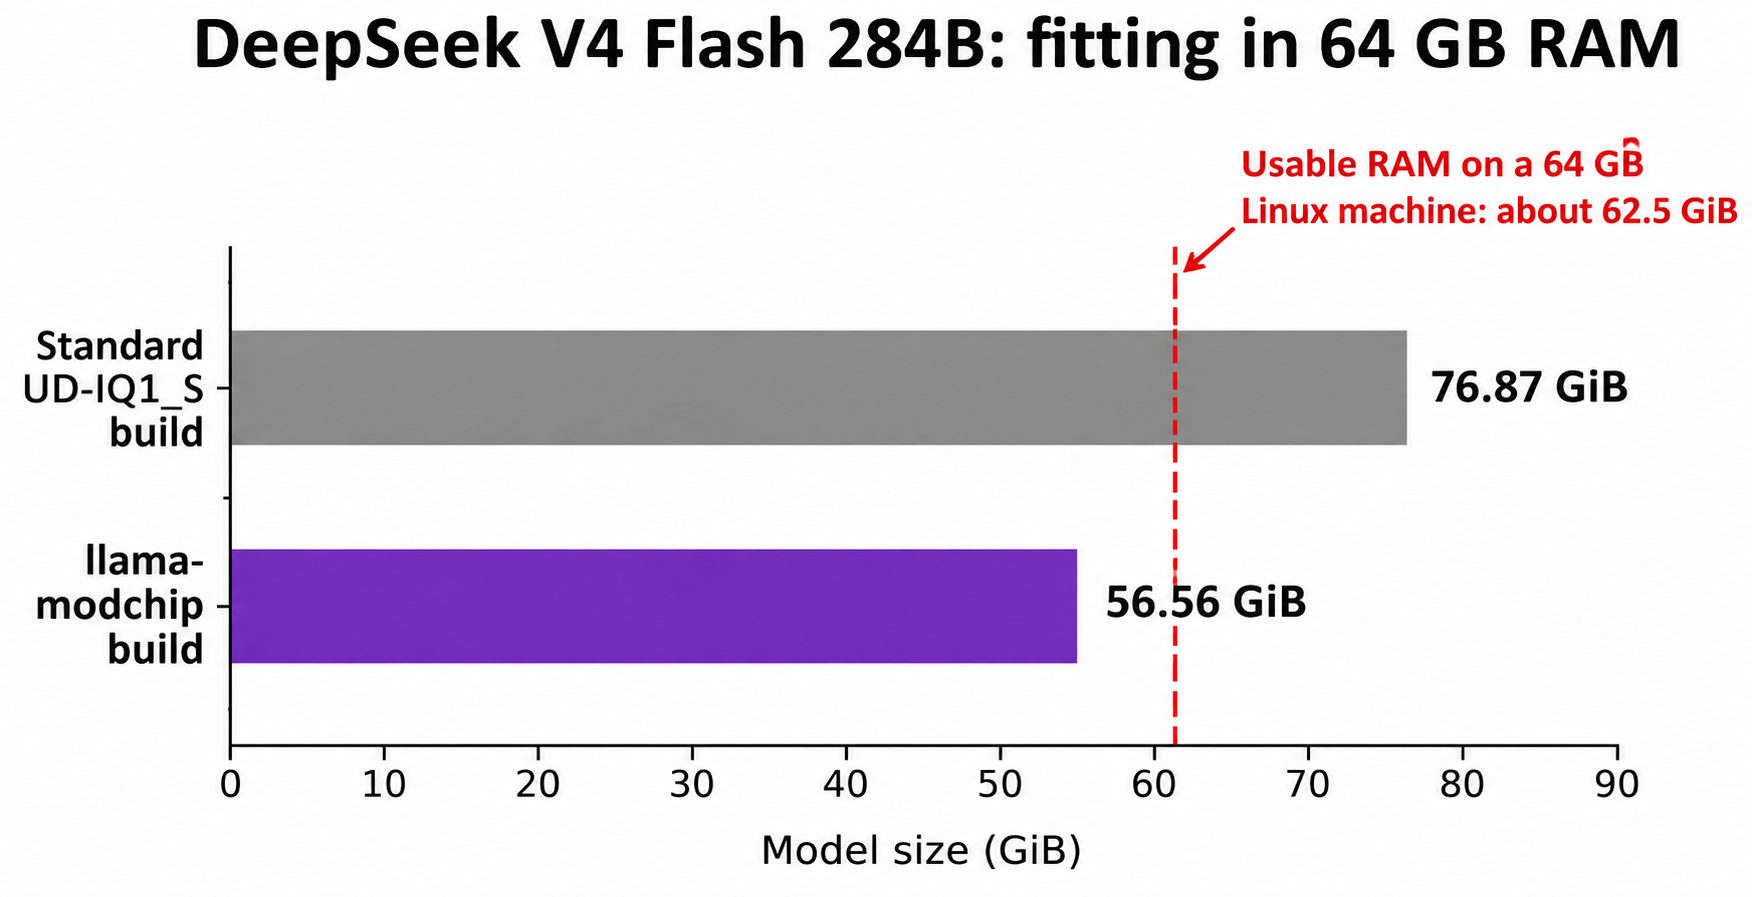
- Daha küçük bir checkpoint. Standart Unsloth
UD-IQ1_Ssürümü 76.87 GiB; 64 GB'lik bir Linux makinesinin kullanabildiği yaklaşık 62.5 GiB'den fazla. llama-modchip bunu 56.56 GiB'ye dönüştürüyor. - CPU önbellek döşeme (tiling). Prefill çekirdekleri işi yazmaçlar ile L1–L3 önbelleğine yayıyor: 16 çekirdekli Zen 5'te saniyede 25.0 ila 44.36 token, %77'lik bir kazanç.
- Kendi kendine spekülatif taslak (drafting). 1.64 MB'lik bir n-gram drafter, kod çözme hızını yaklaşık 9'dan 14.7 token/saniyeye kadar çıkarıyor.
Varsayılan olarak 6 yönlendirilmiş uzmanın tamamı ve paylaşılan uzman her katmanda çalışıyor; yani hiçbir şey budanmıyor.
DeepSeek V4 Flash'ı yerel olarak çalıştırmak için gereken donanım
64 GB sistem RAM'i ve tercihen AVX-512 destekli güncel bir x86_64 CPU'ya ihtiyacınız var. Bu kılavuzdaki tüm 284B sayıları, sürdürücü tarafından tek bir makinede ölçüldü: Linux üzerinde 64 GB DDR5'e sahip bir AMD Ryzen 9 9955HX (16 çekirdek, 32 iş parçacığı, 64 MB L3), GPU yok.
| Sizin makineniz | RAM | README'nin önerdiği model | Bildirilen hız (GPU'suz) |
|---|---|---|---|
| Dizüstü veya mini PC | 16 ila 32 GB | Nemotron-3.5-30B-A3B, 14.35 GiB | 25.0 ila 60.4 tok/s |
| Masaüstü veya sunucu | 64 GB | DeepSeek-V4-Flash 284B, 56.56 GiB | 44.4 tok/s prefill, 9.1 ila 14.7 tok/s decode |
| 8 kanallı iş istasyonu | 128 GB+ | DeepSeek 284B veya Nemotron 30B | 111.62 tok/s (yalnızca 30B) |
- Bellek kullanımı 256K bağlamda 57.61 ila 58.9 GiB'ye ulaşıyor; bu, 62.5 GiB'lik kullanılabilir tavanın altında. Yüklemeden önce diğer her şeyi kapatın.
- Önceden derlenmiş ikili dosya yalnızca Linux x86_64 için (
llama-server-modchip-linux-x86_64)../modchipkurulum betiği Linux ve macOS'u kapsıyor. README'deki Apple Silicon sonuçları 30B modeller içindir, 284B için değil. 284B'nin 64 GB'lik bir Mac'te çalışıp çalışmadığını [DOĞRULAYIN]. - Bellek bant genişliği tavan noktasıdır. SSS'ye göre 8 veya 12 kanallı bir sunucu kartı, kod çözme hızını çift kanallı DDR5'e göre kabaca 3 ila 4 kat ölçeklendiriyor.
Depo, hiçbir model indirmeyen bir hazırlık kontrolü içeriyor:
curl -sL https://raw.githubusercontent.com/synchopate/llama-modchip/main/scripts/check_cpu_readiness.py | python3
Betiği Python'a aktarmadan önce okuyun.
DeepSeek V4 Flash'ı GPU'suz çalıştırma: adım adım
Yol 1: Rehberli kurulum
git clone https://github.com/synchopate/llama-modchip.git
cd llama-modchip
./modchip chat
./modchip chat, canlı token/saniye göstergesiyle bir terminal sohbeti açar. Diğer alt komutlar:
| Komut | Ne yapar |
|---|---|
./modchip web |
http://127.0.0.1:8787 adresinde web sohbeti ve telemetri |
./modchip bench |
Paylaşılabilir bir skor kartıyla 30 saniyelik hız testi |
./modchip claude |
Yerel motoru kullanan Claude Code'u başlatır |
./modchip status / stop |
Hazırlığı kontrol eder veya arka plan servislerini durdurur |
Yol 2: Doğrudan sunucu
Bu komut, GGUF'u ve önceden derlenmiş sunucuyu Hugging Face deposundan indirip 8080 portunda başlatır:
hf download Synchopate/DeepSeek-V4-Flash-0731-Fractal-64GB-CPU-GGUF --local-dir ./dsv4
chmod +x ./dsv4/llama-server-modchip-linux-x86_64
./dsv4/llama-server-modchip-linux-x86_64 \
  -m ./dsv4/DeepSeek-V4-Flash-0731-Fractal-00001-of-00003.gguf \
  -c 32768 -t 16 -fa on --port 8080
-t değerini fiziksel çekirdek sayınıza ayarlayın. Örnekte 32K bağlam kullanılıyor; 256K değerleri için -c 262144 kullanılır.
Bir tuzak: stok llama.cpp, Ollama ve LM Studio bu dosyayı yükleyemiyor. Checkpoint, özel bir tensör türü kullanıyor (ID 40); bu nedenle yamalanmamış sürümler unknown tensor type 40 hatası verir. ./modchip betiğini veya paketlenmiş ikili dosyayı kullanın.
Sunucu, yamalanmış bir llama.cpp llama-server'dır; yani OpenAI tarzı /v1/chat/completions rotasını konuşur:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"messages":[{"role":"user","content":"Reply with the word ready."}],"max_tokens":8}'
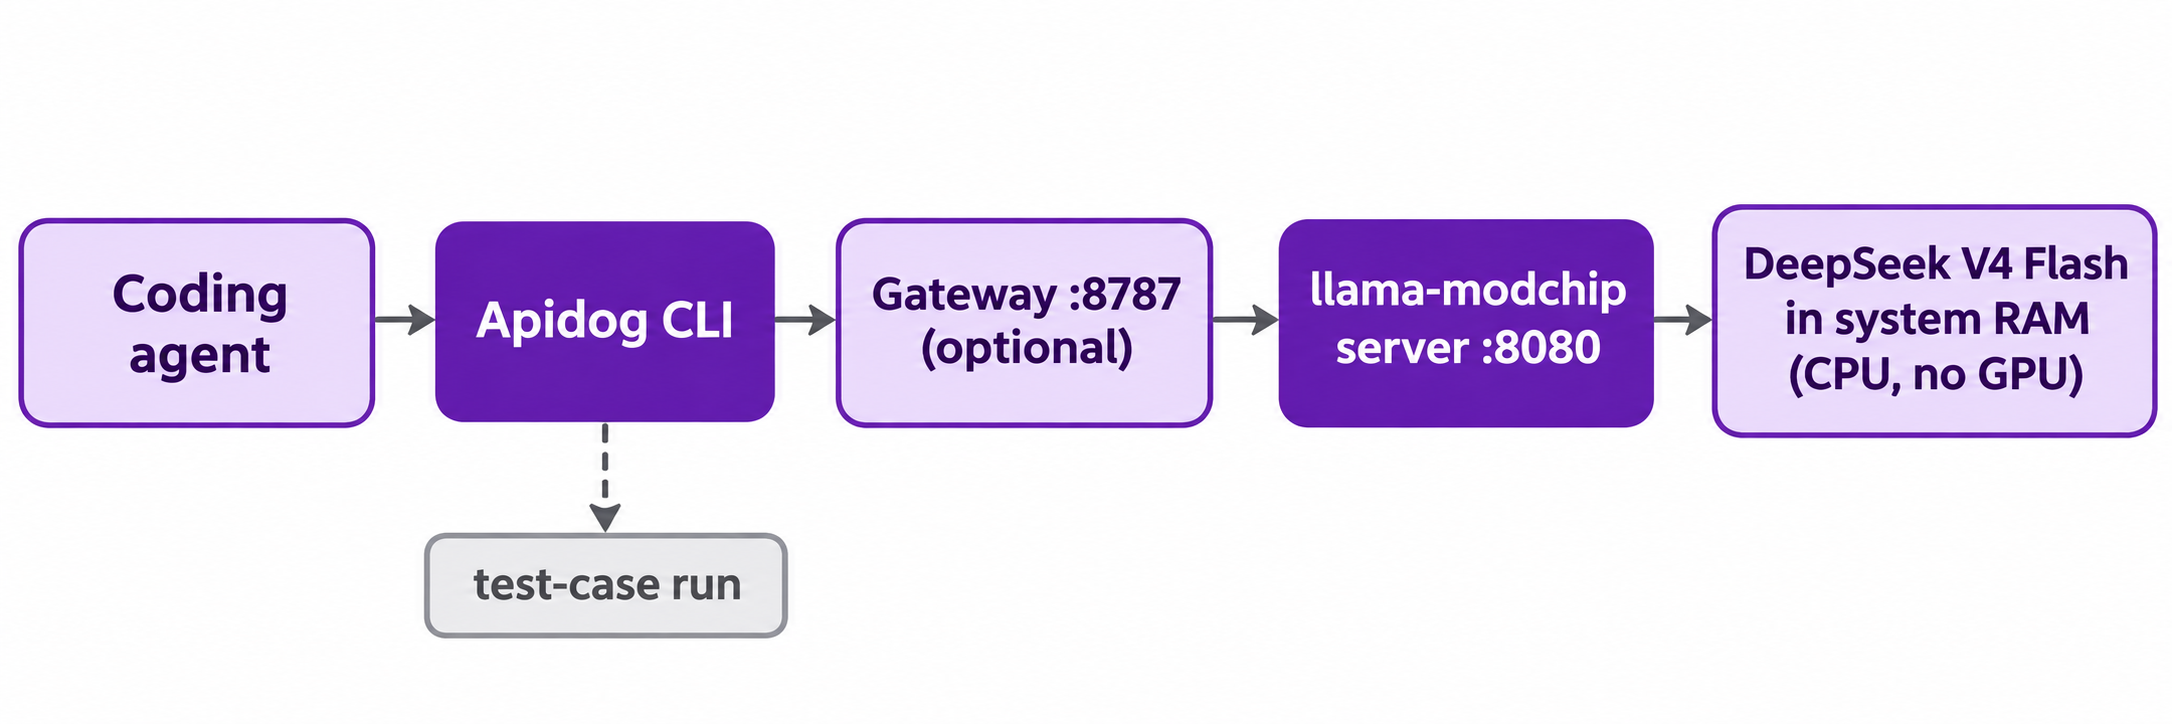
8787 portundaki ağ geçidi
gateway/sse_gateway.py, 127.0.0.1:8787 üzerinde çalışan ve istekleri motora ileten bir vekil sunucudur (üst akışı LLAMA_BACKEND_URL ile ayarlayın). /v1/chat/completions, /v1/messages, /v1/models ve /health uç noktalarını sunar. GATEWAY_API_KEY ayarlanırsa bearer token ister. ./modchip claude, Claude Code'u buraya yönlendirir.
Hız ve kalite: ağırlık başına 1.71 bit size neye mal oluyor?
Hız sayıları gerçek ama spesifik. Ryzen 9 9955HX üzerinde 256K bağlamda DeepSeek-V4-Flash için sürdürücünün tablosu şöyle:
| Yapılandırma | Prefill | Decode | Drafter ile decode |
|---|---|---|---|
Yamalanmamış UD-IQ1_S (76.87 GiB) |
64 GB'de OOM veya swap | 5.91 tok/s | Yok |
| v2.4.0 varsayılan (Top-6, 56.56 GiB) | 43.16 ila 44.36 tok/s | 9.06 ila 9.95 tok/s | 11.5 ila 14.7 tok/s |
| İleri katmanlarda Top-5 | 43.16 ila 44.36 tok/s | 9.68 ila 9.87 tok/s | 12.2 ila 15.1 tok/s |
| Top-4 artı gate-first SwiGLU | 43.16 ila 44.36 tok/s | 10.12 ila 10.74 tok/s | 13.0 ila 16.0 tok/s |
LLAMA_MOE_TOP_K=5 veya 4 ile daha hızlı satırlara geçersiniz. README'ye göre Top-5, kendi varsayılanına kıyasla yaklaşık %0.42 ek perplexity getiriyor.
Hacker News'te tekrar tekrar dile getirilen iki uyarı:
- "Kayıpsız" ifadesi, 1.71 bpw'lik dosyaya göre kayıpsız anlamında, orijinal ağırlıklara göre değil. 1.00000'lik kosinüs benzerliği, aynı sıkıştırılmış checkpoint üzerinde yamalı ve yamasız çalışma zamanlarını karşılaştırıyor; burada yönlendirilmiş uzmanların çoğu
IQ1_S(yaklaşık 1.56 bit) seviyesinde. Yorumcular, kalitenin genellikle 4 bitin altında düştüğünü belirtti ve README'de tam hassasiyetli çıktıyla bir karşılaştırma yok. - Prefill, ajanlar için darboğaz. Saniyede 44 token hızda, 10.000 token'lık bir istem ilk çıktı token'ından önce yaklaşık 225 saniye sürüyor. KV anlık görüntüleri (40 araçlı bir Claude Code istemi için 13.1 ila 32.6 ms geri yükleme) tekrar eden turlarda yardımcı olur, taze bağlamda değil.
Bir not daha: bu, Temmuz'daki 0731 V4-Flash checkpoint'idir. DeepSeek bu arada V4.1 Flash'ı yayınladı. En güncel ağırlıklar sizin için önemliyse, önce DeepSeek V4.1 Flash'ın V4 Pro ve V4 Flash ile karşılaştırmasını okuyun.
Yerel 284B'yi taslaklar, toplu işler ve deneyler için özel, çevrimdışı bir model olarak görün ve önce kendi istemlerinizle test edin.
Kodlama ajanınızın yerel uç noktayı Apidog CLI ile test etmesine izin verin
Yerel bir model de bir API'dir: cevap veriyor mu, JSON geçerli mi, son bayrak değişikliği bir şey bozdu mu? Kodlama ajanınız bu kontrolleri makinenizde çalışan ve 127.0.0.1'e doğrudan erişen Apidog CLI ile yapabilir. Bir kez kurun:
npm install -g apidog-cli@latest
apidog auth login --with-token <YOUR_TOKEN>
apidog skill install
apidog skill install, Apidog skill'ini ekler, böylece ajanınız komutları bilir. Ardından ajanınıza, örneğin Claude Code'a tek bir istem verin:
In Apidog project <projectId>, create an environment called local-dsv4 with base URL
http://127.0.0.1:8080. Add a POST /v1/chat/completions endpoint and a test case that
sends a short prompt, asserts status 200, asserts choices[0].message.content is not empty,
and asserts the response time is under 120 seconds. Run it against local-dsv4 and
summarize any failures.
Ajan şemaları okur, verilerini doğrular, sonra şunları yazar ve çalıştırır:
apidog environment create local-dsv4 --project <projectId> --base-url http://127.0.0.1:8080
apidog cli-schema get endpoint-create
apidog cli-schema validate endpoint-create --file endpoint.json
apidog endpoint create --project <projectId> --file endpoint.json
apidog cli-schema get test-case-create
apidog cli-schema validate test-case-create --file case.json
apidog test-case create --project <projectId> --file case.json
apidog test-case run <caseId> --project <projectId> -e <envId> -r cli,json --timeout-request 180000
--timeout-request (milisaniye) önemli: CPU'ya bağlı bir 284B model, varsayılan zaman aşımını tetikleyecek kadar yavaştır.
Kazanç karşılaştırma imkânı: ikinci bir ortamı DeepSeek'in barındırılan API'sine yönlendirin, aynı test senaryosunu çalıştırın ve yerel nicelemenin nerede saptığını görün. Çalıştırmaları uygulamada görmek için --upload-report ekleyin. Detaylar için Claude Code'da Apidog CLI ve Apidog CLI kurulum rehberine bakın. Apidog'un Ücretsiz planı 4 kullanıcıya kadar kapsıyor.
Yerel CPU, GPU ve barındırılan API karşılaştırması
| Seçenek | Gerekenler | En uygun olduğu durum |
|---|---|---|
| CPU'da llama-modchip | 64 GB RAM, modern x86_64 CPU | API ücreti olmayan özel, çevrimdışı işler — yavaş prefill'i kabul ediyorsanız |
| vLLM veya SGLang ile GPU sunumu | Büyük VRAM veya çoklu GPU'lu bir makine | Hızlı, daha yüksek hassasiyetli kendi kendine barındırma |
| DeepSeek barındırılan API'si | Bir API anahtarı | Üretim hızında tam kaliteli çıktı |
GPU yolu için vLLM ve SGLang'i kapsayan DeepSeek V4'ü yerel olarak çalıştırma rehberine göz atın. Daha yeni checkpoint'in bellek hesabı için DeepSeek V4.1 Flash'ı yerel olarak çalıştırma yazısına bakın. Herhangi bir yerel modeli API olarak test etmek için yerel LLM'leri API olarak test etme yazısına bakın.
SSS
DeepSeek V4 Flash'ı gerçekten GPU'suz çalıştırabilir miyim?
Evet, llama-modchip ve 64 GB RAM ile. Sürücü, 16 çekirdekli bir Ryzen 9 9955HX üzerinde 56.56 GiB'lik modelin tamamı RAM'de ve swap olmadan saniyede 44.36 token prefill ve saniyede 9 ila 15 token decode bildiriyor.
Ollama veya LM Studio ile çalışır mı?
Hayır. Checkpoint özel bir tensör türü kullanıyor ve yamalanmamış llama.cpp, Ollama ve LM Studio bunu unknown tensor type 40 hatasıyla reddediyor. Depodaki ./modchip betiğini veya paketlenmiş llama-server-modchip-linux-x86_64 ikili dosyasını kullanın.
Yalnızca 16 veya 32 GB RAM'im varsa?
Bunun yerine 30B bir MoE çalıştırın. README, bu seviye için 14.35 GiB'lik bir dosya olarak Nemotron-3.5-30B-A3B'yi öneriyor ve CPU'da saniyede 25.0 ila 60.4 token bildiriyor.
Ağırlık başına 1.71 bitle çıktı ne kadar iyi?
Proje, tam hassasiyetli DeepSeek ile bir karşılaştırma yapmıyor ve Hacker News'teki yorumcular bu boyuta şüpheyle yaklaştı. Güvenmeden önce istemlerinizi barındırılan API ile test edin.
Yerel sunucu OpenAI uyumlu mu?
Evet. Yamalanmış bir llama.cpp llama-server'dır; dolayısıyla /v1/chat/completions 8080 portunda çalışır. 8787 portundaki isteğe bağlı ağ geçidi, Claude Code'un kullandığı Anthropic tarzı rota olan /v1/messages'i de sunar.
Kodlama ajanım yerel modeli otomatik test edebilir mi?
Evet. Apidog CLI'yı kurun, apidog skill install komutunu çalıştırın ve ajanınızdan http://127.0.0.1:8080'e yönelen bir ortam ve /v1/chat/completions için bir test senaryosu oluşturmasını isteyin. Ardından apidog test-case run çalıştırır ve başarısızlıkları raporlar.